
AI の音声機能は、ユーザー体験に新たな可能性をもたらします。今年に入り、開発者がこうした体験を構築できるよう、gpt-realtime をはじめとする複数の新しい音声モデルと、新しい API 機能をリリースしました。
先週、新しい音声モデルのスナップショットをリリースしました。文字起こしやテキスト読み上げから、リアルタイムの音声変換をネイティブに行うエージェントまで、本番環境の音声ワークフロー全体で信頼性と品質を向上させ、信頼できる音声エージェントの構築でよく直面する課題に対応するための更新です。
今回の更新には、次のモデルが含まれます。
- 文字起こしまたは Realtime API で音声をテキスト化するための
gpt-4o-mini-transcribe-2025-12-15 - Speech API でテキストを読み上げるための
gpt-4o-mini-tts-2025-12-15 - Realtime API でネイティブなリアルタイム音声変換を行うための
gpt-realtime-mini-2025-12-15 - Chat Completions API でネイティブな音声変換を行うための
gpt-audio-mini-2025-12-15
新しいスナップショットには、次の共通の改善点があります。
音声入力:
- 実環境の音声やノイズを含む音声での単語誤り率の低減
- 無音時や背景ノイズがある場合のハルシネーションの減少
音声出力:
- Custom Voices の使用時も含め、より自然で安定した音声出力
料金は従来のモデルのスナップショットから変わりません。同じ料金で向上した性能を活用できるよう、新しいスナップショットへの切り替えをお勧めします。
音声エージェント、カスタマーサポートシステム、ブランド独自の音声体験を開発している場合、今回の更新は本番環境での信頼性向上に役立ちます。以下では、更新内容と、実際の音声ワークフローでこれらの改善がどのように役立つかを詳しく紹介します。
音声変換
ツール呼び出しと指示への追従性を高めるために最適化した、新しい Realtime mini モデルと Audio mini モデルの提供を進めています。これらのモデルは、mini モデルとフルサイズモデルの能力差を縮め、一部のアプリケーションでは mini モデルへの移行によるコスト最適化を可能にします。
gpt-realtime-mini-2025-12-15
gpt-realtime-mini モデルは、低レイテンシでネイティブなマルチモーダル対話を実現する Realtime API での使用を想定しています。音声のストリーミング入出力、割り込みへの対応(音声区間検出を任意で利用可能)、モデルが話し続けている間のバックグラウンドでの Function Calling などをサポートしています。
新しい Realtime mini スナップショットでは、指示への追従性とツール呼び出しが明確に向上し、リアルタイムエージェントにさらに適したものになりました。社内の音声変換評価では、前のスナップショットと比べて、指示に正確に従う割合が 18.6 パーセントポイント、ツールを正確に呼び出す割合が 12.9 パーセントポイント向上し、Big Bench Audio ベンチマークでも改善が見られました。
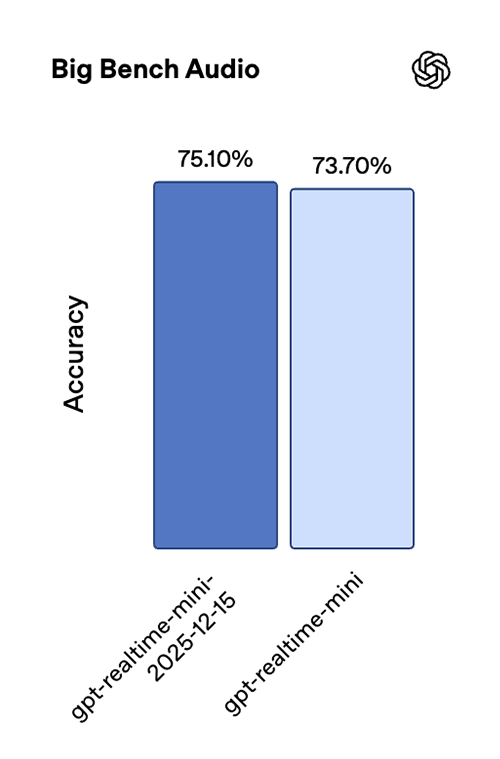
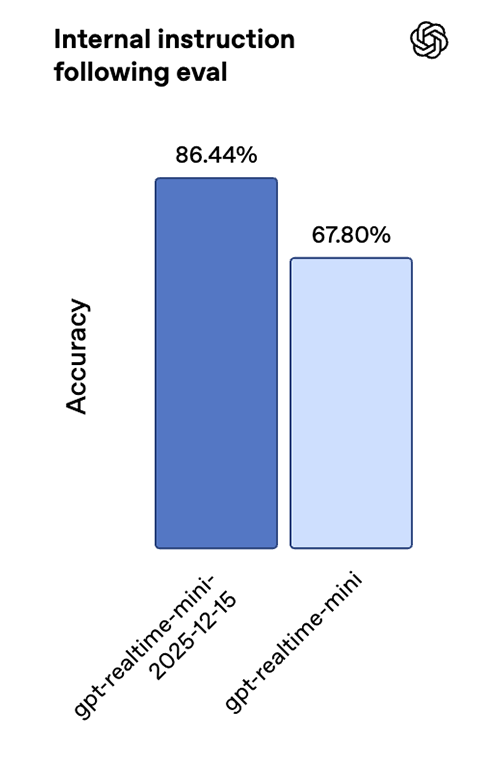
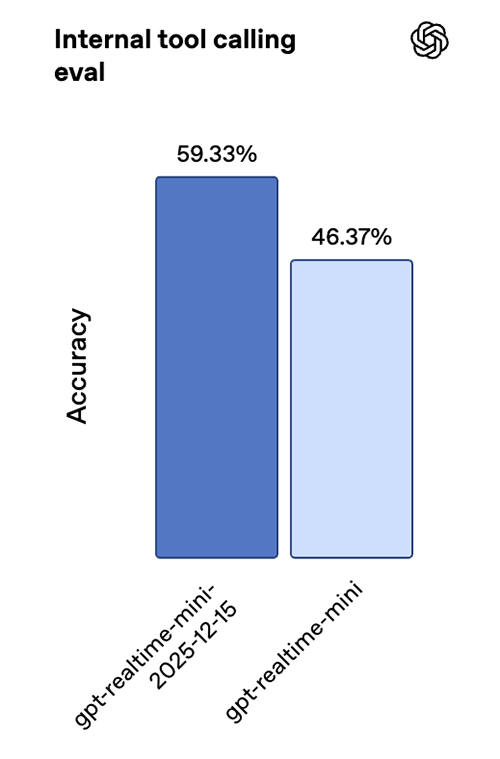
これらの改善により、低レイテンシが求められるリアルタイムの利用環境で、複数ステップの対話の信頼性が高まり、関数の実行もより安定します。
コストが高くてもエージェントの正確性を重視する場面では、引き続き gpt-realtime が最も高い性能を発揮するモデルです。一方、コストとレイテンシを最優先する場合には、実際の利用場面で優れた性能を発揮する gpt-realtime-mini が有力な選択肢です。
たとえば、Genspark は、このモデルを使い、2 言語間の翻訳と、意図を判断して処理を振り分ける機能でストレステストを実施しました。その結果、音声品質の向上に加え、ほぼ瞬時に応答し、テンポの速いやり取りでも意図を的確に認識し続けることを確認しました。
gpt-audio-mini-2025-12-15
gpt-audio-mini モデルは、リアルタイムの対話を必要としない音声変換のユースケースで、Chat Completions API と組み合わせて使用できます。
新しいスナップショットはどちらも、改良されたデコーダーによって、より自然な音声を生成します。また、Custom Voices の使用時も、声の一貫性をより高く保てます。
テキスト読み上げ
最新のテキスト読み上げモデル gpt-4o-mini-tts-2025-12-15 は、精度が大幅に向上しています。標準的な音声ベンチマーク全体で、前世代と比べて単語誤り率が大きく低下しました。Common Voice と FLEURS では単語誤り率(WER)が約 35% 低下し、Multilingual LibriSpeech でも一貫して改善が見られます。
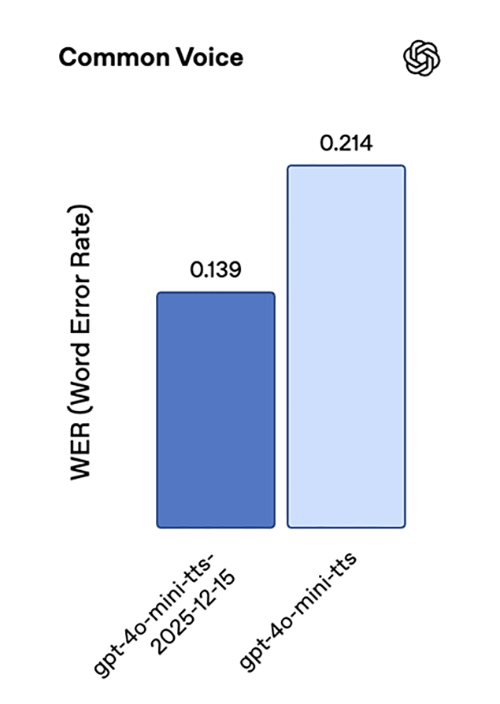
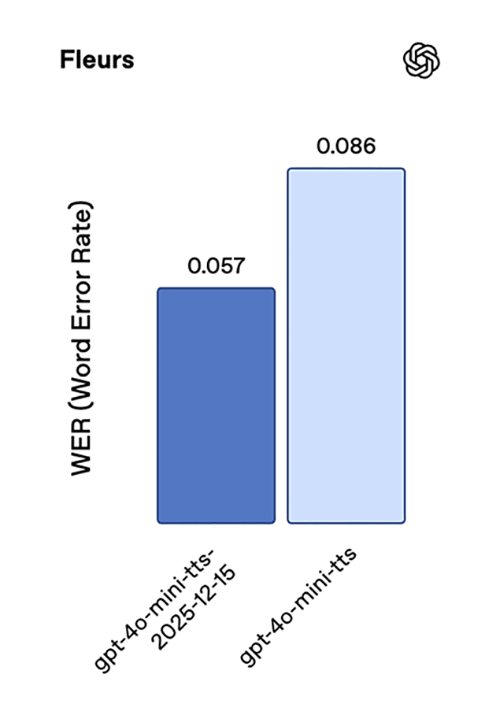
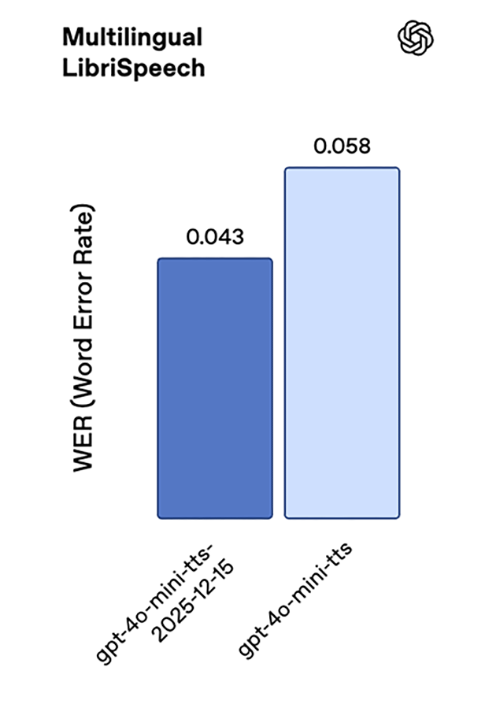
これらの結果は、幅広い言語で発音の正確性と堅牢性が向上していることを示しています。
新しい gpt-realtime-mini スナップショットと同様に、このモデルも音声が格段に自然になり、Custom Voices の使用時の性能も向上しています。
音声のテキスト化
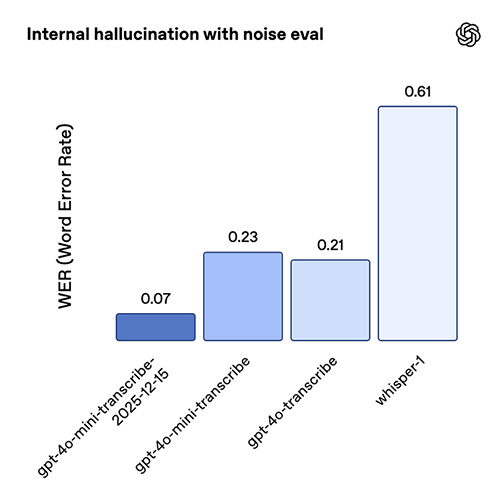
最新の文字起こしモデル gpt-4o-mini-transcribe-2025-12-15 は、正確性と信頼性の両面で大きく向上しています。Common Voice や FLEURS といった標準的な自動音声認識(ASR)ベンチマークでは、言語のヒントなしで、従来のモデルよりも低い単語誤り率を達成しています。このモデルは、短いユーザー発話や背景ノイズがある状況など、実際の会話環境での動作を最適化しています。社内の ノイズ下でのハルシネーション 評価では、実環境の背景ノイズのクリップや、発話間隔がさまざまに異なる音声(無音も含む)を再生しました。その結果、ハルシネーションの発生は Whisper v2 と比べて約 90%、従来の GPT-4o-transcribe モデルと比べて約 70% 減少しました。
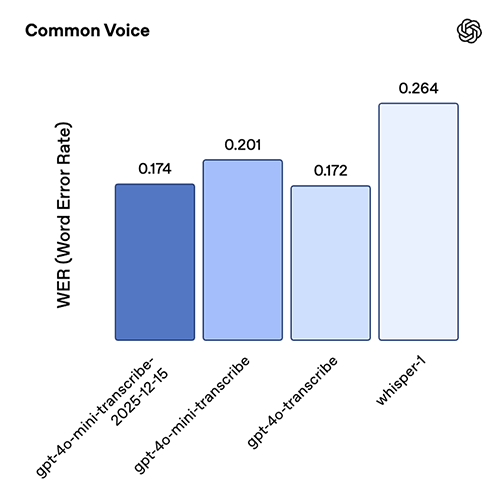
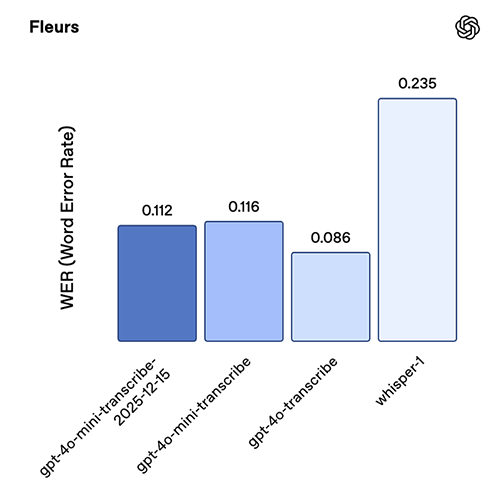
このモデルのスナップショットは、中国語(標準中国語)、ヒンディー語、ベンガル語、日本語、インドネシア語、イタリア語で特に優れた性能を発揮します。
Custom Voices
Custom Voices を使うと、組織はブランド独自の声で顧客とコミュニケーションを取れます。カスタマーサポートエージェントやブランドのアバターを開発する際に、OpenAI のカスタム音声技術を使えば、個性があり、リアルな音声を簡単に作成できます。
今回の新しい音声変換モデルとテキスト読み上げモデルにより、カスタム音声の声色がより自然になり、元のサンプルへの忠実度や、方言ごとの正確性も向上します。
この技術を安全に利用していただくため、Custom Voices は利用資格のあるお客様に限定して提供しています。詳しくは、担当のアカウントディレクター、または営業チームにお問い合わせください。
プロトタイプから本番環境へ
音声アプリで問題が起きる場面には共通する傾向があります。主に、長い会話、無音などのエッジケース、そして音声エージェントに正確な動作が求められるツールを使ったフローです。今回の更新は、こうした問題への対策に重点を置き、誤り率の低減、ハルシネーションの減少、ツール使用の安定性向上、指示への追従性向上を図っています。さらに、出力音声の安定性も改善し、より自然な音声体験を実現できるようにしました。
現在、音声体験を提供している場合は、新しい 2025-12-15 スナップショットに移行し、本番環境向けの主要なテストケースを再実行することをお勧めします。
先行テスターは、指示を変更せず、新しいスナップショットに切り替えるだけで明確な改善が得られることを確認しています。ただし、ご自身のユースケースで試し、必要に応じてプロンプトを調整することをお勧めします。