
text-embedding-3-small and text-embedding-3-large, our newest and most performant embedding models, are now available. They feature lower costs, higher multilingual performance, and new parameters to control the overall size.埋め込みとは
OpenAI のテキスト埋め込みは、文字列同士の関連性を測定します。埋め込みは主に次の用途で使われます。
- 検索 (クエリ文字列との関連性に基づいて結果を順位付け)
- クラスタリング (類似性に基づいて文字列をグループ化)
- レコメンデーション (関連する文字列を持つ項目を推薦)
- 異常検知 (関連性の低い外れ値を特定)
- 多様性の測定 (類似度の分布を分析)
- 分類 (最も類似するラベルに基づいて文字列を分類)
埋め込みは、浮動小数点数のベクトル(リスト)です。2 つのベクトル間の距離で、両者の関連性を測定します。距離が短いほど関連性が高く、長いほど関連性が低いことを示します。
埋め込みの料金については、料金ページをご覧ください。リクエストは、入力に含まれるトークン数に基づいて課金されます。
埋め込みの取得方法
埋め込みを取得するには、文字列と埋め込みモデル名(例:text-embedding-3-small)を埋め込み API エンドポイントに送信します。
1
2
3
4
5
6
7
8
9
10import OpenAI from "openai";
const openai = new OpenAI();

const embedding = await openai.embeddings.create({
  model: "text-embedding-3-small",
  input: "Your text string goes here",
  encoding_format: "float",
});

console.log(embedding);
1
2
3
4
5
6
7
8
9from openai import OpenAI
client = OpenAI()
response = client.embeddings.create(
input="Your text string goes here", model="text-embedding-3-small"
)
print(response.data[0].embedding)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
embedding, err := client.Embeddings.New(context.Background(), openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{
OfString: openai.String("Your text string goes here."),
},
})
if err != nil {
panic(err)
}
fmt.Println(len(embedding.Data[0].Embedding))
}1
2
3
4
5
6
7
8
9
10
11
12
13
14import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("The food was delicious and the waiter...")
.build());
System.out.println(embedding.data().get(0).embedding());1
2
3
4
5
6
7
8
9
10
11using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync(
"The food was delicious and the waiter was friendly."
);
Console.WriteLine($"Dimensions: {embedding.ToFloats().Length}");1
2
3
4
5
6
7
8
9
10require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "The food was delicious and the waiter..."
)
puts(response.data.fetch(0).embedding)1
2
3
4
5
6
7curl https://api.openai.com/v1/embeddings \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"input": "Your text string goes here",
"model": "text-embedding-3-small"
}'レスポンスには、埋め込みベクトル(浮動小数点数のリスト)と追加のメタデータが含まれます。埋め込みベクトルを抽出してベクトルデータベースに保存し、さまざまなユースケースに活用できます。
123456789101112131415161718{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        -0.006929283495992422, -0.005336422007530928, -4.547132266452536e-5,
        -0.024047505110502243
      ]
    }
  ],
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 5,
    "total_tokens": 5
  }
}
デフォルトの埋め込みベクトルの長さは、text-embedding-3-small では 1536、text-embedding-3-large では 3072 です。概念を表現する性質を失わずに埋め込みの次元数を減らすには、dimensions パラメーターを渡します。埋め込みの次元数について詳しくは、埋め込みのユースケースのセクションをご覧ください。
埋め込みモデル
OpenAI は、高性能な第 3 世代の埋め込みモデルを 2 つ提供しています(モデル ID 内の -3 が目印です)。詳しくは、埋め込み v3 の発表ブログ記事をご覧ください。
利用料金は入力トークン単位で計算されます。以下は、1 ページあたり約 800 トークンと仮定した場合に、1 米ドルで処理できるテキストのページ数の例です。
| モデル | 1 ドルあたりのページ数(概算) | MTEB 評価での性能 | 最大入力 |
|---|---|---|---|
| text-embedding-3-small | 62,500 | 62.3% | 8192 |
| text-embedding-3-large | 9,615 | 64.6% | 8192 |
| text-embedding-ada-002 | 12,500 | 61.0% | 8192 |
ユースケース
ここでは、Amazon の食品レビューデータセットを使って、代表的なユースケースをいくつか紹介します。
埋め込みの取得
このデータセットには、2012 年 10 月までに Amazon ユーザーが投稿した計 568,454 件の食品レビューが含まれています。説明用に、最新の 1000 件のレビューを抽出して使用します。レビューは英語で書かれており、肯定的または否定的な内容に偏る傾向があります。各レビューには、ProductId、UserId、Score、レビューのタイトル(Summary)、レビューの本文(Text)があります。以下に例を示します。
| プロダクト ID | ユーザー ID | スコア | 要約 | 本文 |
|---|---|---|---|---|
| B001E4KFG0 | A3SGXH7AUHU8GW | 5 | 品質の良いドッグフード | Vitality の缶詰をいくつか購入しました… |
| B00813GRG4 | A1D87F6ZCVE5NK | 1 | 広告の説明と違う | 届いた商品には「Jumbo Salted Peanut」と表示されていました… |
以下では、レビューの要約と本文を 1 つのテキストに結合します。モデルはこの結合したテキストをエンコードし、1 つのベクトル埋め込みを出力します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import { mkdir, writeFile } from "node:fs/promises";
import OpenAI from "openai";

const client = new OpenAI();
const reviews = ["A rich cup of coffee.", "A bright herbal tea."];

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: reviews.map((review) => review.replaceAll("\n", " ")),
});

const csvField = (value) => `"${value.replaceAll('"', '""')}"`;
const rows = response.data.map(({ embedding }, index) =>
  [csvField(reviews[index]), csvField(JSON.stringify(embedding))].join(",")
);

await mkdir("output", { recursive: true });
await writeFile(
  "output/embedded_1k_reviews.csv",
  ["combined,ada_embedding", ...rows].join("\n") + "\n"
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14from openai import OpenAI
client = OpenAI()
def get_embedding(text, model="text-embedding-3-small"):
text = text.replace("\n", " ")
return client.embeddings.create(input=[text], model=model).data[0].embedding
df["ada_embedding"] = df.combined.apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
df.to_csv("output/embedded_1k_reviews.csv", index=False)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;
static String csvField(String value) {
return "\"" + value.replace("\"", "\"\"") + "\"";
}
List<String> reviews = List.of("A rich cup of coffee.", "A bright herbal tea.");
Path output = Path.of("output", "embedded_1k_reviews.csv");
Files.createDirectories(output.getParent());
try (var writer = Files.newBufferedWriter(output)) {
writer.write("combined,ada_embedding\n");
for (String review : reviews) {
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of(review.replace("\n", " ")))
.build())
.data()
.get(0)
.embedding();
writer.write(csvField(review) + "," + csvField(embedding.toString()) + "\n");
}
}
System.out.println(output);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20require "csv"
require "fileutils"
require "json"
require "openai"
client = OpenAI::Client.new
reviews = ["A rich cup of coffee.", "A bright herbal tea."]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews.map { |review| review.tr("\n", " ") }
)
FileUtils.mkdir_p("output")
CSV.open("output/embedded_1k_reviews.csv", "w") do |csv|
csv << ["combined", "ada_embedding"]
response.data.each do |embedding|
csv << [reviews.fetch(embedding.index), JSON.generate(embedding.embedding)]
end
end保存したファイルからデータを読み込むには、次のコードを実行します。
1
2
3
4import pandas as pd

df = pd.read_csv("output/embedded_1k_reviews.csv")
df["ada_embedding"] = df.ada_embedding.apply(eval).apply(np.array)埋め込みを検索用のベクトルストアに保存する場合など、大きな埋め込みを使用すると、小さな埋め込みを使用する場合よりも一般にコストが高くなり、計算資源、メモリ、ストレージの消費量も増えます。
新しい 2 つの埋め込みモデルはいずれも、埋め込みを利用する際の性能とコストのバランスを開発者が調整できる手法で学習されています。具体的には、dimensions API パラメーターを渡すことで、概念を表現する特性を失わずに埋め込みを短縮できます。つまり、数列の末尾からいくつかの数値を取り除けます。たとえば、MTEB ベンチマークでは、text-embedding-3-large の埋め込みを 256 次元まで短縮しても、短縮していない 1536 次元の text-embedding-ada-002 の埋め込みを上回る性能を維持できます。次元数の変更が性能に与える影響については、埋め込み v3 のリリースを紹介したブログ記事をご覧ください。
一般には、埋め込みの作成時に dimensions パラメーターを使用する方法をおすすめします。ただし、生成後に埋め込みの次元数を変更する必要がある場合もあります。次元数を手動で変更する場合は、以下に示すように、必ず埋め込みを正規化してください。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import OpenAI from "openai";

const client = new OpenAI();

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: "Testing 123",
  encoding_format: "float",
});

const shortened = response.data[0].embedding.slice(0, 256);
const magnitude = Math.hypot(...shortened);
const normalized = shortened.map((value) =>
  magnitude === 0 ? 0 : value / magnitude
);

console.log(normalized);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI
import numpy as np
client = OpenAI()
def normalize_l2(x):
x = np.array(x)
if x.ndim == 1:
norm = np.linalg.norm(x)
if norm == 0:
return x
return x / norm
else:
norm = np.linalg.norm(x, 2, axis=1, keepdims=True)
return np.where(norm == 0, x, x / norm)
response = client.embeddings.create(
model="text-embedding-3-small", input="Testing 123", encoding_format="float"
)
cut_dim = response.data[0].embedding[:256]
norm_dim = normalize_l2(cut_dim)
print(norm_dim)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
private static List<Double> normalizeL2(List<Float> embedding) {
double norm = Math.sqrt(embedding.stream().mapToDouble(value -> value * value).sum());
return embedding.stream().map(value -> norm == 0 ? 0.0 : value / norm).toList();
}
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Testing 123")
.encodingFormat(EmbeddingCreateParams.EncodingFormat.FLOAT)
.build());
List<Float> shortened = embedding.data().get(0).embedding().subList(0, 256);
System.out.println(normalizeL2(shortened));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync("Testing 123");
float[] shortened = embedding.ToFloats().Span[..256].ToArray();
double magnitude = Math.Sqrt(shortened.Sum(value => value * value));
float[] normalized =
magnitude == 0
? shortened
: shortened.Select(value => (float)(value / magnitude)).ToArray();
Console.WriteLine($"Dimensions: {normalized.Length}");
Console.WriteLine($"First value: {normalized[0]:F6}");
Console.WriteLine(
$"L2 norm: {Math.Sqrt(normalized.Sum(value => value * value)):F3}"
);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "Testing 123",
encoding_format: :float
)
shortened = response.data.fetch(0).embedding.first(256)
magnitude = Math.sqrt(shortened.sum { |value| value**2 })
normalized = shortened.map { |value| magnitude.zero? ? 0 : value / magnitude }
puts(normalized)次元数を動的に変更することで、非常に柔軟な使い方が可能になります。たとえば、最大 1024 次元の埋め込みしかサポートしないベクトルデータストアでも、最高性能の埋め込みモデル text-embedding-3-large を使用できるようになりました。dimensions API パラメーターに 1024 を指定すると、埋め込みが 3072 次元から短縮されます。精度は多少低下しますが、ベクトルのサイズを小さくできます。
ユーザーの質問への回答を生成する際に参照させたい重要な事実や情報が、モデルの学習データに含まれていないことはよくあります。解決方法の 1 つは、以下に示すように、モデルのコンテキストウィンドウに情報を追加することです。この方法は多くのユースケースで有効ですが、トークンのコストが高くなります。このノートブックでは、この方法と埋め込みベースの検索のトレードオフを検討します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";

const client = new OpenAI();
const article =
  "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
const question = `Use the article below to answer the question. If the answer cannot be found, say "I don't know."

Article:
${article}

Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;

const response = await client.chat.completions.create({
  model: "gpt-4.1-mini",
  messages: [
    {
      role: "system",
      content: "You answer questions about the 2022 Winter Olympics.",
    },
    { role: "user", content: question },
  ],
  temperature: 0,
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."
Article:
\"\"\"
{wikipedia_article_on_curling}
\"\"\"
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""
response = client.chat.completions.create(
messages=[
{
"role": "system",
"content": "You answer questions about the 2022 Winter Olympics.",
},
{"role": "user", "content": query},
],
model=GPT_MODEL,
temperature=0,
)
print(response.choices[0].message.content)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
String article =
"At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
String question =
"Use the below article on the 2022 Winter Olympics to answer the subsequent question. "
+ "If the answer cannot be found, write \"I don't know.\"\n\n"
+ "Article:\n"
+ article
+ "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletionCreateParams params =
ChatCompletionCreateParams.builder()
.model("gpt-4.1-mini")
.addSystemMessage("You answer questions about the 2022 Winter Olympics.")
.addUserMessage(question)
.temperature(0)
.build();
client.chat().completions().create(params).choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."
question = <<~QUESTION
Use the article below to answer the question. If the answer cannot be found, say "I don't know."
Article:
#{article}
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?
QUESTION
response = client.chat.completions.create(
model: "gpt-4.1-mini",
messages: [
{
role: :system,
content: "You answer questions about the 2022 Winter Olympics."
},
{
role: :user,
content: question
}
],
temperature: 0
)
puts(response.choices.fetch(0).message.content)最も関連性の高いドキュメントを取得するために、クエリと各ドキュメントの埋め込みベクトル間のコサイン類似度を計算し、スコアが最も高いドキュメントを返します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";

const client = new OpenAI();
const reviews = [
  "A rich cup of coffee.",
  "Smooth beans in tomato sauce.",
  "Dark chocolate with orange.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...reviews, "delicious beans"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = reviews
  .map((review, index) => ({
    review,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score)
  .slice(0, 3);

console.log(results);
1
2
3
4
5
6
7
8
9
10def search_reviews(df, product_description, n=3, pprint=True):
embedding = get_embedding(product_description, model="text-embedding-3-small")
df["similarities"] = df.ada_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_reviews(df, "delicious beans", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> reviews =
List.of(
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange.");
var reviewEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(reviews)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("delicious beans"))
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, reviews.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, reviewEmbeddings.get(index).embedding()))
.reversed())
.limit(3)
.map(reviews::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"
client = OpenAI::Client.new
reviews = [
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews + ["delicious beans"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = reviews.map.with_index do |review, index|
{
review: review,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }.first(3)
puts(results)コード検索は、埋め込みベースのテキスト検索と同様に機能します。ここでは、指定したリポジトリ内のすべての Python ファイルから Python 関数を抽出する方法を紹介します。その後、text-embedding-3-small モデルを使って各関数をインデックス化します。
コード検索を実行するには、同じモデルを使って自然言語のクエリを埋め込みに変換します。次に、得られたクエリの埋め込みと各関数の埋め込みの間でコサイン類似度を計算します。コサイン類似度が最も高い結果が、最も関連性の高い結果です。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const client = new OpenAI();
const functions = [
  "function add(a, b) { return a + b; }",
  "function complete(prompt) { return prompt; }",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...functions, "Completions API tests"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = functions
  .map((source, index) => ({
    source,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score);

console.log(results);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16df["code_embedding"] = df["code"].apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
def search_functions(df, code_query, n=3, pprint=True, n_lines=7):
embedding = get_embedding(code_query, model="text-embedding-3-small")
df["similarities"] = df.code_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_functions(df, "Completions API tests", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> functions =
List.of("def add(a, b): return a + b", "def complete(prompt): return prompt");
var functionEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(functions)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Completions API tests")
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, functions.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, functionEmbeddings.get(index).embedding()))
.reversed())
.map(functions::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
functions = [
"function add(a, b) { return a + b; }",
"function complete(prompt) { return prompt; }"
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: functions + ["Completions API tests"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = functions.map.with_index do |source, index|
{
source: source,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }
puts(results)埋め込みベクトル間の距離が短いほど類似度が高いことを表すため、埋め込みはレコメンデーションにも役立ちます。
以下に、基本的な推薦システムの例を示します。文字列のリストと 1 つの「基準」となる文字列を受け取り、それぞれの埋め込みを計算して、基準との類似度が高い順に文字列のランキングを返します。具体例として、以下のリンク先のノートブックでは、この関数の一例を AG news データセット(ニュース記事の説明を 2,000 件サンプリングしたもの)に適用し、任意の基準記事に最も類似する上位 5 件の記事を返します。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from "openai";

const client = new OpenAI();
const strings = [
  "A cheetah is a fast land animal.",
  "A peregrine falcon is a fast bird.",
  "A tortoise moves slowly.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: strings,
});

const query = data[0].embedding;
const recommendations = data
  .map(({ embedding }, index) => {
    const dotProduct = embedding.reduce(
      (total, value, dimension) => total + value * query[dimension],
      0
    );
    const similarity =
      dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
    return { index, text: strings[index], similarity };
  })
  .sort((left, right) => right.similarity - left.similarity);

console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings(
strings: list[str],
index_of_source_string: int,
model="text-embedding-3-small",
) -> list[int]:
"""Return nearest neighbors of a given string."""
# get embeddings for all strings
embeddings = [embedding_from_string(string, model=model) for string in strings]
# get the embedding of the source string
query_embedding = embeddings[index_of_source_string]
# get distances between the source embedding and other embeddings (function from embeddings_utils.py)
distances = distances_from_embeddings(
query_embedding, embeddings, distance_metric="cosine"
)
# get indices of nearest neighbors (function from embeddings_utils.py)
indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances(
distances
)
return indices_of_nearest_neighbors1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> strings =
List.of(
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly.");
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(strings)
.build())
.data();
List<Float> query = embeddings.get(0).embedding();
var nearestNeighbors =
IntStream.range(0, embeddings.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) -> {
List<Float> candidate = embeddings.get(index).embedding();
double dotProduct = 0;
double queryMagnitude = 0;
double candidateMagnitude = 0;
for (int dimension = 0; dimension < query.size(); dimension++) {
dotProduct += query.get(dimension) * candidate.get(dimension);
queryMagnitude += query.get(dimension) * query.get(dimension);
candidateMagnitude += candidate.get(dimension) * candidate.get(dimension);
}
return 1 - dotProduct / Math.sqrt(queryMagnitude * candidateMagnitude);
}))
.toList();
System.out.println(nearestNeighbors);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31require "openai"
client = OpenAI::Client.new
strings = [
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: strings
)
query = response.data.fetch(0).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
recommendations = response.data.map.with_index do |embedding, index|
{
index: index,
text: strings.fetch(index),
similarity: similarity.call(embedding.embedding)
}
end.sort_by { |recommendation| -recommendation.fetch(:similarity) }
puts(recommendations)埋め込みのサイズは、基盤となるモデルの複雑さによって異なります。この高次元データを可視化するために、t-SNE アルゴリズムを使ってデータを 2 次元に変換します。
各レビューを、投稿者が付けた星の数に応じて次のように色分けします。
- 星 1:赤
- 星 2:濃いオレンジ
- 星 3:ゴールド
- 星 4:ターコイズ
- 星 5:濃い緑
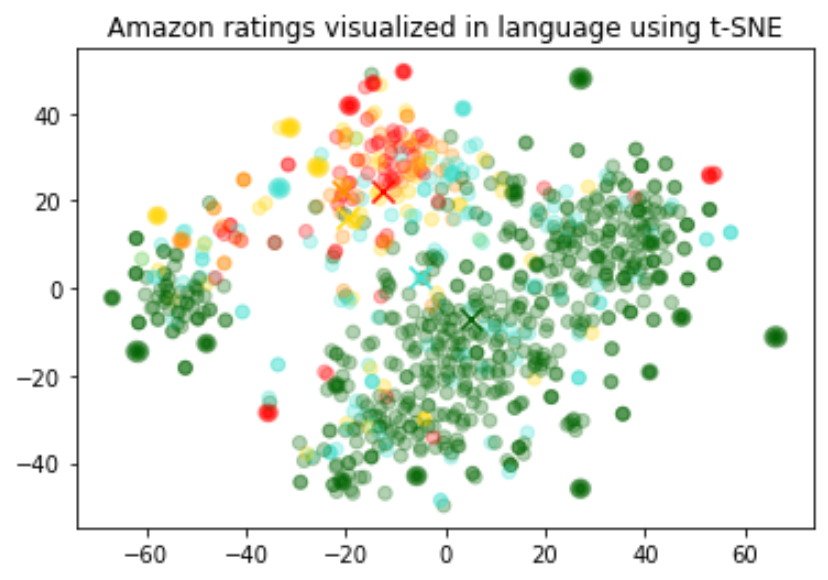
可視化の結果、大きく 3 つのクラスターに分かれているように見えます。そのうちの 1 つは、ほとんどが否定的なレビューです。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import numpy as np
import pandas as pd
from sklearn.manifold import TSNE
import matplotlib.pyplot as plt
import matplotlib

df = pd.read_csv("output/embedded_1k_reviews.csv")
matrix = np.array(df.ada_embedding.apply(eval).to_list())

# Create a t-SNE model and transform the data
tsne = TSNE(
    n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200
)
vis_dims = tsne.fit_transform(matrix)

colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]
x = [x for x, y in vis_dims]
y = [y for x, y in vis_dims]
color_indices = df.Score.values - 1

colormap = matplotlib.colors.ListedColormap(colors)
plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)
plt.title("Amazon ratings visualized in language using t-SNE")埋め込みは、機械学習モデル内で自由記述テキストの汎用的な特徴量エンコーダーとして使用できます。関連する入力の一部が自由記述テキストであれば、どのような機械学習モデルでも、埋め込みを取り入れることで性能が向上します。また、埋め込みは機械学習モデル内でカテゴリ特徴量のエンコーダーとしても使用できます。これは、職種名のように、カテゴリ変数の名前に意味があり、その種類が多い場合に特に有効です。このタスクでは、一般に類似度用の埋め込みのほうが検索用の埋め込みよりも優れた性能を発揮します。
埋め込み表現は一般に非常に豊かで、情報密度が高いことが確認できました。たとえば、SVD や PCA を使って入力の次元数を削減すると、削減率がわずか 10% でも、通常は後段の個別タスクでの性能が低下します。
このコードでは、データをトレーニングセットとテストセットに分割します。これらは、続く 2 つのユースケースである回帰と分類で使用します。
1
2
3
4
5from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    list(df.ada_embedding.values), df.Score, test_size=0.2, random_state=42
)
埋め込み特徴量による回帰
埋め込みを使うと、数値の予測をシンプルに実現できます。この例では、レビューのテキストをもとに、投稿者が付けた星の数を予測します。埋め込みには意味に関する情報が豊富に含まれるため、レビューの数がごく少なくても、まずまずの精度で予測できます。
スコアを 1 から 5 までの連続変数とみなし、アルゴリズムが任意の浮動小数点値を予測できるようにします。機械学習アルゴリズムは、予測値と実際のスコアとの差を最小化し、平均絶対誤差 0.39 を達成します。つまり、予測のずれは平均で星半分未満です。
1
2
3
4
5from sklearn.ensemble import RandomForestRegressor

rfr = RandomForestRegressor(n_estimators=100)
rfr.fit(X_train, y_train)
preds = rfr.predict(X_test)今回は、アルゴリズムに 1 から 5 までの任意の値を予測させるのではなく、レビューの星の数を、星 1 から星 5 までの 5 つのカテゴリに正確に分類することを目指します。
学習後のモデルは、微妙な違いのあるレビュー(星 2〜4)よりも、星 1 と星 5 のレビューをはるかに高い精度で予測できるようになります。これは、感情がより強く表現されているためと考えられます。
1
2
3
4
5
6from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

clf = RandomForestClassifier(n_estimators=100)
clf.fit(X_train, y_train)
preds = clf.predict(X_test)埋め込みを使えば、ラベル付きの学習データがなくてもゼロショット分類を行えます。各クラスについて、クラス名またはクラスの短い説明を埋め込みに変換します。新しいテキストをゼロショットで分類するには、その埋め込みをすべてのクラスの埋め込みと比較し、類似度が最も高いクラスを予測結果とします。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";

const client = new OpenAI();
const labels = ["negative", "positive"];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...labels, "The coffee arrived quickly and tastes great."],
});

const review = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * review[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...review));
};

const [negative, positive] = data.map(({ embedding }) => similarity(embedding));
console.log(positive > negative ? "positive" : "negative");
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18df = df[df.Score != 3]
df["sentiment"] = df.Score.replace(
{1: "negative", 2: "negative", 4: "positive", 5: "positive"}
)
labels = ["negative", "positive"]
label_embeddings = [get_embedding(label, model=model) for label in labels]
def label_score(review_embedding, label_embeddings):
return cosine_similarity(review_embedding, label_embeddings[1]) - cosine_similarity(
review_embedding, label_embeddings[0]
)
prediction = (
"positive" if label_score(get_embedding("Sample Review", model=model), label_embeddings) > 0 else "negative"
)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("negative", "positive", "Sample Review"))
.build())
.data();
List<Float> review = embeddings.get(2).embedding();
double negative = cosineSimilarity(review, embeddings.get(0).embedding());
double positive = cosineSimilarity(review, embeddings.get(1).embedding());
System.out.println(positive > negative ? "positive" : "negative");1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"
client = OpenAI::Client.new
labels = ["negative", "positive"]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: labels + ["The coffee arrived quickly and tastes great."]
)
review = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(review).sum { |value, review_value| value * review_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
review_magnitude = Math.sqrt(review.sum { |value| value**2 })
dot_product / (magnitude * review_magnitude)
end
negative, positive = response.data.first(2).map do |embedding|
similarity.call(embedding.embedding)
end
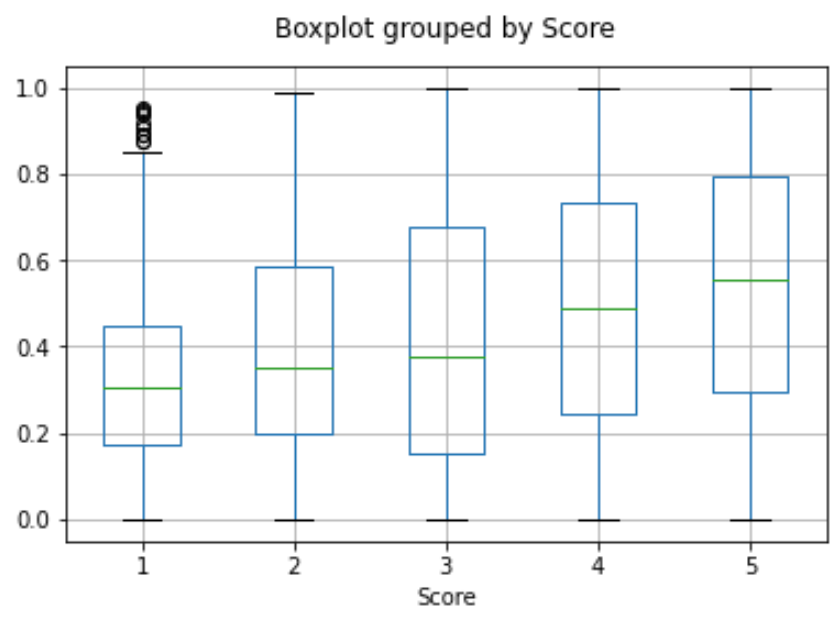
puts((positive > negative) ? "positive" : "negative")ユーザーが投稿したすべてのレビューの埋め込みを平均すると、そのユーザーの埋め込みを取得できます。同様に、ある商品に対するすべてのレビューの埋め込みを平均すると、その商品の埋め込みを取得できます。この手法の有用性を示すため、ユーザーごと、商品ごとにより多くのレビューを含められるよう、5 万件のレビューからなるサブセットを使用します。
これらの埋め込みの有用性を別のテストセットで評価し、ユーザーと商品の埋め込みの類似度を評価スコアごとにプロットします。興味深いことに、この手法では、ユーザーに商品が届く前でも、その商品を気に入るかどうかをランダムな予測より高い精度で予測できます。
user_embeddings = df.groupby("UserId").ada_embedding.apply(np.mean)
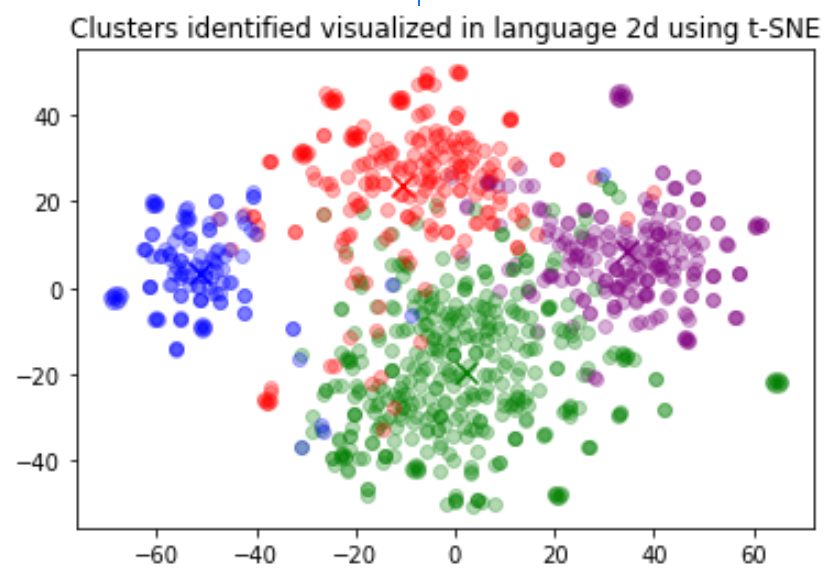
prod_embeddings = df.groupby("ProductId").ada_embedding.apply(np.mean)クラスタリングは、大量のテキストデータを理解するための手法のひとつです。埋め込みは各テキストの意味を反映したベクトル表現を提供するため、このタスクに役立ちます。埋め込みを使ってクラスタリングすると、教師なしでデータセット内に隠れたグループを見つけられます。
この例では、ドッグフードを中心とするクラスターが 1 つ、否定的なレビューのクラスターが 1 つ、肯定的なレビューのクラスターが 2 つ、計 4 つの明確に分かれたクラスターが見つかります。
1
2
3
4
5
6
7
8
9import numpy as np
from sklearn.cluster import KMeans

matrix = np.vstack(df.ada_embedding.values)
n_clusters = 4

kmeans = KMeans(n_clusters=n_clusters, init="k-means++", random_state=42)
kmeans.fit(matrix)
df["Cluster"] = kmeans.labels_
よくある質問
埋め込み生成前の文字列のトークン数の確認方法
Python では、OpenAI のトークナイザー tiktoken を使って文字列をトークンに分割できます。
コード例:
1
2
3
4
5
6
7
8
9
10
11import tiktoken


def num_tokens_from_string(string: str, encoding_name: str) -> int:
    """Returns the number of tokens in a text string."""
    encoding = tiktoken.get_encoding(encoding_name)
    num_tokens = len(encoding.encode(string))
    return num_tokens


num_tokens_from_string("tiktoken is great!", "cl100k_base")
text-embedding-3-small などの第 3 世代の埋め込みモデルには、cl100k_base エンコーディングを使用します。
詳しい説明とコード例は、OpenAI Cookbook のガイド「tiktoken でトークン数を数える方法」を参照してください。
最近傍の埋め込みベクトル K 個を高速に取得する方法
大量のベクトルを高速に検索するには、ベクトルデータベースの使用をお勧めします。ベクトルデータベースと OpenAI API を組み合わせた使用例は、GitHub 上の Cookbook で確認できます。
距離関数の選び方
コサイン類似度をお勧めします。通常、どの距離関数を選んでも大きな違いはありません。
OpenAI の埋め込みは長さが 1 になるように正規化されているため、次の性質があります。
- 内積だけでコサイン類似度を求められるため、計算が少し速くなります
- コサイン類似度とユークリッド距離のどちらを使っても、ランキングは同じになります
埋め込みのオンライン共有は可能ですか?
はい。埋め込みを含め、当社のモデルへの入力とモデルからの出力はお客様に帰属します。当社の API に入力するコンテンツが適用法や当社の利用規約に違反しないようにする責任は、お客様にあります。
V3 埋め込みモデルには最近の出来事に関する知識がありますか?
いいえ。text-embedding-3-large と text-embedding-3-small のモデルには、2021 年 9 月より後に起きた出来事に関する知識はありません。通常、テキスト生成モデルほど大きな制約にはなりませんが、一部の特殊なケースでは性能が低下することがあります。