
OpenAI は、リーズニングモデル(o3 や o4-mini など)と GPT モデル(GPT-4.1 など)の 2 種類のモデルを提供しています。この 2 つのモデルファミリーは、それぞれ動作の特性が異なります。
このガイドでは、以下の内容を説明します。
- OpenAI のリーズニングモデルと、推論を行わない GPT モデルの違い
- OpenAI のリーズニングモデルが適している場面
- リーズニングモデルに効果的なプロンプトの作成方法
リーズニングモデルとその仕組みについて、詳しく説明しています。
リーズニングモデルと GPT モデルの比較
OpenAI の o シリーズのモデルは、GPT モデルとは得意なタスクが異なり、適切なプロンプトも異なります。どちらかのモデルファミリーが優れているというわけではなく、それぞれに異なる特性があります。
OpenAI は、o シリーズのモデルを「計画担当」として、複雑なタスクに対してより長く、より深く考えるようにトレーニングしました。そのため、戦略の立案、複雑な問題の解決策の計画、大量の曖昧な情報に基づく意思決定に優れています。また、高い正確性と精度でタスクを実行できるため、数学、科学、エンジニアリング、金融サービス、法律サービスなど、通常は人間の専門家を必要とする分野に最適です。
一方、レイテンシが低く、コスト効率に優れた GPT モデルは「実務担当」として、明確なタスクの実行を目的に設計されています。たとえば、アプリケーションで o シリーズのモデルを使って問題解決の戦略を立て、GPT モデルで個々のタスクを実行するという使い方が考えられます。特に、完全な正確性よりも速度とコストが重要な場合に適しています。
モデルの選び方
ユースケースで最も重視することは何ですか?
- 速度とコスト → GPT モデルはより高速で、コストも低い傾向があります
- 明確に定義されたタスクの実行 → GPT モデルは明確に定義されたタスクを得意としています
- 正確性と信頼性 → o シリーズのモデルは信頼性の高い意思決定ができます
- 複雑な問題の解決 → o シリーズのモデルは曖昧さや複雑さに対処できます
タスクの完了において速度とコストが最も重要で、 かつ ユースケースが単純で明確に定義されたタスクで構成されている場合は、GPT モデルが最適です。一方、正確性と信頼性が最も重要で、 かつ 解決すべき問題が非常に複雑で複数のステップを要する場合は、o シリーズのモデルが適していると考えられます。
多くの AI ワークフローでは、エージェントによる計画や意思決定には o シリーズ、タスクの実行には GPT シリーズというように、両方のモデルを組み合わせて使用することになります。
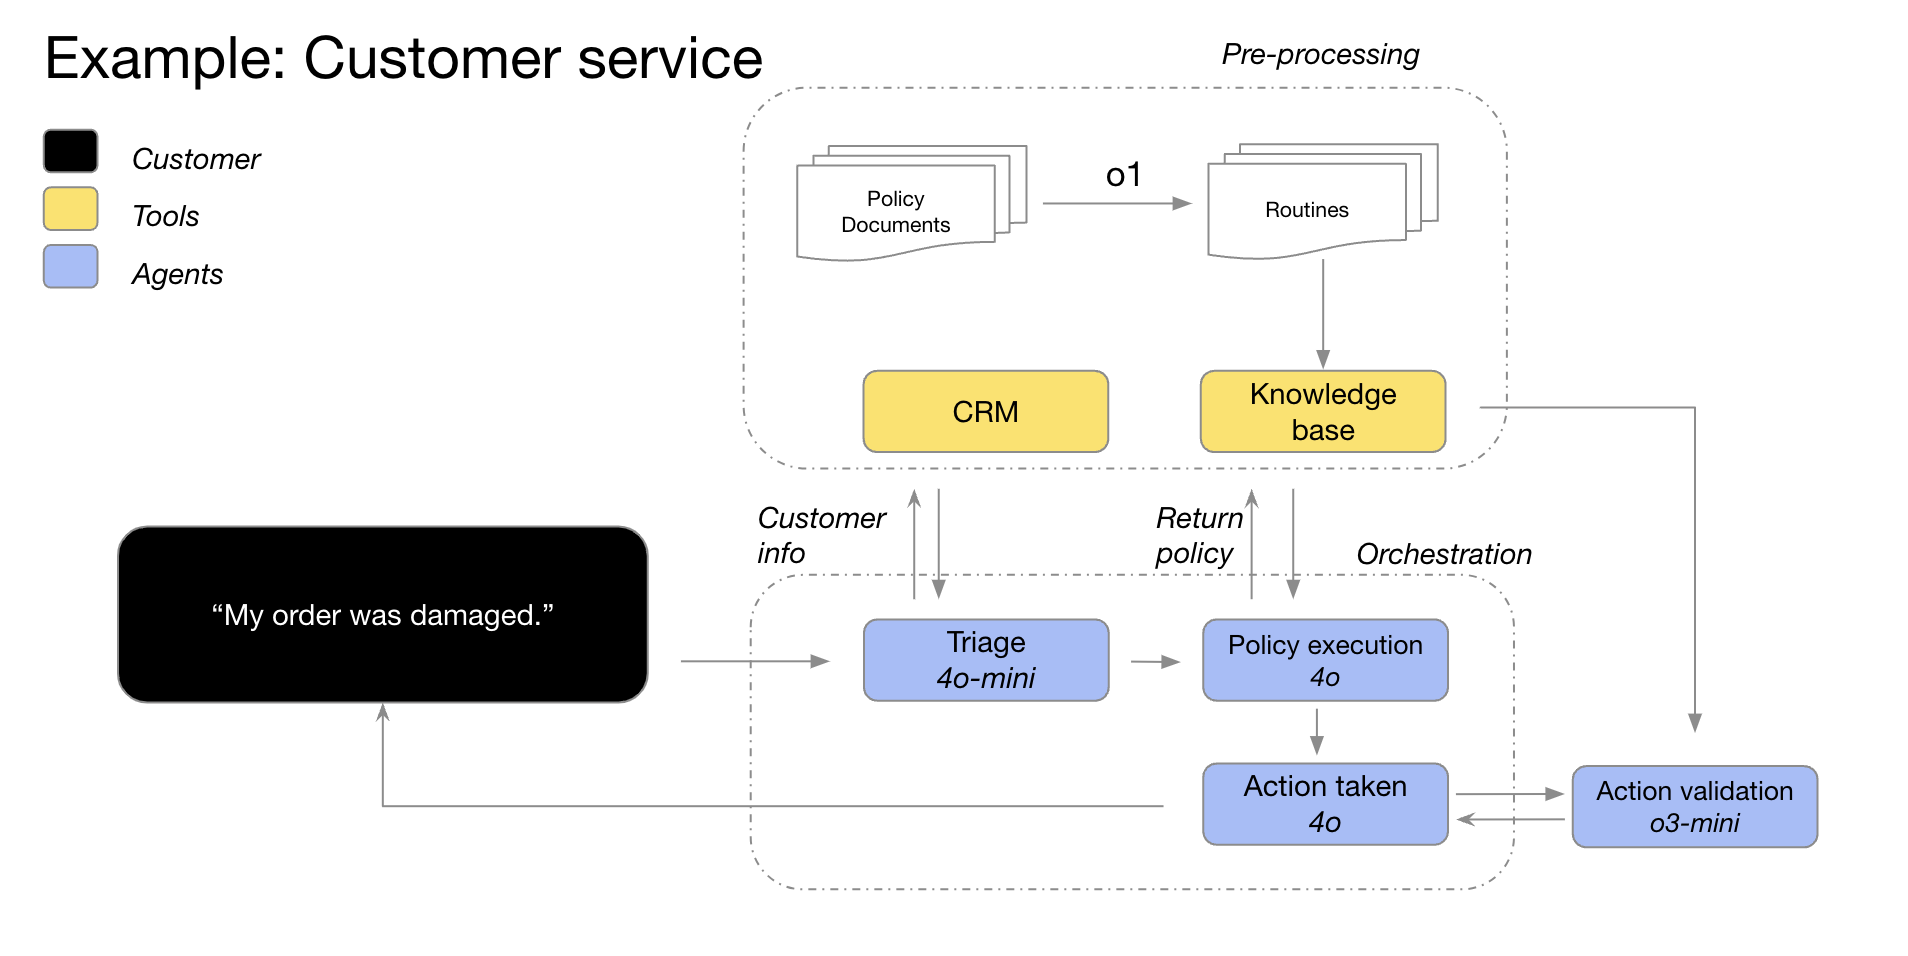
GPT-4o と GPT-4o mini が顧客情報とともに注文の詳細を確認・分類し、注文に関する問題と返品ポリシーを特定します。その後、これらのデータをすべて o3-mini に渡し、ポリシーに基づいて返品の可否を最終判断します。
OpenAI のリーズニングモデルが適している場面
ここでは、お客様や OpenAI 社内で成果が見られた活用パターンをいくつか紹介します。考えられるすべてのユースケースを網羅したものではなく、o シリーズのモデルを試す際に役立つ実践的な指針です。
リーズニングモデルを使ってみませんか?クイックスタートへ →
1. 曖昧なタスクへの対応
リーズニングモデルは、情報が限られていたり、断片的だったりしても、シンプルなプロンプトからユーザーの意図を理解し、指示の不足に対応することを特に得意としています。実際、根拠のない推測や不足情報の補完を試みる前に、確認の質問をすることがよくあります。
「o1 の推論能力により、当社のマルチエージェントプラットフォーム Matrix は、複雑な文書を処理する際に、網羅的で、体裁が整った詳細な回答を生成できるようになりました。たとえば、o1 を使うことで、Matrix は基本的なプロンプトだけで、融資契約の制限付き支払い条項において利用可能な例外許容枠(バスケット)を容易に特定できました。従来のモデルでこれほどの性能を発揮するものはありません。内容が密な融資契約書に関する複雑なプロンプトの 52% で、o1 は他のモデルよりも優れた結果を出しました。」
—Hebbia、法律・金融分野向け AI ナレッジプラットフォーム企業
2. 大量の情報に埋もれた重要事項の発見
大量の非構造化情報を渡した場合でも、リーズニングモデルはその内容を理解し、質問への回答に最も関連する情報だけを抽出することに優れています。
「ある企業の買収を分析するため、o1 は契約書や賃貸借契約書など数十件の企業文書を確認し、取引に影響しうる複雑な条件を探しました。重要な条項を指摘するよう依頼したところ、脚注にある重大な『支配権の変更』条項を特定しました。その企業が売却された場合、7,500 万ドルの融資を直ちに返済しなければならないという内容です。o1 が細部にまで徹底して注意を払うことで、当社の AI エージェントは業務上極めて重要な情報を特定し、金融の専門家を支援できます。」
—Endex、AI 金融インテリジェンスプラットフォーム
3. 大規模なデータセットにおける関係性や微妙な意味の把握
リーズニングモデルは、法的契約書、財務諸表、保険金請求書など、情報密度の高い非構造化情報が数百ページにわたる複雑な文書を対象とした推論に、特に優れていることがわかっています。文書間の共通点を見いだし、データに暗に示されている事実に基づいて意思決定することを特に得意としています。
「税務リサーチでは、複数の文書を総合し、最終的に筋の通った回答を導き出す必要があります。GPT-4o から o1 に切り替えたところ、文書間の関係を推論し、どの文書も単独では明らかにしていない論理的な結論を導く能力が、o1 の方がはるかに優れていることがわかりました。その結果、o1 への切り替えで処理全体の性能が 4 倍になりました。驚くべき成果です。」
—Blue J、税務リサーチ向け AI プラットフォーム
リーズニングモデルは、細かな解釈が必要なポリシーやルールを推論し、それらを目の前のタスクに適用して、妥当な結論に達することも得意としています。
「財務分析では、アナリストは株主持分に関する複雑な状況を扱うことが多く、関連する法律上の細かな論点を理解する必要があります。私たちは、複数のプロバイダーの約 10 種類のモデルに、難しいもののよくある質問を投げかけてテストしました。資金調達は既存株主にどのような影響を与えるのか、特に希薄化防止の権利を行使した場合はどうなるのか、という質問です。これには、資金調達前後の企業価値評価に基づく推論と、希薄化計算の循環参照への対応が必要で、一流の金融アナリストでも解明に 20~30 分かかります。o1 と o3-mini は、これを完璧にこなせることがわかりました!さらに、10 万ドル分の株式を保有する株主への影響を示す、わかりやすい計算表まで作成しました。」
–BlueFlame AI、投資管理向け AI プラットフォーム
4. エージェントによる複数ステップの計画
リーズニングモデルは、エージェントによる計画や戦略の立案に欠かせません。リーズニングモデルを「計画担当」として使い、問題に対する詳細な解決策を複数のステップに分けて作成したうえで、各ステップで高い応答性能と低レイテンシのどちらを最優先するかに応じて、適切な GPT モデルを「実行担当」として選び、割り当てる方法で成果が見られています。
「当社のエージェント基盤では、o1 を計画担当として使用しています。ワークフロー内の他のモデルを統括し、複数ステップのタスクを完了させる役割です。o1 はデータ型の選択や、大きな問いを小さな単位に分解することに非常に優れており、他のモデルが実行に集中できるようになります。」
—Argon AI、製薬業界向け AI ナレッジプラットフォーム
「仕事用 AI アシスタント Lindy では、エージェントを活用した多くのワークフローを o1 が支えています。このモデルは Function Calling を使ってカレンダーやメールから情報を取得し、会議のスケジュール設定、メールの送信、その他の日常業務の管理を自動的に支援できます。以前は問題が起きていたエージェントの処理ステップをすべて o1 に切り替えたところ、一夜にしてエージェントがほぼ完璧に動作するようになりました!」
—Lindy.AI、仕事用 AI アシスタント
5. 視覚的推論
現時点で、画像認識機能をサポートするリーズニングモデルは o1 のみです。GPT-4o との違いは、構造が曖昧なグラフや表、画質の悪い写真など、解釈が極めて難しい視覚情報でも理解できる点です。
「当社は、高級ジュエリーの模倣品、絶滅危惧種、規制物質など、オンライン上の数百万点の製品について、リスクとコンプライアンスのレビューを自動化しています。最も難しい画像分類タスクで、GPT-4o の正解率は 50% でした。o1 は、パイプラインを一切変更せずに、88% という優れた正解率を達成しました。」
—SafetyKit、AI を活用したリスク・コンプライアンスプラットフォーム
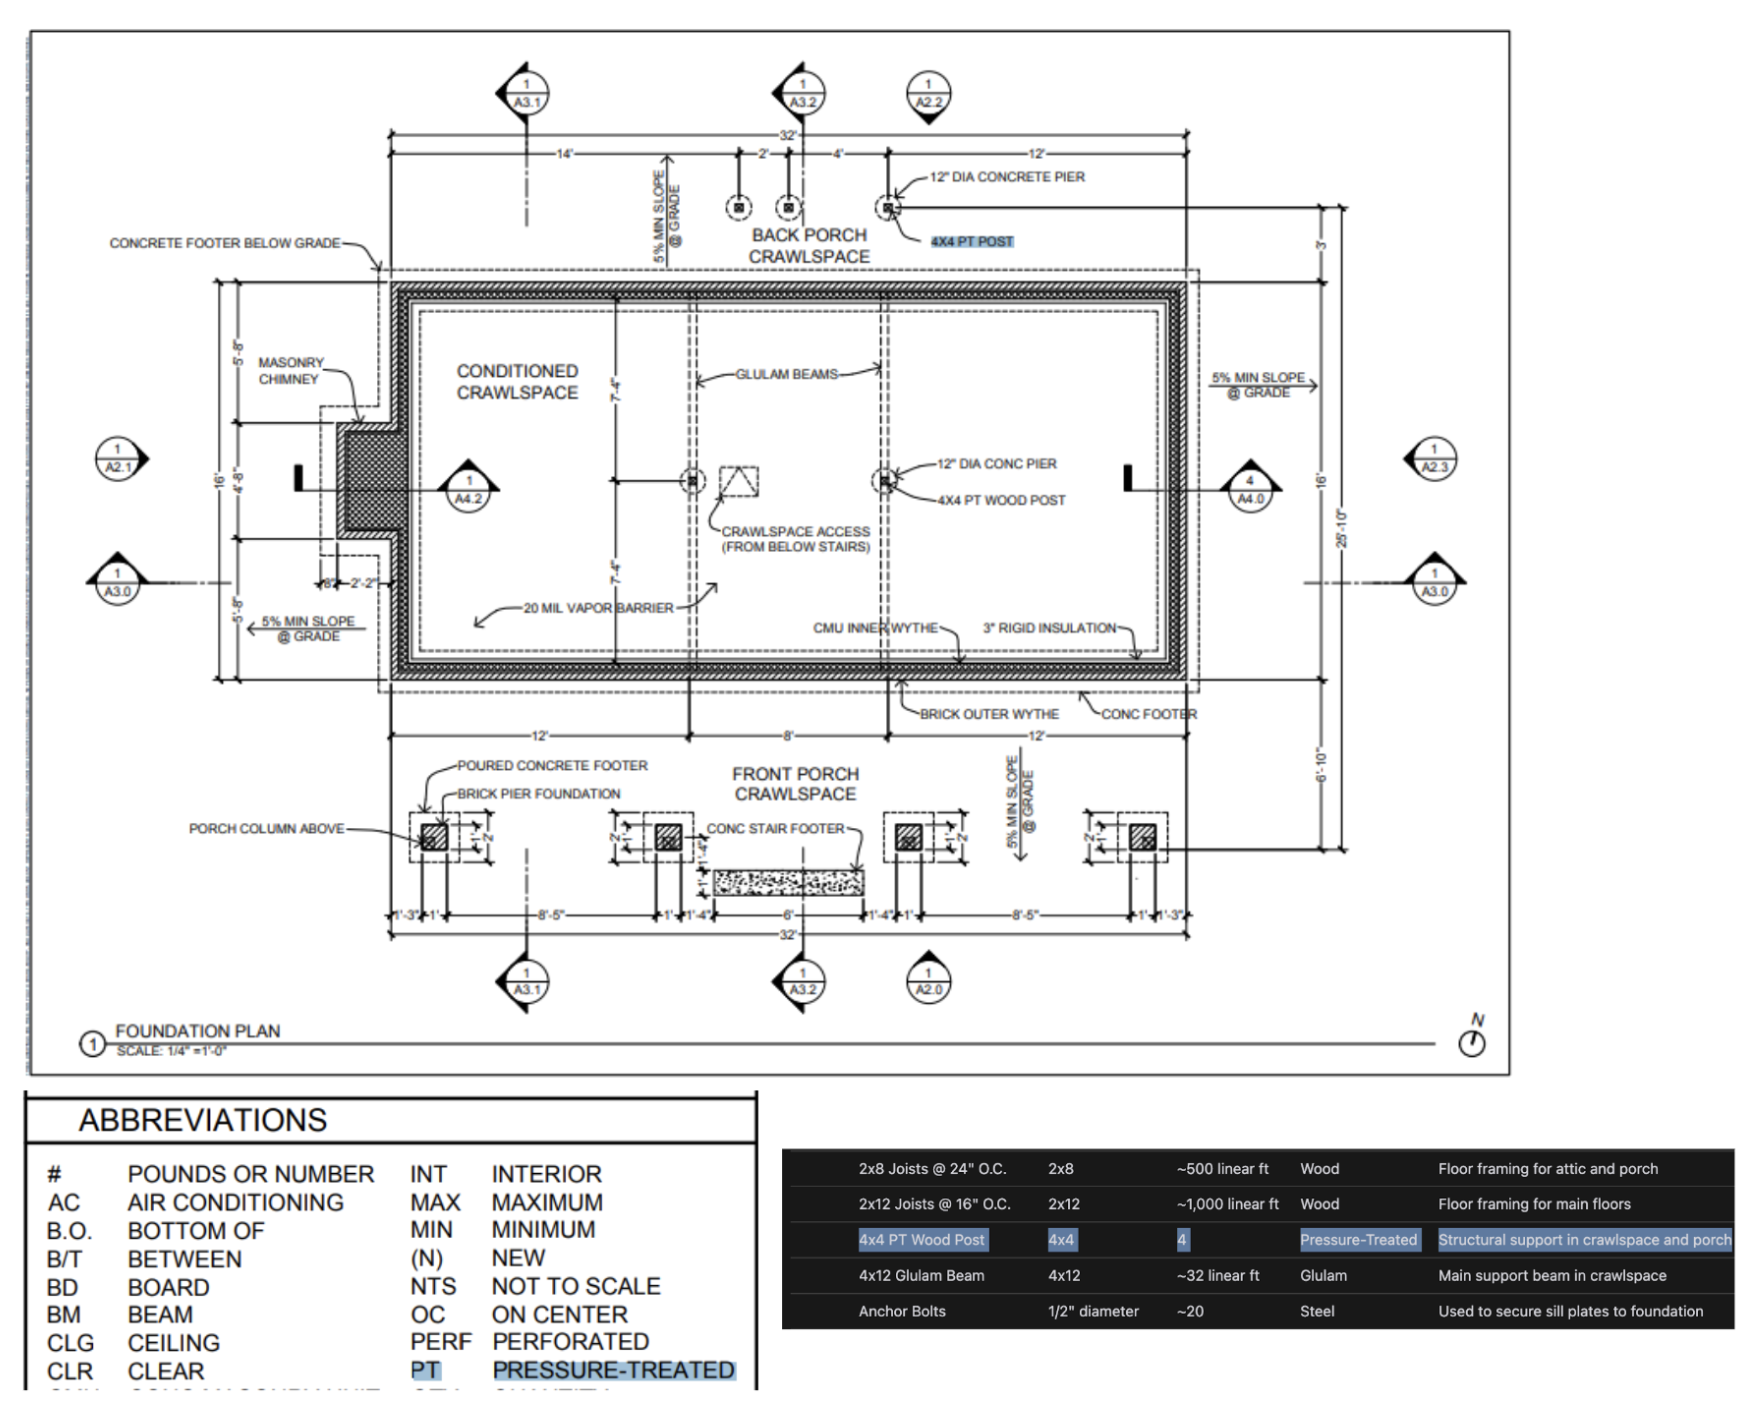
OpenAI の社内テストでは、o1 が非常に詳細な建築図面から設備や材料を特定し、網羅的な部材表を作成できることを確認しています。特に驚いたのは、明示的な指示がなくても、建築図面のあるページの凡例を別のページに正しく適用するなど、異なる画像間の対応関係を把握できたことです。以下の例では、4x4 PT 木柱について、o1 が凡例を基に「PT」は加圧処理を意味すると認識しています。
6. コードのレビュー、デバッグ、品質向上
リーズニングモデルは、大量のコードのレビューや改善に特に効果的です。レイテンシが高いため、コードレビューはバックグラウンドで実行されることがよくあります。
「当社は、GitHub や GitLab などのプラットフォームで、AI による自動コードレビューを提供しています。コードレビューは本来、レイテンシにそれほど敏感な処理ではありませんが、複数のファイルにまたがるコードの差分を理解する必要があります。ここで o1 が真価を発揮します。人間のレビュアーが見落とす可能性のある、コードベースの小さな変更も確実に検出できます。o シリーズのモデルに切り替えた後、製品のコンバージョン率を 3 倍に高めることができました。」
—CodeRabbit、AI コードレビューのスタートアップ企業
GPT-4o と GPT-4o mini はレイテンシが低いため、コードの作成により適している場合があります。一方、レイテンシの重要度がやや低いユースケースでは、o3-mini もコード生成で優れた性能を示しています。
「o3-mini は、問題を的確に解決する高品質なコードを安定して生成します。問題が明確に定義されていれば、非常に難しいコーディングタスクでも、高い確率で正しい解決策にたどり着きます。他のモデルは小規模なコード修正を素早く繰り返す用途にしか役立たない場合がありますが、o3-mini は複雑なソフトウェアシステムの設計計画と実装に優れています。」
—Windsurf、Codeium が開発した、エージェント型 AI を活用した協働型 IDE
7. 他のモデルの回答の評価とベンチマーク
リーズニングモデルは、他のモデルの回答のベンチマークや評価でも優れた成果を示しています。データ検証は、特にヘルスケアのような慎重さを要する分野において、データセットの品質と信頼性を確保するために重要です。従来の検証方法はあらかじめ定義されたルールやパターンを使用しますが、o1 や o3-mini のような高度なモデルは、コンテキストを理解し、データについて推論することで、より柔軟で知的な検証を実現できます。
「多くのお客様が、Braintrust での評価プロセスの一環として LLM-as-a-judge を使用しています。たとえば、ヘルスケア企業が gpt-4o のような実務担当モデルで患者の質問を要約し、その要約の品質を o1 で評価するケースがあります。ある Braintrust のお客様では、評価役のモデルの F1 スコアが、4o の 0.12 から o1 の 0.74 に向上しました!こうしたユースケースでは、最も難しく複雑な採点タスクにおいて、生成された回答の微妙な違いを見つけるうえで、o1 の推論が飛躍的な改善をもたらすと実感されています。」
—Braintrust、AI 評価プラットフォーム
リーズニングモデルに効果的なプロンプトの書き方
これらのモデルは、簡潔で明確なプロンプトで最も高い性能を発揮します。「段階的に考えてください」と指示するなど、一部のプロンプトエンジニアリング手法は、性能の向上につながらず、場合によっては低下させることもあります。以下のベストプラクティスを参照するか、プロンプトの例を試してみてください。
- システムメッセージに代わる開発者メッセージ:
o1-2024-12-17以降のリーズニングモデルは、Model Spec に記載された指示の優先順位に沿って動作するよう、システムメッセージではなく開発者メッセージをサポートしています。 - 簡潔で明確なプロンプト:これらのモデルは、短く明確な指示を理解し、それに応じた回答を生成することに優れています。
- 思考の連鎖を求めるプロンプトは不要:これらのモデルは内部で推論するため、「段階的に考えてください」や「推論の過程を説明してください」と指示する必要はありません。
- 区切りによる明確化:Markdown、XML タグ、セクション見出しなどを使って入力の各部分を明確に区切ると、モデルが各セクションを適切に解釈しやすくなります。
- まずはゼロショット、必要に応じてフューショット:リーズニングモデルは、フューショットの例がなくても良い結果を得られることが多いため、まずは例を含めずにプロンプトを書いてみてください。求める出力の要件が複雑な場合は、入力と望ましい出力の例をいくつかプロンプトに含めると役立つことがあります。ただし、例とプロンプトの指示が食い違うと結果が悪くなる可能性があるため、両者が十分に一致していることを確認してください。
- 具体的なガイドラインの提示:モデルの回答に制約を設けたい場合は、「予算 $500 未満で実現できる解決策を提案してください」のように、その制約をプロンプトに明記してください。
- 最終目標の具体化:望ましい回答が満たすべき条件をできるだけ具体的に指示し、その条件を満たすまで推論と改善を繰り返すようモデルに促してください。
- Markdown 形式:
o1-2024-12-17以降、API のリーズニングモデルは Markdown 形式での回答生成を避けるようになっています。回答に Markdown 形式を使用してほしい場合は、開発者メッセージの最初の行に文字列Formatting re-enabledを含めてください。
低コストと高精度を両立する方法
o3 と o4-mini の導入に伴い、Responses API に保存された推論項目の扱いが変わりました。従来のモデル(o1、o3-mini、o1-mini、o1-preview)では、後続の API リクエストの入力項目に推論項目を含めても、常に無視されていました。o3 と o4-mini では、関数呼び出しの前後にある一部の推論項目がモデルのコンテキストに含まれます。これにより、推論トークンの使用量を最小限に抑えながら、モデルの性能を向上させます。
この変更を最大限に活用するには、Responses API で store パラメーターを true に設定し、過去のリクエストの推論項目をすべて渡すことをお勧めします。これには、previous_response_id を使用するか、過去のリクエストの出力項目をすべて新しいリクエストの入力項目として渡します。OpenAI は、関連する推論項目を自動的にモデルのコンテキストに含め、関連しない項目を無視します。モデルのコンテキストに含める内容をより細かく管理したい高度なユースケースでは、少なくとも、直前のユーザーメッセージから最新の関数呼び出しまでの間にある推論項目をすべて含めることをお勧めします。これにより、関数呼び出しに応答した際にモデルが推論を最初からやり直す必要がなくなり、Function Calling の性能が向上するとともに、全体のトークン使用量が減ります。
Chat Completions API を使用する場合、推論項目がモデルのコンテキストに含まれることはありません。これは、Chat Completions がステートレスな API であるためです。そのため、多数の関数呼び出しを伴う複雑なエージェント型のユースケースでは、モデルの性能がやや低下し、推論トークンの使用量が増えます。複数回の Function Calling を伴う複雑な処理がない場合は、どちらの API を使用しても性能の低下はないと考えられます。
その他のリソース
さらにアイデアを得るには、サンプルコードやサードパーティーのリソースへのリンクを掲載した OpenAI Cookbook をご覧ください。また、以下のリソースでは、モデルや推論機能について詳しく学べます。