
GPT-5 の公開を機に、その組み込みに最適な Responses API について、もう少し詳しくご紹介します。Responses がリーズニングモデルと、エージェントが活躍するこれからの時代に合わせて設計されている理由も説明します。
OpenAI の API は、どの世代も同じ問いを軸に開発してきました。 開発者がモデルとやり取りするための、最もシンプルで強力な方法は何か。
私たちの API 設計は、常にモデル自体の仕組みを指針としてきました。最初の /v1/completions エンドポイントはシンプルでしたが、制約もありました。モデルにプロンプトを渡すと、単にその文章の続きを生成する仕組みでした。フューショットプロンプティングなどの手法を使えば、JSON の出力や質問への回答といった動作をモデルに促すことはできましたが、その能力は、今では当たり前になっているモデルの能力を大きく下回っていました。
その後、RLHF、ChatGPT、そして事後学習の時代が到来しました。モデルは書きかけの文章を補完するだけでなく、会話の相手のように 応答する ようになったのです。この変化に対応するため、私たちは /v1/chat/completions を開発しました(たった一度の週末で開発したという話はよく知られています)。system、user、assistant といったロールを用意することで、カスタム指示やコンテキストを組み込んだチャットインターフェースを素早く構築できる土台を提供しました。
モデルは進化を続け、やがて見ること、聞くこと、話すことができるようになりました。2023 年後半に導入した Function Calling は、特に人気の高い機能の一つとなりました。同じ頃、Assistants API のベータ版を公開しました。Code Interpreter やファイル検索といったホスト型ツールを備えた、全面的にエージェント型のインターフェースへの初めての試みです。一部の開発者には好評でしたが、Chat Completions と比べて API 設計に制約があり、導入も難しかったため、広く普及するには至りませんでした。
2024 年後半には、統合が必要なことは明らかでした。Chat Completions と同じくらい使い始めやすく、Assistants と同じくらい強力で、なおかつマルチモーダルモデルとリーズニングモデルのために設計されたものが必要だったのです。そこで登場したのが /v1/responses です。
エージェント型ループとしての /v1/responses
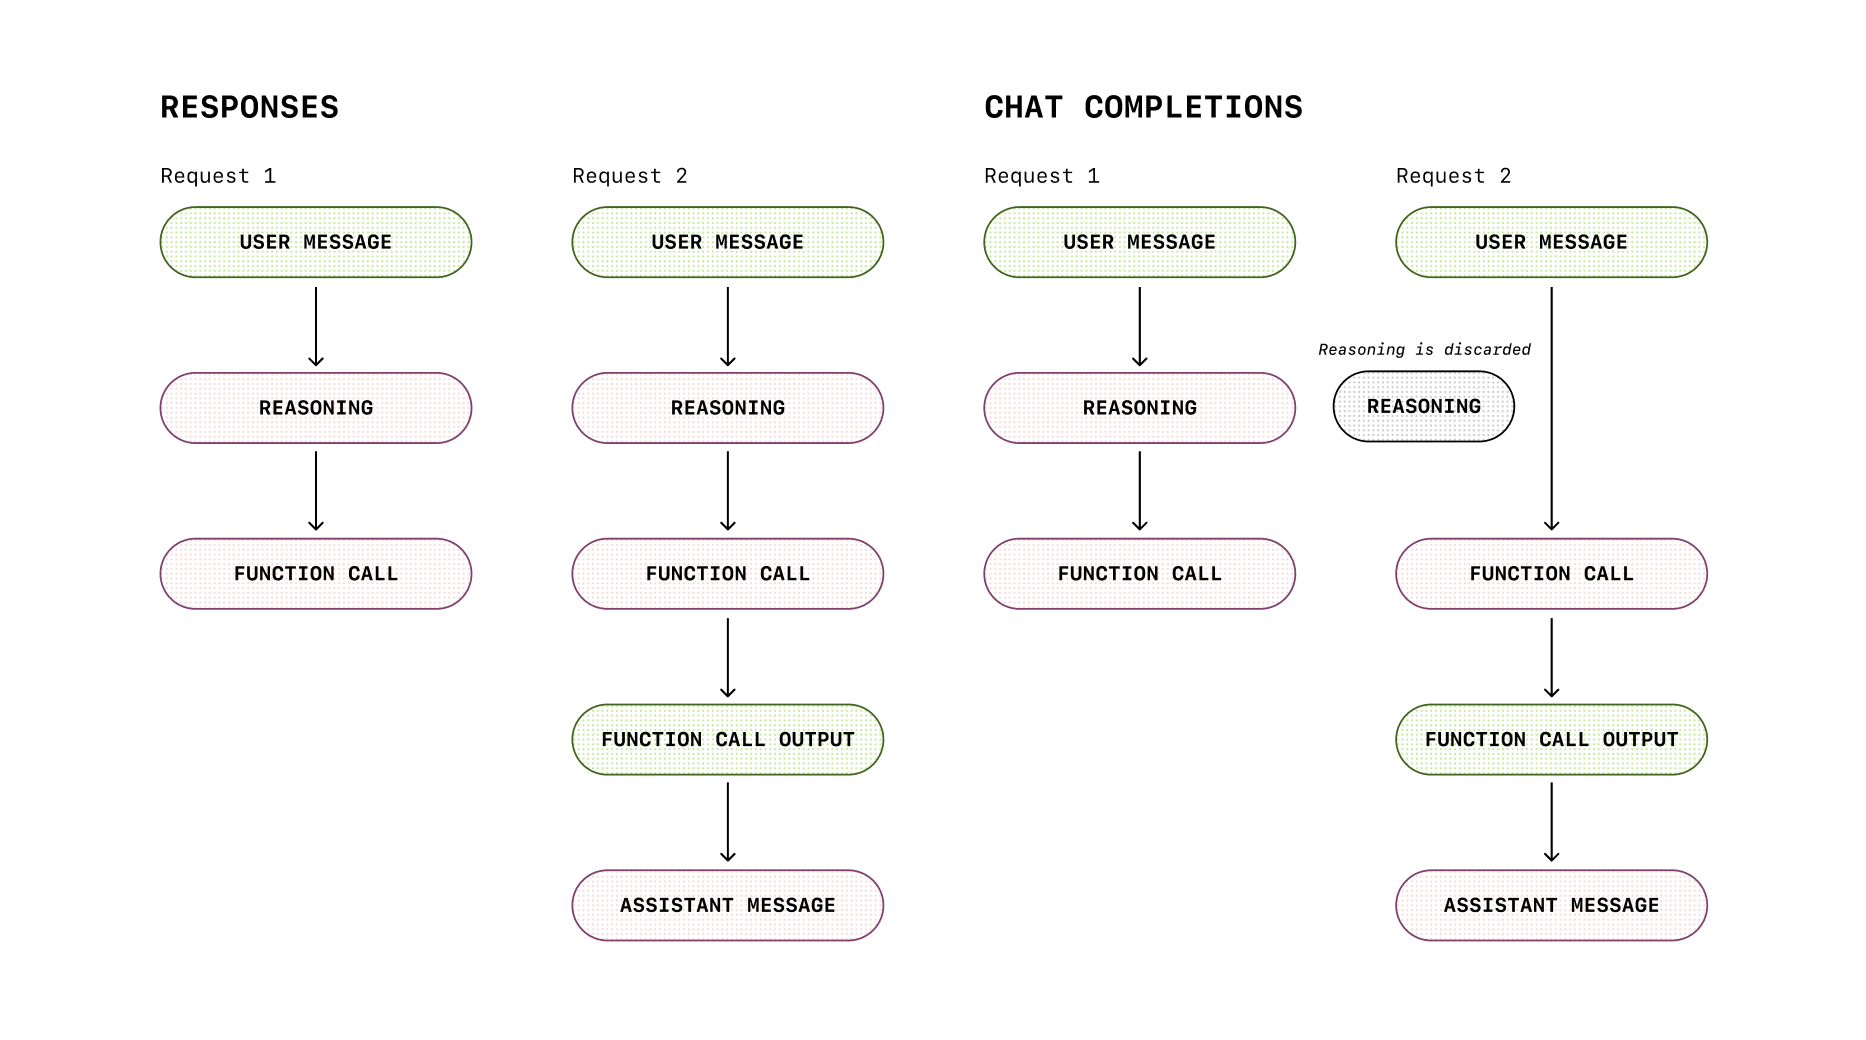
Chat Completions は、ターンごとにやり取りするシンプルなチャットインターフェースを提供していました。一方、Responses は、推論と行動を繰り返す構造化されたループを提供します。探偵に調査を依頼する場面を想像してみてください。証拠を渡すと、探偵は調査を行い、必要に応じて専門家(ツール)に相談し、最後に結果を報告します。探偵は各段階の間も自分用のメモ(推論状態)を保持しますが、それを依頼人に渡すことはありません。
ここでリーズニングモデルが真価を発揮します。Responses は、ターンをまたいでモデルの 推論状態 を保持します。Chat Completions では、呼び出しと呼び出しの間に推論が失われます。探偵が部屋を出るたびに手がかりを忘れてしまうようなものです。Responses ではノートを開いたままにするように、段階的な思考プロセスが次のターンに引き継がれます。その効果は、ベンチマーク(TAUBench で +5%)や、キャッシュ利用効率とレイテンシの改善に表れています。
Responses は複数の出力アイテムを返すこともできます。モデルが 何を言ったかだけでなく、 何をしたかもわかります。ツール呼び出し、構造化出力、途中のステップといった記録を受け取れるのです。完成した文章と、下書きに残された計算過程の両方を受け取るようなものです。デバッグや監査、より充実した UI の構築に役立ちます。
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},ホスト型ツールによる提供範囲の拡大
Function Calling の初期に、私たちは重要な利用パターンに気付きました。開発者はモデルを使って API を呼び出すだけでなく、ドキュメントストアを検索して外部データを取り込んでいました。現在 RAG と呼ばれる手法です。しかし、開発を始めたばかりの人にとって、検索・取得のパイプラインを一から構築するのは難しく、コストもかかります。Assistants では、初の ホスト型 ツールとして file_search と code_interpreter を導入しました。これにより、モデルは RAG を利用したりコードを書いたりして、依頼された問題を解決できるようになりました。Responses ではさらに一歩進め、ウェブ検索、画像生成、MCP を追加しています。また、Code Interpreter や MCP などのホスト型ツールを通じてサーバー側でツールを実行するため、呼び出しのたびに自前のバックエンドを経由する必要がなく、レイテンシと往復通信のコストを抑えられます。
推論の安全な保持
では、なぜこれほど手間をかけて、モデルの生の思考の連鎖(CoT)を隠すのでしょうか。CoT をそのまま公開し、クライアントがほかのモデル出力と同じように扱えるようにする方が簡単ではないでしょうか。端的に言うと、生の CoT の公開にはさまざまなリスクがあるためです。ハルシネーションや、最終回答では生成されない有害な内容が含まれる可能性があり、OpenAI にとっては競争上のリスクも生じます。
昨年後半に o1-preview を公開した際、チーフサイエンティストの Jakub Pachocki はブログに次のように記しました。
私たちは、非公開の思考の連鎖が、モデルの監視に独自の機会をもたらすと考えています。それが実際の思考を忠実に反映し、読み解けるものであれば、非公開の思考の連鎖を通じてモデルの「心を読み」、その思考プロセスを理解できます。たとえば将来、ユーザーを操ろうとする兆候がないか、思考の連鎖を監視したいと考えるかもしれません。ただし、そのためには、モデルが思考をありのままに自由に表現できる必要があります。そのため、思考の連鎖に対して、ポリシーへの準拠やユーザーの好みに沿うような学習を施すことはできません。また、アラインメントが施されていない思考の連鎖を、そのままユーザーに見せることも望んでいません。
Responses では、次の方法でこの課題に対応しています。
- 推論を暗号化して内部に保持し、クライアントには非公開
- 生の CoT を公開せず、
previous_response_idまたは推論アイテムを通じて安全に継続可能
/v1/responses が開発に最適な理由
Responses は、 ステートフルで、マルチモーダルに対応し、効率的に動作するよう設計しました。
- エージェントによるツールの活用: Responses API を使えば、ファイル検索、画像生成、Code Interpreter、MCP などのツールで、エージェント型ワークフローを簡単に強化できます。
- デフォルトでステートフル。 会話とツールの状態を自動的に追跡します。これにより、推論や複数ターンにわたるワークフローが格段に扱いやすくなります。Responses 経由で組み込んだ GPT-5 は、保持された推論を活用するだけで、Chat Completions と比べて TAUBench のスコアが 5% 向上します。
- 設計の土台からマルチモーダルに対応。 テキスト、画像、音声、関数呼び出しのすべてを、基本機能として扱います。テキスト API にほかのモダリティを後付けしたわけではありません。家にたとえるなら、最初から十分な数の寝室を用意して設計したのです。
- コストを抑え、性能を向上。 社内ベンチマークでは、Chat Completions と比べてキャッシュ利用効率が 40–80% 向上しています。これが、レイテンシの低減とコスト削減につながります。
- 設計の改善: Chat Completions API と Assistants API の両方から得た多くの学びを基に、Responses API と SDK に、使い勝手を高める細かな改善を数多く加えました。たとえば、次のようなものです。
- 意味に基づいたストリーミングイベント
- 内部タグによる多態性
- SDK の
output_textヘルパー(choices.[0].message.contentは不要) - マルチモーダルと推論に関するパラメータの整理
Chat Completions の今後
Chat Completions がなくなるわけではありません。用途に合っているなら、そのまま使い続けてください。ただし、推論の継続、自然なマルチモーダルのやり取り、つぎはぎの実装を必要としないエージェント型ループを求めるなら、Responses がこれからの選択肢です。
今後の展望
Chat Completions が Completions に代わって使われるようになったのと同じように、Responses が OpenAI モデルを使って開発する際の標準的な方法になると考えています。シンプルに使いたいときはシンプルに、強力な機能を求めるときはその力を引き出せます。そして、次のパラダイムがどのようなものでも対応できる柔軟性を備えています。
私たちは今後何年にもわたって、この API を基盤に開発を進めていきます。