
Os recursos de áudio com IA abrem novas e empolgantes possibilidades para a experiência do usuário. No início deste ano, lançamos vários modelos de áudio, incluindo o gpt-realtime, além de novos recursos de API para que desenvolvedores possam criar essas experiências.
Na semana passada, lançamos novas versões dos modelos de áudio para enfrentar alguns dos desafios comuns na criação de agentes de áudio confiáveis. Elas melhoram a confiabilidade e a qualidade dos fluxos de trabalho de voz em produção, da transcrição e conversão de texto em fala a agentes que trabalham nativamente de fala para fala em tempo real.
Estas atualizações incluem:
gpt-4o-mini-transcribe-2025-12-15para conversão de fala em texto com a API de Transcrição ou a Realtime APIgpt-4o-mini-tts-2025-12-15para conversão de texto em fala com a Speech APIgpt-realtime-mini-2025-12-15para interações nativas de fala para fala em tempo real com a Realtime APIgpt-audio-mini-2025-12-15para interações nativas de fala para fala com a API Chat Completions
As novas versões têm algumas melhorias em comum:
Na entrada de áudio:
- Menores taxas de erro de palavras em áudios de situações reais e com ruído
- Menos alucinações durante o silêncio ou na presença de ruído de fundo
Na saída de áudio:
- Saída de voz mais natural e estável, inclusive ao usar Vozes personalizadas
Os preços continuam iguais aos das versões anteriores dos modelos. Por isso, recomendamos migrar para as novas versões para obter melhor desempenho pelo mesmo preço.
Se você está criando agentes de voz, sistemas de atendimento ao cliente ou experiências com a voz de uma marca, estas atualizações ajudarão a tornar suas implantações em produção mais confiáveis. A seguir, detalhamos as novidades e como essas melhorias se manifestam em fluxos de trabalho de voz reais.
Fala para fala
Estamos disponibilizando novos modelos Realtime mini e Audio mini, otimizados para melhorar as chamadas de ferramentas e o cumprimento de instruções. Esses modelos reduzem a diferença de inteligência entre os modelos mini e os de tamanho completo, permitindo que algumas aplicações otimizem custos ao migrar para o modelo mini.
gpt-realtime-mini-2025-12-15
O modelo gpt-realtime-mini foi desenvolvido para uso com a Realtime API, nossa API para interações multimodais nativas de baixa latência. Ele oferece recursos como entrada e saída de áudio em streaming, tratamento de interrupções (com detecção opcional de atividade de voz) e chamadas de função em segundo plano enquanto o modelo continua falando.
A nova versão do Realtime mini é mais adequada para agentes em tempo real, com avanços claros no cumprimento de instruções e nas chamadas de ferramentas. Em nossas avaliações internas de fala para fala, observamos uma melhoria de 18,6 pontos percentuais na precisão do cumprimento de instruções e de 12,9 pontos percentuais na precisão das chamadas de ferramentas em relação à versão anterior, além de uma melhoria no benchmark Big Bench Audio.
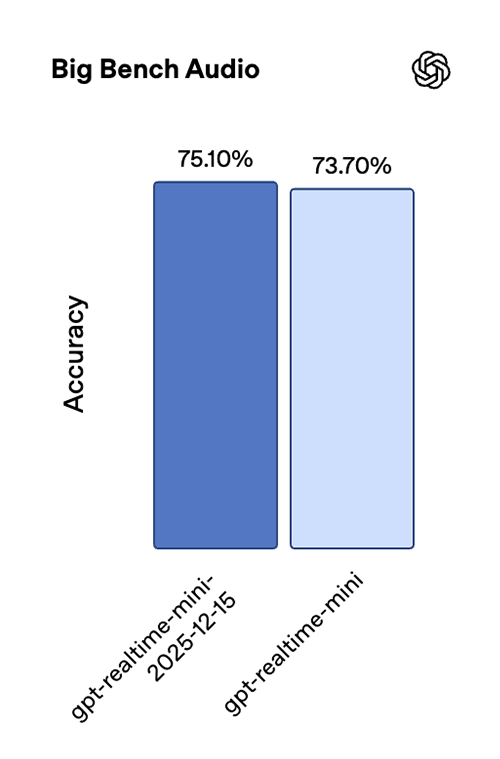
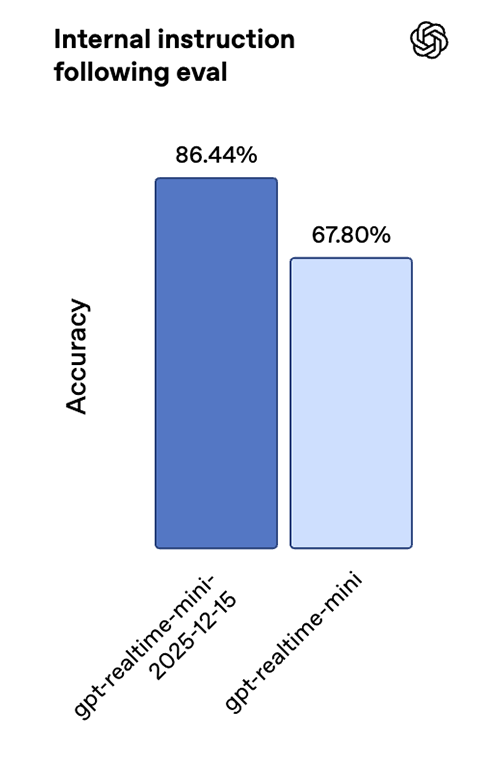
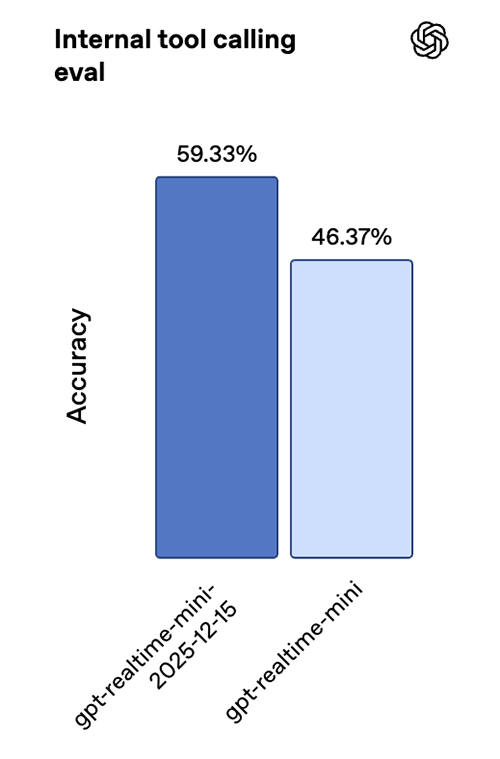
Juntos, esses avanços tornam as interações com várias etapas mais confiáveis e a execução de funções mais consistente em ambientes de interação em tempo real e de baixa latência.
Para cenários em que a precisão do agente justifica um custo maior, o gpt-realtime continua sendo nosso modelo de melhor desempenho. Mas, quando custo e latência são as prioridades, o gpt-realtime-mini é uma ótima opção, com bom desempenho em cenários reais.
Por exemplo, a Genspark submeteu o modelo a testes de estresse em tradução bilíngue e roteamento inteligente de intenções. Além da melhoria na qualidade da voz, a equipe observou respostas quase instantâneas, mantendo o reconhecimento preciso de intenções ao longo de trocas rápidas.
gpt-audio-mini-2025-12-15
O modelo gpt-audio-mini pode ser usado com a API Chat Completions em casos de uso de fala para fala que não exigem interação em tempo real.
As duas novas versões também contam com um decodificador aprimorado para produzir vozes mais naturais e preservar melhor a consistência da voz quando usadas com Vozes personalizadas.
Texto para fala
Nosso modelo mais recente de conversão de texto em fala, gpt-4o-mini-tts-2025-12-15, traz um avanço significativo em precisão, com taxas de erro de palavras substancialmente menores nos benchmarks padrão de fala em comparação com a geração anterior. No Common Voice e no FLEURS, observamos uma WER cerca de 35% menor, além de ganhos consistentes no Multilingual LibriSpeech.
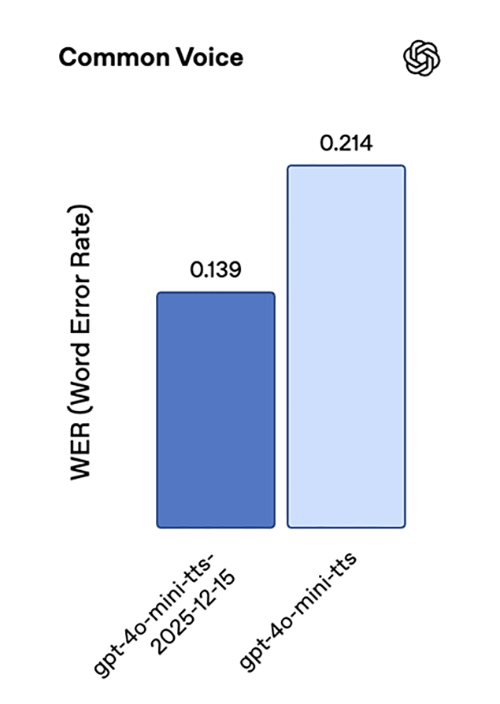
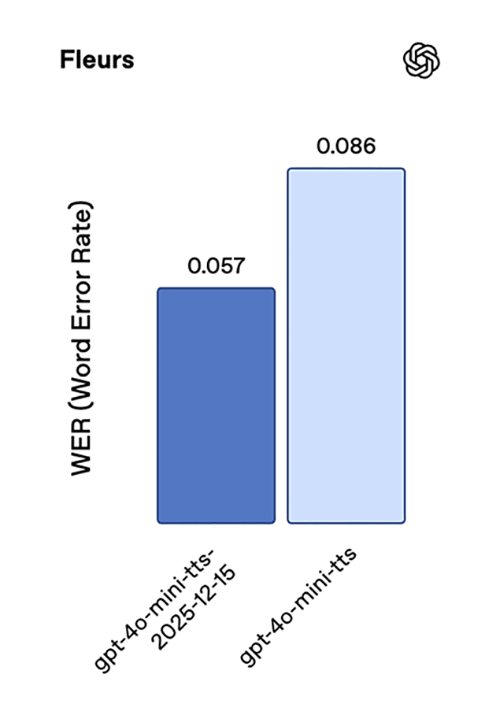
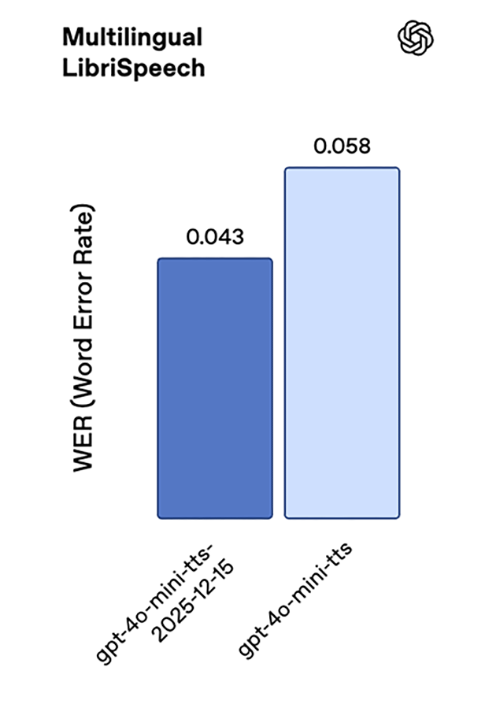
Em conjunto, esses resultados refletem melhorias na precisão da pronúncia e na robustez em uma ampla variedade de idiomas.
Assim como a nova versão do gpt-realtime-mini, este modelo produz uma voz muito mais natural e tem melhor desempenho com Vozes personalizadas.
Fala para texto
O modelo de transcrição mais recente, gpt-4o-mini-transcribe-2025-12-15, apresenta avanços expressivos em precisão e confiabilidade. Em benchmarks padrão de reconhecimento automático de fala, como Common Voice e FLEURS (sem indicações do idioma), ele apresenta taxas de erro de palavras menores que as dos modelos anteriores. Otimizamos o comportamento deste modelo para situações reais de conversa, como falas curtas dos usuários e ambientes com ruído de fundo. Em uma avaliação interna de alucinações na presença de ruído , na qual reproduzimos trechos de ruído de fundo real e áudios com intervalos variados de fala (incluindo silêncio), o modelo produziu ~90% menos alucinações em comparação com o Whisper v2 e ~70% menos em comparação com os modelos GPT-4o-transcribe anteriores.
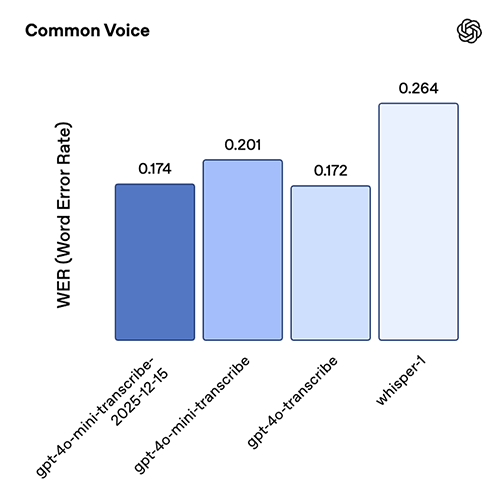
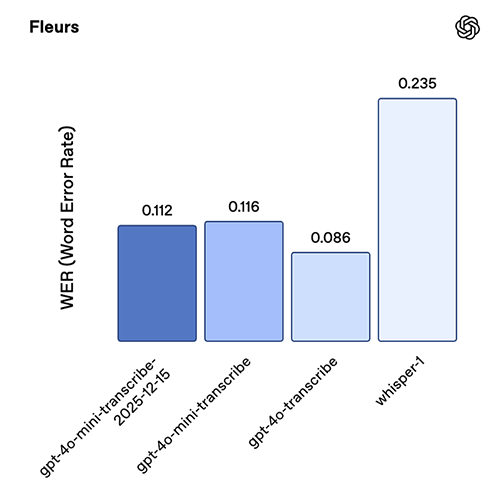
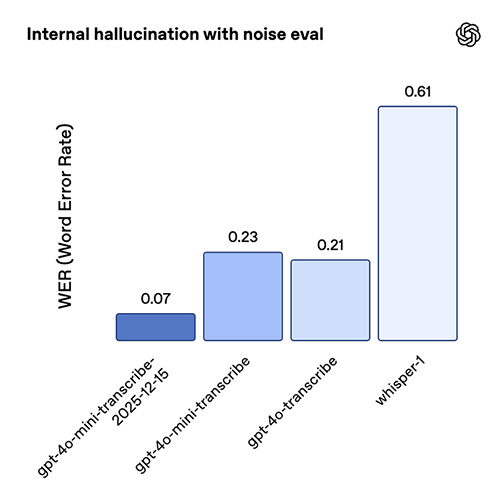
Esta versão do modelo tem desempenho particularmente forte em chinês (mandarim), hindi, bengali, japonês, indonésio e italiano.
Vozes personalizadas
As Vozes personalizadas permitem que as organizações se conectem com os clientes usando uma voz exclusiva para sua marca. Seja para criar um agente de atendimento ao cliente ou um avatar de marca, a tecnologia de voz personalizada da OpenAI facilita a criação de vozes distintas e realistas.
Esses novos modelos de fala para fala e texto para fala trazem melhorias para as vozes personalizadas, como tons mais naturais, maior fidelidade à amostra original e maior precisão em diferentes dialetos.
Para garantir o uso seguro desta tecnologia, as Vozes personalizadas estão disponíveis apenas para clientes elegíveis. Entre em contato com seu diretor de conta ou fale com nossa equipe de vendas para saber mais.
Do protótipo à produção
Os aplicativos de voz tendem a falhar nas mesmas situações, principalmente em conversas longas, em casos atípicos como o silêncio e em fluxos que usam ferramentas e exigem precisão do agente de voz. Estas atualizações se concentram nesses tipos de falha, com menores taxas de erro, menos alucinações, uso mais consistente de ferramentas e melhor cumprimento de instruções. Além disso, melhoramos a estabilidade do áudio de saída para que suas experiências de voz possam soar mais naturais.
Se você já disponibiliza experiências de voz, recomendamos migrar para as novas versões 2025-12-15 e executar novamente seus principais casos de teste de produção.
Os primeiros usuários a testá-las confirmaram melhorias perceptíveis apenas ao trocar para as novas versões, sem alterar as instruções. Ainda assim, recomendamos testar seus próprios casos de uso e ajustar os prompts conforme necessário.