
A OpenAI oferece dois tipos de modelos: modelos de raciocínio (o3 e o4-mini, por exemplo) e modelos GPT (como GPT-4.1). Essas famílias de modelos se comportam de maneiras diferentes.
Este guia aborda:
- A diferença entre nossos modelos de raciocínio e nossos modelos GPT sem raciocínio
- Quando usar nossos modelos de raciocínio
- Como criar prompts eficazes para modelos de raciocínio
Saiba mais sobre os modelos de raciocínio e como eles funcionam.
Modelos de raciocínio vs. modelos GPT
Em comparação com os modelos GPT, nossos modelos da série o se destacam em outras tarefas e exigem prompts diferentes. Uma família de modelos não é melhor que a outra: elas apenas são diferentes.
Treinamos nossos modelos da série o (“os planejadores”) para pensar por mais tempo e com mais profundidade sobre tarefas complexas. Isso os torna eficazes na elaboração de estratégias, no planejamento de soluções para problemas complexos e na tomada de decisões com base em grandes volumes de informações ambíguas. Esses modelos também podem executar tarefas com alta exatidão e precisão, o que os torna ideais para áreas que, de outra forma, exigiriam um especialista humano, como matemática, ciências, engenharia, serviços financeiros e serviços jurídicos.
Já nossos modelos GPT (“os executores”), com menor latência e melhor custo-benefício, são projetados para a execução direta de tarefas. Um aplicativo pode usar modelos da série o para planejar a estratégia de resolução de um problema e modelos GPT para executar tarefas específicas, principalmente quando velocidade e custo são mais importantes que a exatidão absoluta.
Como escolher
O que é mais importante para o seu caso de uso?
- Velocidade e custo → Os modelos GPT são mais rápidos e tendem a custar menos
- Execução de tarefas bem definidas → Os modelos GPT lidam bem com tarefas definidas explicitamente
- Exatidão e confiabilidade → Os modelos da série o são confiáveis na tomada de decisões
- Resolução de problemas complexos → Os modelos da série o lidam com ambiguidade e complexidade
Se velocidade e custo são os fatores mais importantes para concluir suas tarefas e seu caso de uso consiste em tarefas simples e bem definidas, nossos modelos GPT são a melhor opção para você. Porém, se exatidão e confiabilidade são os fatores mais importantes e você precisa resolver um problema muito complexo, com várias etapas, nossos modelos da série o provavelmente são a escolha certa.
A maioria dos fluxos de trabalho de IA usará uma combinação das duas famílias de modelos: a série o para planejamento agêntico e tomada de decisões, e a série GPT para execução de tarefas.
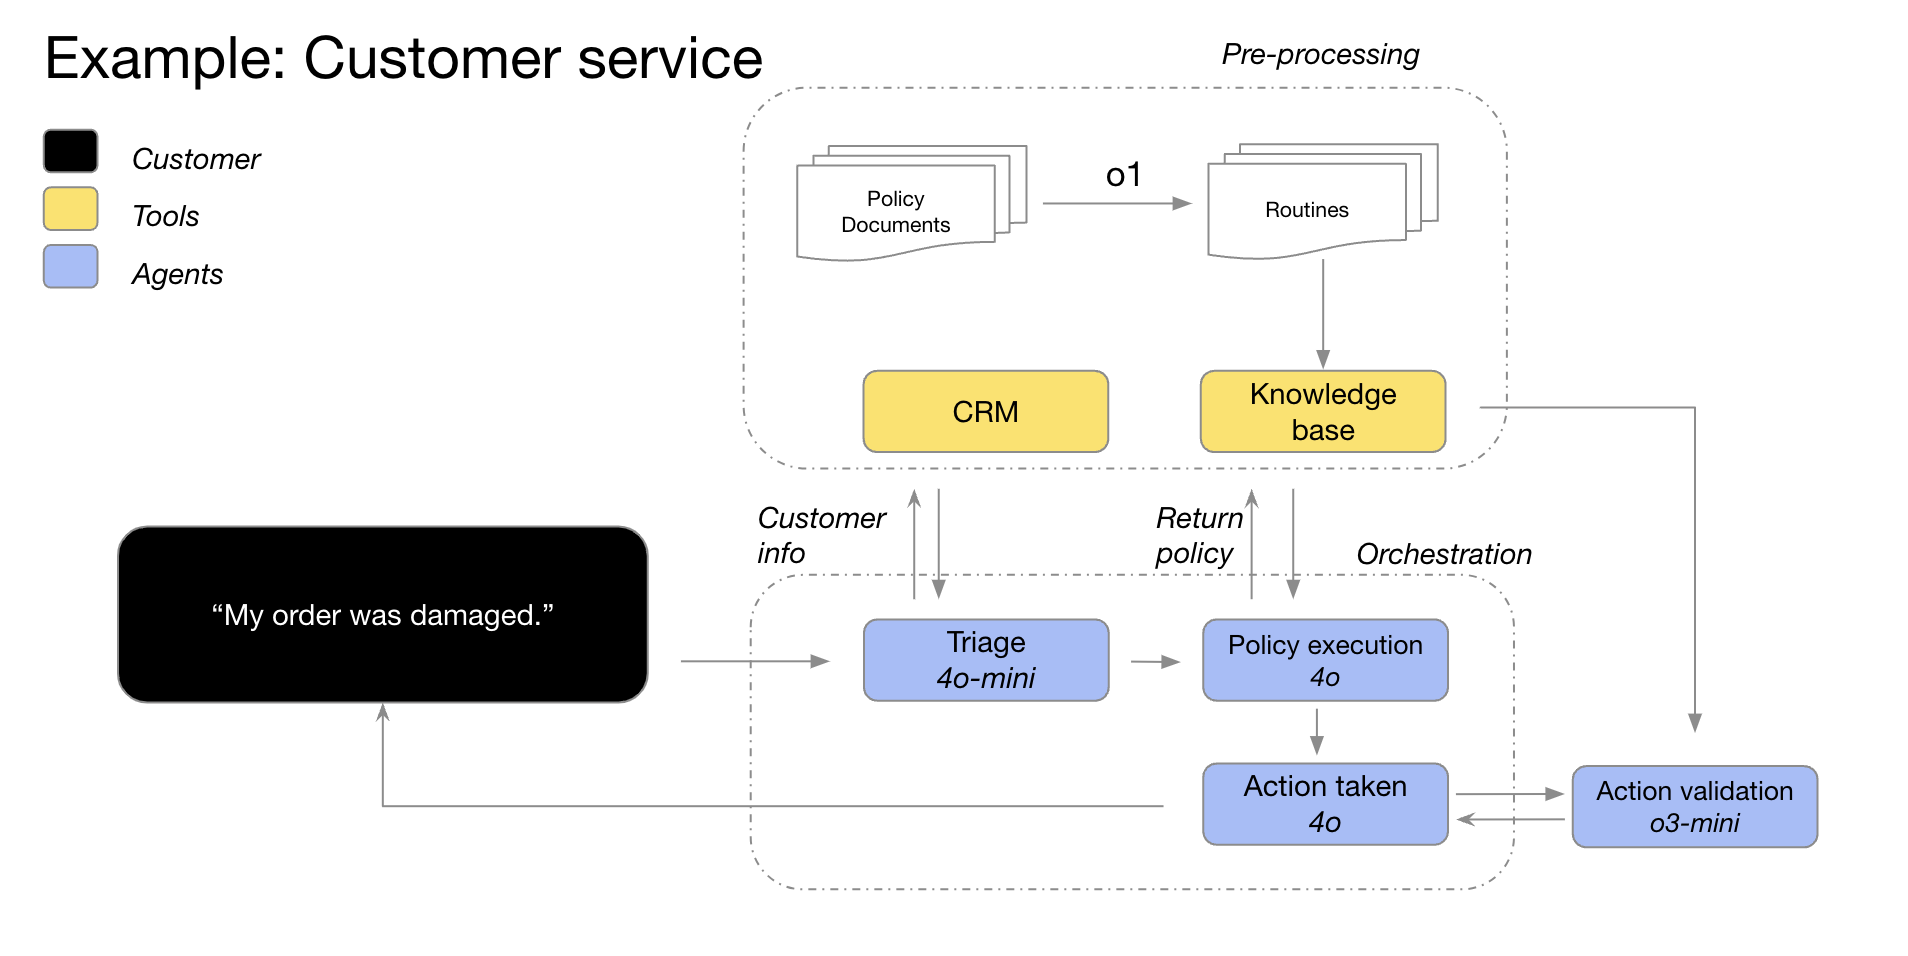
Nossos modelos GPT-4o e GPT-4o mini fazem a triagem dos detalhes do pedido junto com as informações do cliente, identificam os problemas no pedido e a política de devolução e, em seguida, fornecem todos esses dados ao o3-mini para que ele tome a decisão final sobre a viabilidade da devolução com base na política.
Quando usar nossos modelos de raciocínio
Veja alguns padrões de uso bem-sucedido que observamos entre clientes e internamente na OpenAI. Esta não é uma análise abrangente de todos os casos de uso possíveis, mas um conjunto de orientações práticas para testar nossos modelos da série o.
Pronto para usar um modelo de raciocínio? Vá direto para o início rápido →
1. Lidando com tarefas ambíguas
Os modelos de raciocínio são especialmente bons em entender a intenção do usuário e lidar com lacunas nas instruções a partir de informações limitadas ou dispersas e de um prompt simples. Na prática, esses modelos costumam fazer perguntas de esclarecimento antes de formular suposições sem fundamento ou tentar preencher lacunas de informação.
“As capacidades de raciocínio do o1 permitem que nossa plataforma de múltiplos agentes, Matrix, produza respostas abrangentes, bem formatadas e detalhadas ao processar documentos complexos. Por exemplo, com um prompt básico, o o1 permitiu que a Matrix identificasse facilmente as margens disponíveis nas permissões para pagamentos restritos de um contrato de crédito. Nenhum modelo anterior tem desempenho tão bom. Em comparação com outros modelos, o o1 gerou resultados melhores em 52% dos prompts complexos sobre contratos de crédito densos.”
—Hebbia, empresa que oferece uma plataforma de conhecimento com IA para os setores jurídico e financeiro
2. Encontrando uma agulha no palheiro
Ao receber grandes volumes de informações não estruturadas, os modelos de raciocínio são excelentes em compreendê-las e extrair apenas o que é mais relevante para responder a uma pergunta.
“Para analisar a aquisição de uma empresa, o o1 revisou dezenas de documentos da empresa, como contratos e locações, em busca de condições complicadas que pudessem afetar o negócio. O modelo recebeu a tarefa de sinalizar cláusulas importantes e, ao fazer isso, identificou uma disposição crucial sobre ‘mudança de controle’ nas notas de rodapé: se a empresa fosse vendida, teria de quitar imediatamente um empréstimo de US$ 75 milhões. A extrema atenção do o1 aos detalhes permite que nossos agentes de IA apoiem profissionais de finanças ao identificar informações essenciais para suas atividades.”
—Endex, plataforma de inteligência financeira com IA
3. Encontrando relações e nuances em um grande conjunto de dados
Constatamos que os modelos de raciocínio são especialmente bons em raciocinar sobre documentos complexos com centenas de páginas de informações densas e não estruturadas, como contratos jurídicos, demonstrações financeiras e pedidos de indenização de seguros. Eles se destacam ao traçar paralelos entre documentos e tomar decisões com base em fatos implícitos nos dados.
“A pesquisa tributária exige sintetizar vários documentos para produzir uma resposta final convincente. Substituímos o GPT-4o pelo o1 e constatamos que o o1 era muito melhor em raciocinar sobre as relações entre os documentos para chegar a conclusões lógicas que não eram evidentes em nenhum documento isolado. Como resultado, tivemos uma melhoria de 4 vezes no desempenho de ponta a ponta ao mudar para o o1. Incrível.”
—Blue J, plataforma de IA para pesquisa tributária
Os modelos de raciocínio também são bons em analisar políticas e regras cheias de nuances e aplicá-las à tarefa em questão para chegar a uma conclusão razoável.
“Nas análises financeiras, os analistas frequentemente lidam com cenários complexos envolvendo a participação dos acionistas e precisam entender os detalhes jurídicos relevantes. Testamos cerca de 10 modelos de diferentes fornecedores com uma pergunta difícil, mas comum: como uma captação de recursos afeta os acionistas existentes, especialmente quando eles exercem seus direitos de proteção contra diluição? Isso exigia raciocinar sobre as avaliações da empresa antes e depois do aporte e lidar com ciclos circulares de diluição, algo que analistas financeiros de alto nível levariam de 20 a 30 minutos para resolver. Constatamos que o o1 e o o3-mini conseguem fazer isso sem erros! Os modelos chegaram a produzir uma tabela de cálculo clara, mostrando o impacto sobre um acionista com participação de US$ 100 mil.”
–BlueFlame AI, plataforma de IA para gestão de investimentos
4. Planejamento agêntico em várias etapas
Os modelos de raciocínio são fundamentais para o planejamento agêntico e a elaboração de estratégias. Observamos bons resultados quando um modelo de raciocínio atua como “o planejador”, produzindo uma solução detalhada, com várias etapas, para um problema e depois selecionando e atribuindo o modelo GPT adequado (“o executor”) a cada etapa, conforme a prioridade seja alta inteligência ou baixa latência.
“Usamos o o1 como planejador em nossa infraestrutura de agentes, deixando que ele orquestre outros modelos no fluxo de trabalho para concluir uma tarefa de várias etapas. Percebemos que o o1 é muito bom em selecionar tipos de dados e dividir questões amplas em partes menores, permitindo que outros modelos se concentrem na execução.”
—Argon AI, plataforma de conhecimento com IA para a indústria farmacêutica
“O o1 está por trás de muitos dos nossos fluxos de trabalho agênticos na Lindy, nossa assistente de IA para o trabalho. O modelo usa chamada de função para buscar informações no seu calendário ou e-mail e, em seguida, pode ajudar automaticamente a agendar reuniões, enviar e-mails e gerenciar outras partes das suas tarefas diárias. Passamos para o o1 todas as etapas agênticas que costumavam apresentar problemas e vimos nossos agentes se tornarem praticamente impecáveis da noite para o dia!”
—Lindy.AI, assistente de IA para o trabalho
5. Raciocínio visual
Até o momento, o o1 é o único modelo de raciocínio que oferece recursos de visão. O que o diferencia do GPT-4o é a capacidade de compreender até os elementos visuais mais difíceis, como gráficos e tabelas com estrutura ambígua ou fotos de baixa qualidade.
“Automatizamos análises de risco e conformidade para milhões de produtos on-line, incluindo imitações de joias de luxo, espécies ameaçadas de extinção e substâncias controladas. O GPT-4o atingiu 50% de acurácia em nossas tarefas mais difíceis de classificação de imagens. O o1 alcançou impressionantes 88% de acurácia sem nenhuma modificação no nosso pipeline.”
—SafetyKit, plataforma de risco e conformidade com IA
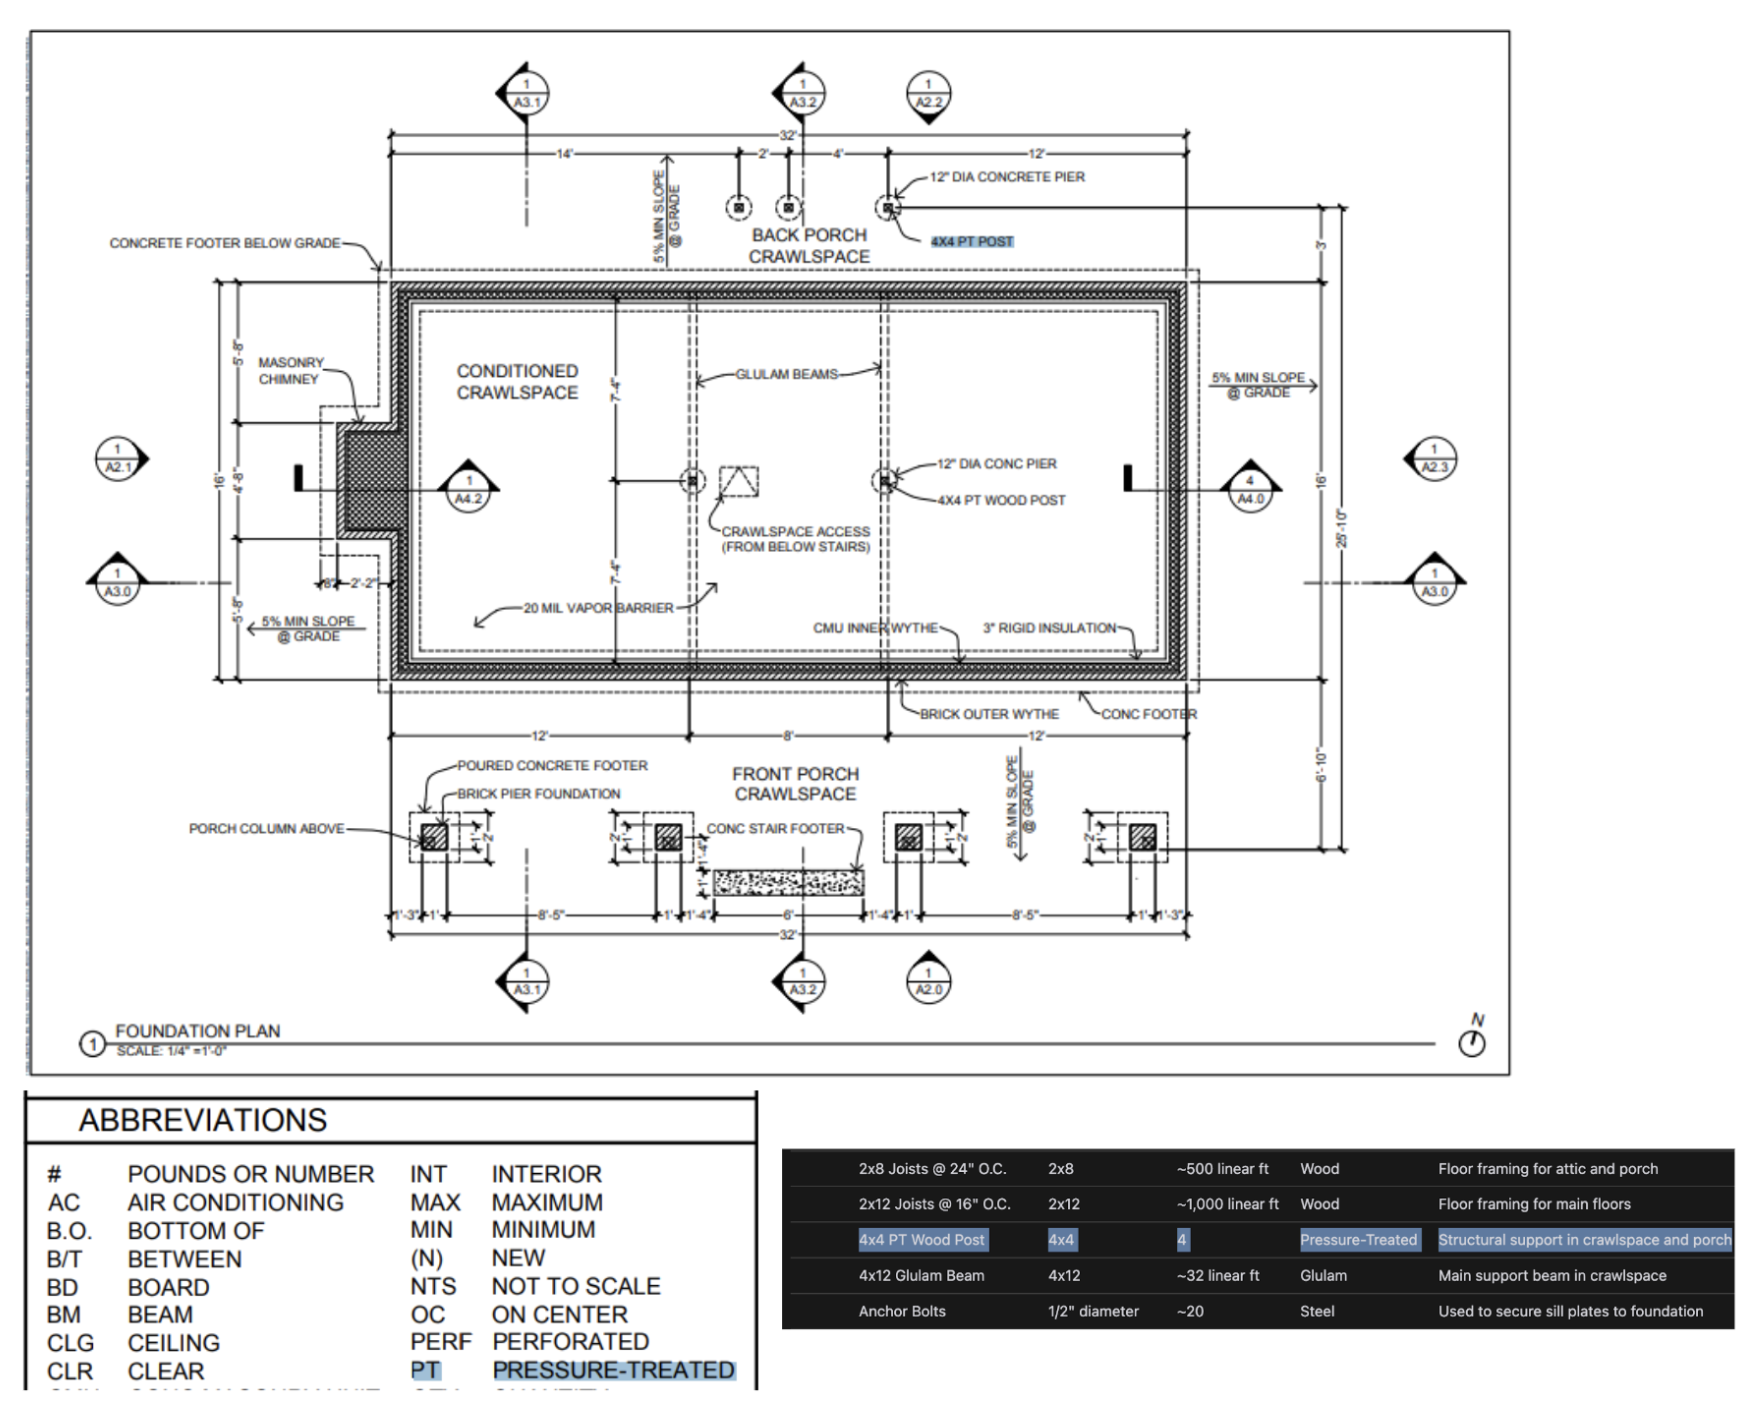
Em nossos testes internos, observamos que o o1 consegue identificar elementos fixos e materiais em desenhos arquitetônicos altamente detalhados para gerar uma lista completa de materiais. Uma das constatações mais surpreendentes foi que o o1 consegue traçar paralelos entre diferentes imagens, usando a legenda de uma página dos desenhos arquitetônicos e aplicando-a corretamente a outra página sem instruções explícitas. Abaixo, você pode ver que, para os pilares de madeira PT 4x4, o o1 reconheceu, com base na legenda, que “PT” significa tratamento sob pressão.
6. Revisando, depurando e melhorando a qualidade do código
Os modelos de raciocínio são especialmente eficazes na revisão e melhoria de grandes volumes de código. Devido à sua maior latência, essas revisões costumam ser executadas em segundo plano.
“Oferecemos revisões de código automatizadas com IA em plataformas como GitHub e GitLab. Embora o processo de revisão de código não seja, por natureza, sensível à latência, ele exige compreender as diferenças no código entre vários arquivos. É aí que o o1 realmente se destaca: ele consegue detectar de forma confiável pequenas alterações em uma base de código que poderiam passar despercebidas por um revisor humano. Conseguimos triplicar as taxas de conversão do produto depois de migrar para os modelos da série o.”
—CodeRabbit, startup de revisão de código com IA
Embora o GPT-4o e o GPT-4o mini possam ser mais adequados para escrever código por terem menor latência, também vimos o o3-mini se destacar na produção de código em casos de uso um pouco menos sensíveis à latência.
“O o3-mini produz de forma consistente código de alta qualidade que resolve o problema e chega com muita frequência à solução correta quando o problema está bem definido, mesmo em tarefas de programação muito difíceis. Enquanto outros modelos podem ser úteis apenas para iterações rápidas e de pequena escala no código, o o3-mini se destaca no planejamento e na implementação de sistemas de software complexos.”
—Windsurf, IDE colaborativa com IA agêntica, desenvolvida pela Codeium
7. Avaliação e testes comparativos de respostas de outros modelos
Também observamos que os modelos de raciocínio têm bom desempenho em testes comparativos e na avaliação de respostas de outros modelos. A validação de dados é importante para garantir a qualidade e a confiabilidade dos conjuntos de dados, especialmente em áreas sensíveis como a saúde. Os métodos tradicionais de validação usam regras e padrões predefinidos, mas modelos avançados como o o1 e o o3-mini conseguem entender o contexto e raciocinar sobre os dados, permitindo uma abordagem de validação mais flexível e inteligente.
“Muitos clientes usam LLMs como avaliadores em seu processo de avaliação na Braintrust. Por exemplo, uma empresa do setor de saúde pode resumir perguntas de pacientes usando um modelo executor como o gpt-4o e depois avaliar a qualidade do resumo com o o1. Um cliente da Braintrust viu a pontuação F1 de um avaliador passar de 0,12 com o 4o para 0,74 com o o1! Nesses casos de uso, os clientes constataram que o raciocínio do o1 fez toda a diferença na identificação de nuances entre as respostas geradas, nas tarefas de atribuição de notas mais difíceis e complexas.”
—Braintrust, plataforma de avaliações de IA
Como criar prompts eficazes para modelos de raciocínio
Esses modelos funcionam melhor com prompts diretos. Algumas técnicas de engenharia de prompt, como instruir o modelo a "pensar passo a passo", podem não melhorar o desempenho (e às vezes até prejudicá-lo). Confira as práticas recomendadas abaixo ou comece pelos exemplos de prompts.
- As mensagens de desenvolvedor são as novas mensagens de sistema: A partir do
o1-2024-12-17, os modelos de raciocínio passam a aceitar mensagens de desenvolvedor em vez de mensagens de sistema, em conformidade com o comportamento da cadeia de comando descrito na especificação do modelo. - Mantenha os prompts simples e diretos: Os modelos se destacam na compreensão de instruções breves e claras e na resposta a elas.
- Evite prompts de cadeia de pensamento: Como esses modelos raciocinam internamente, não é necessário pedir que "pensem passo a passo" ou "expliquem seu raciocínio".
- Use delimitadores para dar clareza: Use delimitadores como Markdown, tags XML e títulos de seção para indicar claramente as diferentes partes da entrada, ajudando o modelo a interpretar cada seção de forma adequada.
- Experimente zero-shot primeiro e few-shot se necessário: Os modelos de raciocínio geralmente não precisam de exemplos few-shot para produzir bons resultados, então tente primeiro escrever prompts sem exemplos. Se você tiver requisitos mais complexos para a saída desejada, pode ser útil incluir alguns exemplos de entradas e saídas desejadas no prompt. Garanta que os exemplos estejam bem alinhados às instruções do prompt, pois divergências entre eles podem gerar resultados ruins.
- Forneça orientações específicas: Se você quiser impor restrições à resposta do modelo (como "proponha uma solução com um orçamento inferior a $500"), descreva essas restrições explicitamente no prompt.
- Seja muito específico sobre seu objetivo final: Nas instruções, procure definir parâmetros bem específicos para uma resposta bem-sucedida e incentive o modelo a continuar raciocinando e iterando até atender aos seus critérios de sucesso.
- Formatação Markdown: A partir do
o1-2024-12-17, os modelos de raciocínio na API evitarão gerar respostas com formatação Markdown. Para indicar ao modelo que você deseja essa formatação na resposta, inclua a stringFormatting re-enabledna primeira linha da mensagem de desenvolvedor.
Como manter os custos baixos e a precisão alta
Com a introdução dos modelos o3 e o4-mini, os itens de raciocínio persistidos na Responses API passam a ser tratados de forma diferente. Antes (para o1, o3-mini, o1-mini e o1-preview), os itens de raciocínio eram sempre ignorados nas requisições subsequentes à API, mesmo quando incluídos nos itens de entrada dessas requisições. Com o3 e o4-mini, alguns itens de raciocínio adjacentes às chamadas de função são incluídos no contexto do modelo para ajudar a melhorar seu desempenho usando o mínimo possível de tokens de raciocínio.
Para obter os melhores resultados com essa mudança, recomendamos usar a Responses API com o parâmetro store definido como true e enviar todos os itens de raciocínio das requisições anteriores (usando previous_response_id ou enviando todos os itens de saída de uma requisição anterior como itens de entrada de uma nova requisição). A OpenAI incluirá automaticamente os itens de raciocínio relevantes no contexto do modelo e ignorará os irrelevantes. Em casos de uso mais avançados, nos quais você queira controlar com mais precisão o que entra no contexto do modelo, recomendamos incluir pelo menos todos os itens de raciocínio entre a chamada de função mais recente e a mensagem anterior do usuário. Isso garante que o modelo não precise reiniciar seu raciocínio quando você responder a uma chamada de função, melhorando o desempenho das chamadas de função e reduzindo o uso total de tokens.
Se você estiver usando a API chat completions, os itens de raciocínio nunca serão incluídos no contexto do modelo. Isso ocorre porque Chat Completions é uma API sem estado. Em casos agênticos complexos que envolvem muitas chamadas de função, isso resultará em um desempenho ligeiramente inferior do modelo e em um uso maior de tokens de raciocínio. Nos casos que não envolvem múltiplas chamadas de função complexas, não deve haver perda de desempenho, independentemente da API usada.
Outros recursos
Para mais inspiração, acesse o OpenAI Cookbook, que contém exemplos de código e links para recursos de terceiros, ou saiba mais sobre nossos modelos e capacidades de raciocínio: