Escolha sua API para entender como o uso é medido e encontrar maneiras de gerenciar os custos do seu aplicativo de voz.
Uso e custos do GPT-Live
O GPT-Live separa a conversa por voz do backend que raciocina e executa ferramentas. Estime esses dois custos separadamente: o custo da sessão de voz depende da duração, enquanto os custos do backend dependem dos modelos e das ferramentas que você usa.
Custos da sessão de voz
As sessões de voz do GPT-Live são cobradas por segundo, com base na tarifa atual do modelo. A duração da sessão não é arredondada para o próximo minuto inteiro.
O tempo de sessão ativa inclui os períodos em que o usuário fala, o assistente fala, ambos ficam em silêncio ou o backend está trabalhando.
Para fazer estimativas, considere a sessão ativa do início ao encerramento. Use a duração informada pela API em vez de medir apenas o áudio que você reproduz. Silenciar a entrada do microfone não encerra a sessão. Quando a conversa terminar, encerre a sessão e colete os dados finais de uso.
Consulte os preços da API para saber os preços dos modelos e das ferramentas do backend.
Cobranças de inicialização do WebRTC
Uma solicitação POST /v1/live/sessions para criar uma sessão WebRTC gera uma cobrança de 15 segundos de voz durante a inicialização da sessão. Esse valor é abatido das cobranças por duração assim que a sessão começa a funcionar. Não acrescente mais 15 segundos à duração da sessão em execução ao estimar seu custo.
Por exemplo, a sessão de 90 segundos abaixo já inclui os 15 segundos cobrados na inicialização. Ela não é cobrada como uma sessão de 105 segundos. Considere as cobranças de criação de sessões ao avaliar reconexões ou aplicativos que criam sessões antes de o usuário estar pronto para falar.
Custos do backend
As chamadas ao backend são cobradas separadamente da sessão de voz, assim como nos aplicativos sem voz. Inclua os tokens de entrada e saída do modelo, a entrada em cache quando houver suporte e quaisquer cobranças aplicáveis a imagens ou ferramentas. Se o seu aplicativo chamar outros serviços, inclua os custos deles na estimativa também.
Você pode otimizar esse trabalho separadamente do frontend de voz. Use o guia geral de otimização de custos para reduzir as solicitações e o uso de tokens. Use o cache de prompts nos modelos de backend compatíveis, mantendo instruções reutilizáveis, definições de ferramentas e outros conteúdos estáveis no início do prompt.
As escolhas de backend também podem alterar a duração da conversa. Compare o custo combinado quando uma otimização fizer o usuário esperar mais ou alterar a confiabilidade com que o assistente conclui a tarefa.
Estime os custos da conversa
Para uma conversa com uma sessão de voz:
Custo total = (segundos de voz faturáveis ÷ 60 × tarifa de voz por minuto) + custos do backend
Por exemplo, com uma tarifa de voz ilustrativa de $0.05 por minuto, uma sessão de voz de 90 segundos custa $0.075. Se os custos de modelos e ferramentas do backend somarem $0.02, a conversa custará $0.095:
| Componente | Cálculo | Custo |
|---|---|---|
| Sessão de voz | 90 segundos ÷ 60 × $0.05 | $0.075 |
| Trabalho do backend | Custos totais de modelos e ferramentas | $0.02 |
| Total da conversa | $0.075 + $0.02 | $0.095 |
As tarifas e o custo do backend acima são exemplos; use a tarifa de voz atual, o uso medido do seu backend e as tarifas aplicáveis aos modelos e às ferramentas. Se a tarefa abranger várias sessões de voz, some suas durações e inclua o trabalho do backend realizado entre as sessões.
Estratégias de otimização
Concentre-se em ajudar o usuário a concluir a tarefa com menos conversa desnecessária e menos espera. Mantenha as confirmações e verificações que a tarefa exige.
Forneça contexto relevante antes da sessão
Reúna as informações que seu aplicativo já tem permissão para usar antes de iniciar a sessão de voz. Por exemplo, um assistente que ajuda com um pedido pode começar com o número do pedido e o status atual, para que o usuário não precise repeti-los nem esperar por outra consulta.
Mantenha esse contexto atualizado e focado na tarefa. Forneça ao modelo de voz as informações necessárias para a conversa; mantenha registros detalhados e fluxos de trabalho no backend. Consulte configuração da sessão e delegação e ferramentas.
Reduza o tempo de espera pelas ferramentas
Esperas mais curtas podem melhorar a experiência do usuário e reduzir os custos da sessão de voz.
Por exemplo, suponha que seu backend use gpt-5.6-luna com o
modo Fast e execute chamadas independentes a ferramentas em
paralelo. Se essas otimizações ajudarem o usuário a terminar e encerrar a sessão de voz
um minuto antes, você economizará $0.05 em cobranças de voz. O custo total
diminui se o custo adicional do backend for menor que essa economia.
Você também pode iniciar uma consulta especulativa a partir de fragmentos da transcrição antes de receber um evento de delegação. Inclua o trabalho especulativo não utilizado nas suas medições de custo do backend.
Consulte Reduza a latência do backend para saber mais sobre otimizações de modelos, conexões, streaming e ferramentas. Valide o tempo até uma resposta falada útil e o sucesso da tarefa com avaliações de agentes de voz.
Encerre a sessão durante tarefas longas
O frontend de voz e o backend gerenciado pelo seu aplicativo podem funcionar de forma independente. Com a delegação ao cliente, o processo de trabalho do backend pode continuar em execução com a sessão de voz aberta ou encerrada. Salve o estado da tarefa e o contexto da conversa antes de encerrar a sessão de voz.
Para um agente ambiente, encerre a sessão de voz enquanto o backend executa uma tarefa de longa duração, como programar no modo Meta. Ofereça um botão com o rótulo Retomar conversa para iniciar uma nova sessão de voz quando o usuário voltar, ou use um evento de conclusão do backend para iniciar uma nova sessão e avisar ao usuário que o resultado está pronto.
Restaure a conversa iniciando uma nova sessão com o contexto salvo e o
resultado verificado da tarefa em input. Por exemplo, envie este evento de inicialização por uma
nova conexão WebSocket:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}Aguarde session.started antes de transmitir áudio. Consulte
inicialize uma sessão com uma conversa anterior
para saber qual formato de histórico é aceito.
Se a sessão anterior foi armazenada com store: true, você também pode criar um fork dessa sessão. Mantenha o estado verificado da tarefa do backend no seu aplicativo, independentemente da abordagem usada.
Encerrar a sessão economiza $0.05 por minuto de tempo de voz ocioso; compare essa economia com os custos de reconexão e a interrupção na experiência do usuário.
Escolha o modelo de backend adequado
Comece com modelos que atendam aos requisitos de precisão e confiabilidade da tarefa. Depois, compare o custo total da conversa, incluindo duração da voz, uso do modelo, chamadas a ferramentas e novas tentativas. O guia de seleção de modelos descreve como equilibrar essas vantagens e desvantagens.
Um modelo de backend maior pode ter um custo total menor se concluir a tarefa mais rápido e a economia na sessão de voz superar os custos adicionais de tokens. Um modelo mais barato pode ter um custo total maior se demorar mais, repetir chamadas a ferramentas ou não conseguir concluir a tarefa.
Compare o custo por tarefa concluída com sucesso, juntamente com a taxa de conclusão e o tempo para concluí-la. Inclua as tentativas malsucedidas e as novas tentativas no total para que uma configuração mais barata não pareça melhor por concluir menos trabalho. Use o Cookbook de avaliação de agentes de voz ao planejar sua comparação.
Monitore o uso real
Registre a duração da voz e o uso do backend separadamente para cada sessão. O GPT-Live informa a duração acumulada da voz em segundos:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}Cada atualização substitui o registro anterior de duração. Não some os registros.
Após enviar session.close, continue recebendo eventos até session.closed e
registre o valor final de usage.seconds uma única vez. Siga o
procedimento de encerramento controlado
para que seu aplicativo possa coletar os dados finais de uso antes de se desconectar.
Para a delegação via Responses, leia o campo usage da resposta do backend nos eventos aninhados
response.completed recebidos por meio de response.event. Conte cada
resposta do backend uma única vez, usando seu ID de resposta, e mantenha os detalhes dos tokens de entrada, saída e
cache necessários para aplicar as tarifas desse modelo. Para o trabalho de backend que seu
aplicativo executa de forma independente, colete também os dados de uso dessas solicitações.
Compare os totais estimados e reais em conversas representativas. Mantenha as chamadas a modelos usadas apenas para avaliação separadas do uso do aplicativo e analise o custo junto com o sucesso da tarefa.
Custos da Realtime API
Este documento descreve como funciona a cobrança da Realtime API e apresenta estratégias para otimizar custos. As sessões de agentes de voz acumulam tokens de entrada e saída nas modalidades de texto, áudio e imagem. As sessões de tradução e transcrição em streaming são cobradas pela duração do áudio. Os preços variam conforme o modelo e estão listados nas páginas dos modelos (por exemplo, gpt-realtime-2, gpt-realtime-translate, gpt-realtime-whisper e gpt-realtime).
As sessões de conversação da Realtime API são uma série de turnos, em que o usuário adiciona uma entrada que aciona uma Response para produzir a saída do modelo. O servidor mantém uma Conversation, que é uma lista de Items que compõem a entrada do próximo turno. Quando uma Response é retornada, a saída é adicionada automaticamente à Conversation.
As sessões de tradução e transcrição usam uma arquitetura de streaming diferente. O cliente transmite áudio continuamente e recebe áudio traduzido, atualizações incrementais da transcrição ou eventos de transcrição à medida que o áudio de origem chega. Essas sessões não usam o ciclo de vida normal de uma Response. Por isso, estime e monitore seus custos usando as tarifas baseadas em duração, em vez do uso de tokens por Response.
Custos por Response
Os custos da Realtime API são gerados quando uma Response é criada, e a cobrança é baseada na quantidade de tokens de entrada e saída (exceto os custos de transcrição da entrada, descritos abaixo). Atualmente, não há cobrança por largura de banda de rede ou conexões. Uma Response pode ser criada manualmente ou automaticamente se a detecção de atividade de voz (VAD) estiver ativada. A VAD filtra o áudio de entrada vazio, de modo que ele não conta como tokens de entrada, a menos que o cliente o adicione manualmente como entrada da conversa.
A conversa inteira é enviada ao modelo a cada Response. A saída de um turno será adicionada como Items à Conversation no servidor e passará a compor a entrada dos turnos seguintes. Portanto, os turnos mais adiante na sessão serão mais caros.
Os custos dos tokens de texto podem ser estimados usando nossas ferramentas de tokenização. Nas mensagens do usuário, o áudio corresponde a 1 token a cada 100 ms; nas mensagens do assistente, a 1 token a cada 50 ms. Observe que a contagem de tokens inclui tokens especiais além do conteúdo da mensagem, o que gera pequenas variações nessas contagens. Por exemplo, uma mensagem do usuário com 10 tokens de texto no conteúdo pode ser contabilizada como 12 tokens.
Exemplo
Veja um exemplo simples que ilustra os custos de tokens ao longo de uma sessão da Realtime API com vários turnos.
No primeiro turno da conversa, adicionamos 100 tokens de instruções e uma mensagem do usuário com 20 tokens de áudio (por exemplo, adicionada pela VAD a partir da fala do usuário), totalizando 120 tokens de entrada. A criação de uma Response gera uma mensagem de saída do assistente (20 tokens de áudio e 10 de texto).
Em seguida, criamos um segundo turno com outra mensagem de áudio do usuário. Como fica a contagem de tokens do turno 2? Nesse momento, a Conversation inclui as instruções iniciais, a primeira mensagem do usuário, a mensagem de saída do assistente do primeiro turno e a segunda mensagem do usuário (25 tokens de áudio). Esse turno terá 110 tokens de texto e 64 tokens de áudio como entrada, além dos tokens de saída de outra mensagem do assistente.
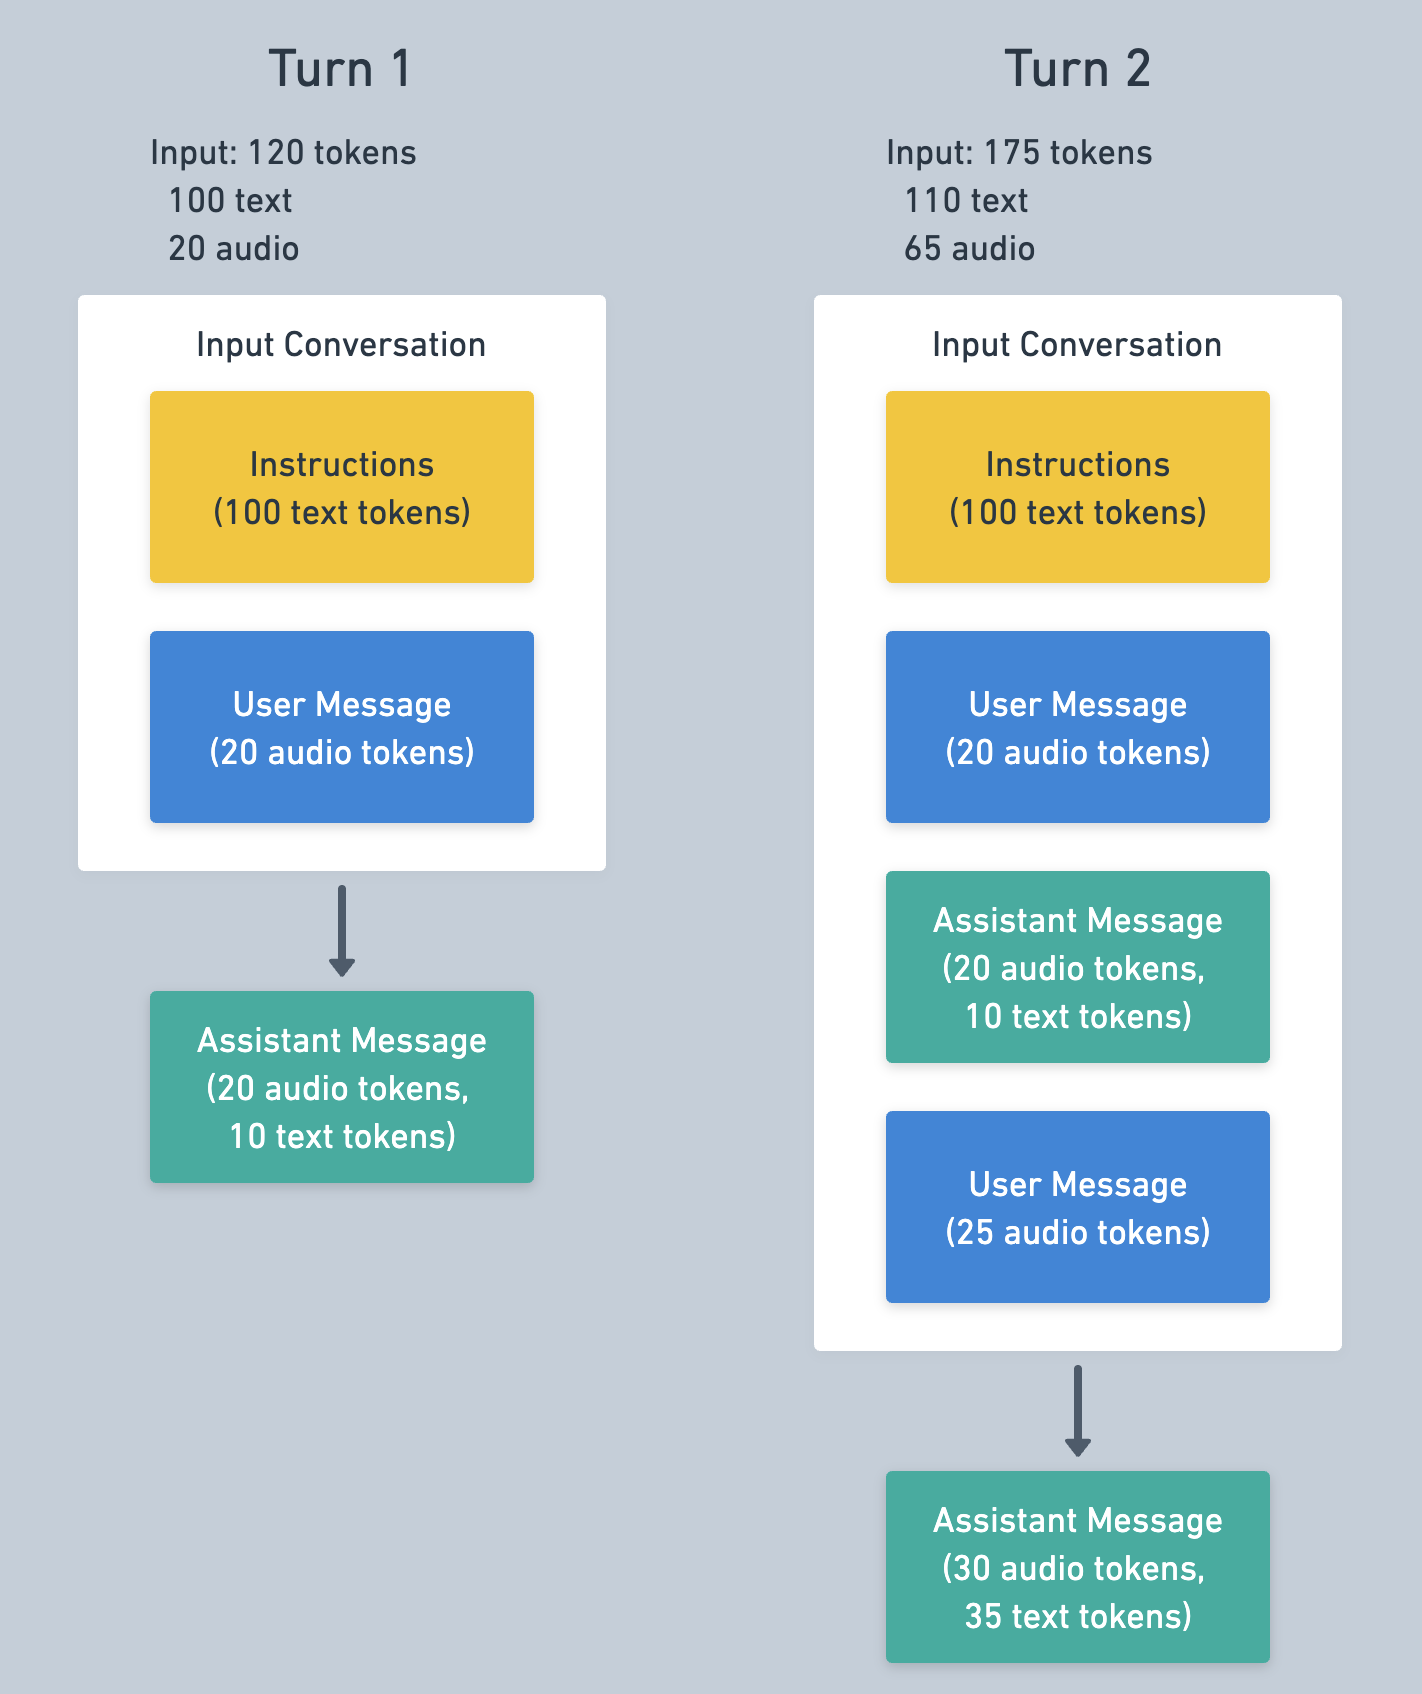
É provável que as mensagens do primeiro turno estejam em cache no turno 2, o que reduz o custo da entrada. Veja abaixo mais informações sobre o uso de cache.
Os tokens usados em uma Response podem ser consultados no evento response.done, que tem o formato a seguir.
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}Custos de transcrição da entrada
Além das Responses de conversação, a Realtime API cobra pelas transcrições da entrada, se estiverem ativadas. A transcrição da entrada usa um modelo diferente do modelo de fala para fala, como whisper-1 ou gpt-4o-transcribe, e por isso segue uma tabela de preços diferente. A transcrição é realizada quando o áudio é gravado no buffer de áudio de entrada e depois confirmado, manualmente ou pela VAD.
A contagem de tokens da transcrição da entrada pode ser consultada no evento conversation.item.input_audio_transcription.completed, como no exemplo a seguir.
{
"type": "conversation.item.input_audio_transcription.completed",
...
"transcript": "Hi, can you hear me?",
"usage": {
"type": "tokens",
"total_tokens": 26,
"input_tokens": 17,
"input_token_details": {
"text_tokens": 0,
"audio_tokens": 17
},
"output_tokens": 9
}
}Uso de cache
A Realtime API oferece suporte ao cache de prompts, aplicado automaticamente, que pode reduzir significativamente os custos dos tokens de entrada em sessões com vários turnos. O cache é usado quando os tokens de entrada de uma Response correspondem aos tokens de uma Response anterior, embora o sistema apenas tente fazer esse reaproveitamento, sem garanti-lo.
A melhor estratégia para maximizar a taxa de aproveitamento do cache é manter o histórico da sessão inalterado. Remover ou alterar conteúdo da conversa invalida o cache até o ponto da alteração, pois a entrada deixa de ter o mesmo grau de correspondência com a anterior. Observe que as instruções e as definições de ferramentas ficam no início da conversa. Portanto, alterá-las durante a sessão reduzirá a taxa de aproveitamento do cache nos turnos seguintes.
Truncamento
Quando a quantidade de tokens de uma conversa excede o limite de tokens de entrada do modelo, a conversa é truncada: as mensagens, começando pelas mais antigas, são removidas da entrada da Response. Um modelo com contexto de 32 mil tokens e limite de 4.096 tokens de saída só pode incluir 28.224 tokens no contexto antes que ocorra o truncamento.
Os clientes podem definir uma janela de tokens menor que o máximo do modelo, o que é uma boa forma de controlar o uso de tokens e o custo. Isso é controlado pela configuração token_limits.post_instructions (se você configurar o truncamento com o tipo retention_ratio, como mostrado abaixo). Como o nome indica, essa configuração controla o número máximo de tokens de entrada de uma Response, exceto os tokens de instruções. Definir post_instructions como 1.000 significa que os itens que excederem o limite de 1.000 tokens de entrada não serão enviados ao modelo para uma Response.
O truncamento invalida o cache próximo ao início da conversa. Se ocorrer a cada turno, a taxa de aproveitamento do cache será muito baixa. Para reduzir esse problema, os clientes podem configurar o truncamento para remover mais mensagens do que o necessário, aumentando a margem disponível antes que outro truncamento seja necessário. Isso pode ser controlado pela configuração session.truncation.retention_ratio. O servidor usa 1.0 como valor padrão, o que significa que o truncamento removerá apenas os itens necessários. Com o valor 0.8, o truncamento manteria 80% do máximo, removendo 20% adicionais.
Se você quer reduzir o custo por sessão da Realtime API para um determinado modelo, recomendamos limitar a quantidade de tokens e definir retention_ratio como um valor menor que 1, como no exemplo a seguir. Lembre-se de que essa redução de custo pode vir acompanhada de uma menor capacidade do modelo de lembrar informações em um determinado turno.
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}O truncamento também pode ser completamente desativado, como mostrado abaixo. Quando ele estiver desativado, um erro será retornado se a Conversation for longa demais para criar uma Response. Isso pode ser útil se você pretende gerenciar o tamanho da Conversation manualmente.
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}Outras estratégias de otimização
Uso de um modelo mini
Os modelos de fala para fala da Realtime estão disponíveis em tamanho “normal” e mini, que é significativamente mais barato. A contrapartida costuma ser uma menor capacidade de seguir instruções e fazer chamadas de função, tarefas em que o modelo mini não será tão eficaz. Recomendamos testar primeiro os aplicativos com o modelo maior, refinar o aplicativo e o prompt e, depois, tentar otimizar usando o modelo mini.
Edição da Conversation
Embora o truncamento ocorra automaticamente no servidor, outra estratégia de gerenciamento de custos é editar a Conversation manualmente. Um princípio da API é dar ao cliente controle total sobre a Conversation no servidor, permitindo adicionar e remover itens livremente.
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}Remover mensagens antigas é uma boa forma de reduzir a quantidade de tokens de entrada e o custo. Isso pode remover conteúdo importante, mas uma estratégia comum é substituir essas mensagens por um resumo. Os Items podem ser excluídos da Conversation com uma mensagem conversation.item.delete, como mostrado acima, e adicionados com uma mensagem conversation.item.create.
Estimativa de custos
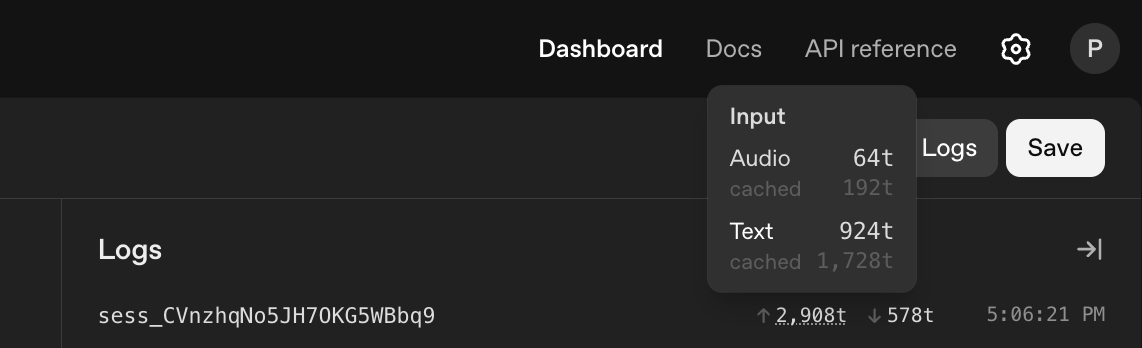
Devido à complexidade do uso de tokens na Realtime API, pode ser difícil estimar seus custos antecipadamente. Uma boa abordagem é usar o Realtime Playground com os prompts e as funções que você pretende utilizar e medir o uso de tokens em uma sessão de exemplo. O uso de tokens de uma sessão pode ser encontrado na aba Logs do Realtime Playground, ao lado do ID da sessão.