
Visão geral
O recurso de múltiplos agentes permite que um modelo crie e coordene subagentes em paralelo, sintetizando o trabalho deles para fornecer uma resposta final. Isso é especialmente eficaz em aplicativos com tarefas complexas que se beneficiam da delegação de trabalho em paralelo, como exploração de bases de código, documentação e implementação.
O recurso de múltiplos agentes está disponível em versão beta com todos os modelos GPT-5.6. Consulte a página do modelo antes de ativar o recurso de múltiplos agentes no seu aplicativo.
Quando usar múltiplos agentes
Muitas vezes, as tarefas podem ser divididas em partes independentes que um único agente executaria em sequência, mas que vários agentes conseguem executar em paralelo. O recurso de múltiplos agentes permite que um agente raiz delegue trabalho a vários subagentes que o executam simultaneamente. Isso pode trazer vários benefícios:
- Execução paralela. Tarefas independentes de pesquisa, análise ou implementação podem avançar ao mesmo tempo, o que pode acelerar a execução.
- Contexto focado. Cada subagente recebe uma tarefa com escopo delimitado e mantém seu próprio contexto, o que reduz a interferência entre contextos de frentes de trabalho não relacionadas e melhora o desempenho.
- Coordenação orientada pelo modelo. O agente raiz pode criar subagentes, enviar informações adicionais a eles, aguardar resultados e sintetizar uma resposta final sem exigir que seu aplicativo implemente a orquestração.
A orquestração de múltiplos agentes é mais útil quando uma tarefa pode ser dividida em frentes de trabalho concretas e independentes, como:
- Explorar partes distintas de uma base de código grande
- Comparar várias propostas, documentos ou hipóteses
- Pesquisar várias fontes em paralelo
- Implementar componentes independentes ou escrever suítes de testes independentes
- Investigar diferentes causas possíveis de uma falha em paralelo
- Explorar diferentes abordagens para um problema simultaneamente
Adicionar subagentes pode aumentar o uso de tokens e talvez não seja tão vantajoso para tarefas que dependem de uma única sequência ordenada de raciocínio, exigem gravações frequentes em um estado mutável compartilhado ou já têm a maior parte do tempo de execução consumida por uma única operação externa lenta.
| Use múltiplos agentes quando | Prefira um único agente quando |
|---|---|
| O trabalho puder ser dividido em tarefas independentes com escopo delimitado | Cada etapa depender diretamente da anterior |
| Contextos separados melhorarem o foco | A tarefa for pequena o suficiente para ser concluída em uma única execução curta |
| A exploração paralela puder reduzir o tempo total decorrido | Os agentes disputarem o mesmo recurso mutável |
| A comparação de descobertas independentes melhorar a cobertura | Você precisar de um grafo de execução fixo e determinístico |
Início rápido
Os exemplos em Python e JavaScript usam o SDK beta da Responses. Para solicitações HTTP,
use client.beta.responses e passe responses_multi_agent=v1 no
argumento betas. Para solicitações HTTP diretas e conexões WebSocket, passe
OpenAI-Beta: responses_multi_agent=v1 nos cabeçalhos da solicitação ou da conexão.
Os esquemas dos itens podem mudar enquanto o recurso de múltiplos agentes estiver em versão beta.
Ative o recurso de múltiplos agentes na sua solicitação à Responses API com multi_agent.enabled. Quando multi_agent.enabled é true, o agente raiz passa a poder criar uma árvore de subagentes. Os subagentes compartilham o modelo e as ferramentas disponíveis na solicitação, enquanto os agentes se coordenam por meio de primitivas de colaboração, como criação de subagentes, troca de mensagens e espera (consulte Como funciona o recurso de múltiplos agentes). O agente raiz é responsável por sintetizar as respostas dos subagentes e fornecer a resposta final.
from openai import OpenAI
client = OpenAI()
def review_pull_request(diff: str) -> str:
response = client.beta.responses.create(
model="gpt-5.6-sol",
input=(
"Review the pull-request diff below with three agents: one for "
"correctness, one for security, and one for missing tests. "
"Reconcile duplicate or conflicting findings, then return a "
"prioritized review with file and line references.\n\n"
f"<diff>\n{diff}\n</diff>"
),
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
betas=["responses_multi_agent=v1"],
)
return "".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)max_concurrent_subagents define o número máximo de subagentes que podem estar ativos simultaneamente em toda a árvore de agentes. Isso inclui todos os descendentes, como filhos, netos e subagentes em níveis mais profundos, mas exclui o agente raiz.
A API não impõe um limite superior fixo para essa configuração. O padrão é 3, recomendado para a maioria das cargas de trabalho. As execuções com múltiplos agentes também não têm limite fixo para a profundidade da árvore nem para o número total de subagentes criados durante uma execução.
Adicione uma mensagem de desenvolvedor para ajustar quando o modelo raiz deve criar subagentes. Essa mensagem de desenvolvedor complementa as instruções injetadas para o agente raiz e os subagentes.
Exemplos de mensagens de desenvolvedor:
- “Não crie subagentes, a menos que o usuário peça explicitamente subagentes, delegação ou trabalho de agentes em paralelo.”
- “A delegação proativa com múltiplos agentes está ativa. Use subagentes quando o trabalho em paralelo puder melhorar significativamente a velocidade ou a qualidade.”
Como funciona o recurso de múltiplos agentes
A Responses API fornece aos modelos do agente raiz e dos subagentes ações de orquestração hospedadas e instruções para usá-las. O agente raiz se chama /root. Os subagentes criados usam caminhos hierárquicos, como:
/root
├── /root/researcher
├── /root/reviewer
└── /root/reviewer/tester
O recurso de múltiplos agentes não impõe um limite fixo para o número total de subagentes nem para a profundidade da árvore. Para a maioria das tarefas, use o valor padrão de max_concurrent_subagents, que é 3. Essa configuração limita o número de turnos ativos de subagentes em toda a árvore, incluindo filhos e descendentes em níveis mais profundos.
Quando o modo de múltiplos agentes está ativado, a Responses API fornece seis ações de colaboração hospedadas. Elas podem aparecer como itens multi_agent_call. Seu aplicativo não deve executá-las nem enviar saídas para elas.
| Ação | Finalidade |
|---|---|
spawn_agent | Cria um subagente e atribui sua tarefa inicial. |
send_message | Coloca uma mensagem na fila para um agente existente sem iniciar um novo turno. |
followup_task | Atribui mais trabalho a um agente existente que não seja o agente raiz e inicia ou retoma seu turno. |
wait_agent | Aguarda uma atualização na caixa de entrada do agente que fez a chamada. |
interrupt_agent | Interrompe o turno ativo de outro agente sem excluir seu contexto. |
list_agents | Retorna a árvore de agentes atual, os status e o last_task_message de cada agente. |
O tratamento de chamadas de ferramentas definidas pelo desenvolvedor funciona da mesma forma que quando o recurso de múltiplos agentes está desativado. Qualquer agente na árvore pode emitir um function_call. Seu aplicativo deve executar a chamada e enviar um function_call_output correspondente.
Todos os agentes na árvore têm acesso às ferramentas configuradas na chamada ao modelo da solicitação à API.
Como usar múltiplos agentes na Responses API
Desempenho de HTTP e WebSocket
HTTP e WebSocket oferecem suporte às mesmas capacidades de múltiplos agentes, mas o WebSocket é recomendado para fluxos de trabalho de longa duração ou que usam muitas ferramentas. Sua conexão persistente permite que seu aplicativo retorne as saídas das funções à medida que ficam disponíveis, reduzindo a sobrecarga de continuação e o tempo de espera dos agentes.
Com HTTP, a resposta é concluída quando todos os agentes ativos terminam ou pausam para aguardar uma chamada de função executada pelo cliente. Em seguida, seu aplicativo executa todas as chamadas de função pendentes e envia suas saídas em uma nova solicitação à Responses API, permitindo que os agentes pausados retomem a execução.
Com WebSocket, seu aplicativo pode injetar a saída de cada função na resposta assim que ela fica disponível, sem esperar que a resposta ativa seja concluída. O agente em espera pode retomar a execução imediatamente enquanto os outros agentes continuam trabalhando. Isso reduz os atrasos de coordenação e evita ciclos extras de ida e volta de solicitações quando os agentes terminam ou solicitam ferramentas em momentos diferentes.
HTTP pode ser suficiente para fluxos de trabalho que exigem chamadas a várias ferramentas hospedadas, como pesquisas na Web em paralelo, ou fluxos de uma única solicitação com poucas chamadas de função. Para a maioria dos fluxos de trabalho com múltiplos agentes, o WebSocket tende a oferecer menor latência e melhor desempenho de ponta a ponta.
Execução de chamadas de função via HTTP
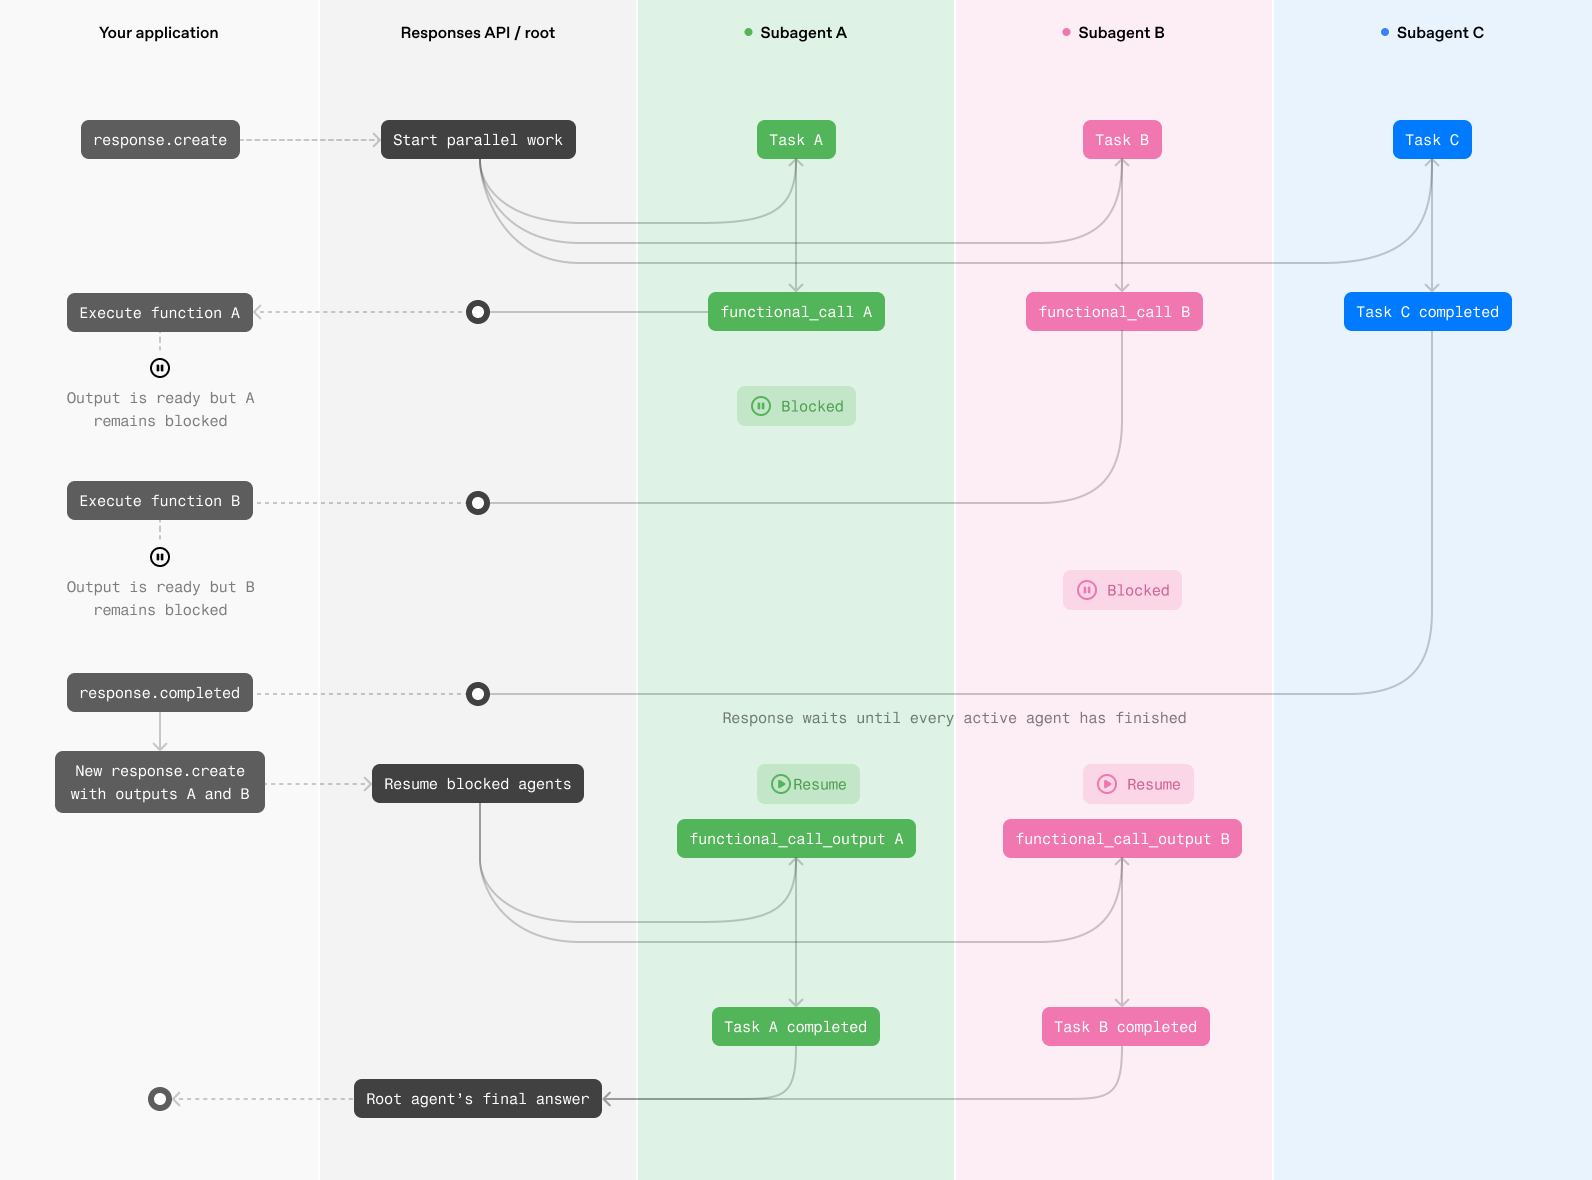
Execução de chamadas de função via WebSocket
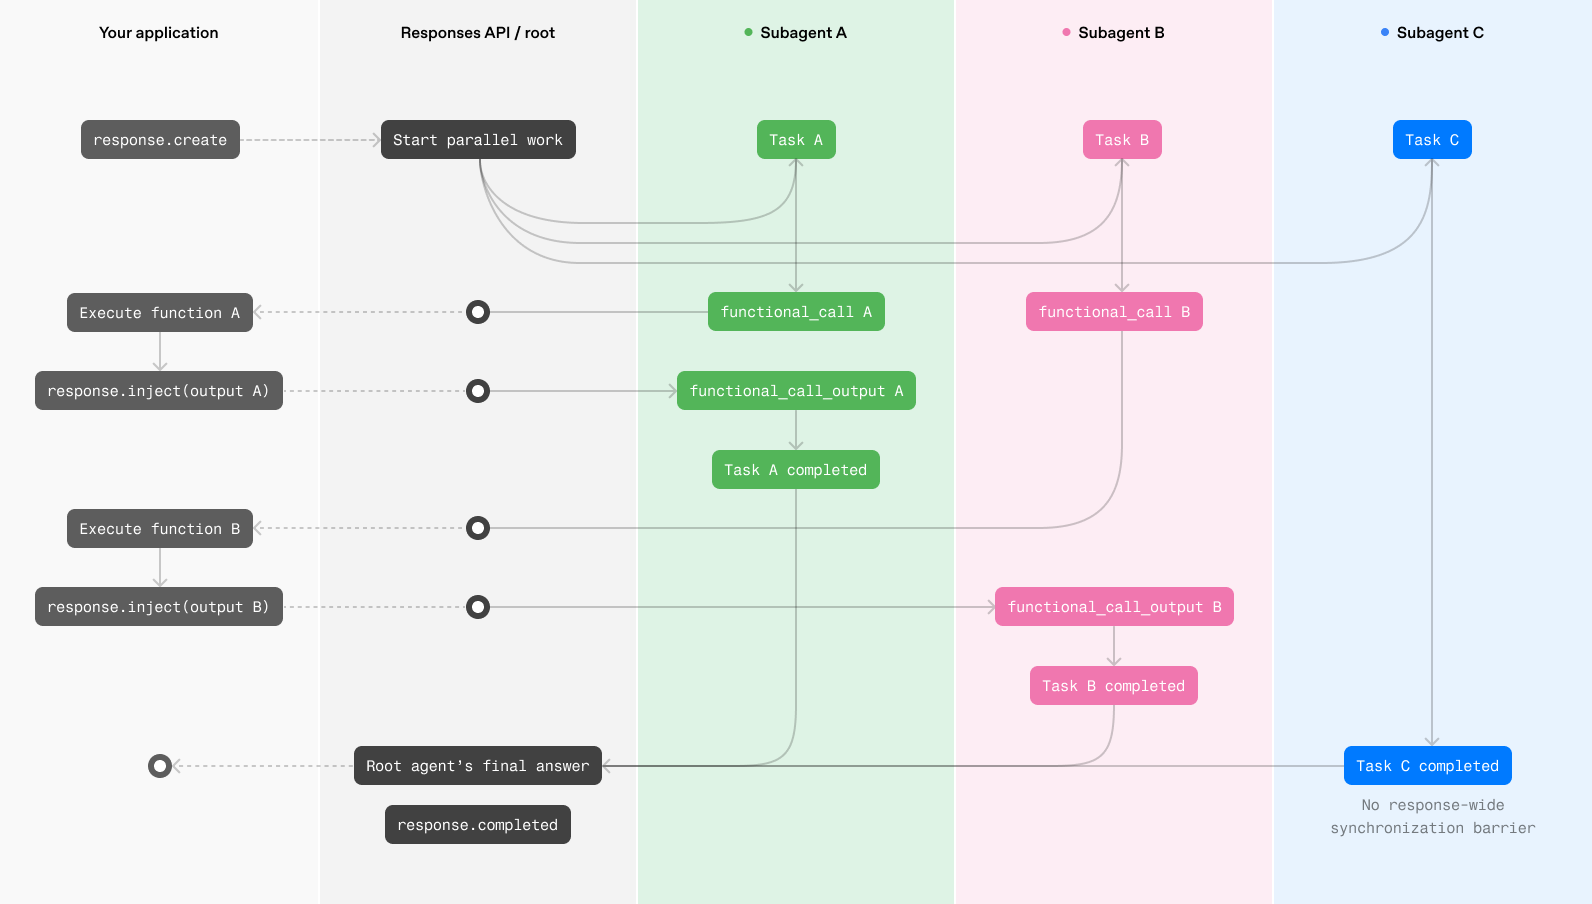
HTTP
Estes exemplos exigem versões beta do SDK que disponibilizem a Responses API beta. Para streaming via HTTP, chame client.beta.responses.create e passe responses_multi_agent=v1 no argumento betas; isso habilita os tipos beta e o preenchimento automático. Em Python, importe os tipos de itens de resposta beta de openai.types.beta ao adicionar anotações de tipo.
Exemplo de código do lado do cliente:
from __future__ import annotations
import json
import sys
from openai import OpenAI
from openai.types.beta import BetaResponseOutputItem
client = OpenAI()
ROOT = "/root"
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
history = [
{
"role": "user",
"content": "Compare proposal alpha and proposal beta.",
}
]
def agent_name(item: BetaResponseOutputItem) -> str:
return item.agent.agent_name if item.agent else ROOT
def render_to_user(delta: str) -> None:
print(delta, end="", flush=True)
def log_subagent_text(agent: str, delta: str) -> None:
print(f"[{agent}] {delta}", end="", file=sys.stderr, flush=True)
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
while True:
output_items = []
pending_calls = []
item_agents: dict[int, str] = {}
stream = client.beta.responses.create(
model="gpt-5.6-sol",
input=history,
tools=tools,
store=False,
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
stream=True,
betas=["responses_multi_agent=v1"],
)
for event in stream:
if event.type == "response.output_item.added":
item_agents[event.output_index] = agent_name(event.item)
elif event.type == "response.output_text.delta":
agent = item_agents.get(event.output_index, ROOT)
if agent == ROOT:
render_to_user(event.delta)
else:
log_subagent_text(agent, event.delta)
elif event.type == "response.output_item.done":
output_items.append(event.item)
if event.item.type == "function_call":
# Handle function calls from both the root agent and subagents.
pending_calls.append(event.item)
elif event.type == "response.completed":
print(f"\nUsage: {event.response.usage}", file=sys.stderr)
break
elif event.type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
history.extend(output_items)
for call in pending_calls:
history.append(
{
"type": "function_call_output",
"call_id": call.call_id,
"output": process_tool_call(call.name, call.arguments),
}
)
if not pending_calls:
breakSe um ou mais agentes chamarem funções definidas pelo desenvolvedor, execute todas as chamadas pendentes e crie uma requisição de continuação contendo suas saídas.
WebSocket
No modo WebSocket, quando um agente chamar uma função definida pelo desenvolvedor, execute a função no seu aplicativo e envie o resultado para a resposta ativa com um evento response.inject. O agente que estava aguardando poderá então retomar a execução sem esperar a conclusão de toda a resposta de Múltiplos agentes.
{
"type": "response.inject",
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
]
}Para uma requisição response.inject válida, o servidor responde com um de dois eventos:
response.inject.created: a entrada foi validada e aceita para injeçãoresponse.inject.failed: a entrada não foi injetada; verifiqueerror.code
{
"type": "response.inject.created",
"sequence_number": 42,
"response_id": "resp_123"
}{
"type": "response.inject.failed",
"sequence_number": 43,
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
],
"error": {
"code": "response_already_completed",
"message": "Response 'resp_123' has already completed."
}
}Se uma requisição não estiver de acordo com o esquema de response.inject, o servidor enviará um erro genérico com status 400 e fechará a conexão WebSocket. Corrija a requisição e abra uma nova conexão WebSocket antes de enviar outro evento.
O SDK beta de Python disponibiliza o modo WebSocket por meio de client.beta.responses.connect. O SDK beta de TypeScript o disponibiliza por meio de ResponsesWS. Passe OpenAI-Beta: responses_multi_agent=v1 nos cabeçalhos da conexão; diferentemente do streaming via HTTP, os conectores WebSocket ainda não aceitam o argumento betas.
Salve o ID da resposta recebido no evento response.created e inclua-o em todos os eventos response.inject que enviar para essa resposta. Depois de enviar um item de injeção, continue lendo do WebSocket até que a resposta seja concluída e cada injeção tenha gerado um evento response.inject.created ou response.inject.failed.
from __future__ import annotations
import json
from openai import OpenAI
client = OpenAI()
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
def run_multi_agent(connection):
previous_response_id: str | None = None
pending_input: list[dict[str, object]] = [{"role": "user", "content": input()}]
while pending_input:
request = {
"type": "response.create",
"model": "gpt-5.6-sol",
"store": True,
"multi_agent": {"enabled": True},
"tools": tools,
"input": pending_input,
}
if previous_response_id is not None:
request["previous_response_id"] = previous_response_id
connection.send(request)
next_input: list[dict[str, object]] = []
completed_response = None
response_id: str | None = None
pending_injections = 0
for event in connection:
event_type = event.type
if event_type == "response.created":
response_id = event.response.id
elif event_type == "response.output_item.done":
item = event.item
if item.type == "function_call":
if response_id is None:
raise RuntimeError(
"Received a function call before response.created"
)
output = {
"type": "function_call_output",
"call_id": item.call_id,
"output": process_tool_call(item.name, item.arguments),
}
pending_injections += 1
connection.send(
{
"type": "response.inject",
"response_id": response_id,
"input": [output],
}
)
elif event_type == "response.inject.created":
pending_injections -= 1
elif event_type == "response.inject.failed":
pending_injections -= 1
if event.error.code != "response_already_completed":
raise RuntimeError(event.error)
next_input.extend(item.model_dump(mode="json") for item in event.input)
elif event_type == "response.completed":
completed_response = event.response
elif event_type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
if completed_response is not None and pending_injections == 0:
break
if completed_response is None:
raise RuntimeError("Connection ended before response.completed")
if not next_input:
return completed_response
previous_response_id = completed_response.id
pending_input = next_input
with client.beta.responses.connect(
extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
) as connection:
run_multi_agent(connection)Depois de enviar um evento response.inject, continue lendo do WebSocket e trate a confirmação:
response.inject.created: A saída da função foi adicionada à resposta ativa. Continue lendo os eventos dessa resposta.response.inject.failedcomresponse_already_completed: A resposta foi concluída antes que a saída da função pudesse ser adicionada. Use oinputretornado no evento de falha e envie-o em uma nova requisiçãoresponse.createque dê continuidade à resposta concluída.response.inject.failedcomresponse_not_found: O servidor não conseguiu encontrar a resposta identificada porresponse_id. Verifique se você está usando o ID recebido emresponse.created.
Uma única execução de Múltiplos agentes pode abranger várias requisições à Responses API. Via HTTP, quando um agente chama uma função definida pelo desenvolvedor, seu aplicativo executa a função e envia sua saída em uma nova chamada response.create. Via WebSocket, seu aplicativo injeta a saída da função diretamente na resposta ativa.
Novos itens de saída de Múltiplos agentes
As respostas de Múltiplos agentes podem incluir três tipos adicionais de itens de saída:
multi_agent_call: registra uma ação hospedada de Múltiplos agentes, comospawn_agent.multi_agent_call_output: contém o resultado da execução de uma ação hospedada.agent_message: transporta uma mensagem criptografada de um agente para outro.
O campo call_id vincula cada multi_agent_call ao seu multi_agent_call_output correspondente.
Cada item também inclui um atributo agent. Em um agent_message, agent.agent_name identifica o agente destinatário. Use author e recipient para rastrear a direção da mensagem.
Quando seu aplicativo receber um multi_agent_call, não o execute como uma chamada de função nem envie um resultado de volta. A Responses API executa a ação hospedada e retorna o multi_agent_call_output correspondente. Preserve ambos os itens se seu aplicativo precisar deles para reexecução ou rastreamento.
[
{
"type": "multi_agent_call",
"id": "mac_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"arguments": "{\"task_name\":\"agent_a\",\"fork_turns\":\"all\",\"message\":\"enc_...\"}",
"agent": { "agent_name": "/root" }
},
{
"type": "multi_agent_call_output",
"id": "maco_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"output": [
{
"type": "output_text",
"text": "{\"task_name\":\"/root/agent_a\"}",
"annotations": [],
"logprobs": []
}
],
"agent": { "agent_name": "/root" }
},
{
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
]Os eventos SSE atribuídos a agentes incluem um atributo agent no nível superior. Em um evento agent_message, agent.agent_name identifica o agente destinatário. Eventos do ciclo de vida da resposta, como response.created e response.completed, descrevem a resposta como um todo, e não um agente individual, por isso não incluem um atributo agent.
{
"type": "response.output_item.done",
"agent": { "agent_name": "/root" },
"item": {
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
}Limitações
- Compactação:
- O endpoint
/responses/compactnão é compatível com o recurso Múltiplos agentes habilitado. - Quando
multi_agent.enabledestá definido comotrue, a compactação automática do lado do servidor é habilitada implicitamente, mesmo que a requisição não configurecontext_management. A compactação é aplicada de forma independente ao agente raiz e a cada subagente, preservando seus contextos separados. Os usuários ainda podem substituircompact_thresholddefinindo explicitamentecontext_management.compact_thresholdna requisição.
- O endpoint
reasoning.summarynão é compatível com o recurso Múltiplos agentes habilitado.max_tool_callsnão é compatível com o recurso Múltiplos agentes habilitado.max_concurrent_subagentstem como padrão3, que é a configuração recomendada.
Orientações sobre prompts
Quando o recurso Múltiplos agentes está habilitado, nossos sistemas acrescentam automaticamente estas instruções ao agente raiz e aos subagentes como uma nova mensagem de desenvolvedor. Você não pode editar nem remover essas instruções, mas deve formular suas instruções de desenvolvedor como um complemento às instruções injetadas automaticamente.
Agente raiz
You are `/root`, the primary agent in a team of agents collaborating to fulfill the user's goals.

At the start of your turn, you are the active agent.
You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents.
All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent without triggering a turn.
Child agents can also spawn their own sub-agents.
You can decide how much context you want to propagate to your sub-agents with the `fork_turns` parameter.

You will receive messages in the form:
```
Message Type: MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
They may be addressed as to=/root

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.
Subagente
You are an agent in a team of agents collaborating to complete a task.

You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents. All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent.
Child agents can also spawn their own sub-agents.

When you provide a response in the final channel, that content is immediately delivered back to your parent agent.

You will receive messages in the form:
```
Message Type: NEW_TASK | MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
You may also see them addressed as to=/root/..., which indicates your identity is /root/...

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.