Aprenda a transformar texto em números para viabilizar casos de uso como pesquisa.
New embedding models
text-embedding-3-small and text-embedding-3-large, our newest and most performant embedding models, are now available. They feature lower costs, higher multilingual performance, and new parameters to control the overall size.
O que são embeddings?
Os embeddings de texto da OpenAI medem o grau de relação entre strings de texto. Os embeddings são comumente usados para:
Pesquisar (os resultados são ordenados por relevância em relação a uma string de consulta)
Agrupamento (strings de texto são agrupadas por similaridade)
Recomendações (itens com strings de texto relacionadas são recomendados)
Detecção de anomalias (valores atípicos com baixo grau de relação são identificados)
Medição de diversidade (distribuições de similaridade são analisadas)
Classificação (strings de texto são classificadas pelo rótulo mais similar)
Um embedding é um vetor (lista) de números de ponto flutuante. A distância entre dois vetores mede o grau de relação entre eles. Distâncias pequenas sugerem um alto grau de relação, e distâncias grandes sugerem um baixo grau de relação.
Visite nossa página de preços para saber mais sobre os preços dos embeddings. As requisições são cobradas com base no número de tokens na entrada.
Como obter embeddings
Para obter um embedding, envie sua string de texto para o endpoint da API de embeddings junto com o nome do modelo de embeddings (por exemplo, text-embedding-3-small):
A resposta contém o vetor de embedding (lista de números de ponto flutuante) e alguns metadados adicionais. Você pode extrair o vetor de embedding, salvá-lo em um banco de dados vetorial e utilizá-lo em diversos casos de uso.
Por padrão, o comprimento do vetor de embedding é 1536 para text-embedding-3-small ou 3072 para text-embedding-3-large. Para reduzir as dimensões do embedding sem perder sua capacidade de representar conceitos, forneça o parâmetro dimensions. Veja mais detalhes sobre as dimensões dos embeddings na seção de casos de uso de embeddings.
Modelos de embeddings
A OpenAI oferece dois modelos avançados de embeddings de terceira geração (identificados por -3 no ID do modelo). Leia o anúncio no blog sobre os embeddings v3 para saber mais.
O uso é cobrado por token de entrada. Abaixo, mostramos um exemplo de quantas páginas de texto podem ser processadas por dólar americano (considerando cerca de 800 tokens por página):
O conjunto de dados contém um total de 568.454 avaliações de alimentos feitas por usuários da Amazon até outubro de 2012. Usamos um subconjunto das 1.000 avaliações mais recentes para fins de demonstração. As avaliações estão em inglês e tendem a ser positivas ou negativas. Cada avaliação contém ProductId, UserId, Score, o título da avaliação (Summary) e o corpo da avaliação (Text). Por exemplo:
ID do produto
ID do usuário
Nota
Resumo
Texto
B001E4KFG0
A3SGXH7AUHU8GW
5
Ração para cães de boa qualidade
Já comprei vários dos enlatados da Vitality...
B00813GRG4
A1D87F6ZCVE5NK
1
Diferente do anunciado
O produto chegou com o rótulo de amendoim jumbo salgado...
Abaixo, combinamos o resumo e o texto da avaliação em um único texto. O modelo codifica esse texto combinado e gera um único embedding vetorial.
Usar embeddings maiores, por exemplo, armazenando-os em um armazenamento vetorial para recuperação, geralmente custa mais e consome mais recursos computacionais, memória e armazenamento do que usar embeddings menores.
Nossos dois novos modelos de embeddings foram treinados com uma técnica que permite aos desenvolvedores equilibrar o desempenho e o custo de uso dos embeddings. Especificamente, os desenvolvedores podem encurtar os embeddings (ou seja, remover alguns números do final da sequência) sem que eles percam suas propriedades de representação de conceitos, usando o parâmetro dimensions da API. Por exemplo, no benchmark MTEB, um embedding de text-embedding-3-large pode ser reduzido para um tamanho de 256 e ainda superar um embedding de text-embedding-ada-002 não reduzido, com tamanho de 1536. Você pode saber mais sobre como a alteração das dimensões afeta o desempenho em nossa publicação no blog sobre o lançamento dos embeddings v3.
Em geral, a abordagem recomendada é usar o parâmetro dimensions ao criar o embedding. Em certos casos, pode ser necessário alterar a dimensão do embedding após gerá-lo. Ao alterar a dimensão manualmente, certifique-se de normalizar as dimensões do embedding, como mostrado abaixo.
Alterar as dimensões dinamicamente permite um uso bastante flexível. Por exemplo, ao usar um armazenamento de dados vetoriais que só oferece suporte a embeddings de até 1024 dimensões, os desenvolvedores agora podem usar nosso melhor modelo de embeddings, text-embedding-3-large, e especificar o valor 1024 para o parâmetro dimensions da API. Isso reduzirá o embedding de 3072 dimensões, sacrificando um pouco da acurácia em troca de um vetor menor.
Em muitas situações comuns, o modelo não foi treinado com dados que contêm os fatos e as informações essenciais que você deseja disponibilizar ao gerar respostas às consultas dos usuários. Uma forma de resolver isso, como mostrado abaixo, é inserir informações adicionais na janela de contexto do modelo. Essa abordagem é eficaz em muitos casos de uso, mas aumenta os custos com tokens. Neste notebook, exploramos as vantagens e desvantagens dessa abordagem em comparação com a pesquisa baseada em embeddings.
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constclient=newOpenAI();constarticle="At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";constquestion=`Use the article below to answer the question. If the answer cannot be found, say "I don't know."Article:${article}Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;constresponse=await client.chat.completions.create({ model: "gpt-4.1-mini", messages: [ { role: "system", content: "You answer questions about the 2022 Winter Olympics.", }, { role: "user", content: question }, ], temperature: 0,});console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."Article:\"\"\"{wikipedia_article_on_curling}\"\"\"Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""response = client.chat.completions.create( messages=[ { "role": "system", "content": "You answer questions about the 2022 Winter Olympics.", }, {"role": "user", "content": query}, ], model=GPT_MODEL, temperature=0,)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";String question = "Use the below article on the 2022 Winter Olympics to answer the subsequent question. " + "If the answer cannot be found, write \"I don't know.\"\n\n" + "Article:\n" + article + "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";ChatCompletionCreateParams params = ChatCompletionCreateParams.builder() .model("gpt-4.1-mini") .addSystemMessage("You answer questions about the 2022 Winter Olympics.") .addUserMessage(question) .temperature(0) .build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"client = OpenAI::Client.newarticle = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."question = <<~QUESTION Use the article below to answer the question. If the answer cannot be found, say "I don't know." Article: #{article} Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?QUESTIONresponse = client.chat.completions.create( model: "gpt-4.1-mini", messages: [ { role: :system, content: "You answer questions about the 2022 Winter Olympics." }, { role: :user, content: question } ], temperature: 0)puts(response.choices.fetch(0).message.content)
Para recuperar os documentos mais relevantes, usamos a similaridade de cosseno entre os vetores de embeddings da consulta e de cada documento e retornamos os documentos com as maiores pontuações.
A pesquisa de código funciona de forma semelhante à pesquisa de texto baseada em embeddings. Fornecemos um método para extrair funções Python de todos os arquivos Python de um determinado repositório. Cada função é então indexada pelo modelo text-embedding-3-small.
Para realizar uma pesquisa de código, geramos um embedding da consulta em linguagem natural usando o mesmo modelo. Em seguida, calculamos a similaridade de cosseno entre o embedding resultante da consulta e cada um dos embeddings das funções. Os resultados com maior similaridade de cosseno são os mais relevantes.
Como distâncias menores entre vetores de embeddings representam maior similaridade, os embeddings podem ser úteis para recomendações.
Abaixo, ilustramos um sistema básico de recomendação. Ele recebe uma lista de strings e uma string de 'referência', calcula seus embeddings e retorna as strings ordenadas da mais similar à menos similar. Como exemplo concreto, o notebook no link abaixo aplica uma versão dessa função ao conjunto de dados de notícias AG (reduzido a uma amostra de 2.000 descrições de notícias) para retornar os 5 artigos mais similares a um determinado artigo de referência.
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from"openai";constclient=newOpenAI();conststrings= ["A cheetah is a fast land animal.","A peregrine falcon is a fast bird.","A tortoise moves slowly.",];const { data } =await client.embeddings.create({ model: "text-embedding-3-small", input: strings,});constquery= data[0].embedding;constrecommendations= data .map(({ embedding }, index) => {constdotProduct= embedding.reduce( (total, value, dimension) => total + value * query[dimension],0 );constsimilarity= dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));return { index, text: strings[index], similarity }; }) .sort((left, right) => right.similarity - left.similarity);console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings( strings: list[str], index_of_source_string: int, model="text-embedding-3-small",) -> list[int]: """Return nearest neighbors of a given string.""" # get embeddings for all strings embeddings = [embedding_from_string(string, model=model) for string in strings] # get the embedding of the source string query_embedding = embeddings[index_of_source_string] # get distances between the source embedding and other embeddings (function from embeddings_utils.py) distances = distances_from_embeddings( query_embedding, embeddings, distance_metric="cosine" ) # get indices of nearest neighbors (function from embeddings_utils.py) indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances( distances ) return indices_of_nearest_neighbors
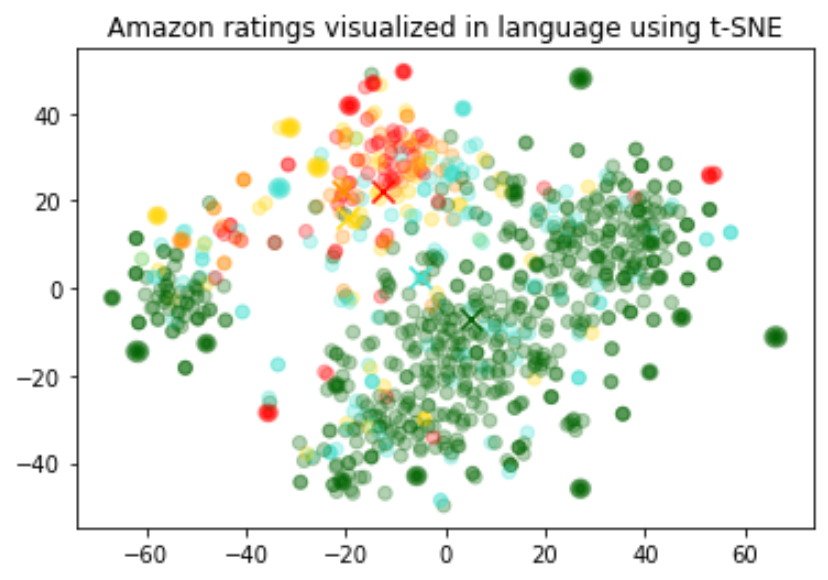
O tamanho dos embeddings varia conforme a complexidade do modelo subjacente. Para visualizar esses dados de alta dimensionalidade, usamos o algoritmo t-SNE para transformá-los em duas dimensões.
Colorimos cada avaliação de acordo com o número de estrelas atribuído pelo autor:
1 estrela: vermelho
2 estrelas: laranja-escuro
3 estrelas: dourado
4 estrelas: turquesa
5 estrelas: verde-escuro
A visualização parece ter produzido aproximadamente 3 grupos, um deles composto principalmente por avaliações negativas.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import numpy as npimport pandas as pdfrom sklearn.manifold importTSNEimport matplotlib.pyplot as pltimport matplotlibdf = pd.read_csv("output/embedded_1k_reviews.csv")matrix = np.array(df.ada_embedding.apply(eval).to_list())# Create a t-SNE model and transform the datatsne = TSNE(n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200)vis_dims = tsne.fit_transform(matrix)colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]x = [x for x, y in vis_dims]y = [y for x, y in vis_dims]color_indices = df.Score.values -1colormap = matplotlib.colors.ListedColormap(colors)plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)plt.title("Amazon ratings visualized in language using t-SNE")
Um embedding pode ser usado como codificador de atributos de texto livre de uso geral em um modelo de aprendizado de máquina. Incorporar embeddings melhorará o desempenho de qualquer modelo de aprendizado de máquina se algumas das entradas relevantes forem texto livre. Um embedding também pode ser usado como codificador de atributos categóricos em um modelo de aprendizado de máquina. Isso agrega mais valor quando os nomes das variáveis categóricas são significativos e numerosos, como nomes de cargos. Embeddings de similaridade geralmente têm desempenho melhor do que embeddings de pesquisa nessa tarefa.
Observamos que, em geral, a representação por embeddings é muito rica e concentra muitas informações. Por exemplo, reduzir a dimensionalidade das entradas usando SVD ou PCA, mesmo em apenas 10%, geralmente piora o desempenho em tarefas específicas nas etapas seguintes.
Este código divide os dados em um conjunto de treinamento e um conjunto de teste, que serão usados nos dois casos de uso a seguir: regressão e classificação.
Os embeddings oferecem uma forma elegante de prever um valor numérico. Neste exemplo, prevemos a nota em estrelas atribuída pelo autor com base no texto da avaliação. Como os embeddings contêm muitas informações semânticas, a previsão é razoável mesmo com pouquíssimas avaliações.
Consideramos a nota uma variável contínua entre 1 e 5 e permitimos que o algoritmo preveja qualquer valor de ponto flutuante. O algoritmo de aprendizado de máquina minimiza a distância entre o valor previsto e a nota real e atinge um erro absoluto médio de 0,39. Isso significa que, em média, a previsão difere da nota real em menos de meia estrela.
Desta vez, em vez de fazer o algoritmo prever qualquer valor entre 1 e 5, tentaremos classificar o número exato de estrelas de uma avaliação em 5 categorias, que vão de 1 a 5 estrelas.
Após o treinamento, o modelo aprende a prever avaliações de 1 e 5 estrelas muito melhor do que as avaliações com mais nuances (2 a 4 estrelas), provavelmente porque os sentimentos são expressos de forma mais extrema.
Podemos usar embeddings para classificação zero-shot sem nenhum dado de treinamento rotulado. Para cada classe, geramos um embedding do nome ou de uma breve descrição da classe. Para classificar um novo texto de forma zero-shot, comparamos seu embedding com os embeddings de todas as classes e prevemos a classe com a maior similaridade.
Podemos obter um embedding de usuário calculando a média de todas as suas avaliações. Da mesma forma, podemos obter um embedding de produto calculando a média de todas as avaliações desse produto. Para demonstrar a utilidade dessa abordagem, usamos um subconjunto de 50 mil avaliações, abrangendo mais avaliações por usuário e por produto.
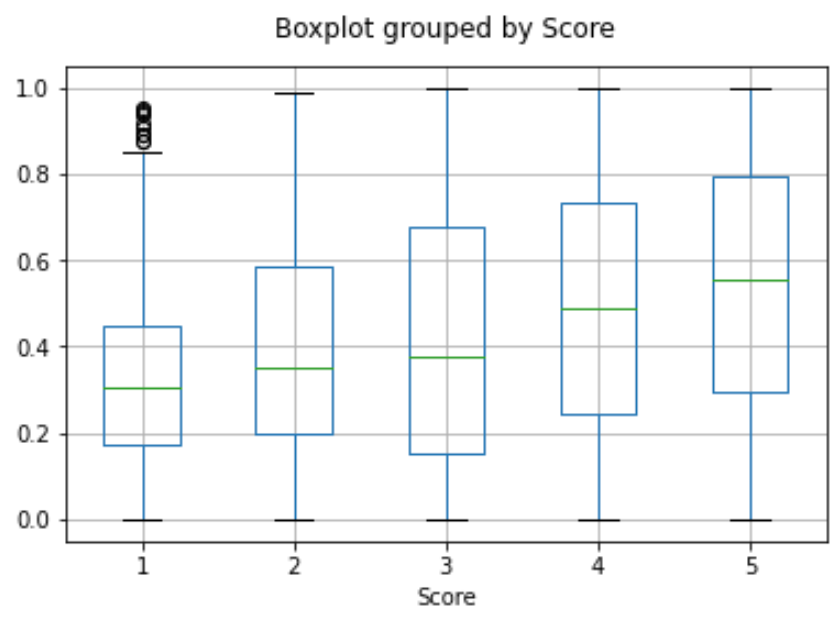
Avaliamos a utilidade desses embeddings em um conjunto de teste separado, no qual representamos em um gráfico a similaridade entre os embeddings de usuário e de produto em função da nota. É interessante observar que, com essa abordagem, mesmo antes de o usuário receber o produto, conseguimos prever se ele gostaria dele com um desempenho superior ao de uma previsão aleatória.
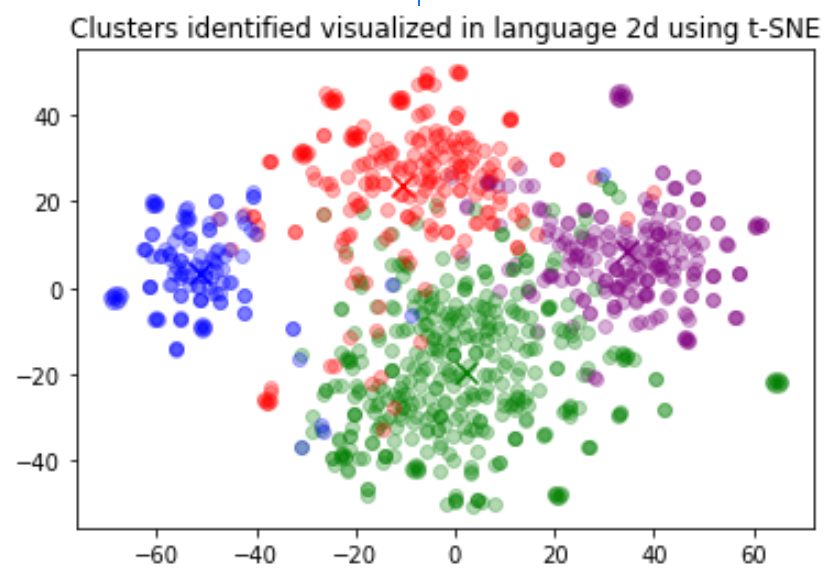
O agrupamento é uma forma de compreender um grande volume de dados textuais. Os embeddings são úteis nessa tarefa, pois fornecem representações vetoriais que capturam o significado de cada texto. Assim, de forma não supervisionada, o agrupamento revela grupos ocultos no nosso conjunto de dados.
Neste exemplo, identificamos quatro grupos distintos: um voltado a ração para cães, um a avaliações negativas e dois a avaliações positivas.
Como saber quantos tokens uma string tem antes de gerar seu embedding?
Em Python, você pode dividir uma string em tokens com o tokenizador tiktoken da OpenAI.
Exemplo de código:
1
2
3
4
5
6
7
8
9
10
11import tiktokendefnum_tokens_from_string(string: str, encoding_name: str) -> int:"""Returns the number of tokens in a text string.""" encoding = tiktoken.get_encoding(encoding_name) num_tokens =len(encoding.encode(string))return num_tokensnum_tokens_from_string("tiktoken is great!", "cl100k_base")
Para modelos de embedding de terceira geração, como text-embedding-3-small, use a codificação cl100k_base.
Como recuperar rapidamente os K vetores de embedding mais próximos?
Para fazer buscas rápidas em um grande número de vetores, recomendamos usar um banco de dados vetorial. Você encontra exemplos de como trabalhar com bancos de dados vetoriais e a API da OpenAI no nosso Cookbook no GitHub.
Qual função de distância devo usar?
Recomendamos a similaridade de cosseno. A escolha da função de distância geralmente não faz muita diferença.
Os embeddings da OpenAI são normalizados para ter norma 1, o que significa que:
A similaridade de cosseno pode ser calculada um pouco mais rápido usando apenas um produto escalar
A similaridade de cosseno e a distância euclidiana produzem ordenações idênticas
Posso compartilhar meus embeddings online?
Sim, os clientes são proprietários dos dados que fornecem aos nossos modelos e das saídas que recebem, inclusive no caso de embeddings. Você é responsável por garantir que o conteúdo enviado à nossa API não viole nenhuma lei aplicável nem nossos Termos de Uso.
Os modelos de embedding V3 têm conhecimento de eventos recentes?
Não, os modelos text-embedding-3-large e text-embedding-3-small não têm conhecimento de eventos ocorridos após setembro de 2021. Em geral, isso não representa uma limitação tão grande quanto representaria para modelos de geração de texto, mas pode reduzir o desempenho em certos casos atípicos.