
Em setembro de 2025, a OpenAI apresentou o GPT-5-Codex como a primeira versão do GPT-5 otimizada para programação agêntica. Em dezembro de 2025, lançamos o 5.2, momento em que as pessoas começaram a acreditar que podiam confiar em agentes autônomos de programação. Em particular, vimos um grande salto no tempo durante o qual o modelo conseguia seguir instruções de forma confiável.
Eu queria colocar esse limite à prova. Então, dei ao Codex um repositório vazio, acesso completo e uma tarefa: criar uma ferramenta de design do zero. Depois, deixei-o executar a tarefa com o GPT-5.3-Codex no nível de raciocínio “Extra alto”. O Codex trabalhou por cerca de 25 horas sem interrupção, usou aproximadamente 13 milhões de tokens e gerou cerca de 30 mil linhas de código.
Foi um experimento, não uma implantação em produção. Mas o desempenho foi bom nos aspectos que importam para trabalhos de longa duração: seguir a especificação, manter o foco na tarefa, executar verificações e corrigir falhas ao longo do processo.
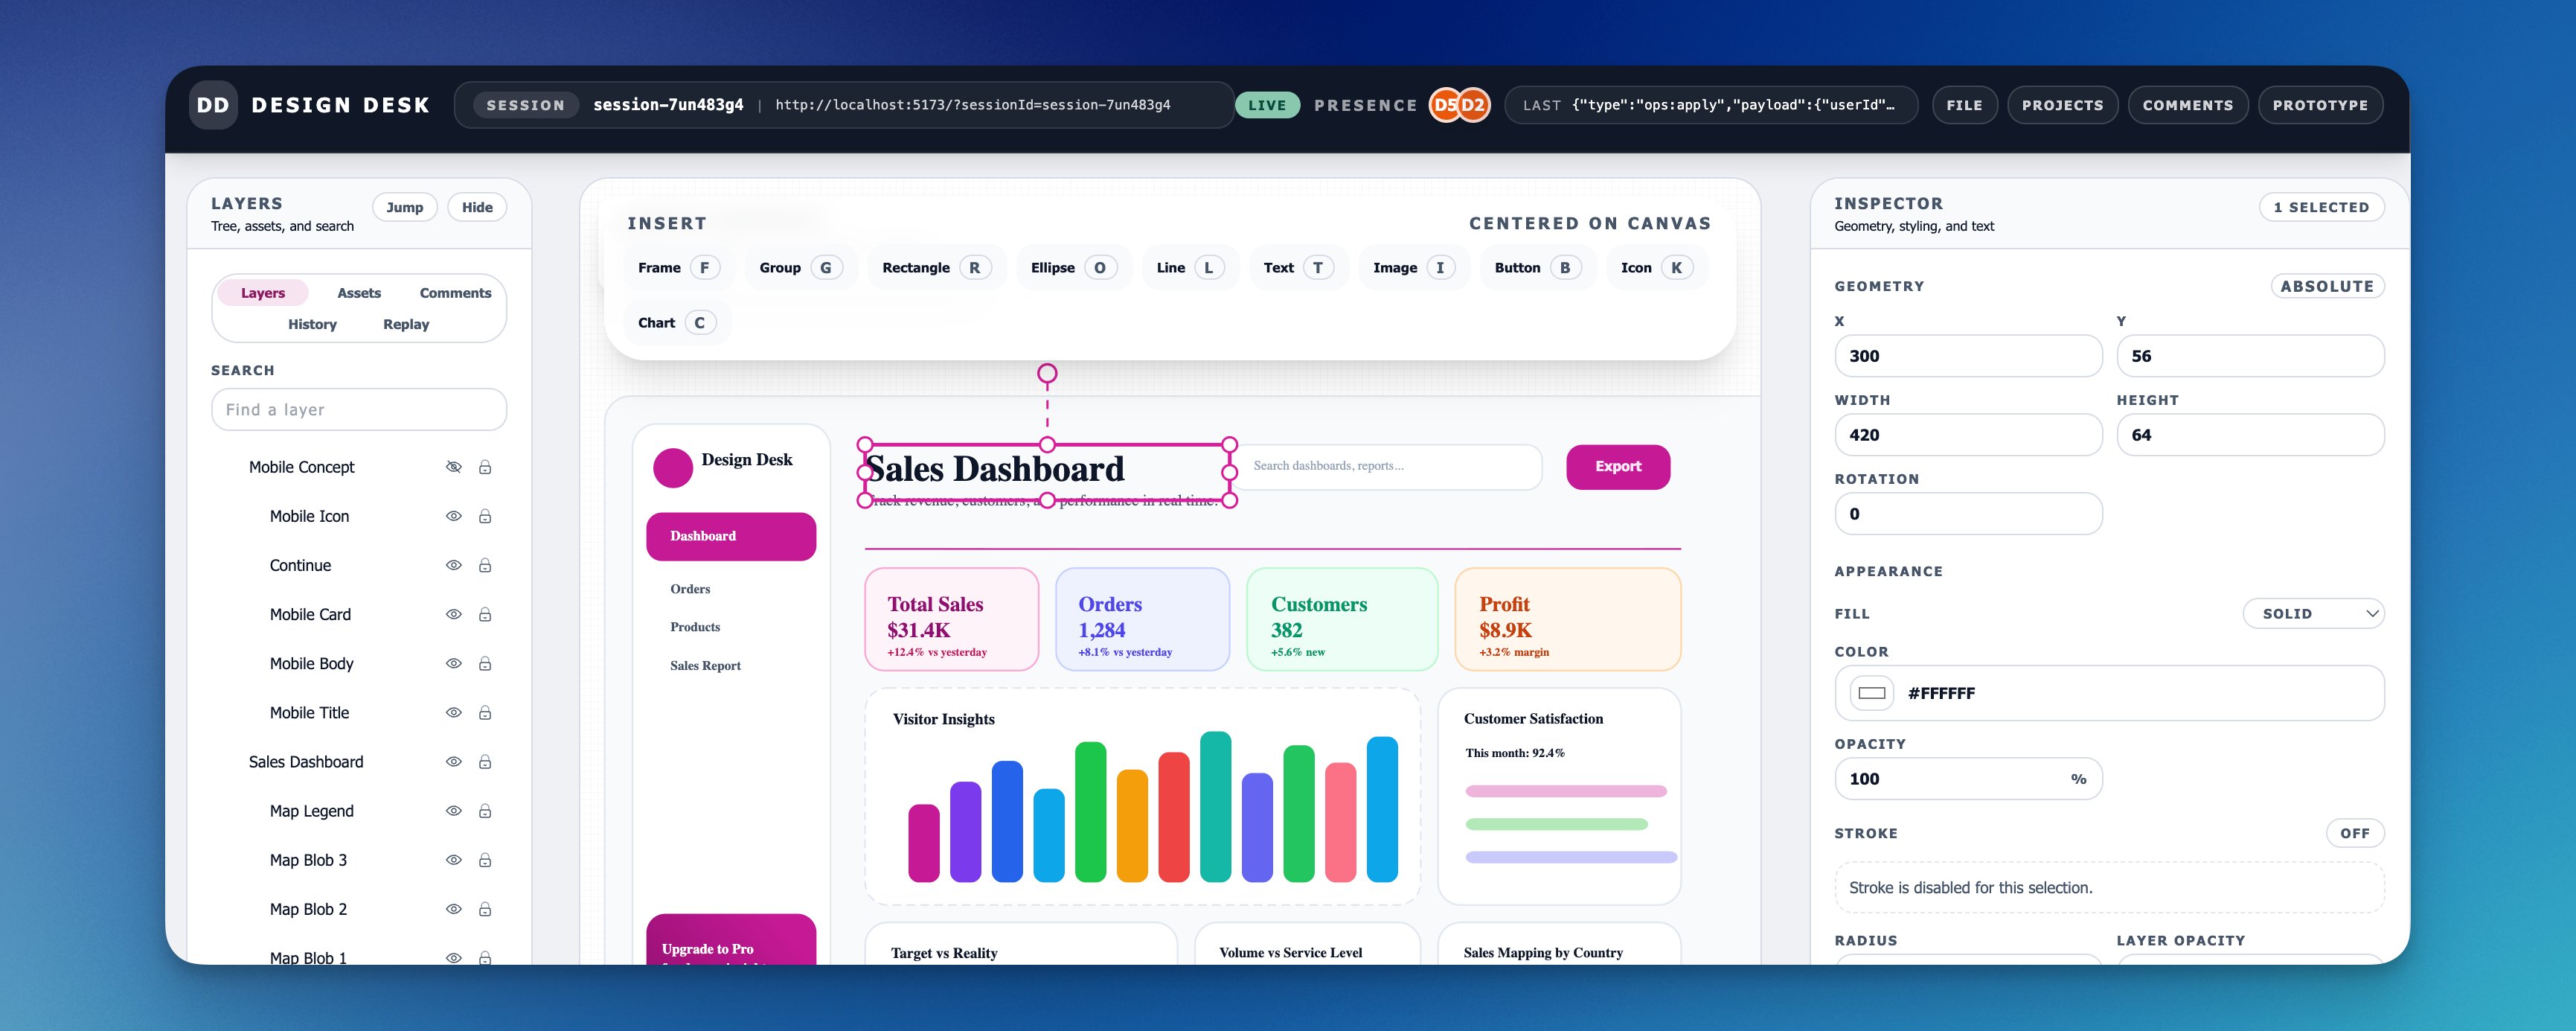
Como é uma sessão de longa duração do Codex
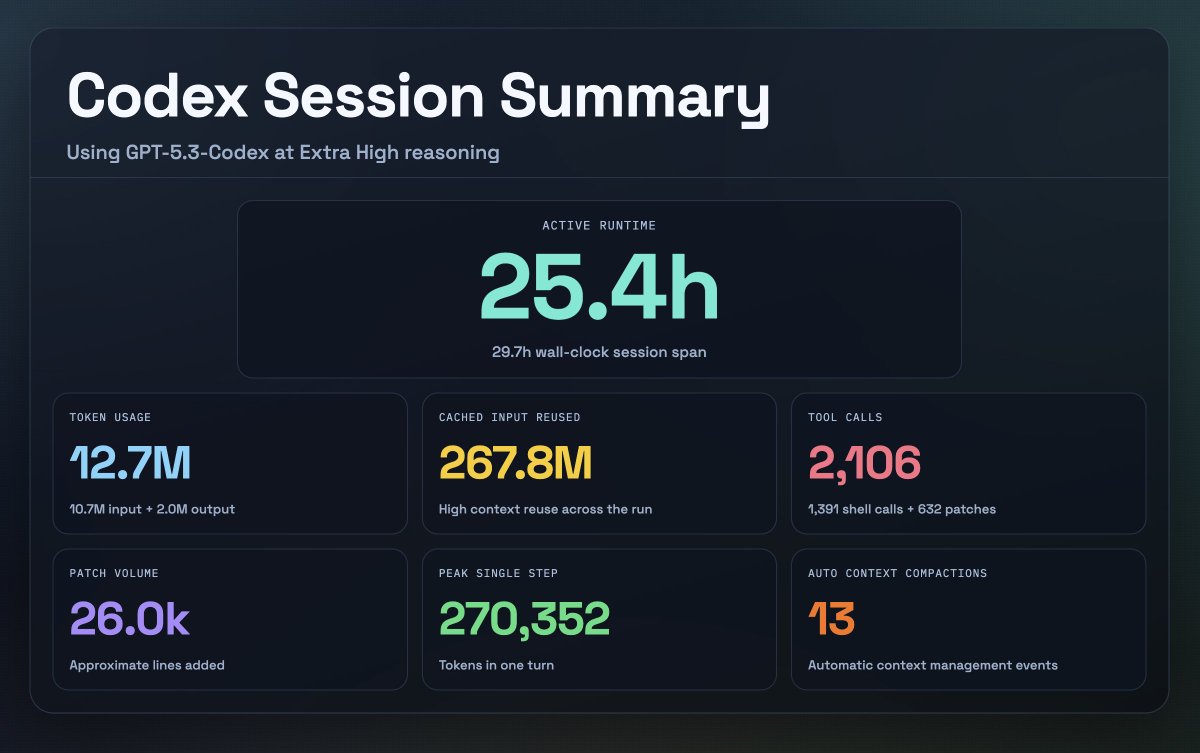
Pedi ao Codex que gerasse uma página de resumo com os dados da sessão:
E aqui estão as estatísticas da sessão na CLI e do uso de tokens:
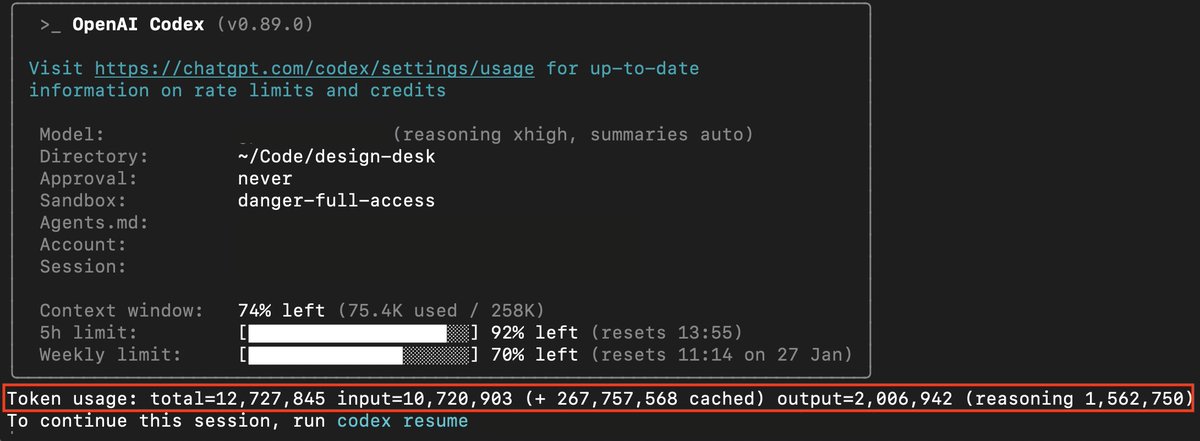
Essas capturas de tela são úteis porque tornam visível a principal mudança: a programação agêntica depende cada vez mais do horizonte temporal, não apenas da inteligência one-shot.
A verdadeira mudança está no horizonte temporal
Não se trata apenas de dizer que “os modelos ficaram mais inteligentes”. A mudança prática é que os agentes conseguem manter a coerência por mais tempo, concluir partes maiores do trabalho de ponta a ponta e se recuperar de erros sem perder o fio da meada.
O trabalho da METR com benchmarks de horizonte temporal ajuda a entender essa tendência: a duração das tarefas de software que agentes de fronteira conseguem concluir com confiabilidade de cerca de 50% e de 80% vem aumentando rapidamente, dobrando aproximadamente a cada 7 meses. Consulte Medindo a capacidade da IA de concluir tarefas longas (METR).
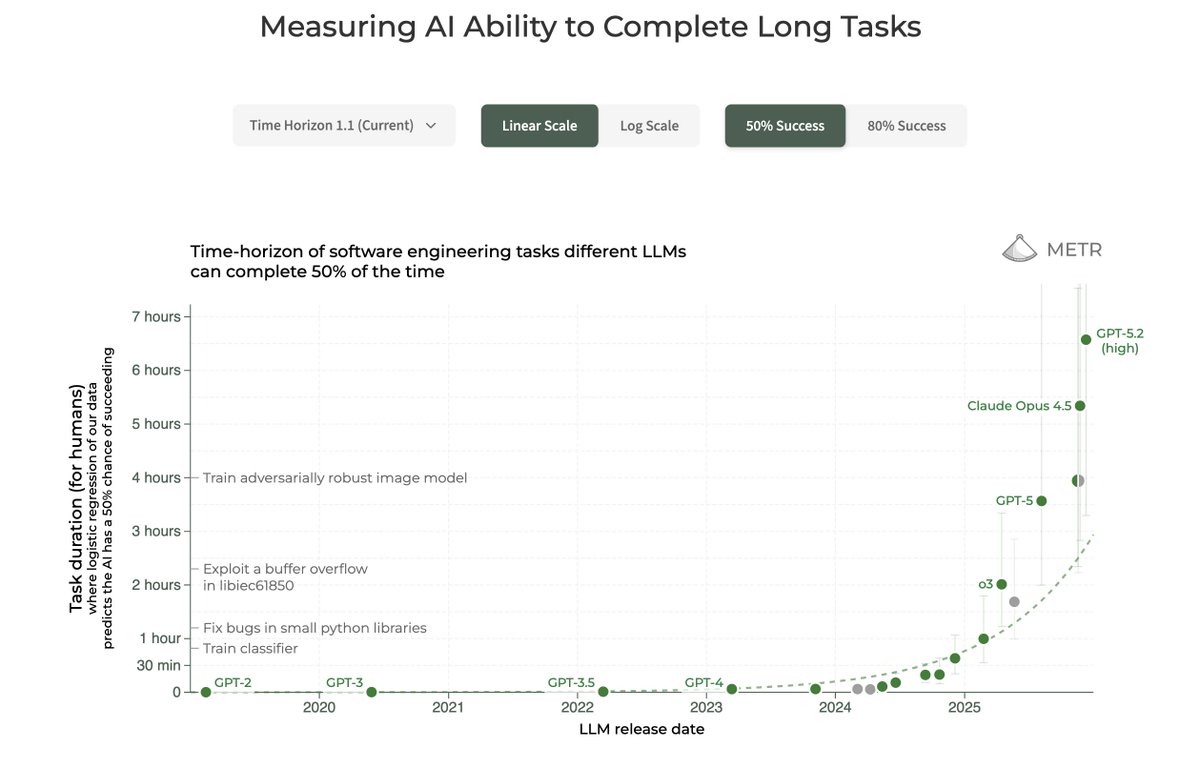
Nosso recente anúncio de lançamento do GPT-5.3-Codex mostra avanços nessa direção para o trabalho de agentes de duas formas práticas:
- Ele executa melhor tarefas com várias etapas (planejar → implementar → validar → corrigir).
- É mais fácil redirecioná-lo durante a execução sem reiniciar todo o trabalho (as correções de rumo não apagam o progresso).
Também me inspirei nos textos da equipe do Cursor sobre sistemas autônomos de programação de longa duração, incluindo seu experimento de criação de um navegador: Como a equipe do Cursor criou um navegador Web (Agentes em escala).
A equipe do Cursor escreveu que os modelos da OpenAI são “muito melhores em trabalhos autônomos prolongados: seguem instruções, mantêm o foco, evitam desvios e implementam as coisas de forma precisa e completa”.
Por que o Codex consegue manter a coerência em tarefas longas
Trabalhos de longa duração dependem menos de um único prompt enorme e mais do ciclo do agente em que o modelo opera.
No Codex, o ciclo é basicamente este:
- Planejar
- Editar código
- Executar ferramentas (testes/build/lint)
- Observar os resultados
- Corrigir falhas
- Atualizar a documentação e o status
- Repetir
Esse ciclo é importante porque oferece ao agente:
- Feedback real (erros, diffs, logs)
- Estado registrado externamente (repositório, arquivos, documentação, árvores de trabalho, saídas)
- Possibilidade de redirecionamento ao longo do tempo (você pode corrigir o rumo com base nos resultados)
Isso também explica por que os modelos Codex parecem funcionar melhor nas interfaces do Codex do que em uma janela de chat genérica: o harness fornece contexto estruturado (metadados do repositório, árvore de arquivos, diffs, saídas de comandos) e impõe uma rotina disciplinada de critérios de conclusão.
Publicamos recentemente um artigo com mais detalhes sobre o ciclo do agente do Codex.
Para completar, também lançamos o aplicativo Codex, que permite usar esse ciclo no dia a dia:
- Conversas paralelas em diferentes projetos (trabalhos longos não bloqueiam suas tarefas do dia a dia)
- Habilidades (padronizam as etapas de planejamento, implementação, teste e relato dos resultados)
- Automações (trabalho rotineiro em segundo plano)
- Árvores de trabalho do Git (isolam execuções, mantêm os diffs fáceis de revisar e reduzem o retrabalho)
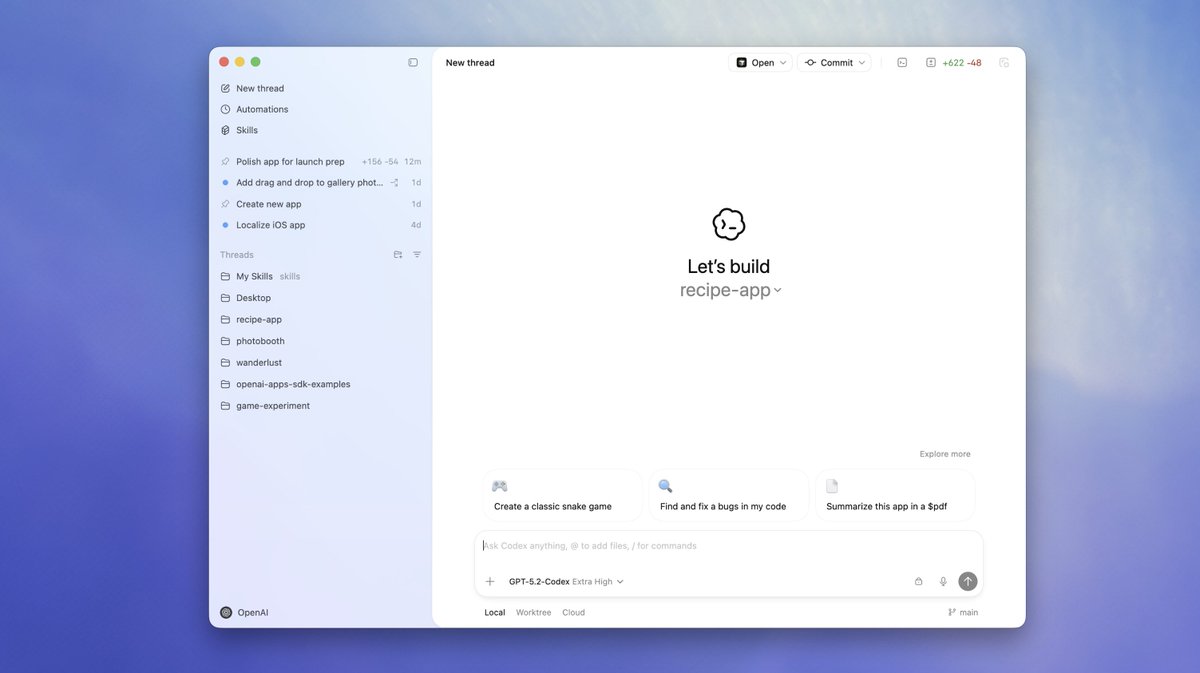
Minha configuração para o teste
Escolhi uma ferramenta de design para esse “experimento” porque é um teste que não perdoa: interface + modelo de dados + operações de edição + muitos casos extremos. Não dá para disfarçar os problemas. Se a arquitetura estiver errada, tudo quebra rapidamente.
Dei ao GPT-5.3-Codex uma especificação robusta, configurei o nível de raciocínio como “Extra alto” e ele acabou trabalhando sem interrupção por cerca de 25 horas, mantendo a coerência e entregando código de qualidade. O modelo também executou etapas de verificação (testes, lint, checagem de tipos) para cada marco concluído.
A ideia central: memória persistente do projeto
A técnica mais importante foi a memória persistente do projeto. Registrei a especificação, o plano, as restrições e o status em arquivos Markdown que o Codex podia consultar repetidamente. Isso evitou desvios e manteve uma definição estável de “concluído”.
O link para o repositório está abaixo, e o conjunto de arquivos era o seguinte:
Prompt.md (especificação + entregáveis)
Objetivo: fixar o resultado esperado para que o agente não “crie algo impressionante, mas errado”.
Principais seções do arquivo:
- Objetivos + o que está fora do escopo
- Restrições obrigatórias (desempenho, determinismo, UX, plataforma)
- Entregáveis (o que deve existir ao final)
- “Concluído quando” (verificações + fluxo de demonstração)
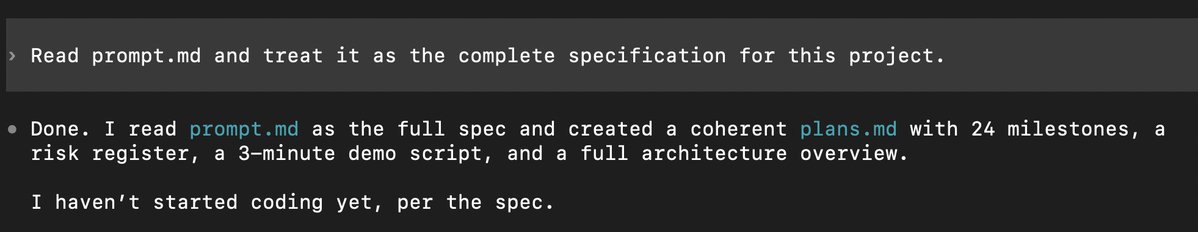
O prompt inicial instruía o Codex a tratar o arquivo de prompt/especificação como a especificação completa do projeto e gerar um plano baseado em marcos:
Plan.md (marcos + validações)
Objetivo: transformar um trabalho em aberto em uma sequência de pontos de verificação que o agente possa concluir e verificar.
Principais seções do arquivo:
- Marcos pequenos o suficiente para serem concluídos em um único ciclo
- Critérios de aceitação + comandos de validação por marco
- Regra de parar e corrigir: se a validação falhar, corrigir antes de prosseguir
- Notas sobre as decisões para evitar idas e vindas
- Arquitetura planejada para a base de código
Recentemente, adicionamos um modo planejamento nativo ao aplicativo Codex, à CLI e à extensão para IDE. Ele ajuda a dividir uma tarefa maior em uma sequência clara de etapas que você pode revisar antes de fazer alterações, permitindo alinhar a abordagem desde o início. Se precisar de mais esclarecimentos, o Codex fará perguntas adicionais. Para ativá-lo, use o comando de barra /plan.
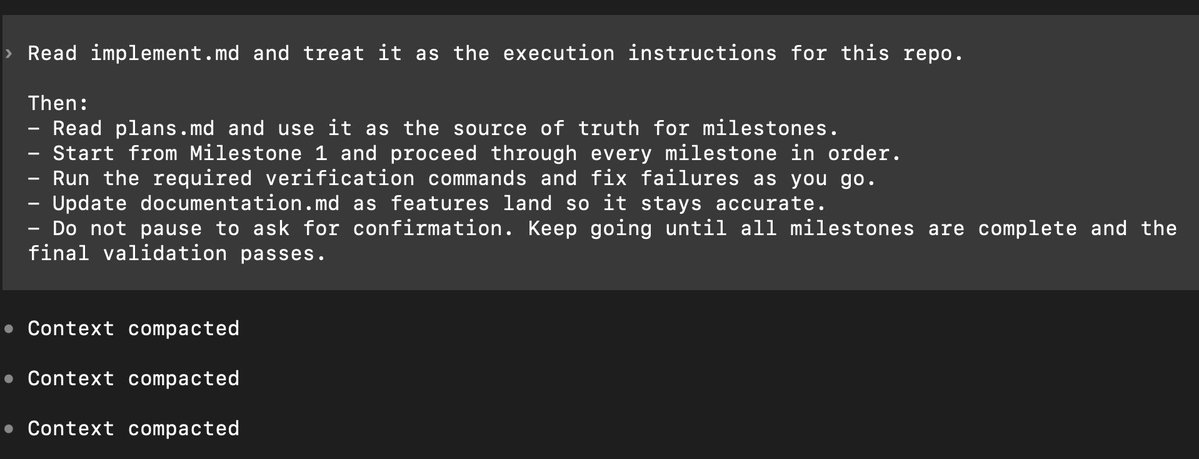
Implement.md (instruções de execução que fazem referência ao plano)
Objetivo: este é o manual de execução. Ele diz ao Codex exatamente como trabalhar: seguir o plano, manter as alterações dentro do escopo, executar validações e atualizar a documentação.
Principais seções do arquivo:
- O arquivo Markdown de planos é a referência oficial (marco a marco)
- Execute a validação após cada marco (corrija as falhas imediatamente)
- Mantenha as alterações dentro do escopo (não amplie o escopo)
- Atualize continuamente o arquivo Markdown de documentação
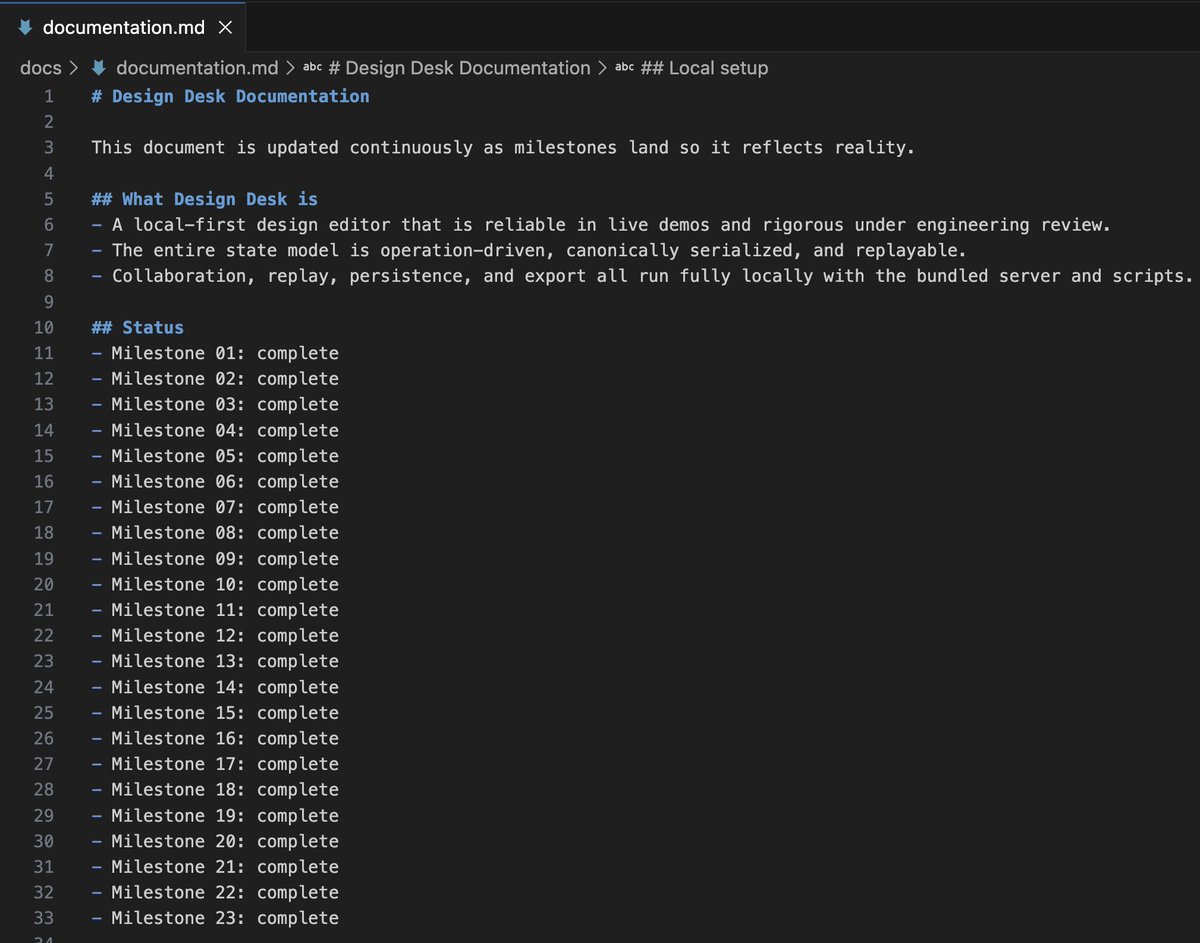
Documentation.md (status + decisões ao longo das entregas)
Objetivo: este arquivo é a memória compartilhada e o registro de auditoria. É o que me permite ficar longe por horas e ainda entender o que aconteceu.
Principais seções do arquivo:
- Status atual dos marcos (o que foi concluído, o que vem a seguir)
- Decisões tomadas (e seus motivos)
- Como executar + demonstração (comandos + testes rápidos de funcionamento básico)
- Problemas conhecidos / pendências
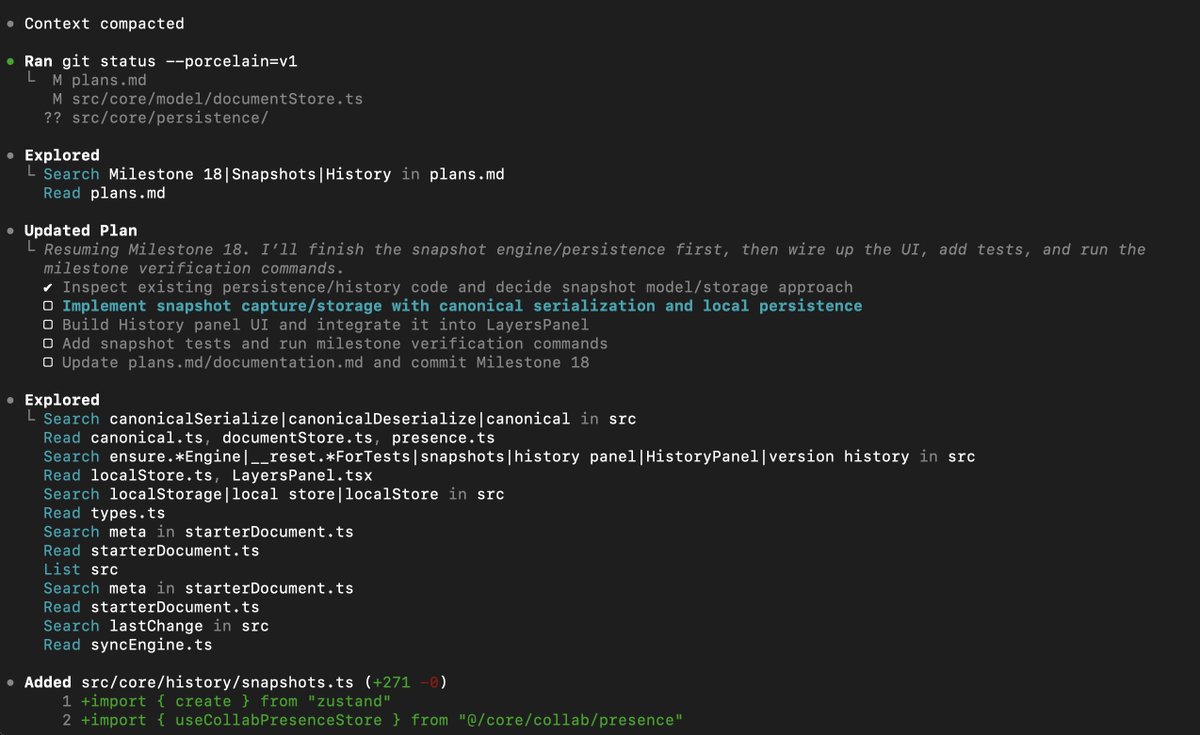
Veja como a verificação dos marcos aconteceu na prática durante a execução:
Verificação a cada marco
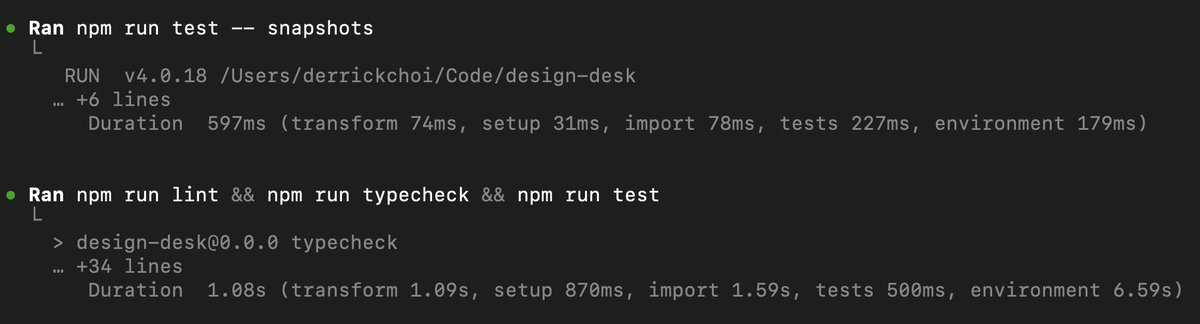
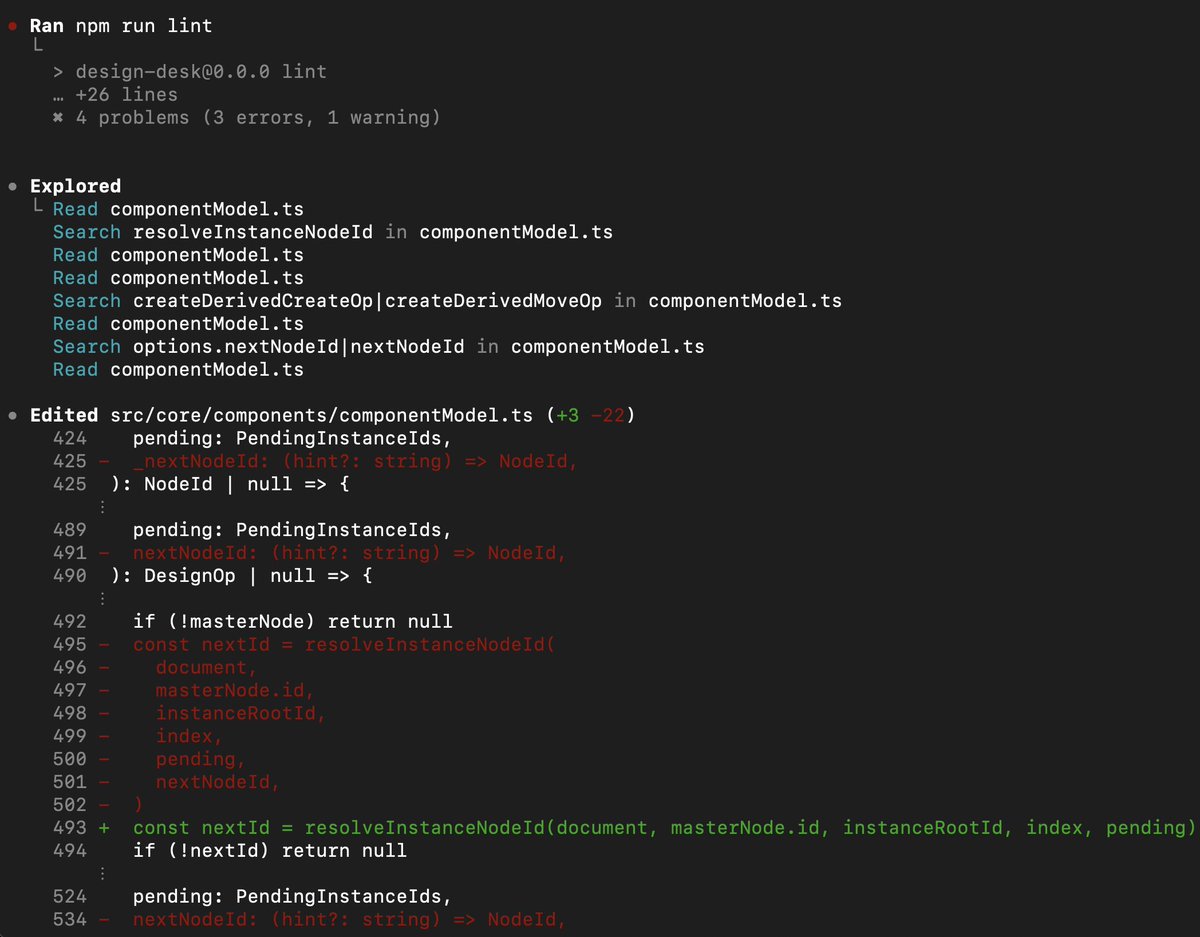
O Codex não se limitou a escrever código e torcer para que funcionasse. Após os marcos, executou comandos de verificação e corrigiu as falhas antes de continuar.
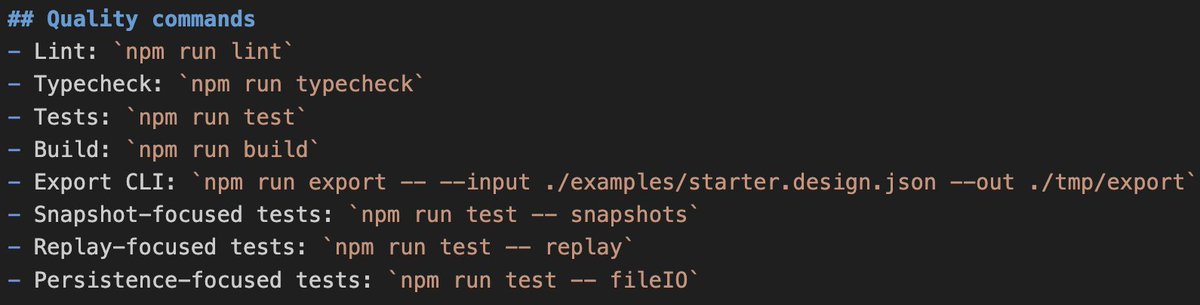
Veja exemplos dos comandos de verificação de qualidade que ele foi instruído a usar:
E um exemplo do Codex corrigindo problemas após uma falha no lint:
O que o agente construiu
O resultado não era perfeito nem estava pronto para produção, mas era real e podia ser testado. O critério para esta execução não era "compila", mas sim "segue as instruções e funciona de verdade?"
Principais capacidades implementadas:
- Edição no Canvas (quadros, grupos, formas, texto, imagens/ícones, botões, gráficos)
- Colaboração em tempo real (presença, cursores, seleções e edições sincronizados entre abas)
- Controles do inspetor (geometria, estilo, texto)
- Gerenciamento de camadas (pesquisar, renomear, bloquear/ocultar, reordenar)
- Guias/alinhamento/encaixe automático
- Instantâneos do histórico + restauração
- Linha do tempo de reprodução + criação de branch a partir de um ponto anterior
- Modo de protótipo (áreas interativas + navegação pelo fluxo)
- Comentários (conversas fixadas com opções de resolver/reabrir)
- Exportação (salvar/importar/exportar + exportação pela CLI para JSON e React + Tailwind)
Lições para tarefas de longa duração com o Codex
O que fez esta execução dar certo não foi um único prompt engenhoso. Foi a combinação de:
- Objetivo e restrições claros (arquivo de especificação)
- Marcos com pontos de verificação e critérios de aceitação (
plans.md) - Um manual de execução que define como o agente deve trabalhar (
implement.md) - Verificação contínua (testes/lint/verificação de tipos/compilação)
- Um registro de status/auditoria sempre atualizado (
documentation.md) para que fosse possível inspecionar a execução
É nessa direção que o trabalho de programação de longa duração está avançando: menos supervisão constante, mais delegação com mecanismos de proteção.
Experimente o Codex em uma tarefa sua de longa duração
Esta execução de 25 horas do Codex é uma prévia do futuro do desenvolvimento com código. Estamos indo além de prompts únicos e ciclos curtos de programação em dupla, rumo a colegas de equipe que trabalham por longos períodos e conseguem assumir uma parte concreta do trabalho de ponta a ponta, com você orientando o rumo a cada marco em vez de microgerenciar cada linha.
Nosso rumo com o Codex é simples: atuar cada vez mais como um colega de equipe, integrar-se melhor ao seu contexto real e oferecer mecanismos de proteção que mantenham o trabalho confiável, fácil de revisar e de entregar. Já vemos desenvolvedores avançando mais rápido quando o agente assume a implementação e a verificação rotineiras, liberando as pessoas para o que mais importa: design, arquitetura, decisões de produto e problemas novos que não têm uma solução pronta.
E isso não vai se limitar aos desenvolvedores. À medida que o Codex melhora ainda mais sua capacidade de captar a intenção e oferecer uma estrutura segura (planos, validações, prévias, reversões), mais pessoas que não são desenvolvedoras poderão criar e iterar sem passar o dia em uma IDE. Há mais novidades a caminho nas interfaces e nos modelos do Codex, mas o objetivo continua o mesmo: fazer o agente parecer menos uma ferramenta que exige supervisão constante e mais um colega de equipe em quem você pode confiar para trabalhos de longa duração.
Se quiser experimentar, comece por: