
Agora que o GPT-5 foi lançado, queremos explicar melhor a melhor forma de integrá-lo, a Responses API, e por que Responses foi feita sob medida para modelos de raciocínio e o futuro agêntico.
Todas as gerações de APIs da OpenAI foram criadas em torno da mesma pergunta: qual é a maneira mais simples e poderosa de os desenvolvedores interagirem com os modelos?
O design das nossas APIs sempre foi orientado pelo funcionamento dos próprios modelos. O primeiro endpoint, /v1/completions, era simples, mas limitante: você fornecia um prompt ao modelo, e ele simplesmente completava seu pensamento. Com técnicas como prompts few-shot, os desenvolvedores podiam tentar orientar o modelo a realizar tarefas como gerar JSON e responder a perguntas, mas esses modelos eram muito menos capazes do que os que estamos acostumados a usar hoje.
Depois vieram o RLHF, o ChatGPT e a era do pós-treinamento. De repente, os modelos não estavam apenas completando seus textos inacabados: eles estavam respondendo como parceiros de conversa. Para acompanhar essa mudança, criamos /v1/chat/completions (em um único fim de semana, como ficou conhecido). Ao disponibilizar papéis como system, user e assistant, fornecemos uma estrutura para criar rapidamente interfaces de chat com instruções personalizadas e contexto.
Nossos modelos continuaram melhorando. Logo, começaram a ver, ouvir e falar. A chamada de função, no fim de 2023, acabou se tornando um dos nossos recursos mais queridos. Na mesma época, lançamos a API Assistants em versão beta: nossa primeira tentativa de criar uma interface totalmente agêntica, com ferramentas hospedadas como Code Interpreter e pesquisa de arquivos. Alguns desenvolvedores gostaram, mas ela nunca alcançou ampla adoção devido ao design da API, que era limitante e difícil de adotar em comparação com Chat Completions.
No fim de 2024, ficou claro que precisávamos unificar tudo: algo tão acessível quanto Chat Completions e tão poderoso quanto Assistants, mas também desenvolvido especificamente para modelos multimodais e de raciocínio. Foi aí que surgiu /v1/responses.
/v1/responses é um ciclo agêntico
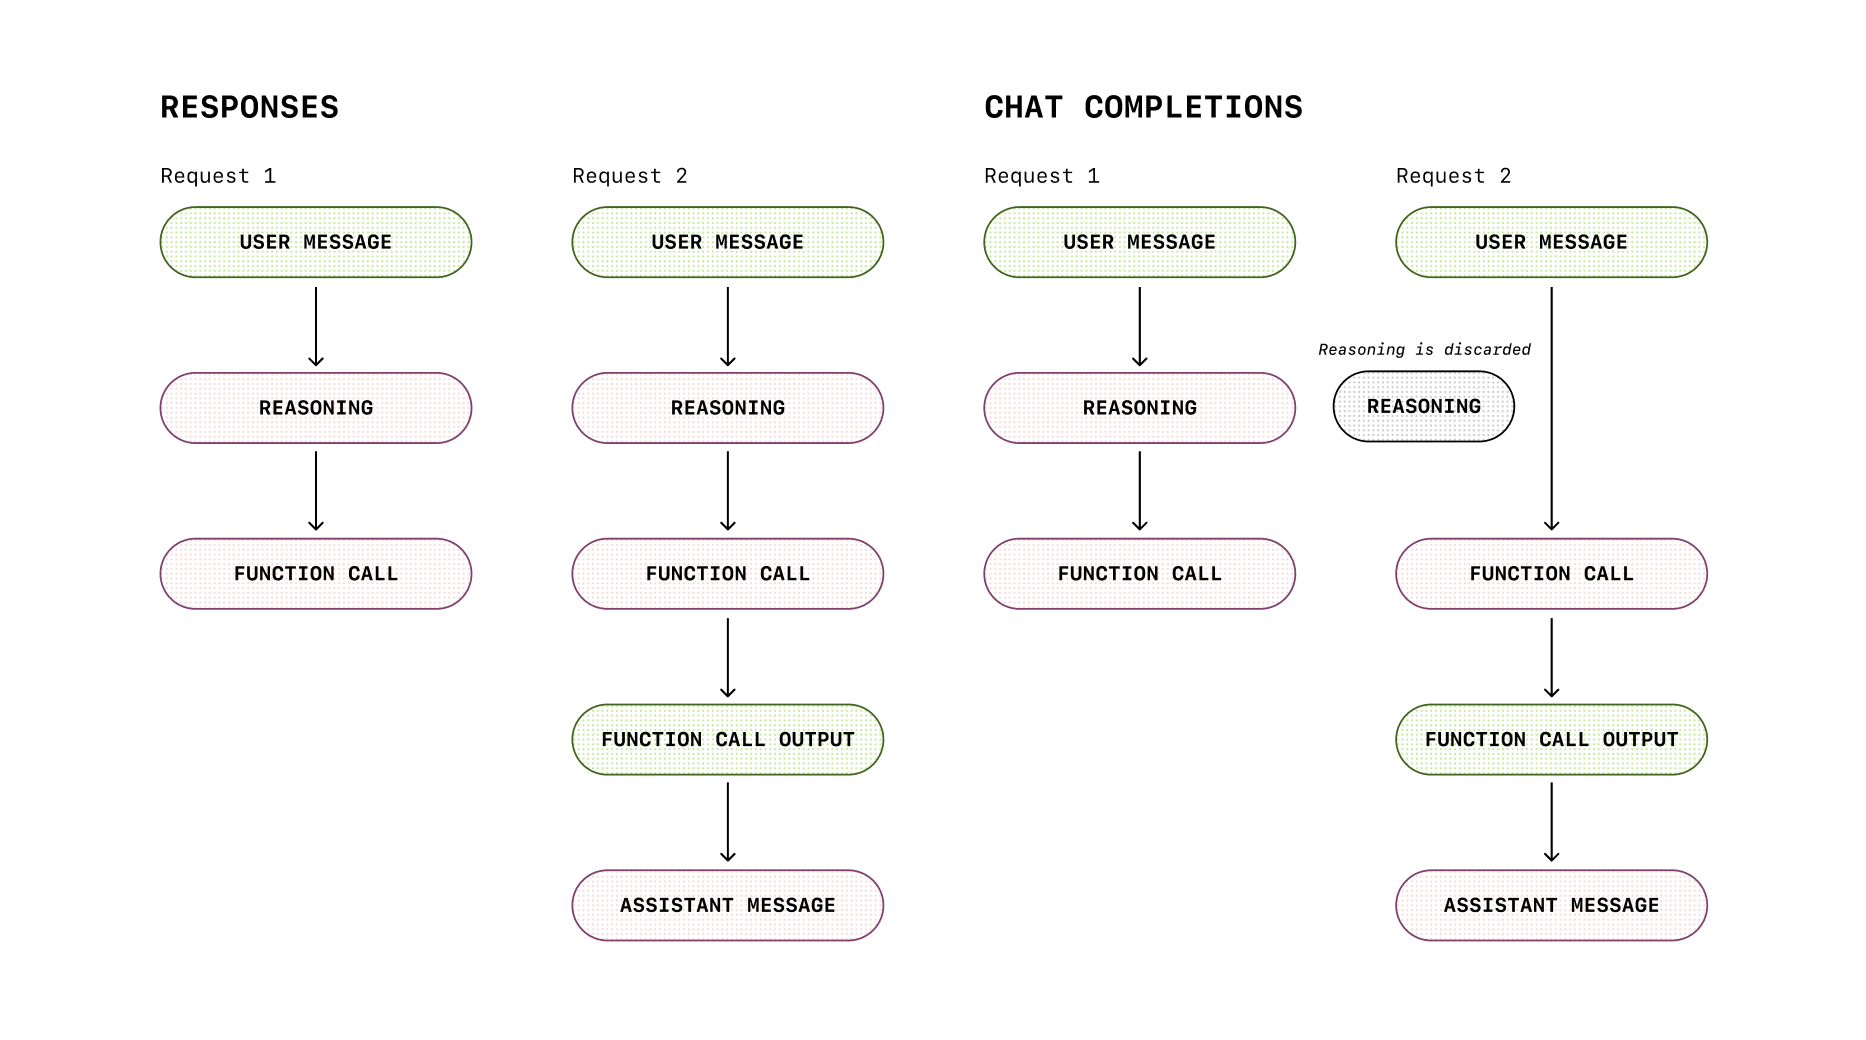
Chat Completions oferecia uma interface de chat simples, baseada em turnos. Responses oferece um ciclo estruturado para raciocinar e agir. Pense nisso como trabalhar com um detetive: você fornece evidências, ele investiga, pode consultar especialistas (ferramentas) e, por fim, apresenta os resultados. O detetive mantém suas anotações privadas (estado de raciocínio) entre as etapas, mas nunca as entrega ao cliente.
É aqui que os modelos de raciocínio realmente se destacam: Responses preserva o estado de raciocínio do modelo entre esses turnos. Em Chat Completions, o raciocínio é descartado entre as chamadas, como se o detetive esquecesse as pistas toda vez que saísse da sala. Responses mantém o caderno aberto; os processos de pensamento passo a passo são de fato preservados para o turno seguinte. Isso se reflete nos benchmarks (TAUBench +5%), no uso mais eficiente do cache e na redução da latência.
Responses também pode emitir vários itens de saída: não apenas o que o modelo disse, mas o que ele fez. Você recebe registros: chamadas de ferramentas, saídas estruturadas e etapas intermediárias. É como receber tanto o texto final quanto os cálculos do rascunho. Isso é útil para depurar, auditar e criar interfaces mais completas.
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},Subindo o nível de abstração com ferramentas hospedadas
Nos primeiros tempos da chamada de função, percebemos um padrão importante: os desenvolvedores usavam o modelo tanto para invocar APIs quanto para pesquisar em repositórios de documentos e incorporar fontes de dados externas, uma prática hoje conhecida como RAG. Mas, para quem está começando a desenvolver, criar um pipeline de recuperação do zero é uma tarefa difícil e cara. Com Assistants, introduzimos nossas primeiras ferramentas hospedadas : file_search e code_interpreter, permitindo que o modelo usasse RAG e escrevesse código para resolver os problemas que você apresentava. Em Responses, fomos ainda mais longe, adicionando pesquisa na Web, geração de imagens e MCP. E, como a execução das ferramentas acontece no servidor, por meio de ferramentas hospedadas como Code Interpreter ou MCP, você não precisa encaminhar cada chamada de volta ao seu próprio backend, garantindo menor latência e menores custos de comunicação de ida e volta.
Preservando o raciocínio com segurança
Então, por que ter todo esse trabalho para ocultar a cadeia de pensamento (CoT) bruta do modelo? Não seria mais fácil simplesmente expor a CoT e deixar os clientes tratá-la como as outras saídas do modelo? A resposta curta é que expor a CoT bruta traz vários riscos, como alucinações, conteúdo prejudicial que não seria gerado em uma resposta final e, para a OpenAI, riscos competitivos.
Quando lançamos o o1-preview no fim do ano passado, nosso cientista-chefe, Jakub Pachocki, escreveu isto no nosso blog:
Acreditamos que uma cadeia de pensamento oculta oferece uma oportunidade única para monitorar modelos. Desde que seja fiel e legível, a cadeia de pensamento oculta nos permite "ler a mente" do modelo e entender seu processo de pensamento. Por exemplo, no futuro, talvez queiramos monitorar a cadeia de pensamento em busca de sinais de manipulação do usuário. No entanto, para que isso funcione, o modelo precisa ter liberdade para expressar seus pensamentos sem alterações. Por isso, não podemos treinar a cadeia de pensamento para seguir políticas ou preferências dos usuários. Também não queremos tornar uma cadeia de pensamento desalinhada diretamente visível aos usuários.
Responses lida com isso das seguintes formas:
- Preservando o raciocínio internamente, criptografado e oculto para o cliente.
- Permitindo a continuação segura por meio de
previous_response_idou de itens de raciocínio, sem expor a CoT bruta.
Por que /v1/responses é a melhor maneira de desenvolver
Projetamos Responses para preservar estado, ser multimodal e eficiente.
- Uso agêntico de ferramentas: A Responses API facilita aprimorar fluxos de trabalho agênticos com ferramentas como Pesquisa de arquivos, Geração de imagens, Code Interpreter e MCP.
- Preservação de estado por padrão. As conversas e o estado das ferramentas são acompanhados automaticamente. Isso facilita muito o raciocínio e os fluxos de trabalho com vários turnos. O GPT-5 integrado via Responses obtém uma pontuação 5% melhor no TAUBench em comparação com Chat Completions, apenas por aproveitar o raciocínio preservado.
- Multimodal desde a concepção. Texto, imagens, áudio e chamadas de função: todos têm suporte de primeira classe. Não adaptamos uma API de texto para incluir outras modalidades; projetamos a casa com quartos suficientes desde o primeiro dia.
- Custos menores, desempenho melhor. Benchmarks internos mostram um aproveitamento do cache 40–80% melhor em comparação com Chat Completions. Isso significa menor latência e menores custos.
- Design melhor: Aprendemos muito com as APIs Chat Completions e Assistants e fizemos uma série de pequenas melhorias na ResponsesAPI e no SDK para facilitar o dia a dia, incluindo
- Eventos semânticos de streaming.
- Polimorfismo com tags internas.
- Recursos auxiliares
output_textno SDK (sem precisar mais dechoices.[0].message.content). - Melhor organização dos parâmetros multimodais e de raciocínio.
E quanto a Chat Completions?
Chat Completions não vai desaparecer. Se funciona para você, continue usando. Mas, se você quer raciocínio persistente, interações multimodais que pareçam nativas e um ciclo agêntico que não dependa de gambiarras, Responses é o caminho a seguir.
Olhando para o futuro
Assim como Chat Completions substituiu Completions, esperamos que Responses se torne a maneira padrão de os desenvolvedores criarem com os modelos da OpenAI. Ela é simples quando você precisa de simplicidade, poderosa quando você quer mais recursos e flexível o suficiente para lidar com o que o próximo paradigma trouxer.
Esta é a API que servirá de base para o que vamos desenvolver nos próximos anos.