Saiba como os modelos de raciocínio funcionam e como usá-los bem.
Responses
Os modelos de raciocínio usam tokens internos de raciocínio antes de produzir uma resposta. Isso ajuda o modelo a planejar, usar ferramentas com eficácia, examinar alternativas, contornar ambiguidades e resolver tarefas mais difíceis com várias etapas. Os modelos de raciocínio funcionam especialmente bem na resolução de problemas complexos, na programação, no raciocínio científico e em fluxos de trabalho agênticos com várias etapas. Também são os melhores modelos para o Codex CLI, nosso agente leve de programação.
Comece com gpt-6-astra para a maioria das cargas de trabalho de raciocínio. Para reduzir o custo, considere gpt-5.6-terra, ou gpt-5.6-luna para obter o menor custo e a menor latência. Se estiver usando um modelo GPT-5.6, consulte modo de raciocínio para saber mais sobre a opção pro.
Os modelos de raciocínio funcionam melhor com a Responses
API. Embora a API Chat Completions
ainda tenha suporte, você terá mais inteligência e melhor desempenho do modelo ao
usar a Responses.
Primeiros passos com raciocínio
Chame a Responses API e especifique o modelo e o esforço de raciocínio:
Como usar um modelo de raciocínio na Responses API
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "low" }, input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "low"},input=[{"role": "user", "content": prompt}],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortLow, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input(prompt) .reasoning(Reasoning.builder().effort(ReasoningEffort.LOW).build()) .build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """;CreateResponseOptions options = new(){ Model = "gpt-6-astra", ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Low, },};options.InputItems.Add(ResponseItem.CreateUserMessageItem(prompt));ResponseResult response = await client.CreateResponseAsync(options);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", reasoning: { effort: :low }, input: prompt)puts(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [
      {
        "role": "user",
        "content": "Write a bash script that takes a matrix represented as a string with format \"[1,2],[3,4],[5,6]\" and prints the transpose in the same format."
      }
    ]
  }'
Esforço de raciocínio
O parâmetro reasoning.effort orienta o modelo sobre quanto pensar ao executar uma tarefa.
Os valores aceitos dependem do modelo e podem incluir none, minimal, low, medium, high, xhigh e max. Um esforço menor favorece a velocidade e reduz o uso de tokens, enquanto um esforço maior faz o modelo pensar de forma mais completa para fornecer respostas de maior qualidade. Os modelos também adaptam o raciocínio em todos os níveis de esforço, usando menos tokens em tarefas mais simples e raciocinando mais em tarefas complexas.
O GPT-6 Astra não aceita o esforço de raciocínio
none. Definir reasoning.effort (Responses) ou reasoning_effort (Chat
Completions) como none retorna HTTP 400.
Use a Responses API para chamada
de função. Chat Completions não oferece suporte à chamada de função com o GPT-6 Astra.
Os valores padrão também dependem do modelo e não são universais. O gpt-5.5 usa o esforço de raciocínio medium por padrão. Esse é o melhor ponto de partida para aproveitar o equilíbrio entre qualidade, confiabilidade e desempenho do gpt-5.5.
Esforço
Ideal para
none
Tarefas em que a latência é crítica e que não se beneficiam de raciocínio nem de várias chamadas de ferramentas encadeadas. Para casos de uso sensíveis à latência com gpt-5.5, recomendamos começar testando low e depois mudar para none, se necessário.
Casos de uso comuns incluem voz, recuperação rápida de informações e classificação.
low
Raciocínio eficiente com um pequeno aumento na latência. Ideal para casos de uso que exigem uso de ferramentas, planejamento, pesquisa ou tomada de decisões em várias etapas, com foco em otimizar a velocidade e o custo.
Casos de uso comuns incluem análise de dados, elaboração de rascunhos, programação voltada à execução e fluxos de trabalho de suporte ao cliente ou de assistentes de chat.
medium
Quando qualidade e confiabilidade são importantes e a tarefa envolve planejamento, raciocínio complexo e discernimento. É a configuração padrão para a maioria das cargas de trabalho e um ponto de equilíbrio na curva de Pareto entre latência, desempenho e custo.
Casos de uso comuns incluem programação agêntica, pesquisa, trabalho com planilhas e slides e delegação de trabalhos de longa duração.
high
Tarefas de raciocínio exigentes, depuração complexa, planejamento aprofundado e tarefas de alto valor em que qualidade e inteligência são mais importantes que a latência. Recomendado para fluxos de trabalho complexos e tarefas agênticas.
Casos de uso comuns incluem programação agêntica, pesquisa de longa duração e trabalho intelectual. Dependendo da complexidade da tarefa, avalie tanto medium quanto high.
xhigh
Pesquisa aprofundada, fluxos de trabalho assíncronos e tarefas agênticas que exigem execuções longas. Use somente quando suas avaliações demonstrarem um benefício claro que justifique a latência e o custo adicionais.
Casos de uso comuns incluem revisões de segurança e de código, produtividade empresarial, tarefas de pesquisa mais aprofundada e fluxos de trabalho de programação desafiadores.
max
Raciocínio máximo para suas tarefas mais complexas. Se você usa xhigh atualmente, avalie se max oferece melhor desempenho
Para reduzir o tempo até o primeiro token visível em aplicativos sensíveis à latência, peça ao modelo que gere uma breve introdução antes de prosseguir com um raciocínio mais aprofundado.
Alguns modelos aceitam apenas parte desses valores. Por isso, consulte a página do modelo correspondente antes de escolher uma configuração.
Modo de raciocínio
Os modelos GPT-5.6 oferecem os modos de raciocínio standard e pro na Responses API. O padrão é standard. Defina reasoning.mode como pro para tarefas difíceis que exigem mais processamento do modelo e toleram maior latência e uso de tokens.
O modo de raciocínio e o esforço de raciocínio são independentes. O modo seleciona a execução padrão ou pro, enquanto reasoning.effort controla quanto raciocínio o modelo aplica nesse modo. Se você omitir reasoning.effort, o GPT-5.6 usará medium por padrão nos dois modos.
O modo Pro contabiliza todo o processamento realizado pelo modelo para produzir a resposta final e cobra esses tokens de acordo com as tarifas de tokens padrão do modelo selecionado. O modo Pro realiza mais processamento que o modo padrão, aumentando o uso de tokens e o custo. Os IDs de modelos Pro existentes mantêm o comportamento e os preços atuais.
Como o raciocínio funciona
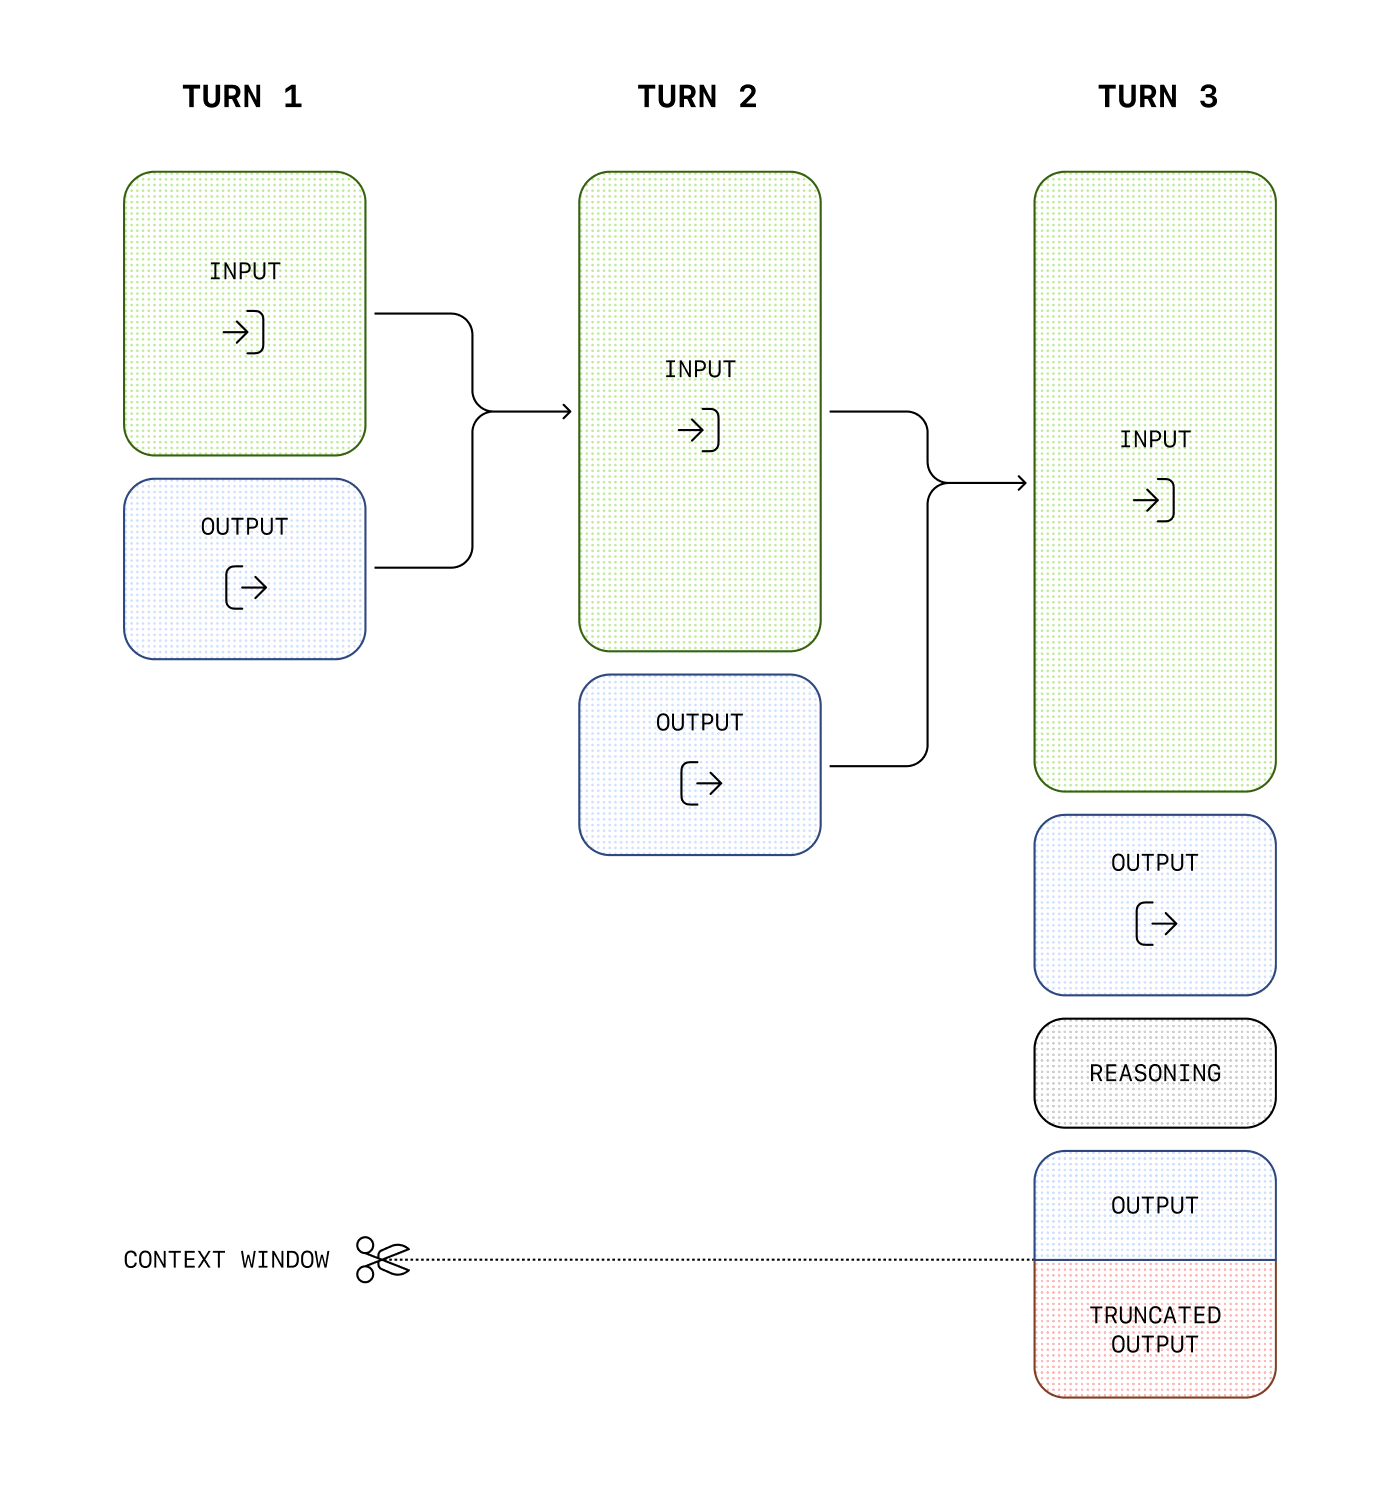
Os modelos de raciocínio introduzem tokens de raciocínio , além dos tokens de entrada e saída. Os modelos usam esses tokens de raciocínio para "pensar", decompondo o prompt e considerando várias abordagens para gerar uma resposta. Nossos modelos de raciocínio, como gpt-5.5 e gpt-5.4, oferecem suporte ao raciocínio intercalado: o modelo pode gerar tokens de saída visíveis antes e entre etapas de raciocínio, além de pensar entre chamadas de ferramentas.
Nos modelos lançados antes do GPT-5.6, o comportamento padrão em uma conversa com várias etapas é manter os tokens de entrada e saída de cada etapa, sem incorporar o raciocínio dos turnos anteriores à próxima amostra. Já os modelos GPT-5.6 incorporam, por padrão, o raciocínio disponível dos turnos anteriores. Use reasoning.context para selecionar um desses comportamentos nos modelos compatíveis.
Embora os tokens de raciocínio não sejam visíveis pela API, eles ainda ocupam espaço na
janela de contexto do modelo e são cobrados como tokens de
saída.
Controle de custos
Para gerenciar os custos com modelos de raciocínio, você pode limitar o número total de tokens que o
modelo gera, incluindo tokens de raciocínio, tokens de saída visíveis e tokens de formatação
não visíveis, usando o parâmetro
max_output_tokens.
Consulte contagens de tokens de saída para saber como os tokens gerados são contabilizados no uso e nos limites de saída.
Gerenciamento da janela de contexto
É importante garantir que haja espaço suficiente na janela de contexto para os tokens de raciocínio ao criar respostas. Dependendo da complexidade do problema, os modelos podem gerar de algumas centenas a dezenas de milhares de tokens de raciocínio. O número exato de tokens de raciocínio usados fica visível no objeto de uso do objeto de resposta, em output_tokens_details:
Os tamanhos das janelas de contexto estão disponíveis na página de referência dos modelos e variam entre as versões específicas dos modelos.
Reserva de espaço para raciocínio
Se os tokens gerados atingirem o limite da janela de contexto ou o valor de max_output_tokens que você definiu, você receberá uma resposta com status definido como incomplete e incomplete_details com reason definido como max_output_tokens. Isso pode ocorrer antes que qualquer token de saída visível seja produzido, o que significa que você pode ter custos com tokens de entrada e de raciocínio sem receber uma resposta visível.
Para evitar isso, garanta que haja espaço suficiente na janela de contexto ou aumente o valor de max_output_tokens. A OpenAI recomenda reservar pelo menos 25.000 tokens para raciocínio e saídas quando você começar a experimentar esses modelos. Conforme conhecer melhor a quantidade de tokens de raciocínio que seus prompts exigem, você poderá ajustar essa reserva.
Como lidar com respostas incompletas
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "medium" }, input: [ { role: "user", content: prompt, }, ], max_output_tokens: 300,});if ( response.status === "incomplete" && response.incomplete_details.reason === "max_output_tokens") { console.log("Ran out of tokens"); if (response.output_text?.length > 0) { console.log("Partial output:", response.output_text); } else { console.log("Ran out of tokens during reasoning"); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "medium"},input=[{"role": "user", "content": prompt}],max_output_tokens=300,)if ( response.status =="incomplete"and response.incomplete_details.reason =="max_output_tokens"):print("Ran out of tokens")if response.output_text:print("Partial output:", response.output_text)else:print("Ran out of tokens during reasoning")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", MaxOutputTokens: openai.Int(300), Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortMedium, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } if response.Status == responses.ResponseStatusIncomplete { fmt.Println("Ran out of tokens") if text := response.OutputText(); text != "" { fmt.Println("Partial output:", text) } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.Response;import com.openai.models.responses.ResponseCreateParams;import com.openai.models.responses.ResponseStatus;ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input( "Write a bash script that takes a matrix represented as a string with format " + "'[1,2],[3,4],[5,6]' and prints the transpose in the same format.") .maxOutputTokens(300) .reasoning(Reasoning.builder().effort(ReasoningEffort.MEDIUM).build()) .build();var response = client.responses().create(params);if (response.status().filter(ResponseStatus.INCOMPLETE::equals).isPresent() && response .incompleteDetails() .flatMap(Response.IncompleteDetails::reason) .filter(Response.IncompleteDetails.Reason.MAX_OUTPUT_TOKENS::equals) .isPresent()) { System.out.println("Ran out of tokens"); response.output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println("Partial output: " + text.text()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new(){ Model = "gpt-6-astra", MaxOutputTokenCount = 300, ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Medium, },};options.InputItems.Add( ResponseItem.CreateUserMessageItem("Write a bash script that transposes a matrix."));ResponseResult response = await client.CreateResponseAsync(options);if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.MaxOutputTokens){ Console.WriteLine("The response ended before all output tokens were generated."); string partialOutput = response.GetOutputText(); Console.WriteLine( string.IsNullOrWhiteSpace(partialOutput) ? "Ran out of tokens during reasoning." : $"Partial output: {partialOutput}" );}else if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.ContentFilter){ Console.WriteLine("The response was interrupted by the content filter.");}else if (response.Status == ResponseStatus.Completed){ Console.WriteLine(response.GetOutputText());}else{ throw new InvalidOperationException($"The response ended with status: {response.Status}");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", max_output_tokens: 300, reasoning: { effort: :medium }, input: prompt)if response.status == OpenAI::Responses::ResponseStatus::INCOMPLETE puts("Ran out of tokens") puts("Partial output: #{response.output_text}") unless response.output_text.empty?end
Preserve o raciocínio entre chamadas
O estado da conversa e o estado de raciocínio têm finalidades diferentes. Passar mensagens entre chamadas fornece ao modelo o histórico visível da conversa. Nos modelos compatíveis, o raciocínio persistido também permite que o modelo incorpore itens de raciocínio compatíveis de turnos anteriores ao próximo contexto.
O raciocínio persistido oferece continuidade, mas não expõe o raciocínio bruto do modelo. Os itens de raciocínio permanecem opacos, e a API não retorna o texto de raciocínio desses itens. Defina reasoning.context para controlar quais itens de raciocínio disponíveis o modelo pode usar:
A família de modelos GPT-5.6
oferece suporte a
all_turns e usa esse valor por padrão. Os modelos anteriores usam
current_turn por padrão. Omita reasoning.context ou defina-o como
auto para usar o padrão do modelo selecionado.
Valor
Comportamento
auto
Usa o padrão do modelo selecionado. Omitir reasoning.context tem o mesmo efeito que usar auto.
current_turn
Disponibiliza o raciocínio do turno ativo, mas não incorpora o raciocínio dos turnos anteriores à próxima amostra.
all_turns
Incorpora à próxima amostra os itens de raciocínio disponíveis e compatíveis dos turnos anteriores. Os modelos GPT-5.6 aceitam esse valor.
O campo reasoning.context da resposta contém o modo efetivamente usado: current_turn ou all_turns. Verifique esse campo em cada resposta para confirmar qual modo o modelo usou. Essa configuração não cria itens de raciocínio que ainda não estejam disponíveis.
all_turns só tem efeito quando a solicitação tem acesso aos itens de respostas anteriores. Use previous_response_id, associe a resposta a uma conversa ou reenvie manualmente o histórico completo de respostas. Na primeira solicitação, current_turn e all_turns se comportam da mesma forma, pois não há raciocínio anterior.
O raciocínio persistido só pode ser reutilizado dentro da mesma família de modelos. Por exemplo, gpt-5.6-sol, gpt-5.6-terra e gpt-5.6-luna podem reutilizar o raciocínio uns dos outros, mas o raciocínio não é transferido entre as famílias GPT-5.6 e GPT-5.5.
Quando você muda de família de modelos, a API omite o raciocínio incompatível do contexto do modelo, mesmo quando reasoning.context está definido como all_turns.
Continue o raciocínio com respostas armazenadas
Use previous_response_id para a integração com estado mais enxuta:
Preserve o raciocínio com uma resposta anterior
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import OpenAI from "openai";const client = new OpenAI();const first = await client.responses.create({ model: "gpt-5.6", input: "Inspect this repository and identify the likely bug.", reasoning: { context: "current_turn" },});const second = await client.responses.create({ model: "gpt-5.6", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAIclient = OpenAI()model ="gpt-5.6"first = client.responses.create(model=model,input="Inspect this repository and identify the likely bug.",reasoning={"context": "current_turn"},)second = client.responses.create(model=model,previous_response_id=first.id,input="Now patch the bug and explain the change.",reasoning={"context": "all_turns"},)print(second.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-5.6", input: "Inspect this repository and identify the likely bug.", reasoning: { context: :current_turn })second = client.responses.create( model: "gpt-5.6", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: :all_turns })puts(second.output_text)
Use current_turn ao reenviar itens de respostas anteriores de que o modelo não precisa mais. Esses itens de raciocínio podem permanecer no payload da API para manter a continuidade, mas o serviço não os inclui na nova amostra. Isso pode reduzir o contexto incluído em fluxos de trabalho de longa duração.
Preserve o raciocínio sem respostas armazenadas
Quando você cria uma resposta no modo sem estado, os itens de raciocínio no array output da resposta incluem a propriedade encrypted_content por padrão. O modo sem estado se aplica quando store é false ou quando sua organização usa zero retenção de dados (ZDR). A API ainda aceita o valor legado reasoning.encrypted_content em include por compatibilidade, mas não o exige.
A solicitação a seguir retorna conteúdo de raciocínio criptografado sem especificar include:
1
2
3
4
5
6
7
8
9
10curlhttps://api.openai.com/v1/responses\-H"Content-Type: application/json"\-H"Authorization: Bearer $OPENAI_API_KEY"\-d'{ "model": "gpt-6-astra", "store": false, "reasoning": {"effort": "medium"}, "input": "What is the weather like today?", "tools": [ ... function config here ... ] }'
Os itens de raciocínio no array output incluirão a propriedade encrypted_content com tokens de raciocínio criptografados que você pode passar para chamadas futuras.
Para usar all_turns com store: false, preserve todos os itens de saída, acrescente a próxima mensagem do usuário e reenvie o histórico completo:
Preserve o raciocínio sem armazenar respostas
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const client = new OpenAI();const history = [ { role: "user", content: "Inspect this repository and identify the likely bug.", },];const first = await client.responses.create({ model: "gpt-5.6", store: false, input: history, reasoning: { context: "current_turn" },});// Keep replayable output, including encrypted reasoning and assistant phase.history.push(...toResponseInputItems(first.output));history.push({ role: "user", content: "Now patch the bug and explain the change.",});const second = await client.responses.create({ model: "gpt-5.6", store: false, input: history, reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()model ="gpt-5.6"history = [ {"role": "user","content": "Inspect this repository and identify the likely bug.", }]first = client.responses.create(model=model,store=False,input=history,reasoning={"context": "current_turn"},)# Keep every output item, including encrypted reasoning and assistant phase.history.extend(item.model_dump() for item in first.output)history.append( {"role": "user","content": "Now patch the bug and explain the change.", })second = client.responses.create(model=model,store=False,input=history,reasoning={"context": "all_turns"},)print(second.output_text)
Ao usar chamada de função com um modelo de raciocínio na Responses API, recomendamos fortemente que você reenvie todos os itens de raciocínio retornados com a última chamada de função (além da saída da sua função). Se o modelo chamar várias funções consecutivamente, reenvie todos os itens de raciocínio, de chamada de função e de saída de chamada de função desde a última mensagem user. Isso permite que o modelo continue seu processo de raciocínio para produzir resultados melhores com o uso mais eficiente possível de tokens.
A maneira mais simples de fazer isso é passar todos os itens de raciocínio de uma resposta anterior para a próxima. Nossos sistemas ignoram de forma inteligente os itens de raciocínio que não são relevantes para suas funções e mantêm no contexto apenas os relevantes. Você pode passar itens de raciocínio de respostas anteriores usando o parâmetro previous_response_id ou passando manualmente todos os itens de saída de uma resposta anterior para a entrada de uma nova resposta.
Em casos de uso avançados, nos quais você pode truncar e otimizar partes da janela de contexto antes de passá-las para a próxima resposta, basta garantir que todos os itens entre a última mensagem do usuário e a saída da chamada de função sejam passados para a próxima resposta sem alterações. Isso garante que o modelo tenha todo o contexto de que precisa.
Consulte este guia para saber mais sobre o gerenciamento manual de contexto.
Altere o raciocínio durante a conversa
Use configuration_update para aumentar o esforço de raciocínio em tarefas difíceis ou reduzi-lo em interações rotineiras na sequência. Adicione a atualização entre as respostas, mantendo reasoning.effort inalterado no nível da solicitação. Isso preserva o prefixo original do prompt para o cache de prompts.
Somente o GPT-6 Astra (gpt-6-astra) oferece suporte a atualizações de configuração no
modo padrão, com um único agente. Elas alteram apenas o esforço de raciocínio.
Adicione o item a seguir antes da próxima mensagem do usuário no array input de uma solicitação HTTP à Responses API ou de uma solicitação response.create via WebSocket:
Por exemplo, se a conversa começar com o esforço low no nível da solicitação, essa atualização selecionará high para a próxima resposta e as seguintes, até que outra atualização substitua esse valor.
Aumente o esforço de raciocínio para uma interação subsequente
Preserve as atualizações com previous_response_id ou reenvie-as nas posições originais ao gerenciar o histórico da conversa manualmente. O campo reasoning.effort da resposta continua informando a configuração no nível da solicitação, e não o esforço selecionado pela atualização.
Não coloque dois itens configuration_update diretamente um após o outro no histórico da conversa; a API rejeita atualizações adjacentes.
Não combine atualizações de configuração com compactação automática ou truncamento automático. O endpoint independente /responses/compact também rejeita históricos que contenham essas atualizações.
Você ainda pode compactar o histórico explicitamente incluindo um item compaction_trigger em uma solicitação /responses. Após a compactação, adicione um novo item configuration_update com o esforço desejado antes da próxima mensagem do usuário.
Os requisitos normais de cache de prompts continuam válidos. Para enviar instruções do usuário enquanto uma resposta está sendo gerada, use Orientação durante o turno.
Resumos de raciocínio
Embora não exponhamos os tokens de raciocínio brutos emitidos pelo modelo, você pode visualizar um resumo do raciocínio do modelo usando o parâmetro summary. Consulte nossa documentação de modelos para verificar quais modelos de raciocínio oferecem suporte a resumos.
Cada modelo oferece suporte a diferentes configurações de resumo de raciocínio. Por exemplo, nosso modelo de uso do computador oferece suporte ao gerador de resumos concise, enquanto o o4-mini oferece suporte a detailed. Para acessar o gerador de resumos mais detalhado disponível para um modelo, defina o valor desse parâmetro como auto. Atualmente, auto equivale a detailed para a maioria dos modelos de raciocínio, mas configurações mais granulares podem estar disponíveis no futuro.
A saída do resumo de raciocínio faz parte do array summary no item de saídareasoning. Essa saída só será incluída se você optar explicitamente por incluir resumos de raciocínio.
O exemplo abaixo mostra como fazer uma solicitação à API que inclua um resumo de raciocínio.
Inclua um resumo de raciocínio na resposta da API
Python
1
2
3
4
5
6
7
8
9
10
11
12
13import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "What is the capital of France?", reasoning: { effort: "low", summary: "auto", },});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="What is the capital of France?",reasoning={"effort": "low", "summary": "auto"},)print(response.output)
Essa solicitação à API retornará um array de saída com uma mensagem do assistente e um resumo do raciocínio do modelo ao gerar essa resposta.
1234567891011121314151617181920212223242526[ { "id": "rs_6876cf02e0bc8192b74af0fb64b715ff06fa2fcced15a5ac", "type": "reasoning", "summary": [ { "type": "summary_text", "text": "**Answering a simple question**\n\nI\u2019m looking at a straightforward question: the capital of France is Paris. It\u2019s a well-known fact, and I want to keep it brief and to the point. Paris is known for its history, art, and culture, so it might be nice to add just a hint of that charm. But mostly, I\u2019ll aim to focus on delivering a clear and direct answer, ensuring the user gets what they\u2019re looking for without any extra fluff." } ] }, { "id": "msg_6876cf054f58819284ecc1058131305506fa2fcced15a5ac", "type": "message", "status": "completed", "content": [ { "type": "output_text", "annotations": [], "logprobs": [], "text": "The capital of France is Paris." } ], "role": "assistant" }]
Para fluxos de longa duração ou com uso intenso de ferramentas com GPT-5.5 e GPT-5.4 na Responses API, use o campo phase da mensagem do assistente para evitar encerramentos prematuros e outros comportamentos inadequados.
phase é opcional no nível da API, mas a OpenAI recomenda seu uso. Use phase: "commentary" para atualizações intermediárias do assistente, como preâmbulos antes de chamadas de ferramentas, e phase: "final_answer" para a resposta concluída. Não adicione phase às mensagens do usuário.
Usar previous_response_id geralmente é o caminho mais simples, pois preserva o estado anterior do assistente. Se você reenviar o histórico do assistente manualmente, preserve cada valor original de phase.
A ausência ou remoção de phase pode fazer com que preâmbulos sejam tratados como respostas finais nesses fluxos de trabalho. Para orientações de criação de prompts específicas do modelo, consulte Criação de prompts para GPT-5.5.
Reenvie os valores de phase do assistente
Reenvie os valores de phase do assistente
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: [ { role: "assistant", phase: "commentary", content: "I’ll inspect the logs and then summarize root cause and remediation.", }, { role: "assistant", phase: "final_answer", content: "Root cause: cache invalidation race.", }, { role: "user", content: "Great—now give me a rollout-safe fix plan.", }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input=[ {"role": "assistant","phase": "commentary","content": "I’ll inspect the logs and then summarize root cause and remediation.", }, {"role": "assistant","phase": "final_answer","content": "Root cause: cache invalidation race.", }, {"role": "user","content": "Great—now give me a rollout-safe fix plan.", }, ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25require "openai"client = OpenAI::Client.newresponse = client.responses.create( model: "gpt-6-astra", input: [ { role: :assistant, phase: :commentary, content: "I'll inspect the logs and then summarize root cause and remediation." }, { role: :assistant, phase: :final_answer, content: "Root cause: cache invalidation race." }, { role: :user, content: "Great—now give me a rollout-safe fix plan." } ])puts(response.output_text)
Orientações para criação de prompts
Considere estas diferenças ao criar prompts para um modelo de raciocínio. Os modelos GPT-5 com capacidade de raciocínio geralmente funcionam melhor quando você fornece um objetivo claro, restrições bem definidas e um contrato explícito de saída, sem prescrever cada etapa intermediária.
Forneça ao modelo a tarefa, as restrições e o formato de saída desejado.
Trate reasoning.effort como um parâmetro de ajuste, e não como a principal forma de recuperar a qualidade.
Para fluxos de trabalho agênticos ou com muita pesquisa, defina os critérios de conclusão e como o modelo deve verificar seu trabalho.
Para saber mais sobre as práticas recomendadas ao usar modelos de raciocínio, consulte este guia.
Exemplos de prompts
Programação (refatoração)
Os modelos da série o da OpenAI são capazes de implementar algoritmos complexos e produzir código. Este prompt pede ao o1 que refatore um componente React com base em alguns critérios específicos.
Refatorar código
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Refatorar código
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Programação (planejamento)
Os modelos da série o da OpenAI também são capazes de criar planos com várias etapas. Este exemplo de prompt pede ao o1 que crie uma estrutura de sistema de arquivos para uma solução completa, junto com código Python que implemente o caso de uso desejado.
Planeje e crie um projeto Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ChatCompletion completion = await client.CompleteChatAsync( new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Planeje e crie um projeto Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ResponseResult response = await client.CreateResponseAsync("gpt-6-astra", prompt);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Pesquisa em STEM
Os modelos da série o da OpenAI têm demonstrado excelente desempenho em pesquisas em STEM. Prompts que pedem apoio em tarefas de pesquisa básica devem produzir bons resultados.
Faça perguntas relacionadas à pesquisa científica básica
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.chat.completions.create( model="gpt-6-astra", messages=[{"role": "user", "content": prompt}])print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Faça perguntas relacionadas à pesquisa científica básica
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.responses.create( model="gpt-6-astra", input=[{"role": "user", "content": prompt}])print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Exemplos de casos de uso
Você encontra alguns exemplos de uso de modelos de raciocínio em casos reais no cookbook.