
AI 音频能力为用户体验开辟了令人振奋的新天地。今年早些时候,我们发布了包括 gpt-realtime 在内的多款新音频模型,以及新的 API 功能,帮助开发者打造这些体验。
上周,我们发布了新的音频模型快照,旨在解决构建可靠音频智能体时的一些常见挑战。这些快照提升了生产环境中各类语音工作流的可靠性和质量,涵盖转录、文本转语音,以及原生支持实时语音到语音交互的智能体。
本次更新包括:
gpt-4o-mini-transcribe-2025-12-15:通过转录或 Realtime API 实现语音转文本gpt-4o-mini-tts-2025-12-15:通过 Speech API 实现文本转语音gpt-realtime-mini-2025-12-15:通过 Realtime API 实现原生实时语音到语音交互gpt-audio-mini-2025-12-15:通过 Chat Completions API 实现原生语音到语音交互
这些新快照在以下几个方面都有改进:
音频输入方面:
- 处理真实场景和含噪音频时,词错误率更低
- 在静音或存在背景噪声时,幻觉更少
音频输出方面:
- 语音输出更自然、更稳定,使用自定义语音时也同样如此
定价与之前的模型快照保持一致,因此我们建议您切换到这些新快照,以相同的价格获得更好的性能。
如果您正在构建语音智能体、客户支持系统或具有品牌特色的语音体验,这些更新将帮助您提高生产部署的可靠性。下面,我们将详细介绍更新内容,以及这些改进在实际语音工作流中的表现。
语音到语音
我们正在部署新的 Realtime mini 和 Audio mini 模型,它们经过优化,工具调用和指令遵循能力得到了提升。这些模型缩小了 mini 模型与完整规模模型之间的智能差距,让部分应用可以通过切换到 mini 模型来优化成本。
gpt-realtime-mini-2025-12-15
gpt-realtime-mini 模型专为配合 Realtime API 使用而设计,这是我们用于实现低延迟原生多模态交互的 API。该模型支持流式音频输入和输出、处理中断(可选用语音活动检测),以及在继续说话的同时在后台进行函数调用等功能。
新的 Realtime mini 快照在指令遵循和工具调用方面有明显提升,更适合实时智能体。在内部语音到语音评估中,与上一个快照相比,其指令遵循准确率提高了 18.6 个百分点,工具调用准确率提高了 12.9 个百分点,在 Big Bench Audio 基准测试中的表现也有所改善。
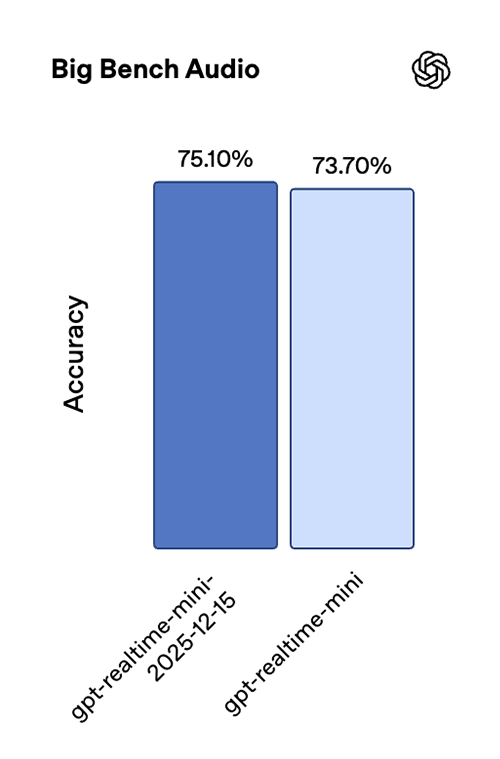
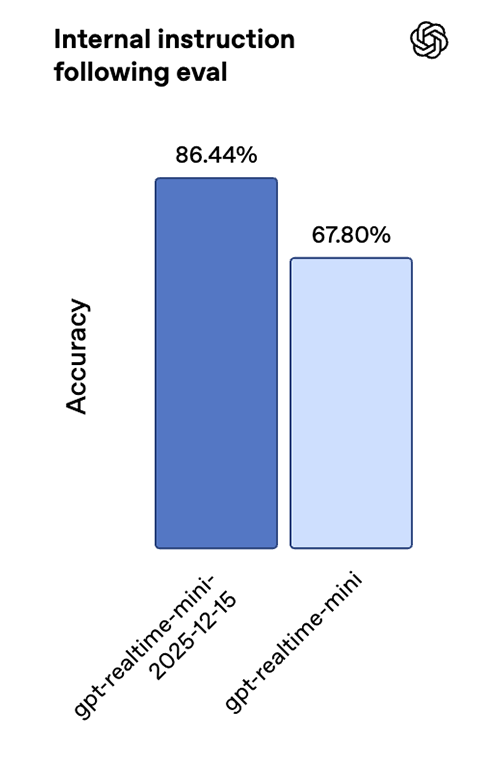
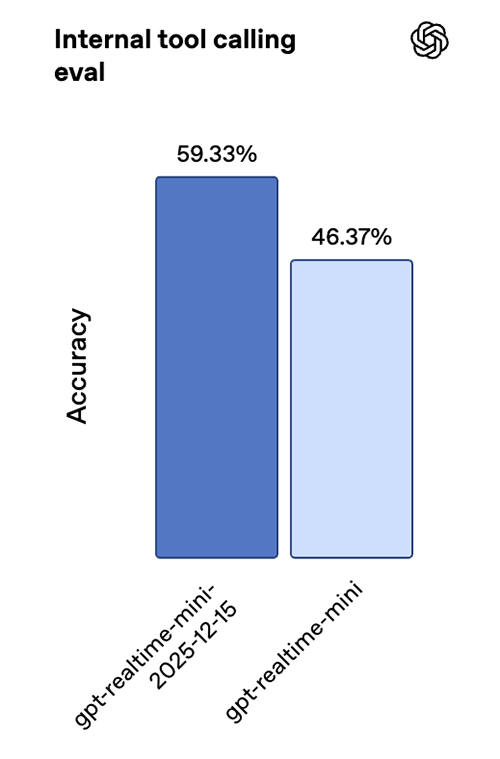
这些改进共同提升了实时、低延迟环境中多步骤交互的可靠性和函数执行的一致性。
对于值得为智能体准确性投入更高成本的场景,gpt-realtime 仍然是我们表现最好的模型。而当成本和延迟最为重要时,gpt-realtime-mini 是一个很好的选择,在实际场景中表现出色。
例如,Genspark 在双语翻译和智能意图路由场景中对它进行了压力测试。他们发现,除了语音质量有所提升之外,模型的响应也几乎是即时的,而且在快速交流过程中始终能准确识别意图。
gpt-audio-mini-2025-12-15
gpt-audio-mini 模型可与 Chat Completions API 配合使用,适用于不要求实时交互的语音到语音使用场景。
这两个新快照还升级了解码器,让声音听起来更自然,并在使用自定义语音时更好地保持声音的一致性。
文本转语音
我们最新的文本转语音模型 gpt-4o-mini-tts-2025-12-15 在准确性方面有显著提升,相比上一代模型,在各项标准语音基准测试中的词错误率都大幅降低。在 Common Voice 和 FLEURS 上,词错误率(WER)降低了约 35%,在 Multilingual LibriSpeech 上也有类似的提升。
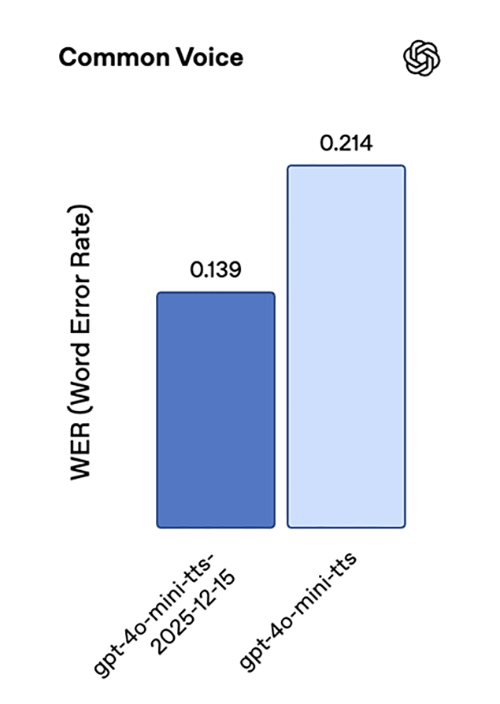
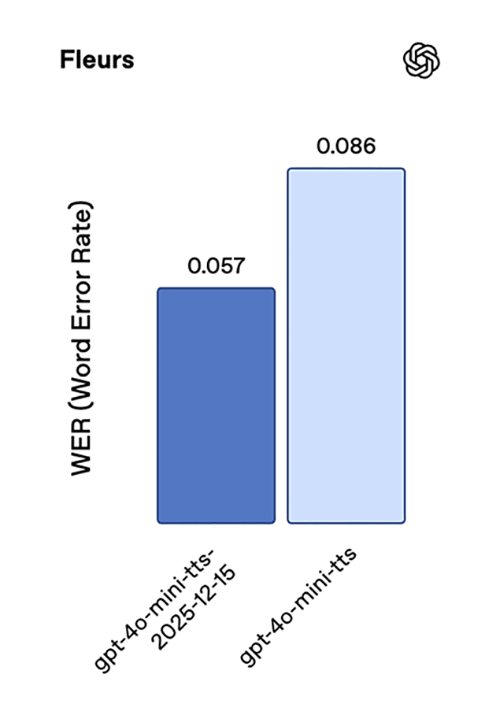
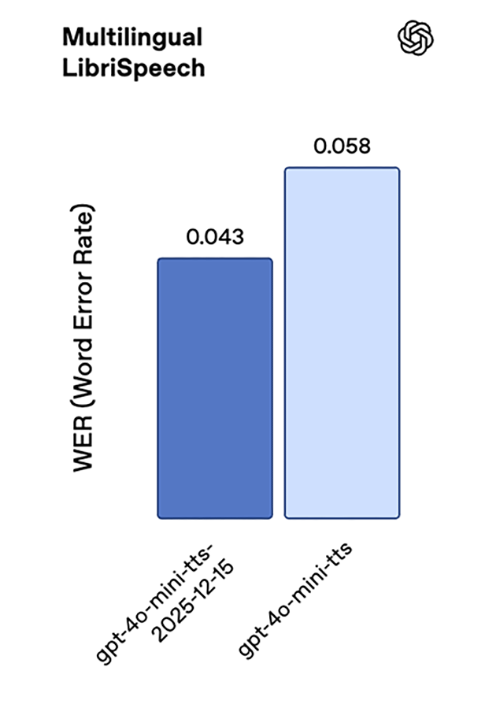
综合来看,这些结果表明,模型在多种语言中的发音准确性和稳健性均有所提升。
与新的 gpt-realtime-mini 快照类似,该模型的声音自然度大幅提升,使用自定义语音时的表现也更好。
语音转文本
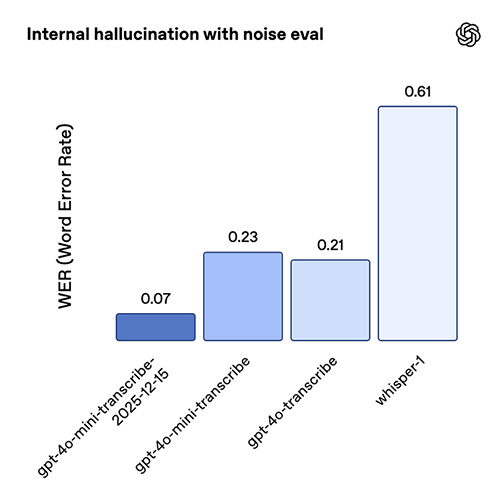
最新的转录模型 gpt-4o-mini-transcribe-2025-12-15 在准确性和可靠性方面均有显著提升。在 Common Voice 和 FLEURS 等标准 ASR 基准测试中(不提供语言提示),它的词错误率低于之前的模型。我们针对真实对话场景优化了该模型的表现,例如用户的简短话语和嘈杂背景。在一项内部 噪声环境下的幻觉 评估中,我们播放了真实场景的背景噪声片段,以及说话间隔不一的音频(包括静音)。与 Whisper v2 相比,该模型产生的幻觉减少了约 90%;与之前的 GPT-4o-transcribe 模型相比,减少了约 70%。
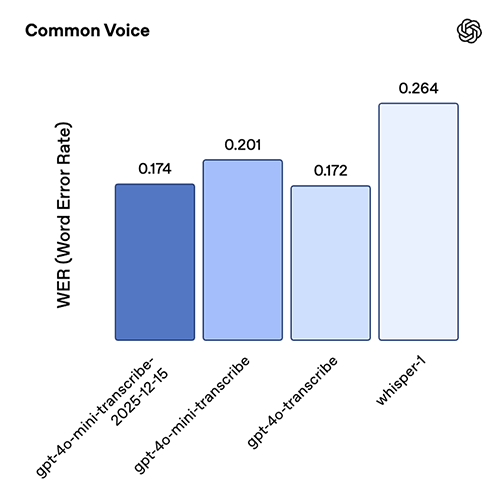
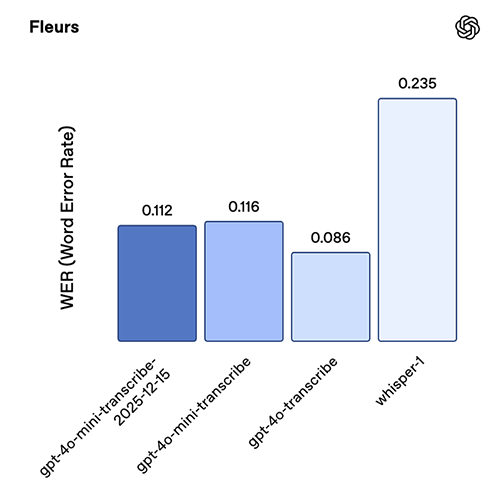
该模型快照在中文(普通话)、印地语、孟加拉语、日语、印度尼西亚语和意大利语方面表现尤为出色。
自定义语音
自定义语音让组织能够以独特的品牌声音与客户交流。无论您是在构建客户支持智能体还是品牌虚拟形象,OpenAI 的自定义语音技术都能让您轻松创建独特、逼真的声音。
这些新的语音到语音和文本转语音模型为自定义语音带来了多项改进,包括更自然的语调、更忠实于原始样本的声音,以及在不同方言中更高的准确性。
为确保安全使用这项技术,自定义语音仅向符合条件的客户开放。请联系您的客户总监或联系我们的销售团队以了解更多信息。
从原型到生产环境
语音应用往往在相似的场景下出错,主要包括长对话、静音等边缘情况,以及要求语音智能体精确执行的工具驱动流程。本次更新着重解决这些问题:降低错误率、减少幻觉、提高工具使用的一致性,并更好地遵循指令。此外,我们还提升了输出音频的稳定性,让您的语音体验听起来更自然。
如果您目前正在推出语音体验,我们建议您切换到新的 2025-12-15 快照,并重新运行关键的生产环境测试用例。
早期测试者已确认,无需更改指令,仅切换到新快照就能获得明显改善。不过,我们仍建议您针对自己的使用场景进行试验,并根据需要调整提示。