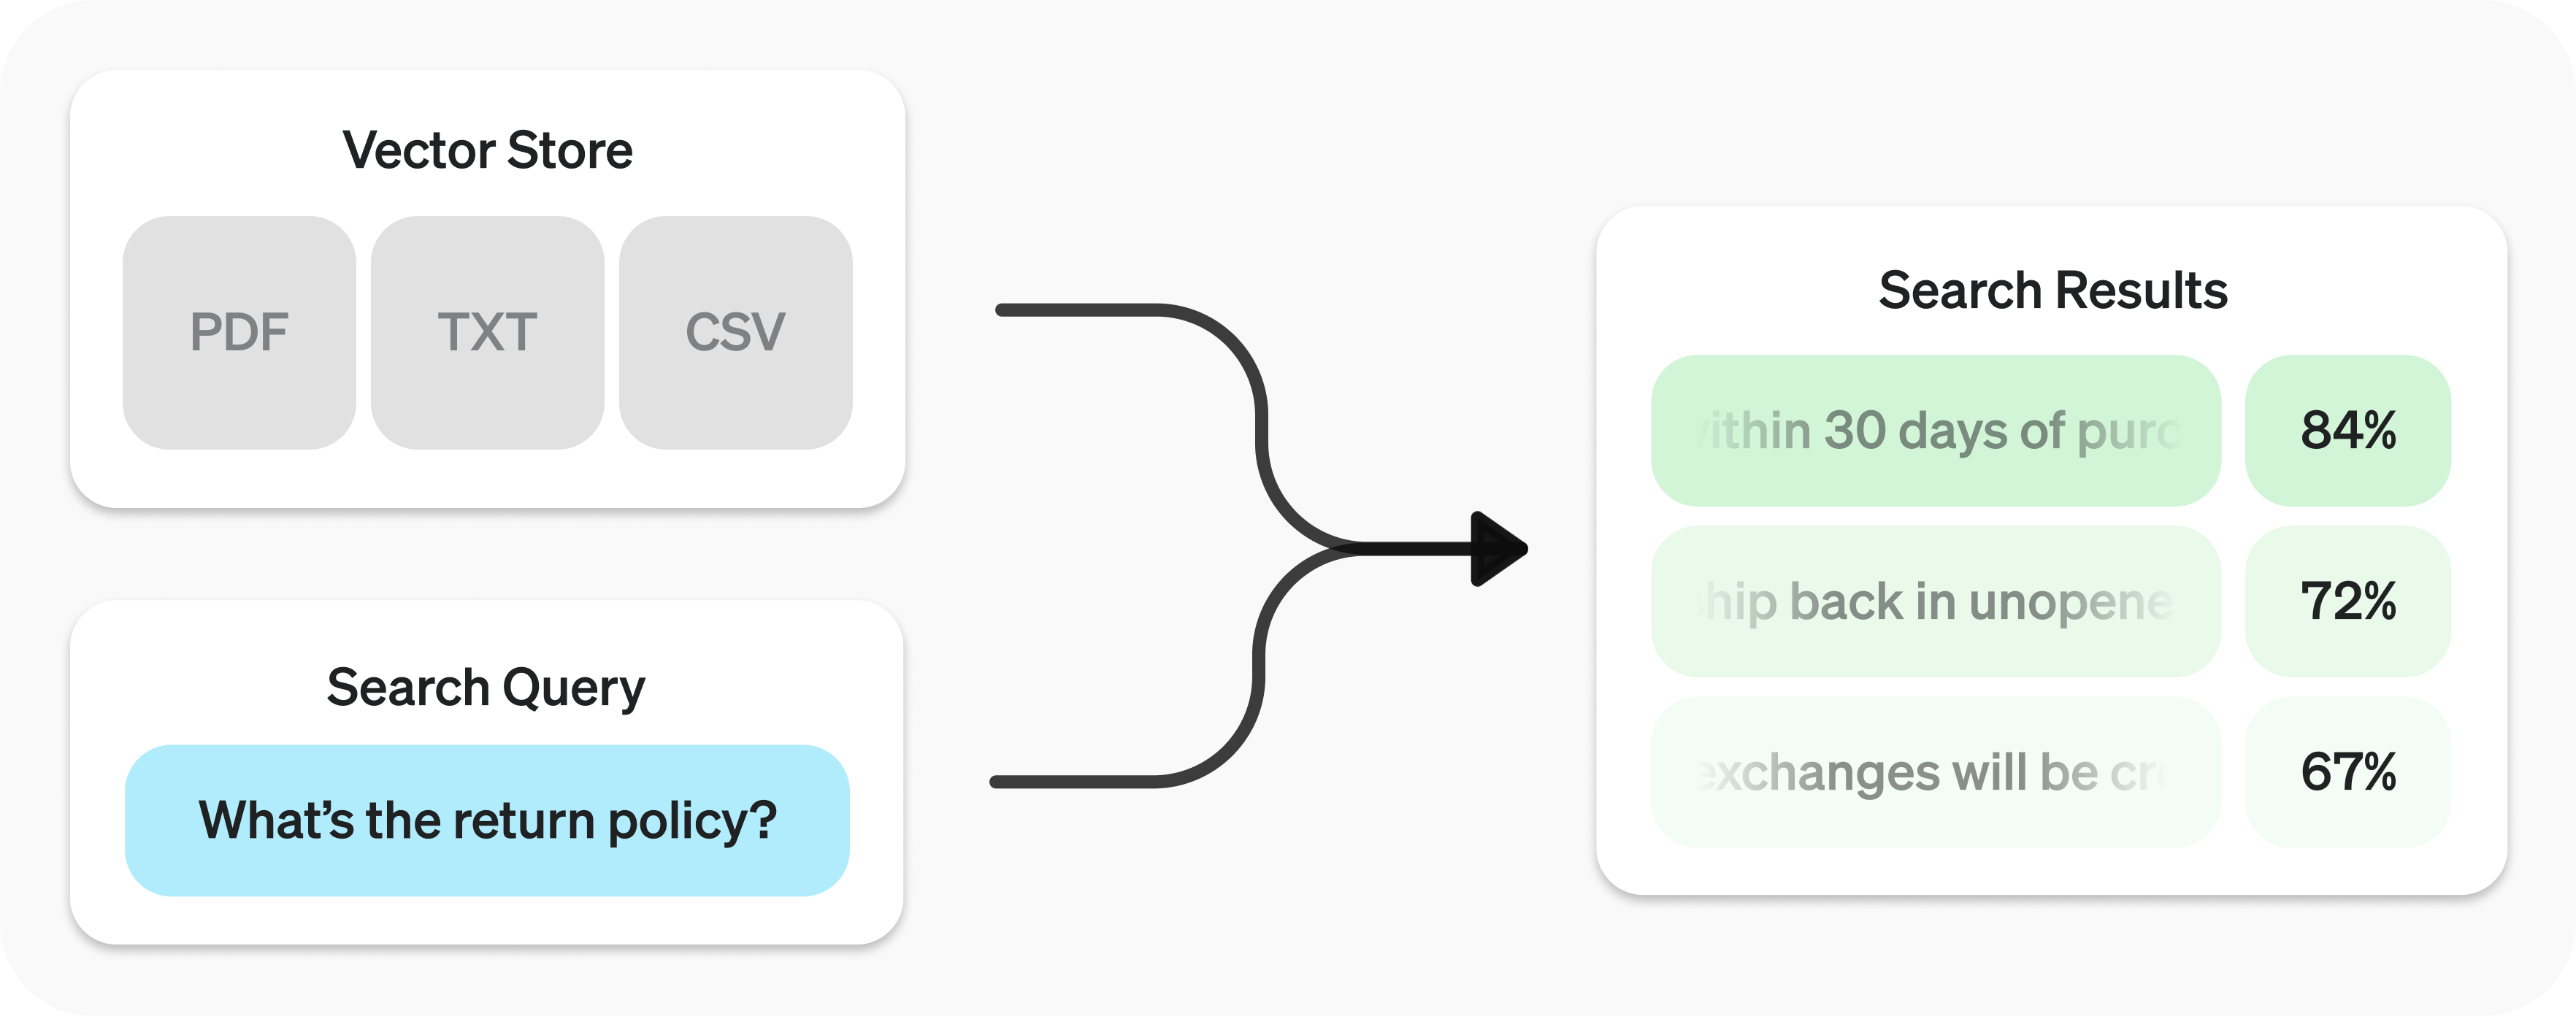
检索 API 让您能够对数据执行语义搜索
检索 API 由向量存储
创建向量存储 并上传文件。
1
2
3
4
5
6
7
8
9
10
11
12
13 import OpenAI from "openai";
const client = new OpenAI();
const vector_store = await client.vectorStores.create({
// Create vector store
name: "Support FAQ",
});
await client.vectorStores.files.uploadAndPoll(
vector_store.id,
// Upload file
fs.createReadStream("customer_policies.txt")
); 1
2
3
4
5
6
7
8
9
10
11
12 from openai import OpenAI
client = OpenAI()
vector_store = client.vector_stores.create( # Create vector store
name = "Support FAQ" ,
)
client.vector_stores.files.upload_and_poll( # Upload file
vector_store_id = vector_store.id,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{Name: openai.String("Support FAQ")})
if err != nil {
panic(err)
}
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
_, err = client.VectorStores.Files.UploadAndPoll(context.Background(), vectorStore.ID, openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.VectorStoreCreateParams;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
var store =
client.vectorStores().create(VectorStoreCreateParams.builder().name("Support FAQ").build());
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
store.id(),
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(file.id(), FileRetrieveParams.builder().vectorStoreId(store.id()).build());
}
System.out.println(store.id()); 1
2
3
4
5
6
7
8
9
10
11
12
13 require "openai"
require "pathname"
client = OpenAI::Client.new
store = client.vector_stores.create(name: "Support FAQ")
file = client.vector_stores.files.upload_and_poll(
store.id,
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{file.status}" unless file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(store.id) 发送搜索查询 以获取相关结果。
1
2
3
4
5 const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6 user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search("vs_123", query: "What is the return policy?")
puts(results.data&.first&.content) 语义搜索 是一种利用嵌入向量 查找语义相关结果的技术。关键在于,它还能找到与查询只有少量相同关键词,甚至没有相同关键词的结果,而传统搜索技术可能会遗漏这些结果。
例如,我们来看看 "When did we go to the moon?" 可能返回的结果:
文本 关键词相似度 语义相似度 首次登月发生在 1969 年 7 月。 0% 65% 第一个登上月球的人是尼尔·阿姆斯特朗。 27% 43% 我吃月饼时,觉得它很美味。 40% 28%
(关键词相似度使用交并比 计算;语义相似度则使用 text-embedding-3-small 和余弦相似度 计算。)
请注意,最相关的结果并不包含搜索查询中的任何词。这种灵活性使语义搜索成为查询任意规模知识库的强大技术。
语义搜索由向量存储 提供支持,我们将在本指南后文详细介绍向量存储。本节将重点介绍语义搜索的工作机制。
您可以使用 search 函数并以自然语言指定 query,来查询向量存储。这会返回一个结果列表,其中每项结果都包含相关文本块、相似度分数和来源文件。
1
2
3 const results = await client.vectorStores.search(vector_store.id, {
query: "How many woodchucks are allowed per passenger?",
}); 1
2
3
4 results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = "How many woodchucks are allowed per passenger?" ,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("How many woodchucks are allowed per passenger?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder()
.query("How many woodchucks are allowed per passenger?")
.build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "How many woodchucks are allowed per passenger?"
)
puts(results.data&.first&.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42 {
"object" : "vector_store.search_results.page" ,
"search_query" : "How many woodchucks are allowed per passenger?" ,
"data" : [
{
"file_id" : "file-12345" ,
"filename" : "woodchuck_policy.txt" ,
"score" : 0.85 ,
"attributes" : {
"region" : "North America" ,
"author" : "Wildlife Department"
},
"content" : [
{
"type" : "text" ,
"text" : "According to the latest regulations, each passenger is allowed to carry up to two woodchucks."
},
{
"type" : "text" ,
"text" : "Ensure that the woodchucks are properly contained during transport."
}
]
},
{
"file_id" : "file-67890" ,
"filename" : "transport_guidelines.txt" ,
"score" : 0.75 ,
"attributes" : {
"region" : "North America" ,
"author" : "Transport Authority"
},
"content" : [
{
"type" : "text" ,
"text" : "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks."
}
]
}
],
"has_more" : false ,
"next_page" : null
} 默认情况下,响应最多包含 10 条结果,但您可以通过 max_num_results 参数将上限设为最多 50 条。
某些查询表达方式能带来更好的结果,因此我们提供了一项设置,可自动改写您的查询以获得最佳效果。执行 search 时,设置 rewrite_query=true 即可启用此功能。
改写后的查询会出现在结果的 search_query 字段中。
原始查询 改写后的查询 我想知道主办公楼的高度。 主办公楼高度 运输危险品有哪些安全规定? 危险品安全规定 如何就服务问题提出投诉? 服务投诉提交流程
属性筛选通过应用条件来缩小结果范围,例如将搜索限定在特定日期范围内。您可以在 attribute_filter 中定义和组合条件,在执行语义搜索之前根据文件属性筛选目标文件。
使用 比较筛选器 ,将文件 attributes 中的特定 key 与给定的 value 进行比较;使用 复合筛选器 ,通过 and 和 or 组合多个筛选器。
1
2
3
4
5 {
"type" : "eq" | "ne" | "gt" | "gte" | "lt" | "lte" | "in" | "nin" , // comparison operators
"key" : "attributes_key" , // attributes key
"value" : "target_value" // value to compare against
} 1
2
3
4 {
"type" : "and" | "or" , // logical operators
"filters" : [ ... ]
} 以下是一些筛选器示例。
地区
1
2
3
4
5 {
"type" : "eq" ,
"key" : "region" ,
"value" : "us"
} 日期范围
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 {
"type" : "and" ,
"filters" : [
{
"type" : "gte" ,
"key" : "date" ,
"value" : 1704067200 // unix timestamp for 2024-01-01
},
{
"type" : "lte" ,
"key" : "date" ,
"value" : 1710892800 // unix timestamp for 2024-03-20
}
]
} 文件名
1
2
3
4
5 {
"type" : "in" ,
"property" : "filename" ,
"value" : [ "example.txt" , "example2.txt" ]
} 排除文件名
1
2
3
4
5 {
"type" : "nin" ,
"property" : "filename" ,
"value" : [ "draft.txt" , "internal_notes.md" ]
} 复杂筛选
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35 {
"type" : "or" ,
"filters" : [
{
"type" : "and" ,
"filters" : [
{
"type" : "or" ,
"filters" : [
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X123"
},
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X999"
}
]
},
{
"type" : "eq" ,
"key" : "confidentiality" ,
"value" : "top_secret"
}
]
},
{
"type" : "eq" ,
"key" : "language" ,
"value" : "en"
}
]
}
如果您发现文件搜索结果的相关性不足,可以调整 ranking_options 来提高响应质量。具体包括指定 ranker(例如 auto 或 default-2024-08-21),以及将 score_threshold 设置为 0.0 到 1.0 之间的值。较高的 score_threshold 会将结果限制为相关性更高的分块,但也可能排除一些潜在有用的分块。提供 ranking_options.hybrid_search 时,您还可以调整 hybrid_search.embedding_weight(rrf_embedding_weight)和 hybrid_search.text_weight(rrf_text_weight),以控制倒数排名融合如何平衡语义嵌入匹配与稀疏关键词匹配。增大前者可侧重语义相似性,增大后者可侧重文本重合度,并确保至少有一个权重大于零。
向量存储是为 Retrieval API 和文件搜索 工具的语义搜索提供支持的容器。将文件添加到向量存储后,系统会自动对其分块、生成嵌入向量并建立索引。
向量存储包含 vector_store_file 对象,每个对象都以一个 file 对象为基础。
对象类型
说明 file表示通过 Files API 上传的内容。通常与向量存储配合使用,也用于微调等其他使用场景。 vector_store用于存放可搜索文件的容器。 vector_store.file一种封装类型,专门表示已完成分块和嵌入向量生成、并已关联到 vector_store 的 file。attributes 映射。
费用按您所有向量存储占用的总存储空间计算,具体取决于解析后的分块及其对应嵌入向量的大小。
存储用量 费用 不超过 1 GB(所有存储合计) 免费 超过 1 GB 的部分 $0.10/GB/天
创建
1
2
3
4 await client.vectorStores.create({
name: "Support FAQ",
file_ids: ["file_123"],
}); 1
2
3
4 client.vector_stores.create(
name = "Support FAQ" ,
file_ids = [ "file_123" ]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{
Name: openai.String("Support FAQ"),
FileIDs: []string{"file_123"},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreCreateParams;
String fileId = "file_123";
var store =
client
.vectorStores()
.create(
VectorStoreCreateParams.builder().name("Support FAQ").addFileId(fileId).build());
System.out.println(store.id()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.create(
name: "Support FAQ",
file_ids: ["file_123"]
)
puts(store.id) 获取
1 await client.vectorStores.retrieve("vs_123"); 1
2
3 client.vector_stores.retrieve(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Get(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().retrieve(vectorStoreId).id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.retrieve("vs_123")
puts(store.id) 更新
1
2
3 await client.vectorStores.update("vs_123", {
name: "Support FAQ Updated",
}); 1
2
3
4 client.vector_stores.update(
vector_store_id = "vs_123" ,
name = "Support FAQ Updated"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
Name: openai.String("Support FAQ Updated"),
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.Name)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder().name("Updated knowledge base").build());
System.out.println(store.name()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update("vs_123", name: "Updated knowledge base")
puts(store.name) 删除
1 await client.vectorStores.delete("vs_123"); 1
2
3 client.vector_stores.delete(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Delete(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().delete(vectorStoreId).deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.delete("vs_123")
puts(deleted.deleted) 列出
await client.vectorStores.list(); client.vector_stores.list() package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStores, err := client.VectorStores.List(context.Background(), openai.VectorStoreListParams{})
if err != nil {
panic(err)
}
fmt.Println(vectorStores.Data)
} import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
System.out.println(client.vectorStores().list().data()); require "openai"
client = OpenAI::Client.new
stores = client.vector_stores.list(limit: 10)
puts((stores.data || []).length)
某些操作是异步的,可能需要一段时间才能完成,例如对 vector_store.file 执行 create。您可以使用 create_and_poll 等辅助函数阻塞等待,直到操作完成,也可以自行检查状态。从向量存储中移除文件采用最终一致性机制,因此在移除后的一小段时间内,搜索结果仍可能包含该文件的内容。
添加文件的速率限制按向量存储 ID 分别计算。对 /vector_stores/{vector_store_id}/files/vector_stores/{vector_store_id}/file_batches
创建
1
2
3 await client.vectorStores.files.createAndPoll("vs_123", {
file_id: "file_123",
}); 1
2
3
4 client.vector_stores.files.create_and_poll(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileNewParams{
FileID: "file_123",
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "vs_123";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(vectorStoreId, FileCreateParams.builder().fileId(fileId).build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create("vs_123", file_id: "file_123")
puts(file.id) 上传
1
2
3
4 await client.vectorStores.files.uploadAndPoll(
"vs_123",
fs.createReadStream("customer_policies.txt")
); 1
2
3
4 client.vector_stores.files.upload_and_poll(
vector_store_id = "vs_123" ,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
result, err := client.VectorStores.Files.UploadAndPoll(context.Background(), "vs_123", openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(result.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
String vectorStoreId = "vs_123";
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(
file.id(), FileRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(file.id()); 1
2
3
4
5
6
7
8
9
10
11
12 require "openai"
require "pathname"
client = OpenAI::Client.new
vector_store_file = client.vector_stores.files.upload_and_poll(
"vs_123",
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{vector_store_file.status}" unless vector_store_file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(vector_store_file.id) 获取
1
2
3 await client.vectorStores.files.retrieve("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.retrieve(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Get(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.retrieve(
fileId,
com.openai.models.vectorstores.files.FileRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.retrieve("file_123", vector_store_id: "vs_123")
puts(file.id) 更新
1
2
3
4 await client.vectorStores.files.update("file_123", {
vector_store_id: "vs_123",
attributes: { key: "value" },
}); 1
2
3
4
5 client.vector_stores.files.update(
vector_store_id = "vs_123" ,
file_id = "file_123" ,
attributes = { "key" : "value" }
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Update(context.Background(), "vs_123", "file_123", openai.VectorStoreFileUpdateParams{
Attributes: map[string]openai.VectorStoreFileUpdateParamsAttributeUnion{
"key": {OfString: openai.String("value")},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileUpdateParams;
String fileId = "file_123";
String vectorStoreId = "vs_123";
var file =
client
.vectorStores()
.files()
.update(
fileId,
FileUpdateParams.builder()
.vectorStoreId(vectorStoreId)
.attributes(
FileUpdateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.update("file_123", vector_store_id: "vs_123", attributes: { category: "policy" })
puts(file.id) 删除
1
2
3 await client.vectorStores.files.delete("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.delete(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Files.Delete(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.delete(
fileId,
com.openai.models.vectorstores.files.FileDeleteParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.files.delete("file_123", vector_store_id: "vs_123")
puts(deleted.deleted) 列出
1 await client.vectorStores.files.list("vs_123"); 1
2
3 client.vector_stores.files.list(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.Files.List(context.Background(), "vs_123", openai.VectorStoreFileListParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().files().list(vectorStoreId).data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.files.list("vs_123")
puts((files.data || []).length)
创建
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 await client.vectorStores.fileBatches.createAndPoll("vs_123", {
files: [
{
file_id: "file_123",
attributes: { department: "finance" },
},
{
file_id: "file_456",
chunking_strategy: {
type: "static",
static: {
max_chunk_size_tokens: 1200,
chunk_overlap_tokens: 200,
},
},
},
],
}); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 client.vector_stores.file_batches.create_and_poll(
vector_store_id = "vs_123" ,
files = [
{
"file_id" : "file_123" ,
"attributes" : { "department" : "finance" }
},
{
"file_id" : "file_456" ,
"chunking_strategy" : {
"type" : "static" ,
"max_chunk_size_tokens" : 1200 ,
"chunk_overlap_tokens" : 200
}
}
]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileBatchNewParams{
Files: []openai.VectorStoreFileBatchNewParamsFile{
{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileBatchNewParamsFileAttributeUnion{
"department": {OfString: openai.String("finance")},
},
},
{
FileID: "file_456",
ChunkingStrategy: openai.FileChunkingStrategyParamUnion{OfStatic: &openai.StaticFileChunkingStrategyObjectParam{
Static: openai.StaticFileChunkingStrategyParam{MaxChunkSizeTokens: 1200, ChunkOverlapTokens: 200},
}},
},
},
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.StaticFileChunkingStrategy;
import com.openai.models.vectorstores.filebatches.FileBatchCreateParams;
import com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams;
import com.openai.models.vectorstores.filebatches.VectorStoreFileBatch;
String vectorStoreId = "vs_123";
String fileId = "file_123";
String fileId2 = "file_456";
var first =
FileBatchCreateParams.File.builder()
.fileId(fileId)
.attributes(
FileBatchCreateParams.File.Attributes.builder()
.putAdditionalProperty("department", JsonValue.from("finance"))
.build())
.build();
var second =
FileBatchCreateParams.File.builder()
.fileId(fileId2)
.staticChunkingStrategy(
StaticFileChunkingStrategy.builder()
.maxChunkSizeTokens(1200)
.chunkOverlapTokens(200)
.build())
.build();
var batch =
client
.vectorStores()
.fileBatches()
.create(
vectorStoreId,
FileBatchCreateParams.builder().addFile(first).addFile(second).build());
while (batch.status().equals(VectorStoreFileBatch.Status.IN_PROGRESS)) {
Thread.sleep(1000);
batch =
client
.vectorStores()
.fileBatches()
.retrieve(
batch.id(),
FileBatchRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(batch.status()); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.create_and_poll(
"vs_123",
files: [
{
file_id: "file_123",
attributes: { department: "finance" }
},
{
file_id: "file_456",
chunking_strategy: {
type: :static,
static: {
max_chunk_size_tokens: 1_200,
chunk_overlap_tokens: 200
}
}
}
],
timeout: 600
)
raise "File ingestion ended with status: #{batch.status}" unless batch.status == OpenAI::VectorStores::VectorStoreFileBatch::Status::COMPLETED
raise "File ingestion failed for #{batch.file_counts.failed} file(s)" if batch.file_counts.failed.positive?
# Live validation of per-file batches returned default chunking despite overrides.
file = client.vector_stores.files.retrieve("file_456", vector_store_id: "vs_123")
strategy = file.chunking_strategy
unless strategy.is_a?(OpenAI::StaticFileChunkingStrategyObject) &&
strategy.static.max_chunk_size_tokens == 1_200 &&
strategy.static.chunk_overlap_tokens == 200
raise "Requested chunking was not applied to #{file.id}: #{strategy.to_json}"
end
puts(batch.status) 获取
1
2
3 await client.vectorStores.fileBatches.retrieve("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.retrieve(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Get(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.retrieve(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.retrieve(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) 取消
1
2
3 await client.vectorStores.fileBatches.cancel("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.cancel(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Cancel(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.Status)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.cancel(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchCancelParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.cancel(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) 列出
1
2
3 await client.vectorStores.fileBatches.listFiles("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.list_files(
"vsfb_123" ,
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.FileBatches.ListFiles(context.Background(), "vs_123", "vsfb_123", openai.VectorStoreFileBatchListFilesParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.listFiles(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchListFilesParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.file_batches.list_files(
"vsfb_123",
vector_store_id: "vs_123"
)
puts((files.data || []).length)
创建批次时,您可以提供 file_ids,并按需指定 attributes 和/或 chunking_strategy;也可以使用 files 数组,为每个文件传入包含 file_id 以及可选的 attributes 和 chunking_strategy 的对象。这两种方式互斥,便于您明确控制是让所有文件共用相同设置,还是按文件覆盖设置。
为提高向单个向量存储摄取数据的吞吐量,我们建议尽可能使用批量创建。每个批次可在一次请求中包含最多 500 个文件,与发送大量单文件创建请求相比,这通常能减少资源争用并降低端到端延迟。
每个 vector_store.file 都可以关联 attributes,这是一个值字典,在使用属性筛选 进行语义搜索 时可以引用其中的值。该字典最多可以包含 16 个键,每个键最多包含 256 个字符。
1
2
3
4
5
6
7
8 await client.vectorStores.files.create("<vector_store_id>", {
file_id: "file_123",
attributes: {
region: "US",
category: "Marketing",
date: 1672531200, // Jan 1, 2023
},
}); 1
2
3
4
5
6
7
8
9 client.vector_stores.files.create(
vector_store_id = "<vector_store_id>" ,
file_id = "file_123" ,
attributes = {
"region" : "US" ,
"category" : "Marketing" ,
"date" : 1672531200 # Jan 1, 2023
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.New(context.Background(), "<vector_store_id>", openai.VectorStoreFileNewParams{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileNewParamsAttributeUnion{
"region": {OfString: openai.String("US")},
"category": {OfString: openai.String("Marketing")},
"date": {OfFloat: openai.Float(1672531200)},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "<vector_store_id>";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
FileCreateParams.builder()
.fileId(fileId)
.attributes(
FileCreateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create("<vector_store_id>", file_id: "file_123", attributes: { category: "policy" })
puts(file.id) 您可以通过 expires_after 为 vector_store 对象设置过期策略。向量存储过期后,所有关联的 vector_store.file 对象都会被删除,您也无需再为这些对象付费。
1
2
3
4
5
6 await client.vectorStores.update("vs_123", {
expires_after: {
anchor: "last_active_at",
days: 7,
},
}); 1
2
3
4
5
6
7 client.vector_stores.update(
vector_store_id = "vs_123" ,
expires_after = {
"anchor" : "last_active_at" ,
"days" : 7
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
ExpiresAfter: openai.VectorStoreUpdateParamsExpiresAfter{Days: 7},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ExpiresAfter)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder()
.expiresAfter(
VectorStoreUpdateParams.ExpiresAfter.builder()
.anchor(JsonValue.from("last_active_at"))
.days(7)
.build())
.build());
System.out.println(store.expiresAfter().orElseThrow()); 1
2
3
4
5
6
7
8
9
10
11 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update(
"vs_123",
expires_after: {
anchor: :last_active_at,
days: 7
}
)
puts(store.expires_after) 文件大小上限为 512 MB。每个文件包含的 Token 数不应超过 5,000,000(在您附加文件时自动计算)。
默认情况下,max_chunk_size_tokens 设置为 800,chunk_overlap_tokens 设置为 400,这意味着每个文件在建立索引时会被拆分为每块 800 个 Token 的块,相邻块之间有 400 个 Token 重叠。
您可以在向向量存储添加文件时,通过设置 chunking_strategy
max_chunk_size_tokens 必须介于 100 和 4096 之间(包含两端值)。chunk_overlap_tokens 必须为非负数,且不应超过 max_chunk_size_tokens / 2。
支持的文件类型 对于 text/ MIME 类型,编码必须是 utf-8、utf-16 或 ascii 之一。
文件格式 MIME 类型 .ctext/x-c.cpptext/x-c++.cstext/x-csharp.csstext/css.docapplication/msword.docxapplication/vnd.openxmlformats-officedocument.wordprocessingml.document.gotext/x-golang.htmltext/html.javatext/x-java.jstext/javascript.jsonapplication/json.mdtext/markdown.pdfapplication/pdf.phptext/x-php.pptxapplication/vnd.openxmlformats-officedocument.presentationml.presentation.pytext/x-python.pytext/x-script.python.rbtext/x-ruby.shapplication/x-sh.textext/x-tex.tsapplication/typescript.txttext/plain
执行查询后,您可能希望根据结果综合生成回答。您可以向我们的模型提供查询结果和原始查询,让模型生成有据可依的回答。
1
2
3
4
5
6
7
8
9 import OpenAI from "openai";
const client = new OpenAI();
const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6
7
8
9
10 from openai import OpenAI
client = OpenAI()
user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "What is the return policy?"
)
puts(results.data) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 const formattedResults = formatResults(results.data);
// Join the text content of all results
const textSources = results.data
.map((result) => result.content.map((c) => c.text).join("\n"))
.join("\n");
const completion = await client.chat.completions.create({
model: "gpt-6-astra",
messages: [
{
role: "developer",
content:
"Produce a concise answer to the query based on the provided sources.",
},
{
role: "user",
content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`,
},
],
});
console.log(completion.choices[0].message.content); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 # Use results and user_query from the preceding search step.
formatted_results = format_results(results.data)
" \n " .join( " \n " .join(c.text for c in result.content) for result in results.data)
completion = client.chat.completions.create(
model = "gpt-6-astra" ,
messages = [
{
"role" : "developer" ,
"content" : "Produce a concise answer to the query based on the provided sources." ,
},
{
"role" : "user" ,
"content" : f "Sources: { formatted_results }\n\n Query: ' { user_query } '" ,
},
],
)
print (completion.choices[ 0 ].message.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46 package main
import (
"context"
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
userQuery := "What is the return policy?"
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)},
})
if err != nil {
panic(err)
}
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-6-astra",
Messages: []openai.ChatCompletionMessageParamUnion{
openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."),
openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)),
},
})
if err != nil {
panic(err)
}
fmt.Println(completion.Choices[0].Message.Content)
}
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
import com.openai.models.vectorstores.VectorStoreSearchParams;
import java.util.stream.Collectors;
String vectorStoreId = "vs_123";
String query = "What is the return policy?";
var results =
client
.vectorStores()
.search(vectorStoreId, VectorStoreSearchParams.builder().query(query).build());
String sources =
results.data().stream()
.map(
result ->
"<result file_id='"
+ result.fileId()
+ "' file_name='"
+ result.filename()
+ "'>"
+ result.content().stream()
.map(content -> "<content>" + content.text() + "</content>")
.collect(Collectors.joining())
+ "</result>")
.collect(Collectors.joining());
var completion =
client
.chat()
.completions()
.create(
ChatCompletionCreateParams.builder()
.model("gpt-6-astra")
.addDeveloperMessage(
"Answer the query concisely using only the provided sources.")
.addUserMessage(
"Sources: <sources>" + sources + "</sources>\n\nQuery: " + query)
.build());
completion.choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 require "openai"
client = OpenAI::Client.new
query = "What is the return policy?"
results = client.vector_stores.search("vs_123", query: query)
sources = (results.data || []).map do |result|
content = result.content.map { |part| "<content>#{part.text}</content>" }.join
"<result file_id='#{result.file_id}' file_name='#{result.filename}'>#{content}</result>"
end.join
completion = client.chat.completions.create(
model: "gpt-6-astra",
messages: [
{
role: :developer,
content: "Answer the query concisely using only the provided sources."
},
{
role: :user,
content: "Sources: <sources>#{sources}</sources>\n\nQuery: #{query}"
}
]
)
puts(completion.choices.fetch(0).message.content) "Our return policy allows returns within 30 days of purchase." 这里使用了一个示例 format_results 函数,其实现方式可以
如下:
1
2
3
4
5
6
7
8
9
10
11 function formatResults(results) {
let formattedResults = "";
for (const result of results.data) {
let formattedResult = `<result file_id='${result.file_id}' file_name='${result.filename}'>`;
for (const part of result.content) {
formattedResult += `<content>${part.text}</content>`;
}
formattedResults += formattedResult + "</result>";
}
return `<sources>${formattedResults}</sources>`;
} 1
2
3
4
5
6
7
8
9
10 def format_results (results):
formatted_results = ""
for result in results.data:
formatted_result = (
f "<result file_id=' { result.file_id } ' file_name=' { result.file_name } '>"
)
for part in result.content:
formatted_result += f "<content> { part.text } </content>"
formatted_results += formatted_result + "</result>"
return f "<sources> { formatted_results } </sources>" 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31 package main
import (
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
results := []openai.VectorStoreSearchResponse{{
FileID: "file-12345",
Filename: "woodchuck_policy.txt",
Content: []openai.VectorStoreSearchResponseContent{{Text: "Each passenger may carry up to two woodchucks."}},
}}
fmt.Println(formatResults(results))
}
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 results = [
{
file_id: "file-12345",
filename: "woodchuck_policy.txt",
content: [{ text: "Each passenger may carry up to two woodchucks." }]
}
]
sources = results.map do |result|
content = result.fetch(:content).map { |part| "<content>#{part.fetch(:text)}</content>" }.join
"<result file_id=\"#{result.fetch(:file_id)}\" file_name=\"#{result.fetch(:filename)}\">#{content}</result>"
end
puts("<sources>#{sources.join}</sources>")