
本指南介绍了一组核心原则,可用于降低各类 LLM 相关使用场景的延迟。这些技巧源于我们与众多客户和开发者在生产应用上的合作经验,因此,无论您构建的是细化的工作流程,还是端到端的聊天应用,都应该适用。
降低延迟的具体技巧有很多,本指南将其归纳为 七项原则 ,从整体上对这些方法进行分类。
最后,我们将通过一个示例,看看如何应用这些原则。
七项原则
更快地处理 Token
解决延迟问题时,您首先想到的可能是推理速度 (不过您很快就会看到,需要考虑的远不止这一点)。它指的是 LLM 实际处理 Token 的速率,通常以 TPM(每分钟处理的 Token 数)或 TPS(每秒处理的 Token 数)衡量。
影响推理速度的主要因素是 模型大小。较小的模型通常运行得更快,成本也更低;使用得当时,效果甚至可以优于较大的模型。为了让较小的模型也能保持高质量表现,您可以尝试:
您还可以采用推理优化措施,例如我们的预测输出功能。如果您预先知道输出中的大部分内容,例如在代码编辑任务中,预测输出可以显著降低生成延迟。向模型提供预测内容后,LLM 就能更多地专注于实际需要修改的部分,减少在不变内容上花费的精力。
影响推理速度的其他因素还包括您可用的
计算资源,以及您采用的其他
推理优化措施。
大多数人无法直接改变这些因素,但如果您对此感兴趣,
并且对基础设施有一定的控制权,那么采用更快的硬件或
让引擎在较低饱和度下运行,或许能让您的
TPM 略有提升。如果您深入到底层实现,还有许多其他的
推理优化技术
,不过这些就超出了本指南的讨论范围。
减少生成的 Token
使用 LLM 时,生成 Token 几乎总是延迟最高的环节。一般而言, 将输出 Token 减少 50%,可能会使延迟降低约 50%。缩减输出的具体方法取决于输出类型:
如果您生成的是 自然语言, 要求模型表达得更简洁 (例如“少于 20 个词”或“简短一些”)可能会有帮助。您还可以使用少样本示例和/或微调,教会模型给出更简短的回复。
如果您生成的是 结构化输出,请尽可能 精简输出语法 ,例如缩短函数名、省略具名实参、合并参数等。
最后,虽然不常用,但您也可以使用 max_tokens 或 stop_tokens 提前结束生成。
请记住:少生成一个 Token,就能省下一点时间,哪怕只有几毫秒!
减少输入 Token
减少输入 Token 的数量确实能降低延迟,但通常影响不大:将提示缩短 50%,可能仅带来 1–5% 的延迟改善。除非您处理的上下文规模非常庞大(如文档、图像),否则您可能更应该将精力投入其他方面。
不过,如果您 确实 在处理海量上下文(或者您决心挖掘每一点性能, 并且 已经用尽其他方法),可以采用以下技巧减少输入 Token:
- 微调模型,从而无需提供冗长的指令或示例。
- 过滤输入的上下文,例如精简 RAG 结果、清理 HTML 等。
- 尽可能延长提示的共享前缀,将动态部分(例如 RAG 结果和历史记录)放在提示的后面。这样,请求就能更好地利用大多数 LLM 提供商采用的 KV 缓存,减少每次请求需要处理的输入 Token。
请查阅我们的文档,详细了解提示 缓存 的工作原理。
减少请求次数
每次发出请求都会产生一定的往返延迟,这些延迟会逐渐累积。
如果您需要让 LLM 按顺序执行多个步骤,可以考虑 将它们放在同一个提示中,并在一次响应中获取所有结果,而不是每个步骤分别发出请求。这样既能避免额外的往返延迟,也有可能降低处理多个响应的复杂度。
一种做法是在合并后的提示中,用编号列表列出各个步骤,然后要求模型将结果放在 JSON 对象的具名字段中返回。这样,您就可以解析并引用每个结果。
并行处理
使用 LLM 执行多个步骤时,并行处理可以发挥很大的作用。
如果各步骤 不必 严格按顺序执行,您可以 将它们拆分为并行调用。就像同时晾干两件衬衫与晾干一件所需的时间一样。
不过,即使各步骤 必须 严格按顺序执行,您仍有可能 利用推测执行。当分类步骤的某一种结果比其他结果更可能出现时(例如内容审核),这种方法尤其有效。
- 同时启动步骤 1 和步骤 2(例如输入内容审核和故事生成)
- 验证步骤 1 的结果
- 如果结果与预期不符,取消步骤 2(必要时重试)
如果您对步骤 1 的结果猜对了,就相当于在不增加任何延迟的情况下完成了这个步骤!
让用户少等待
等待 与 看到进展的体验截然不同。请确保您的用户体验到的是后者。以下是几种方法:
- 流式传输:这是最有效的方法,能将 等待 时间缩短到一秒或更短。(如果每次都要等整个回复生成完毕才能看到内容,ChatGPT 的使用感受会很不一样。)
- 分块处理:如果输出需要进一步处理(如内容审核、翻译)才能展示给用户,请考虑 分块处理 ,而不是一次性处理全部内容。具体做法是将输出流式传输到后端,再将处理好的内容块发送到前端。
- 展示执行步骤:如果您要执行多个步骤或使用工具,请让用户看到这些过程。能展示的真实进展越多越好。
- 加载状态:加载动画和进度条就能带来很大的帮助。
请注意, 展示执行步骤和加载状态 主要改善的是 用户的心理感受;而将应用和用户视为一个整体时, 流式传输和分块处理 确实能降低总体 延迟,因为用户可以更早地 读完回复。
不要默认使用 LLM
语言模型功能强大、用途广泛,因此有时也会被用在一些更适合采用 速度更快的传统方法 的场景中。找出这类场景,可能会让您大幅降低延迟。请看以下示例:
- 硬编码: 如果 输出 的范围非常有限,您可能无需用 LLM 来生成。操作确认、拒绝消息以及请求用户提供标准输入的提示,都非常适合采用硬编码。(您甚至可以沿用老办法,为每种消息准备几个不同版本。)
- 预计算: 如果 输入 的范围有限(例如类别选择),您可以提前生成多个回复,只需确保不向同一用户重复展示相同的回复。
- 利用 UI: 对于汇总指标、报告或搜索结果,有时使用传统的定制 UI 组件,比使用 LLM 生成的文本更能有效传达信息。
- 传统优化技巧: LLM 应用本质上仍然是应用;二分查找、缓存、哈希表和运行时间复杂度这些技术与概念,在语言模型的世界中 依然 有用。
示例
现在,让我们看看一个示例应用,找出可以优化延迟的地方,并提出一些解决方案!
我们将分析一个假想客服机器人的架构和提示,其设计参考了真实的生产应用。架构和提示部分介绍基本情况,分析与优化部分则会逐步介绍延迟优化的过程。
您会发现,这个示例并未涵盖每一条原则,就像实际使用场景也不需要用到每一种技巧一样。
架构和提示
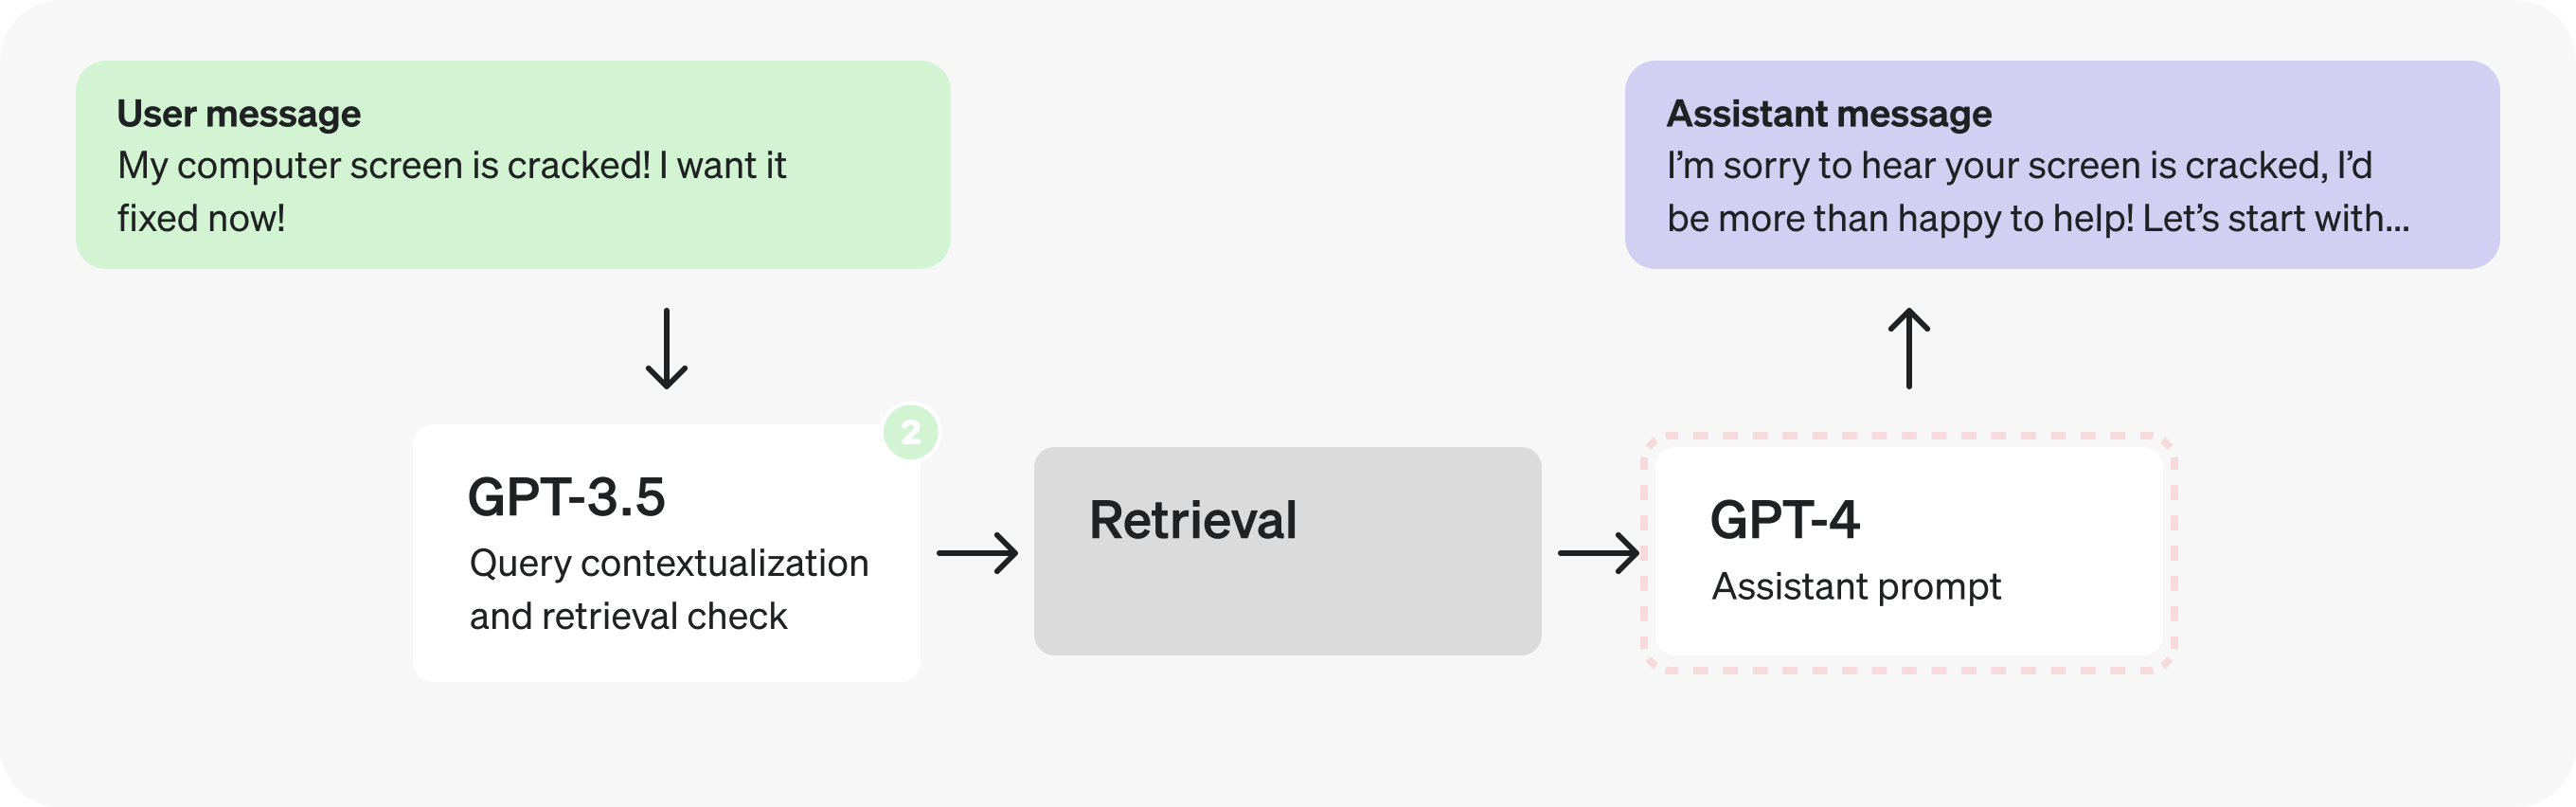
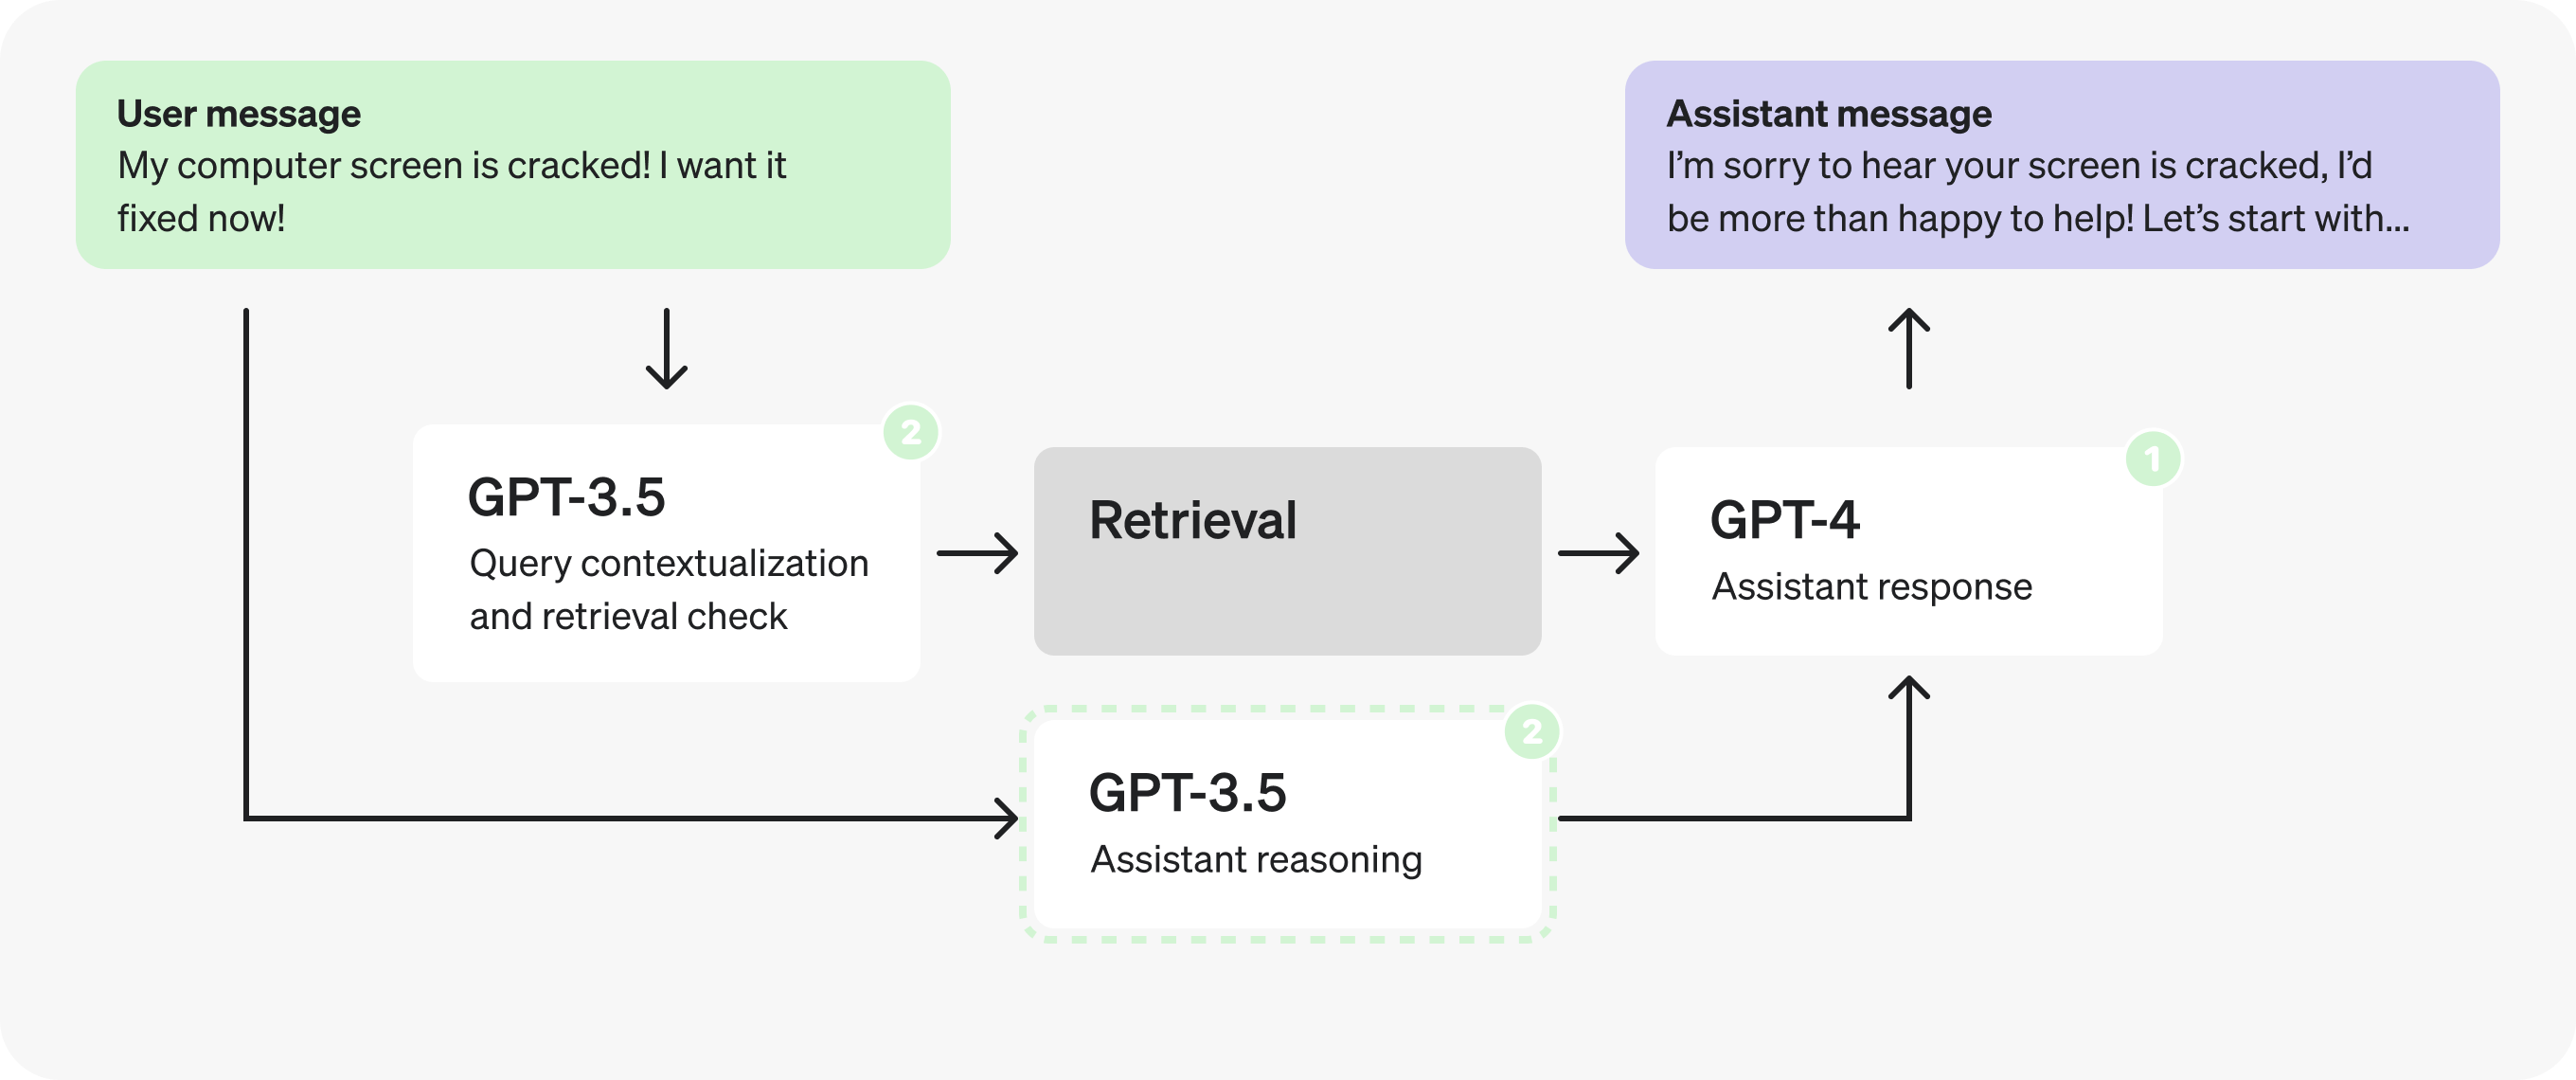
以下是一个假想 客服机器人的 初始架构 。我们将以此为基础进行修改。
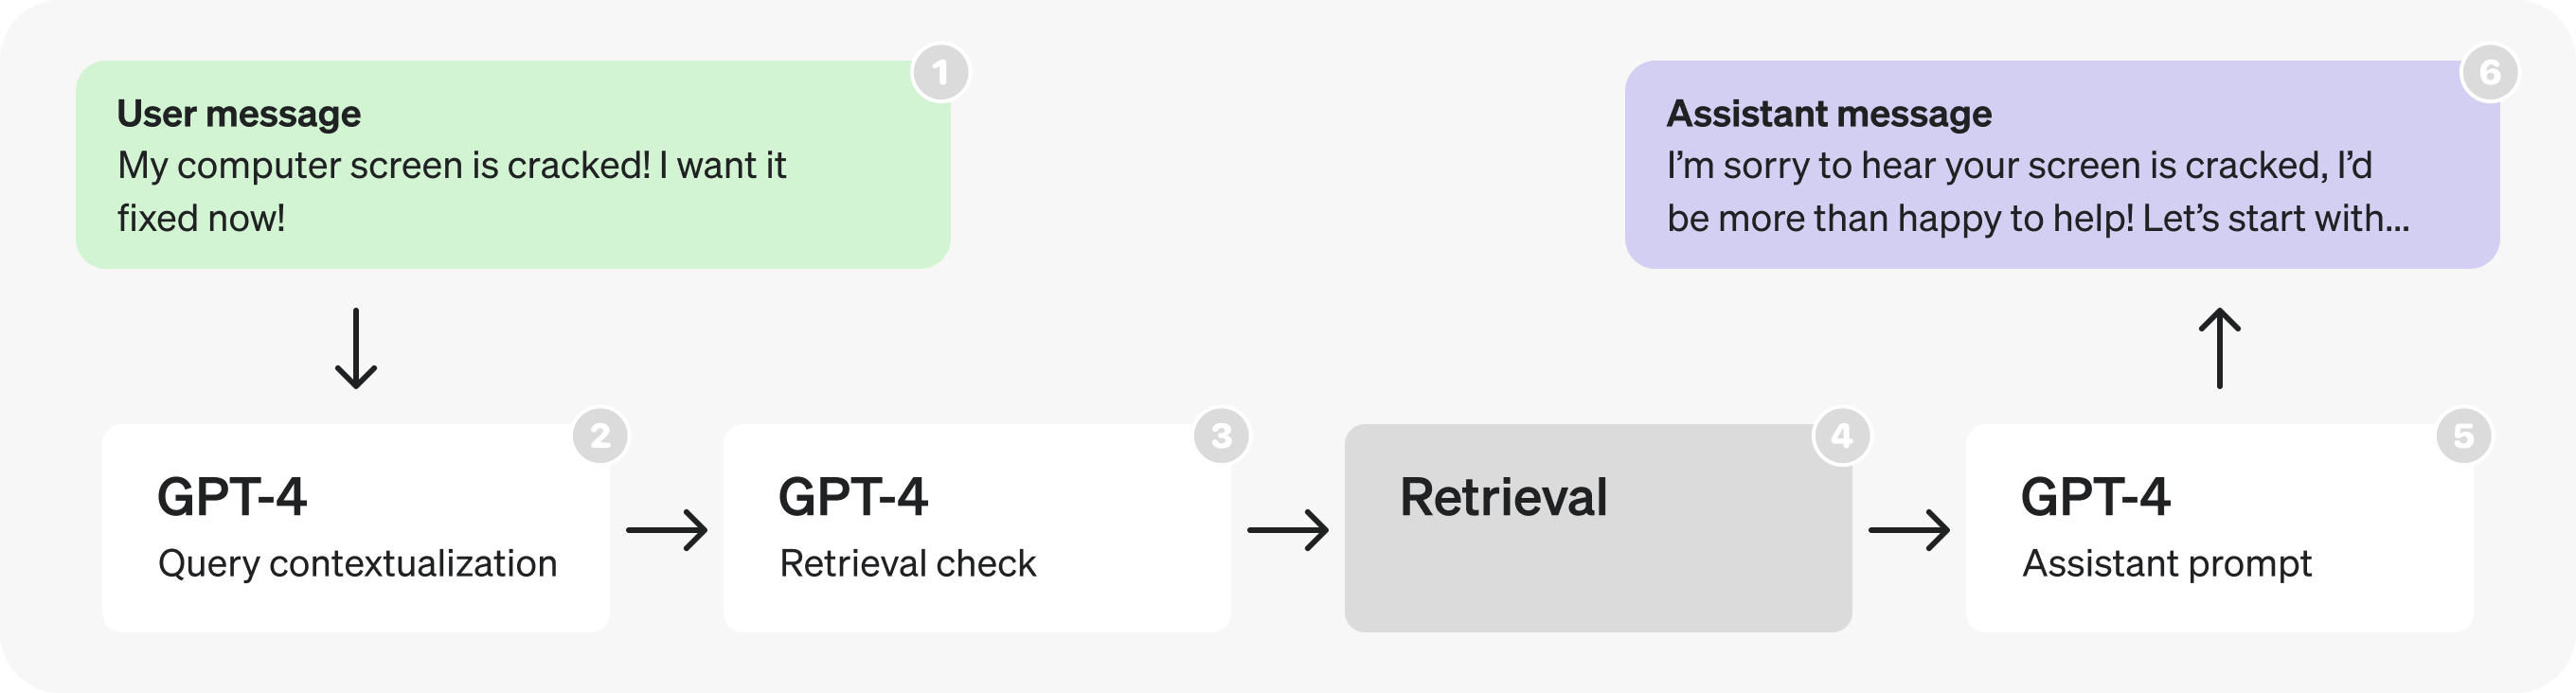
概括来说,图中展示了以下流程:
- 用户在正在进行的对话中发送一条消息。
- 将最新一条消息转换为 语义完整、无需依赖上下文的查询 (参见提示中的示例)。
- 判断回答该查询是否 需要额外信息(通过检索获取) 。
- 执行检索 ,获得搜索结果。
- 助手根据用户的查询和搜索结果进行 推理 ,并 生成回复。
- 将回复发送给用户。
以下是图中各个环节使用的提示。虽然这些提示是假想的简化示例,但其结构和措辞与生产应用中使用的提示一致。
像“[user input here]”这样的占位符表示 动态内容,运行时会用实际数据替换。
分析与优化
第 1 部分:分析检索提示
查看架构时,首先引人注意的是 连续的 GPT-4 调用 。这表明可能存在效率问题,通常可以用单次调用或并行调用来替代。
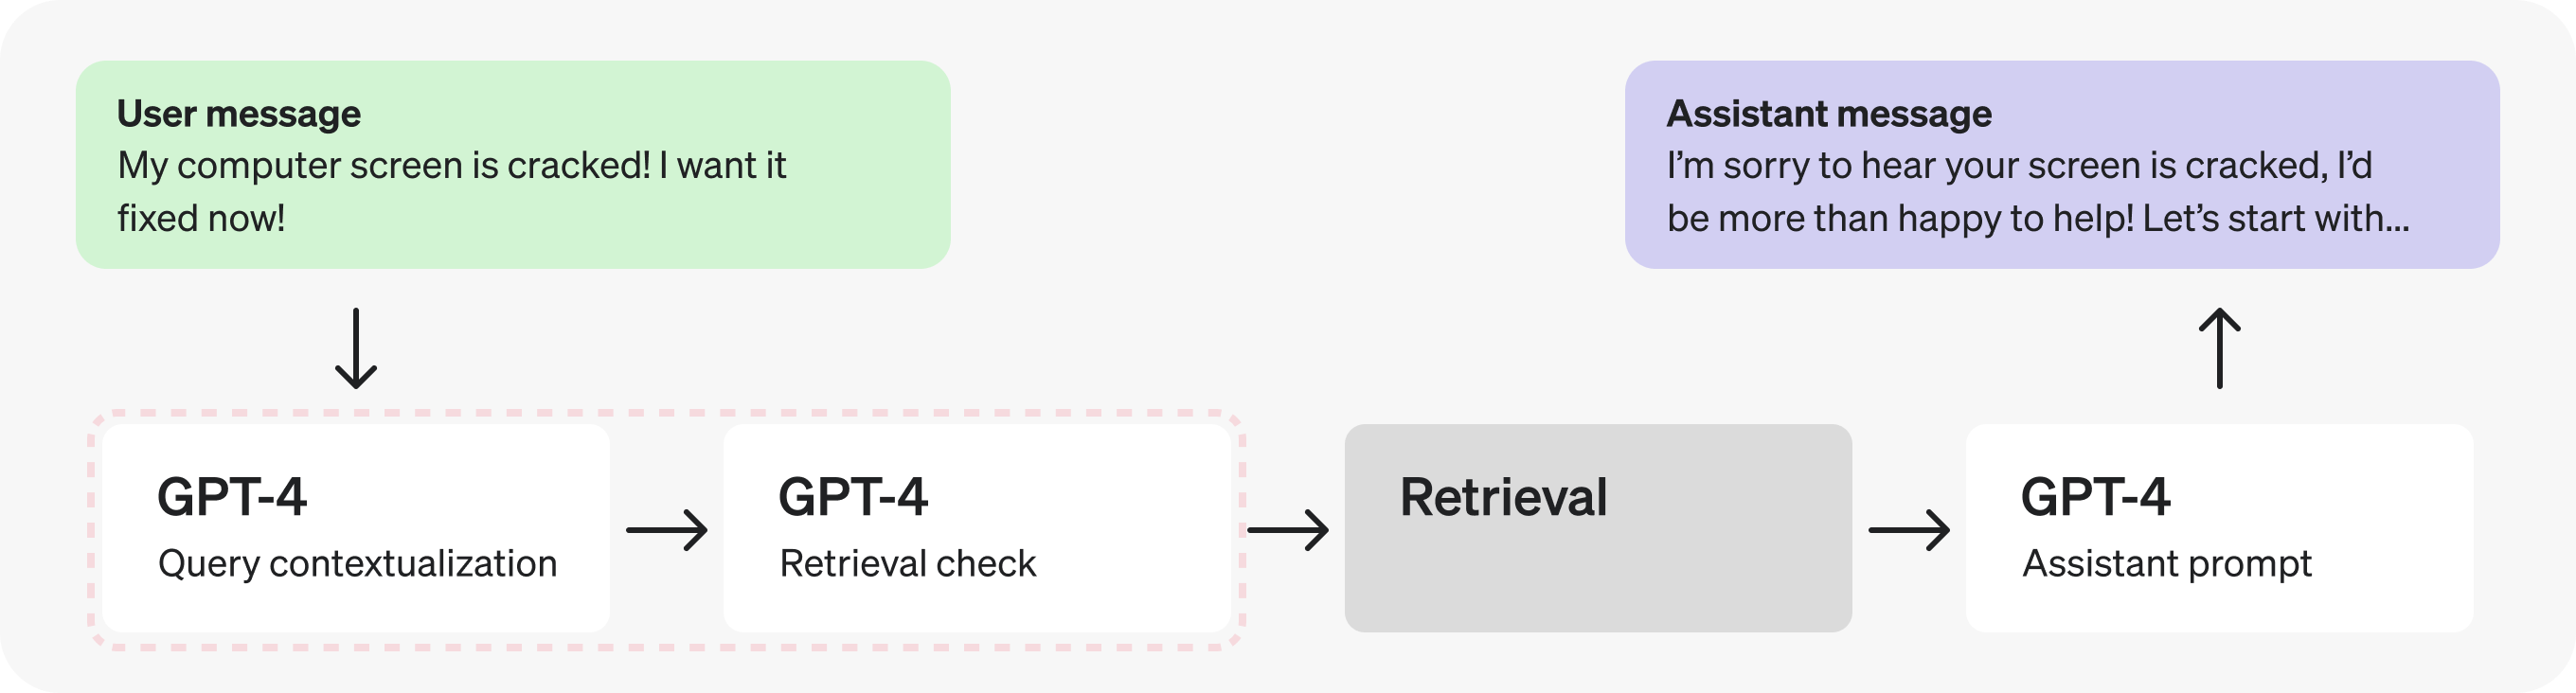
在这个示例中,由于判断检索需求需要使用已补充上下文的查询,我们可以 将这两项任务合并到一个提示中 ,从而减少请求次数。
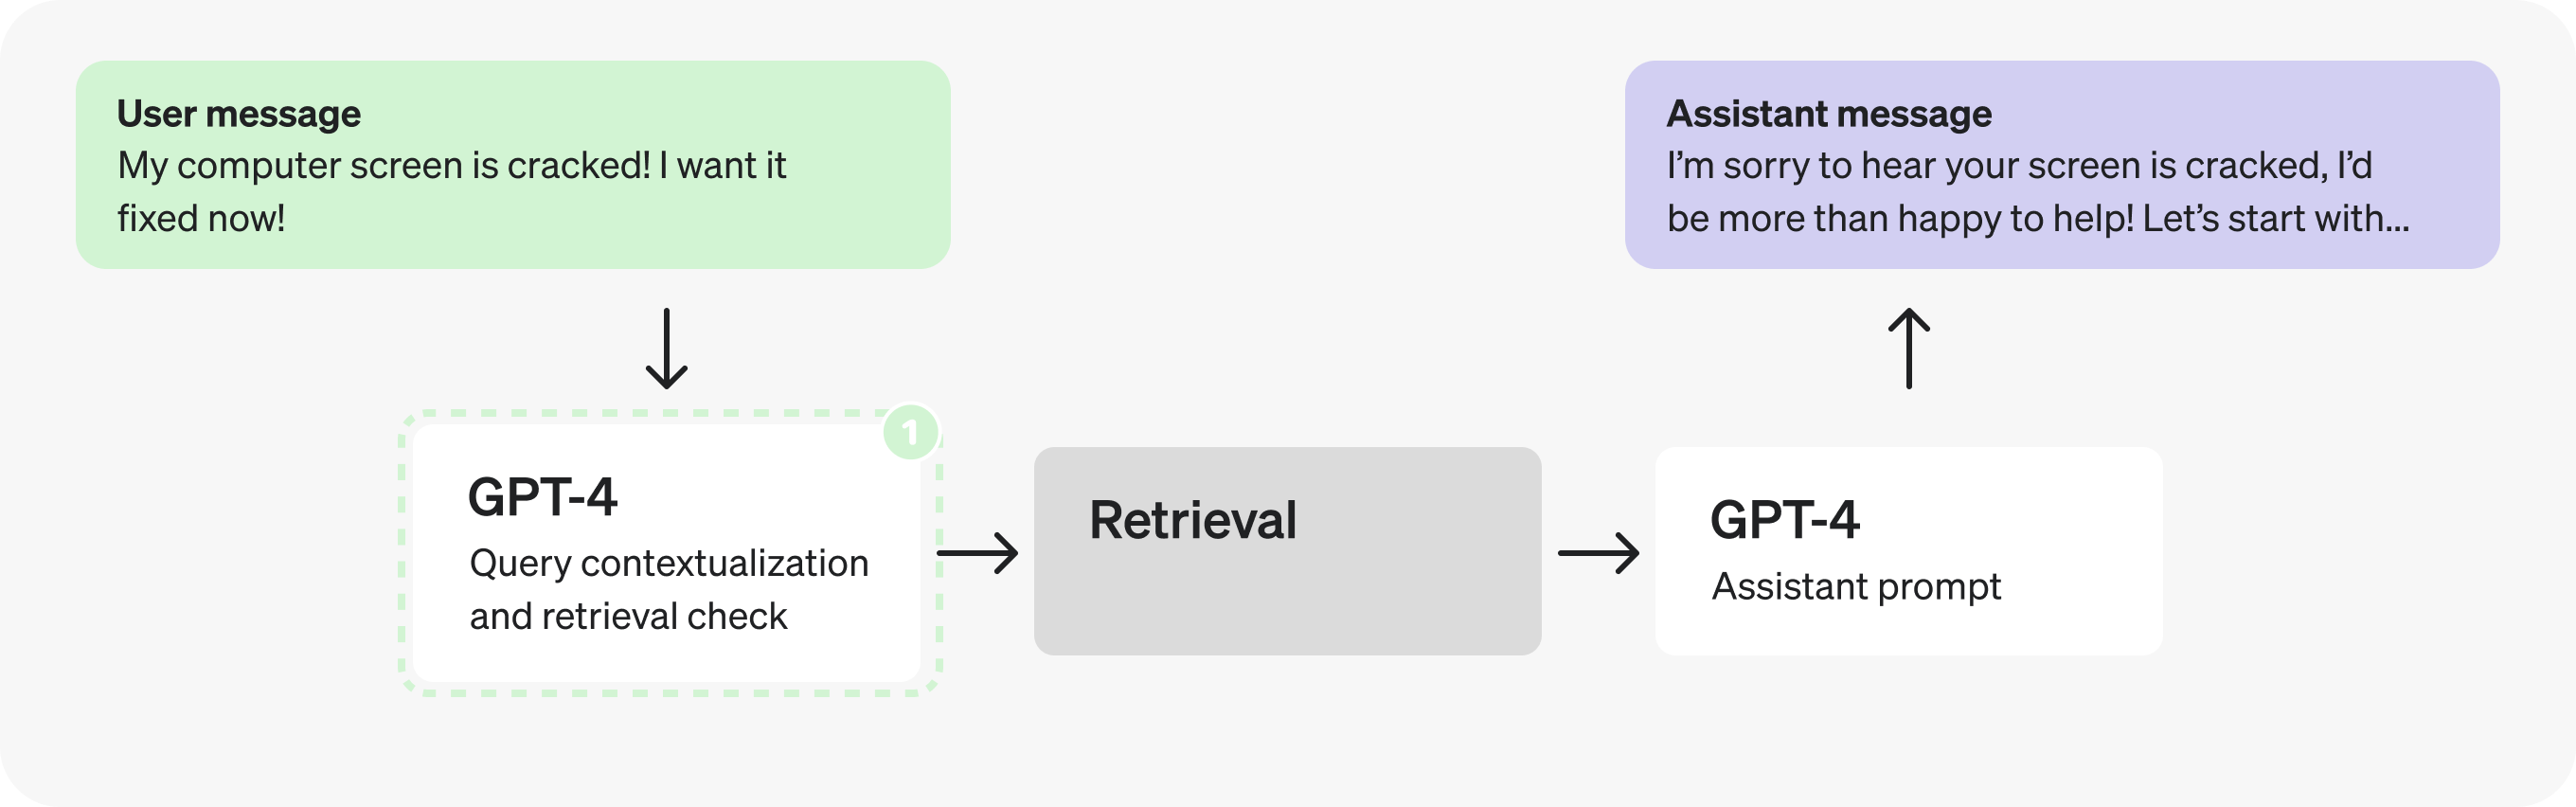
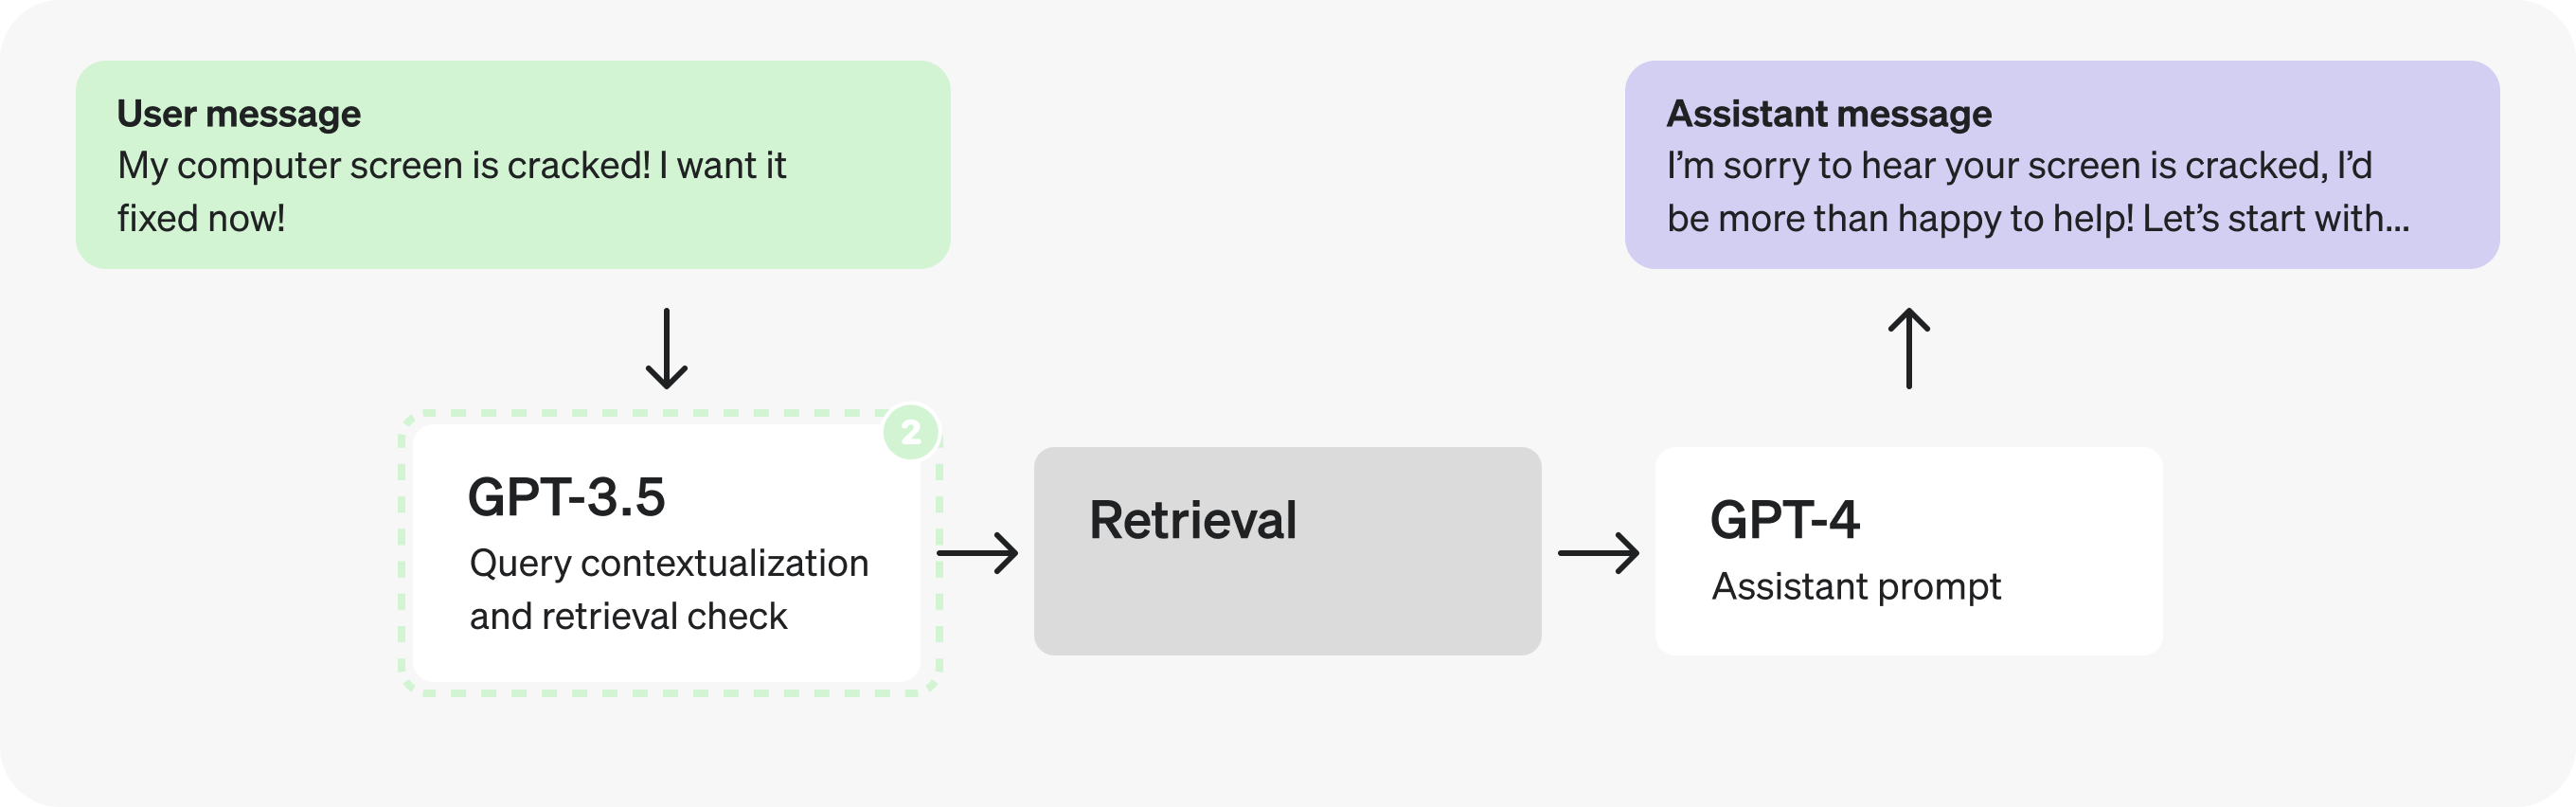
实际上,补充上下文和判断是否需要检索都是简单且定义明确的任务,因此我们很可能可以改用 经过微调的较小模型 。切换到 GPT-3.5 可以让我们更快地处理 Token。
第 2 部分:分析助手提示
现在,让我们关注助手提示。填写 JSON 字段的过程似乎包含许多不同的步骤,这意味着可能存在并行处理的机会。
不过,假设我们进行了一些测试,发现拆分 JSON 中的推理步骤会导致回复质量下降,那么我们就需要探索其他解决方案。
能否用经过微调的 GPT-3.5 替代 GPT-4? 或许可以,但一般来说,助手的开放式回复最好还是交给 GPT-4 生成,因为它能更好地应对更广泛的情况。不过,单看这些推理步骤,并非每一步都需要 GPT-4 级别的推理能力。这些步骤的范围明确且有限,因此 很适合考虑通过微调来处理。
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
}这就带来了一个需要权衡的选择:是保留 单次请求,全部内容都由 GPT-4 生成,还是 拆分为两次顺序执行的请求 ,将最终回复以外的所有内容都交给 GPT-3.5 处理?这里两条原则发生了冲突:第一种方案可以减少请求次数,而第二种方案可能让我们更快地处理 Token。
与许多优化中的权衡一样,答案取决于具体情况。例如:
response与其他字段的 Token 数量比例。- 加快大部分字段的处理速度所减少的平均延迟。
- 将一次请求改为两次请求所 增加 的平均延迟。
结论会因情况而异,最好的判断方式是使用生产环境中的实例进行测试。在这个示例中,假设测试表明,将提示一分为二以更快地处理 Token是有利的。
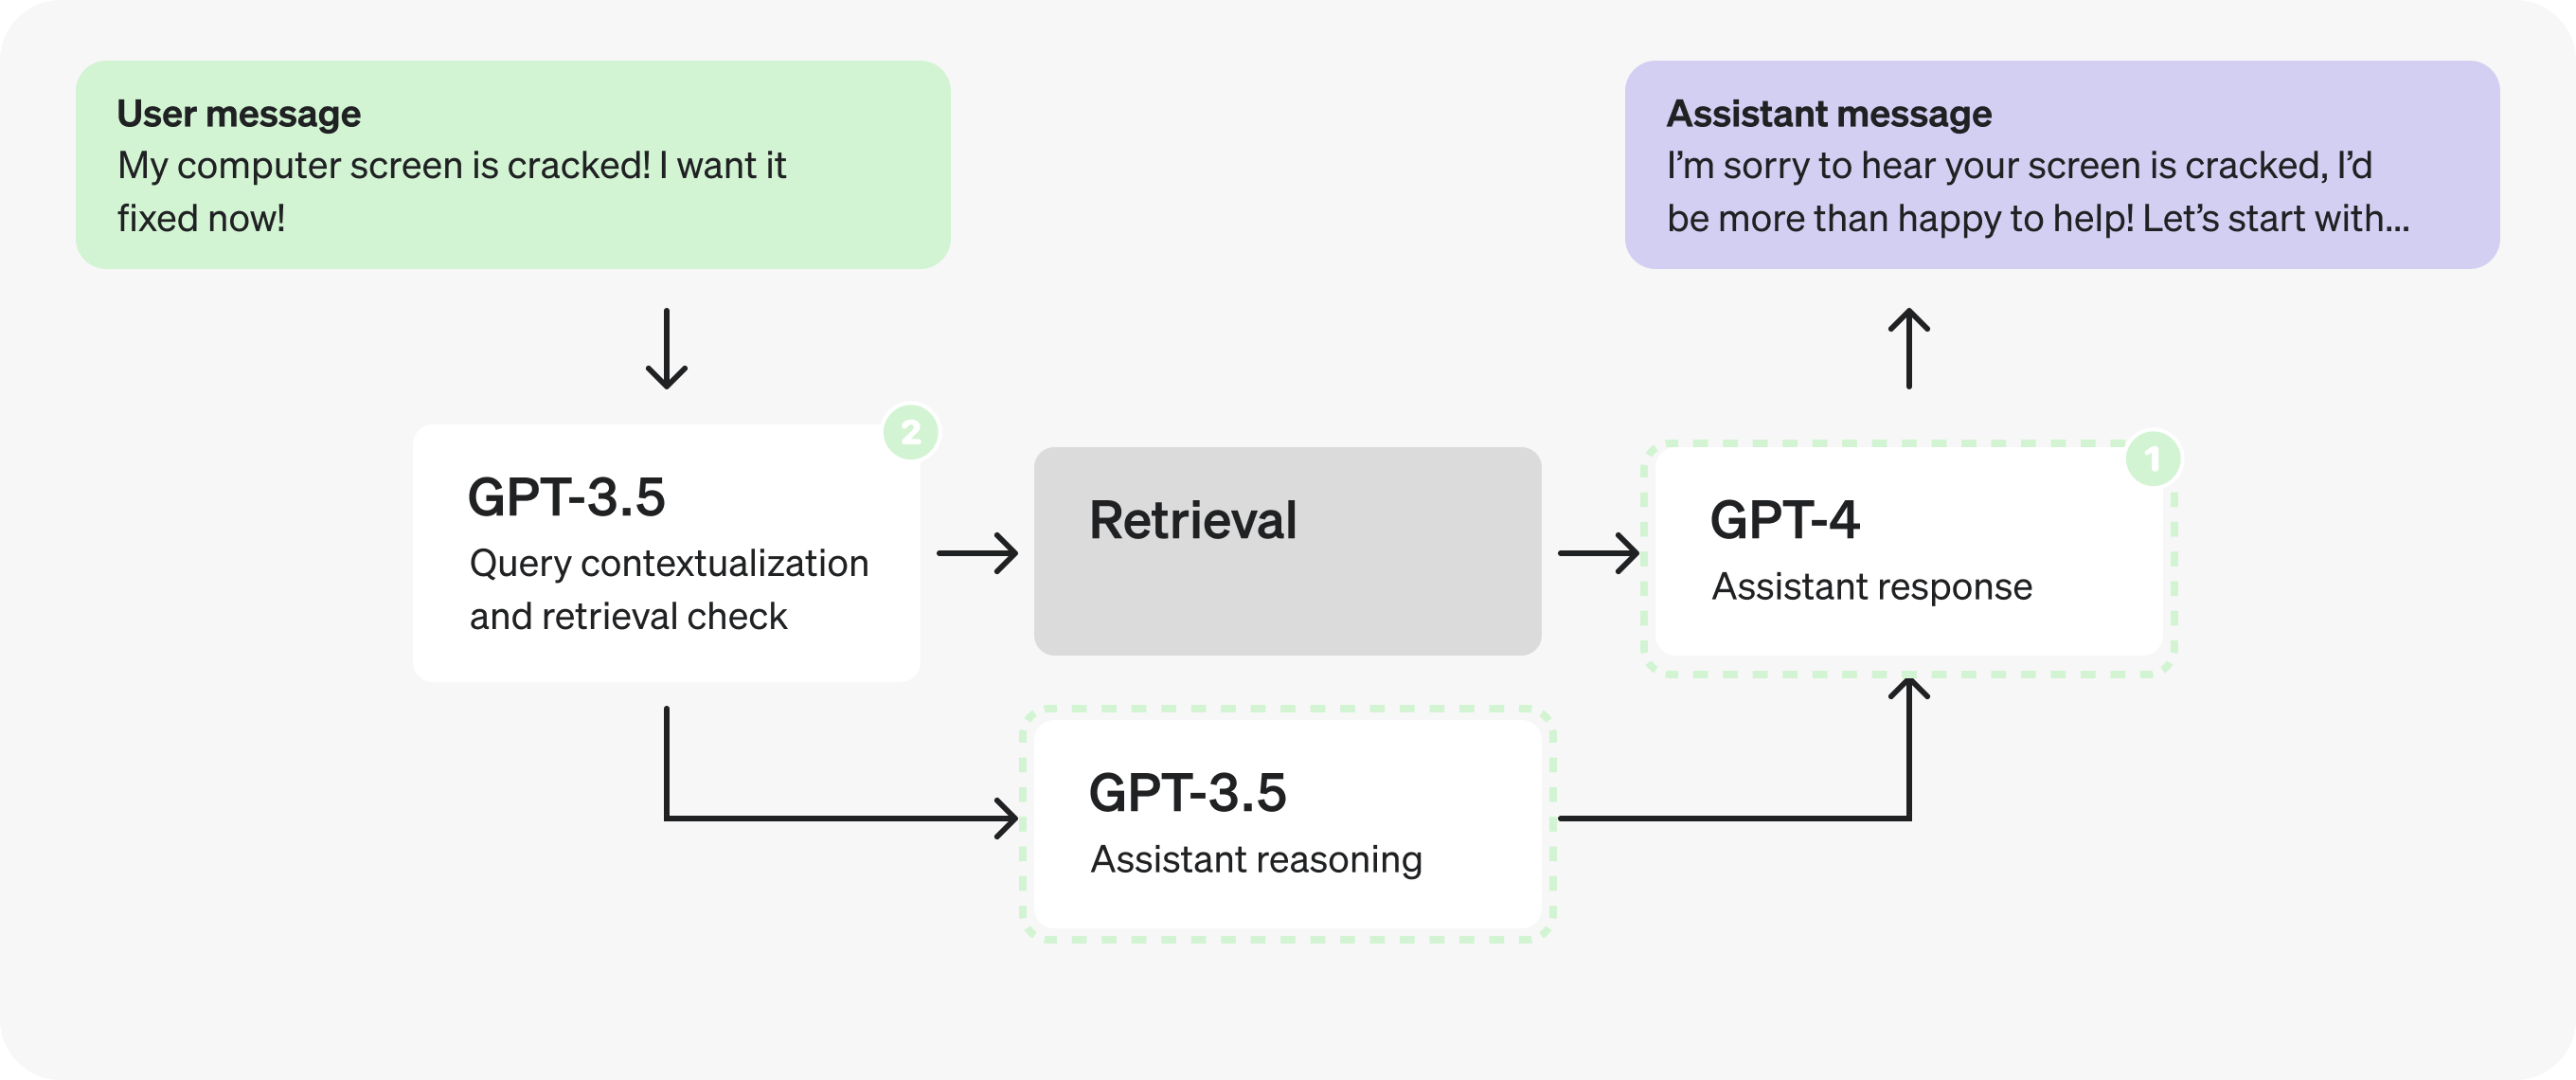
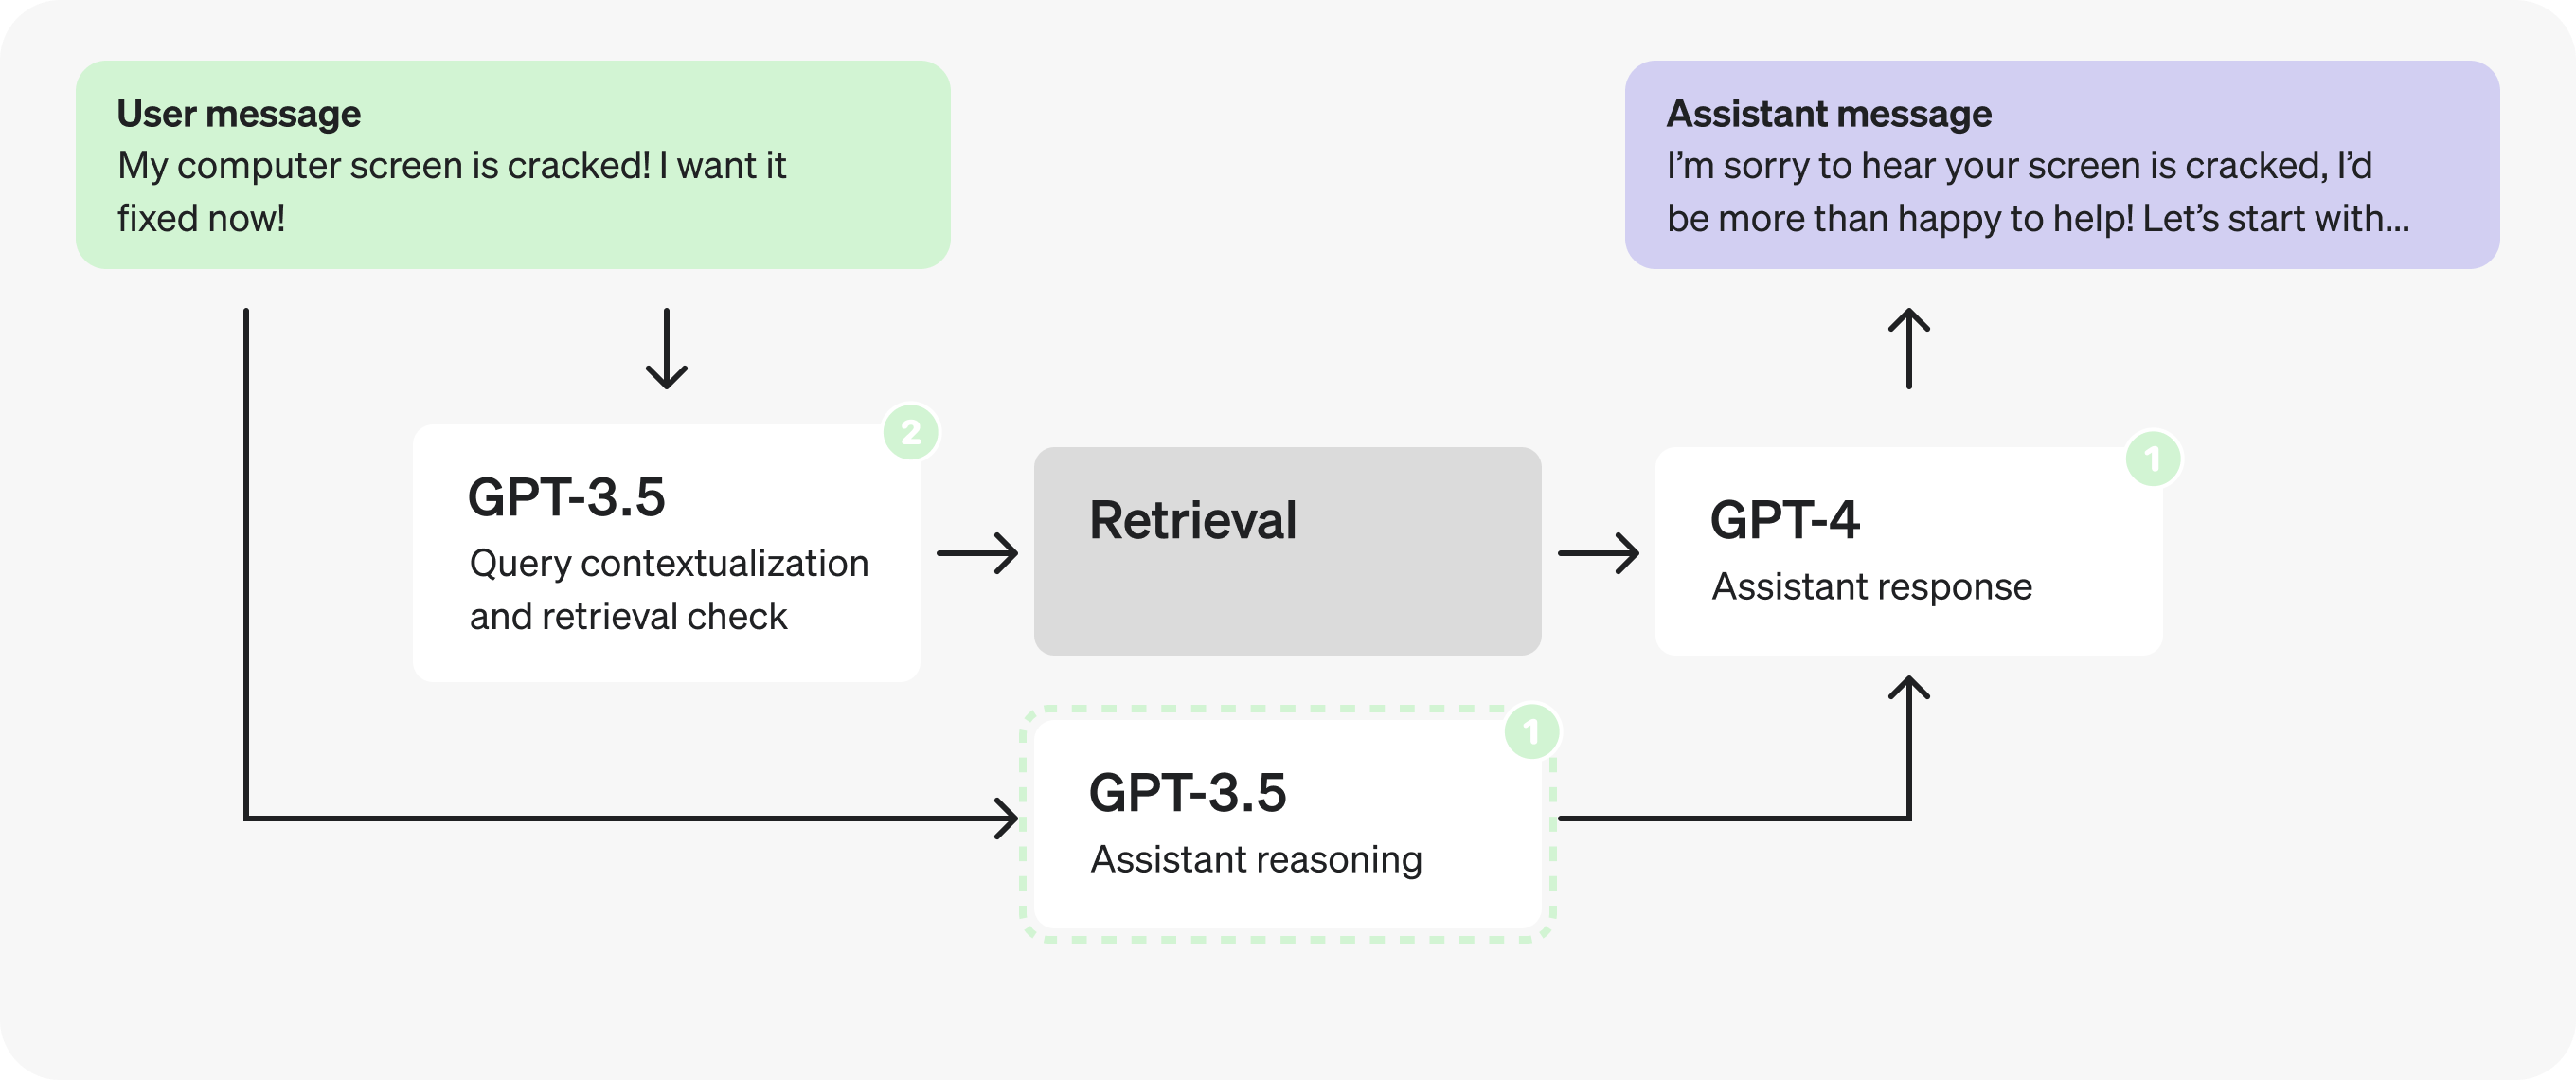
注意: 我们会将 response 和 enough_information_in_context 放在第二个提示中一起处理,以免需要向两个新提示都传入检索到的上下文。
事实上,既然推理提示不再依赖检索到的上下文,我们就可以采用并行处理,同时发出推理提示和检索提示的请求。
第 3 部分:优化结构化输出
让我们再看看推理提示。
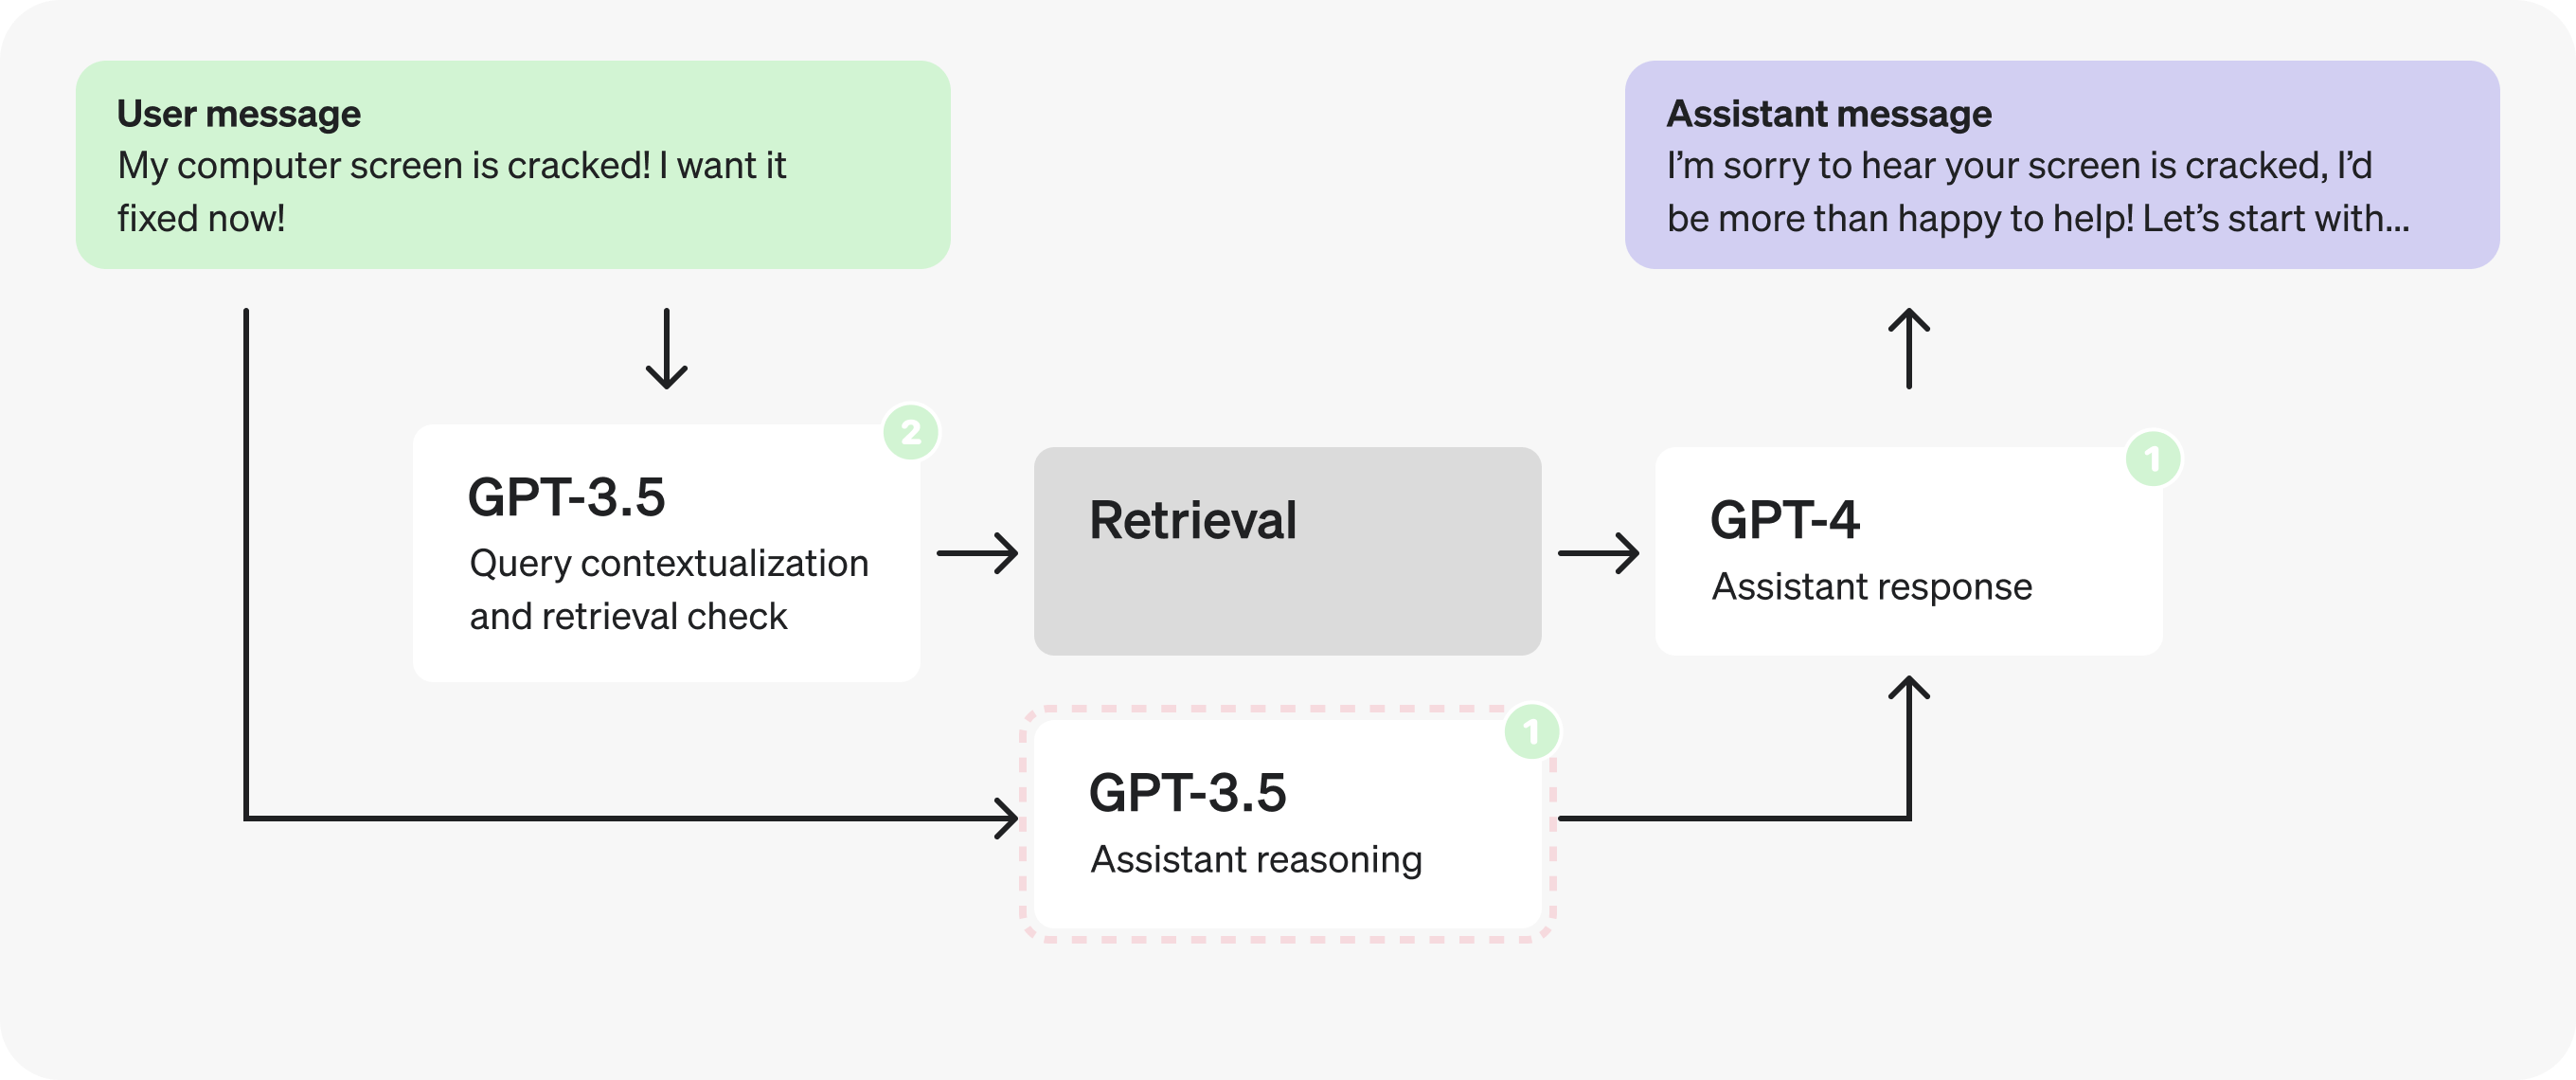
仔细查看推理 JSON,您可能会注意到字段名本身相当长。
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
}缩短字段名,并将说明移至注释中,就可以减少生成的 Token 数量。
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
}
这个小改动减少了 19 个输出 Token。对于 GPT-3.5,这可能只能缩短几毫秒的延迟,而对于 GPT-4,则可能最多缩短一秒。
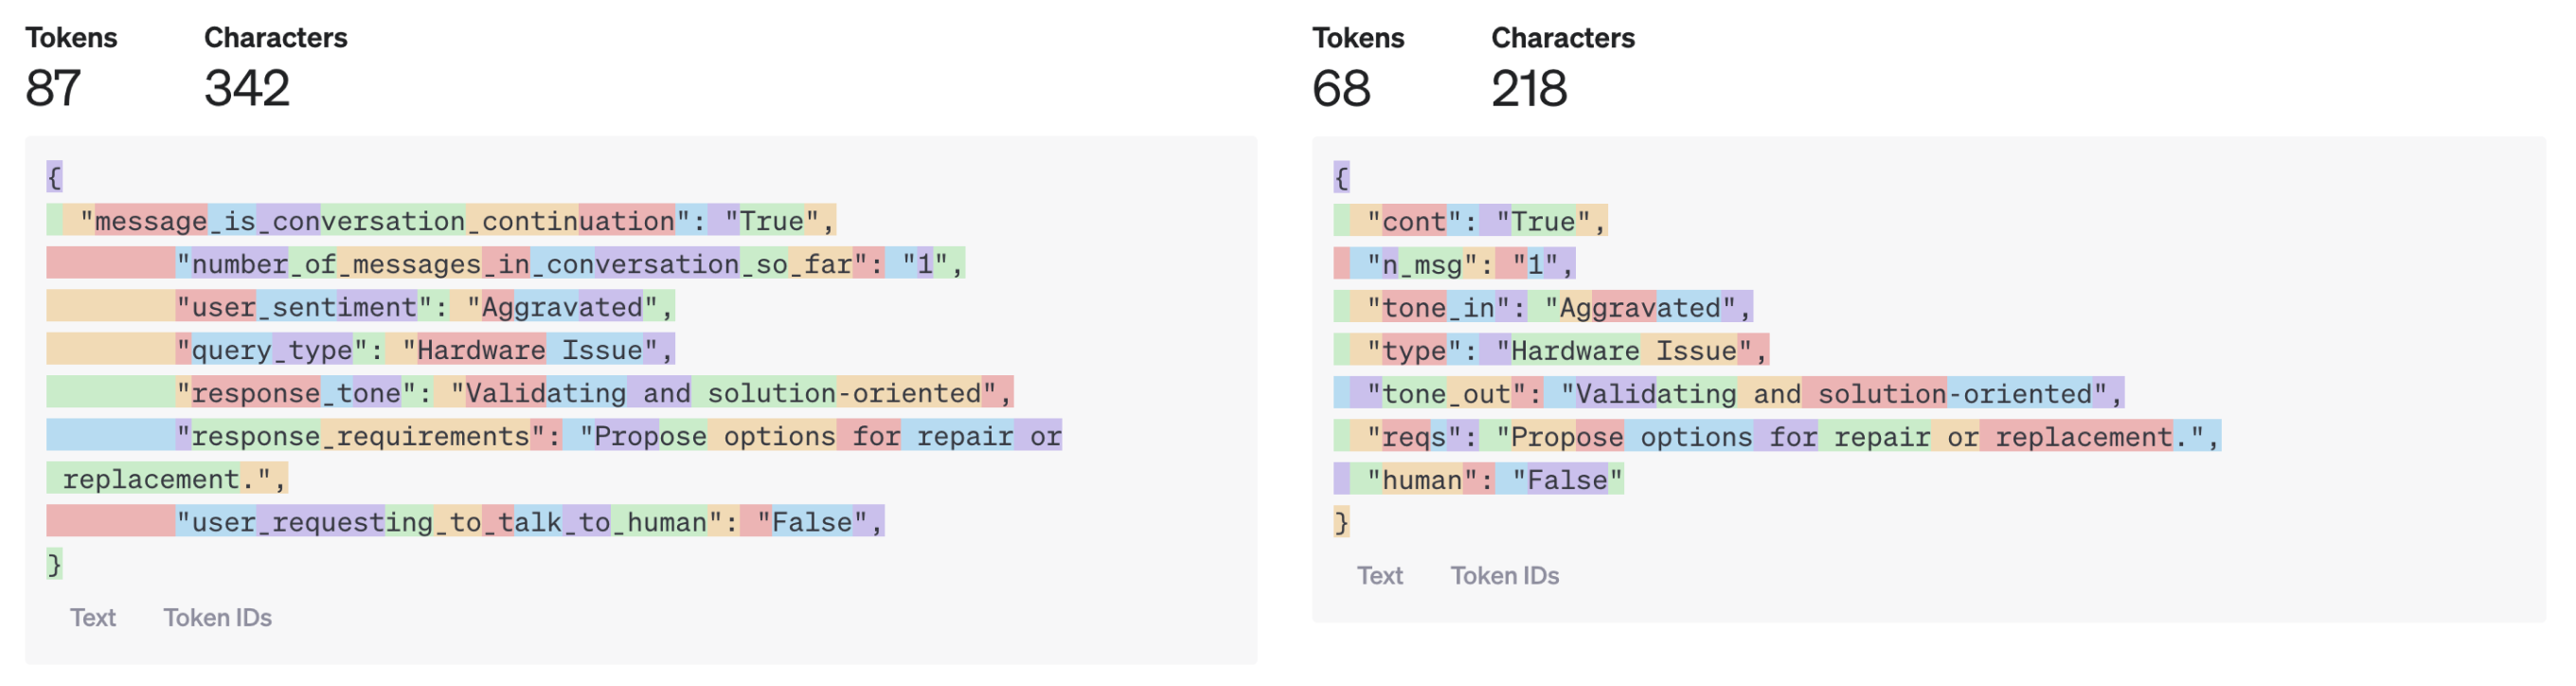
不过,您可以想象,当模型输出更长时,这种改动可能带来相当显著的效果。
我们还可以进一步用单个字符作为 JSON 字段名,或将所有内容放入一个数组中,但这可能会开始影响回复质量。要判断效果如何,最好的方法仍然是测试。
示例总结
让我们回顾一下在客服机器人示例中实施的优化:
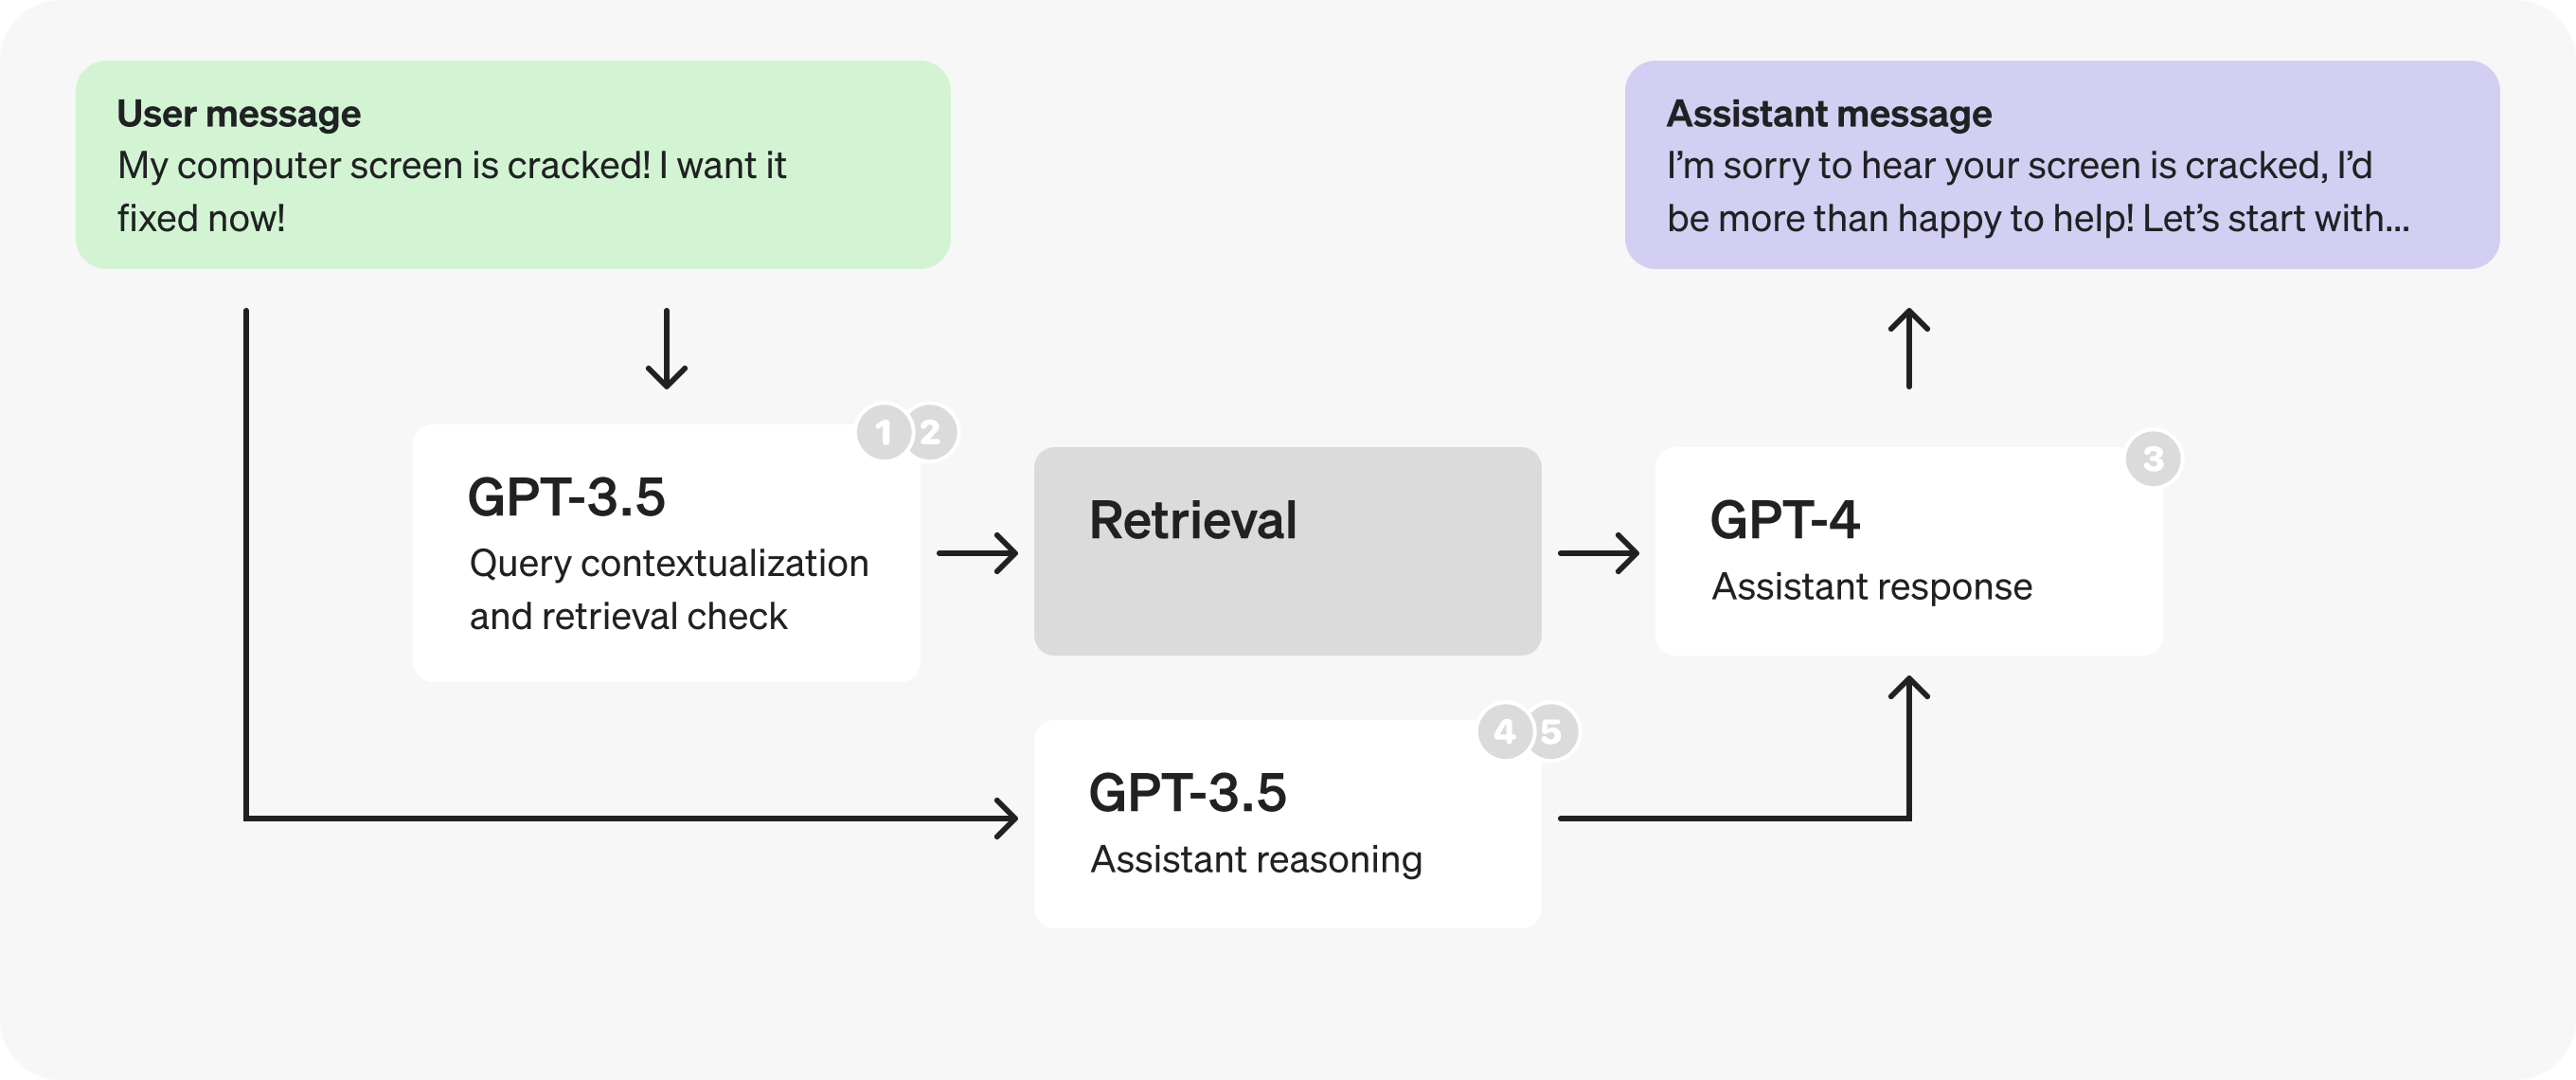
- 合并 查询上下文补全和检索检查步骤,以减少请求次数。
- 针对新提示, 改用规模更小且经过微调的 GPT-3.5 ,以更快地处理 Token。
- 将助手提示拆分为两个提示,并 改用规模更小且经过微调的 GPT-3.5 来完成推理,同样是为了更快地处理 Token。
- 并行执行检索检查和推理步骤。
- 缩短推理字段名 ,并将注释移入提示中,以生成更少的 Token。