
我们构建安全 MCP 隧道,是因为团队最重视的 MCP 服务器,往往也是他们最不愿暴露在互联网上的服务器。
我们想分享如何应对这一约束:让私有服务器保持私有,同时为 ChatGPT、Codex 和其他 OpenAI 产品提供正常的 MCP 请求通路。
模型上下文协议让 AI 系统更容易连接外部工具和数据。但许多最有价值的 MCP 服务器运行在企业网络、私有服务网格、开发者笔记本电脑等环境中,而这些环境本就被设计为拒绝来自公网的入站流量。要将这些服务器连接到托管式 AI 产品,团队往往需要创建公网端点、部署额外的代理基础设施,或在敏感链路中引入新的网络运营方。
安全 MCP 隧道提供了一种更简单的方法: 客户在私有环境中运行一个小型客户端,由它向 OpenAI 建立出站 HTTPS 连接。该客户端会:
- 接收 MCP 请求
- 将请求转发到获准访问的本地服务器
- 通过同一连接返回响应和通知。
OpenAI 产品可以使用标准的 MCP 请求和响应模型,而底层服务器仍受客户现有网络控制措施的保护。
要让这一机制可靠、安全地运行,就必须同时解决几个工程问题:保留服务器的私有网络边界、支持 MCP 的流式传输和身份验证流程,以及为团队提供能够自行检查和运维的客户端。本文将逐一介绍这些设计决策。
我们围绕几项原则设计了这一隧道:仅建立出站连接、明确配置目标、兼容 MCP 流式传输和通知,以及由客户运行客户端,让团队能够自行检查和运维。
这些设计共同让私有工具和数据能够轻松接入 OpenAI 产品,无须将私有 MCP 服务器变成公开服务。
不合适的默认方案
如今,团队通常通过三种方式之一让私有服务可访问:暴露公网端点、运行第三方隧道,或通过 VPN 或对等连接扩展网络。
- 公网端点让访问变得简单,代价却是削弱网络边界。
- 第三方隧道提供商可以迅速让私有服务器可访问,但也在连接链路中增加了一家供应商,需要团队对其进行审查、签约、运维并给予信任。对企业团队来说,这并非小事:一个原本旨在让私有工具保持私有的系统,现在必须将隧道提供商纳入安全审查、采购流程、运维手册和元数据暴露范围。
- VPN 和网络对等连接通过建立广泛的网络互通来解决可访问性问题,但对于范围有限的 MCP 集成而言,这套机制往往过于繁重。
安全 MCP 隧道采用了更有针对性的方法。它不要求客户迁移 MCP 服务器、扩大网络边界或引入另一家连接服务供应商,而是在私有服务器旁部署一个小型、可供检查的开源客户端,由该客户端发起并控制与 OpenAI 的连接。
安全 MCP 隧道反转了建立连接的方向:由私有环境这一侧先发起连接。OpenAI 产品向 OpenAI 托管的隧道端点发送 MCP 请求。隧道服务将任务排入特定隧道的队列,已在私有 MCP 服务器旁运行的客户侧客户端通过出站 HTTPS 连接获取任务。客户端在本地转发请求,再沿同一路径返回响应。
这样,OpenAI 产品就有了一条正常的 MCP 请求通路,既无须私有服务器接收来自公网的入站流量,也无须建立更广泛的网络互通。
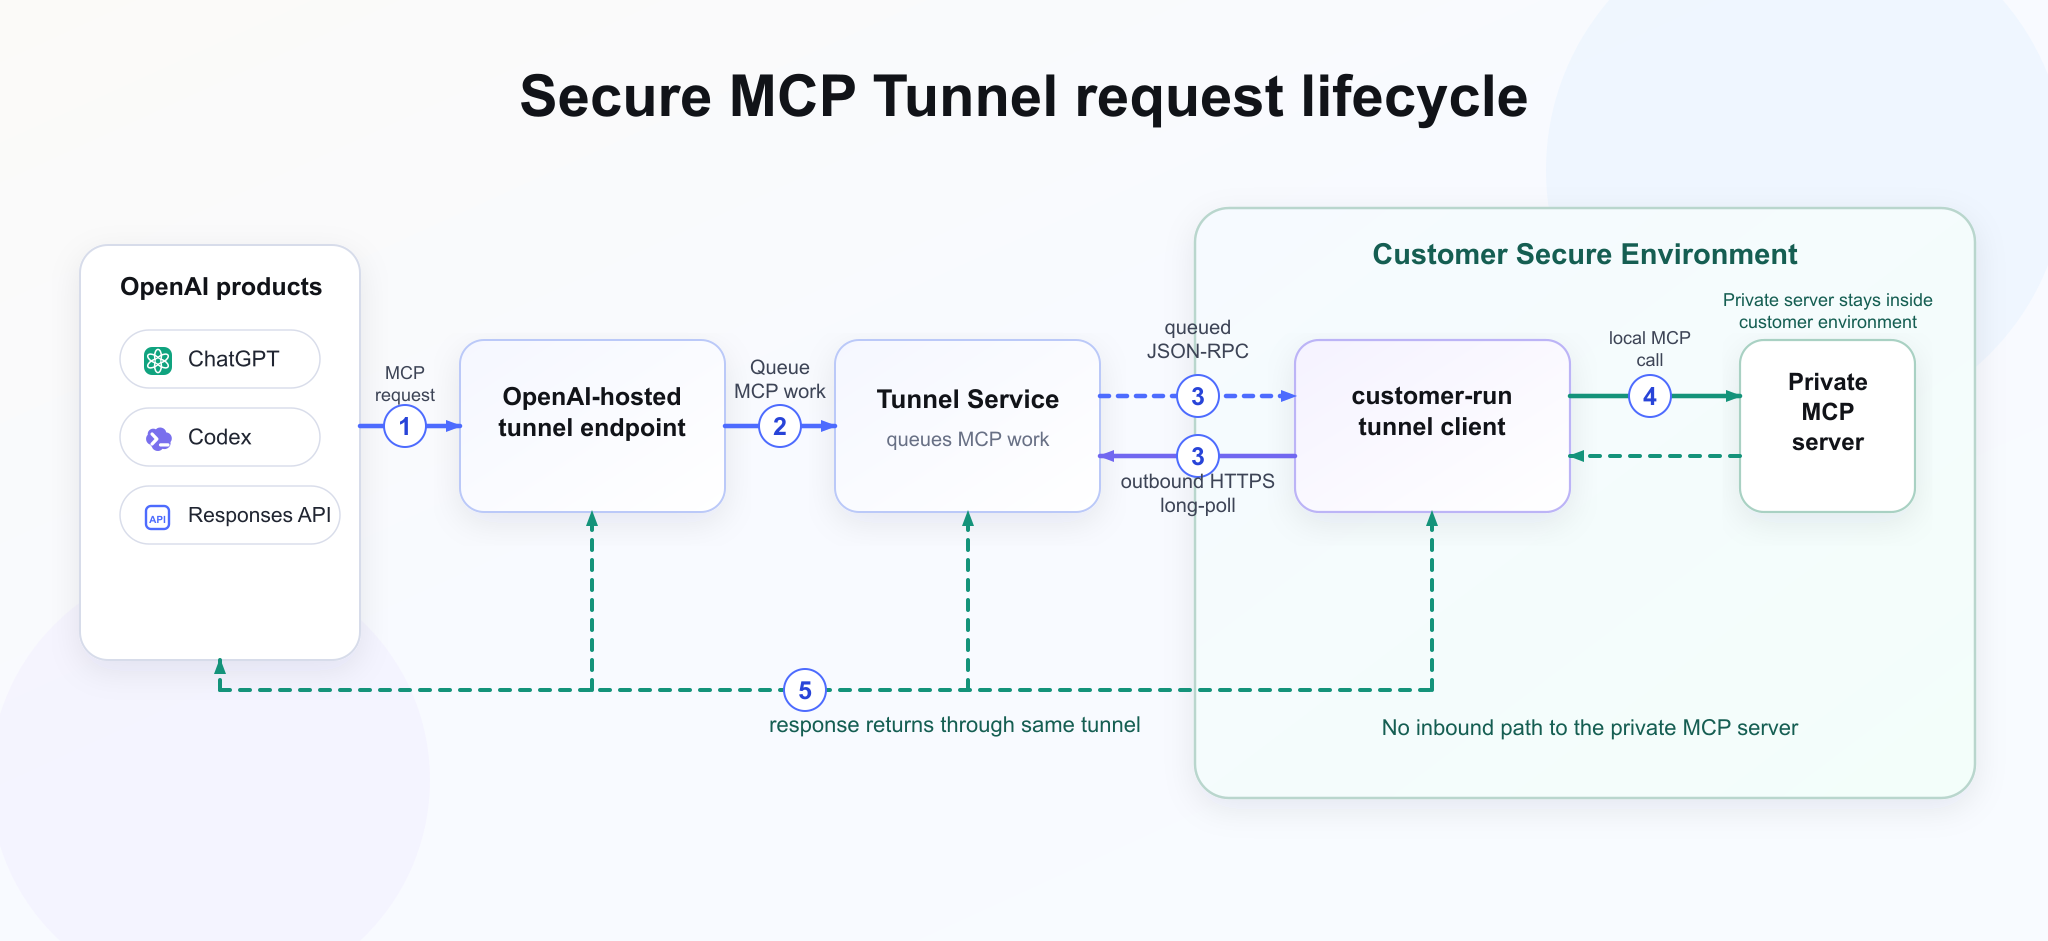
图 1。安全 MCP 隧道请求生命周期。
为什么从长轮询开始?
我们有意从一种运维上成熟平稳的传输方式入手。企业防火墙和代理环境已普遍支持出站 HTTPS,平台团队也早已熟悉这种连接方式。长轮询让隧道客户端只按自身处理能力请求相应数量的任务,从而为客户端队列提供天然的背压控制点,而不会促使缓冲区无限增长。
这一选择也让最终交付的运行机制易于理解:
- 产品向 OpenAI 托管的端点发送 MCP JSON-RPC 请求。
- 隧道服务保持该请求,或以流式方式传输,直到客户运行的客户端返回最终响应
- 当请求要求以流式方式返回结果时,隧道可以转发中间的服务器发送事件。
这样,产品就能使用正常的 MCP 请求/响应通路,而 MCP 服务器及其地址仍保持私有。请求、响应和中间事件均通过 OpenAI 托管的隧道端点中继。
保持清晰的安全边界
隧道的作用不是消除网络边界,而是让边界更加明确。客户运行的隧道客户端向隧道控制平面进行身份验证,产品侧使用 OpenAI 托管的隧道端点,私有 MCP 地址则仅在客户环境内部使用。隧道访问与客户现有的 OpenAI 组织、工作空间上下文及配置的隧道身份绑定,而不会成为一条具有独立访问模型的网络通路。
这一设计不仅取决于选对网络连接方向。由于隧道客户端运行在客户环境内部,其行为必须可供检查,且范围应有意保持有限:客户应当能够了解正在运行哪些代码、建立了什么出站通路,以及允许访问哪些私有服务。
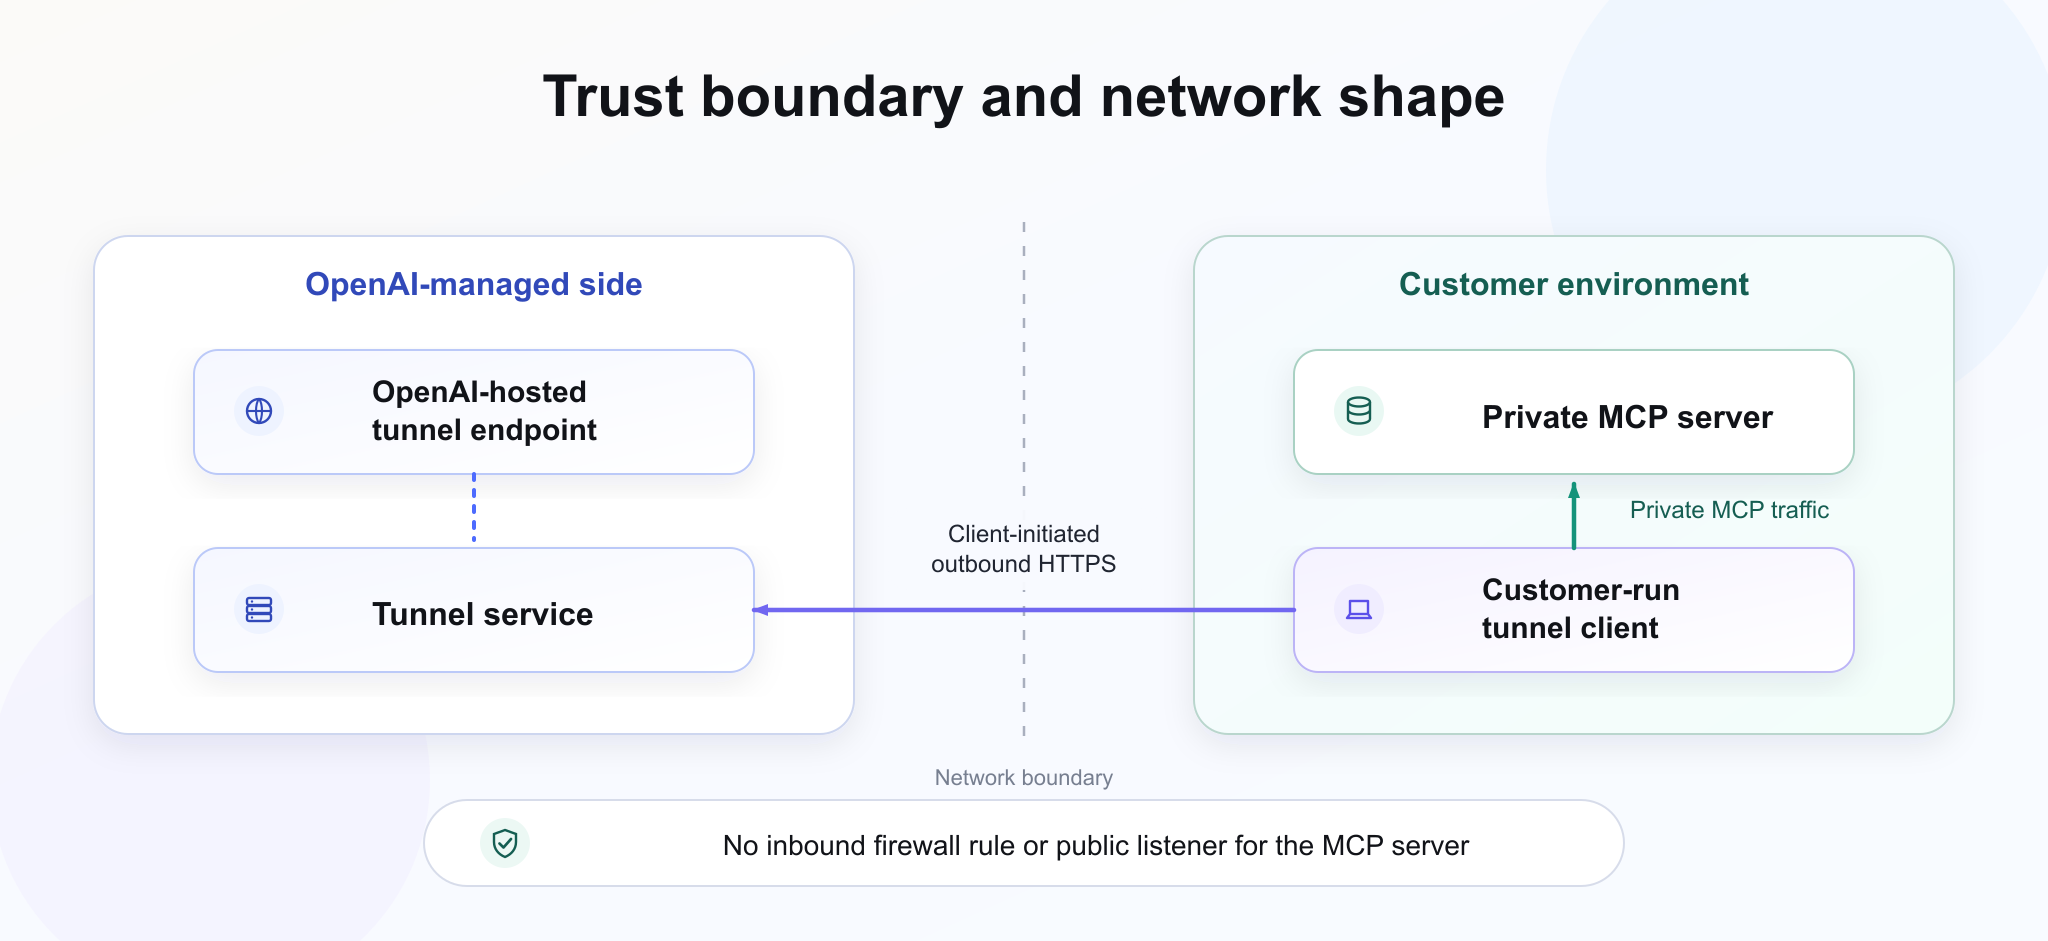
图 2。MCP 服务器始终位于客户的网络边界内。
让 MCP 开发拥有本地开发体验
我们希望隧道客户端用起来像一个开发者工具,而不是一项网络工程。开发者应当能够在笔记本电脑上运行 MCP 服务器,在其旁边启动隧道客户端,再将该服务器连接到 ChatGPT 或 Codex,无须创建公网端点,也无须等待 VPN、防火墙规则或对等连接的变更。
当服务器从笔记本电脑迁移到 Kubernetes、虚拟机或其他由客户控制的环境时,同一流程也应继续适用。关键在于,理解和使用它的方式保持不变:在私有 MCP 服务器附近运行客户端,验证客户端能够访问服务器,再由客户端发起面向 OpenAI 的连接。健康检查、就绪状态、日志和本地管理界面,是为了在出现问题时帮助检查这一流程,而不是把隧道变成一项运维工程。
这一开发者体验也延伸到了 Codex 本身。隧道客户端包含一个 Codex 插件,将设置过程转化为有引导的工作流程,而不要求开发者事先了解 tunnel-client 的每个标志、配置方案和控制平面细节。目标并不是提供一个仅供本地临时使用的捷径:当服务器从笔记本电脑迁移到 Kubernetes、虚拟机或其他生产环境时,团队应能沿用插件生成的同一配置结构。
tunnel-client 随附的助手工作流程也体现了同样的理念:助手可以读取 tunnel-client 提供的本地隧道上下文,因此能根据实际设置帮助开发者分析,而不只是给出通用说明。这些上下文包括当前启用的配置方案、已生成的配置、本地 MCP 服务器是否可访问,以及隧道客户端处于启动流程的哪个阶段。 这样,故障排除就融入了开发流程,而不是一条独立的升级求助流程。
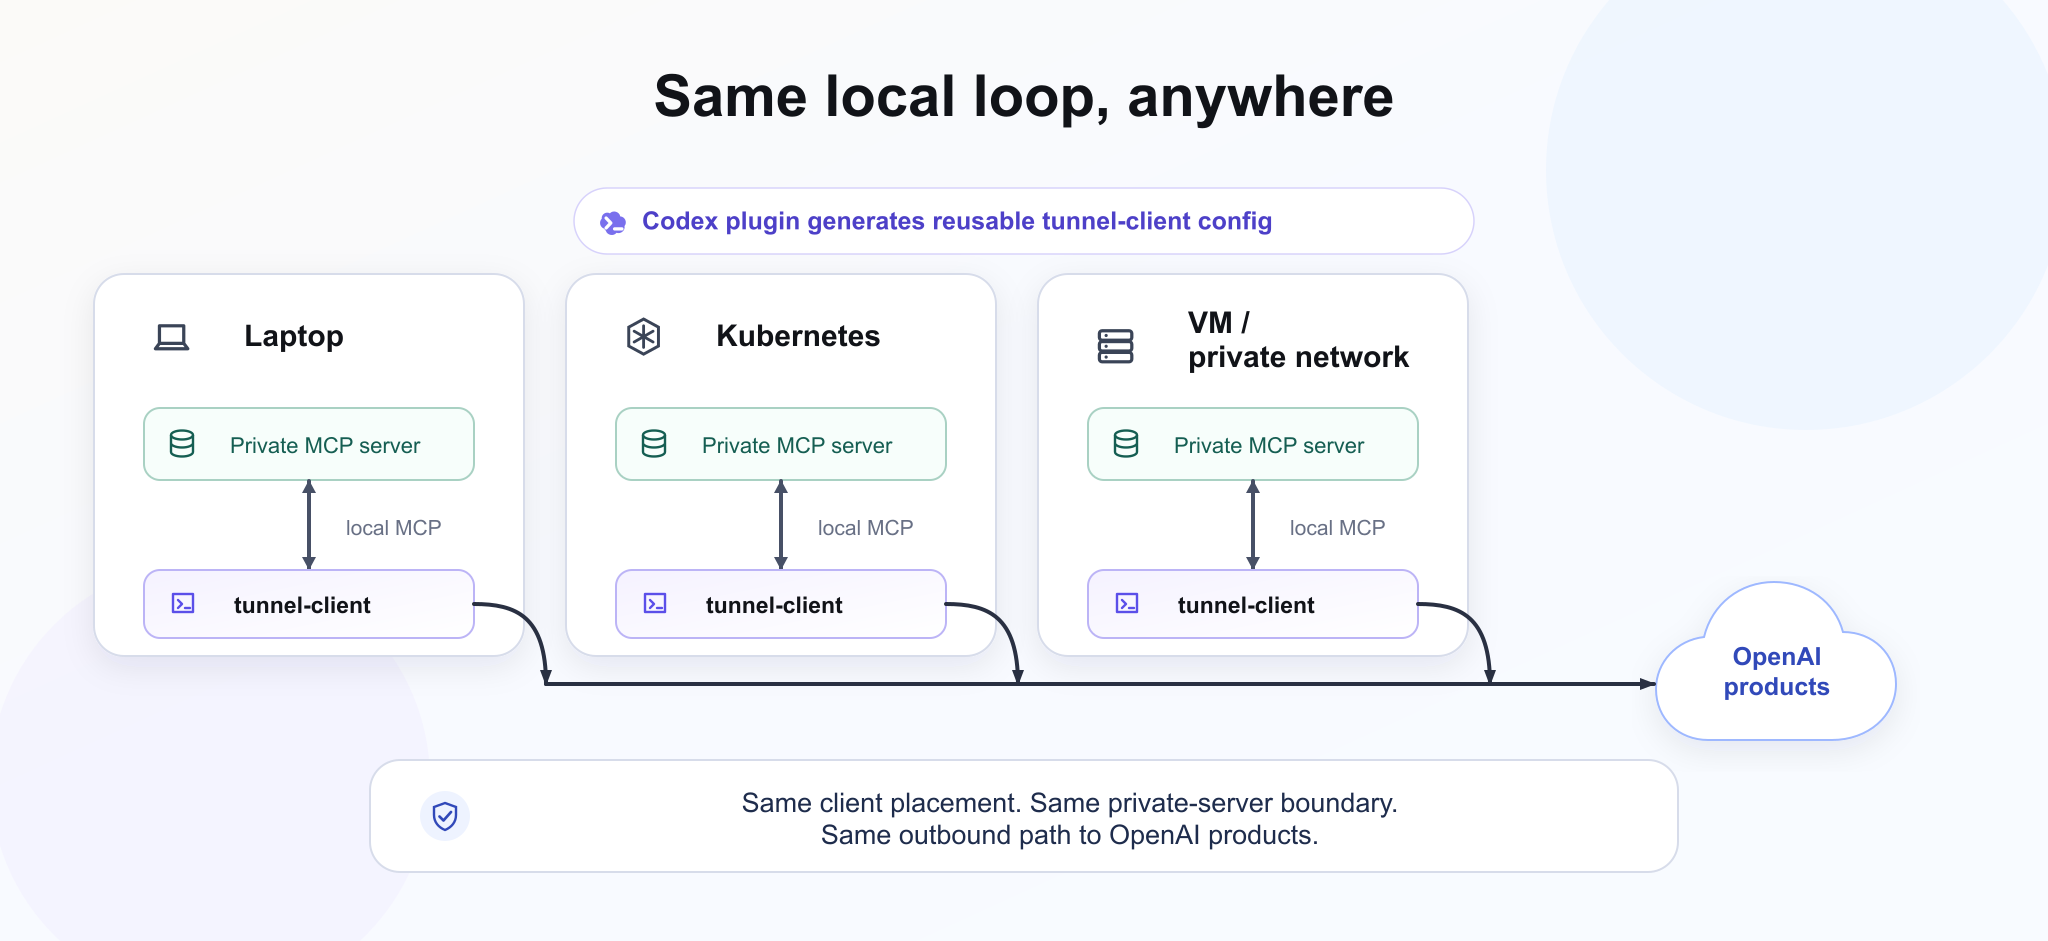
图 3。从笔记本电脑到生产环境,同一套 tunnel-client 工作流程都适用。
为什么隧道客户端开源很重要
隧道客户端是由客户运行的开源软件,部署在客户的网络边界内,与私有 MCP 服务器相邻。这让客户和安全审查人员能够检查在其环境中运行的代码。他们可以检查客户端执行哪些操作、建立什么出站连接、如何在本地转发 MCP 请求,以及哪些配置控制其访问范围。
这种透明度让信任模型与架构保持一致:OpenAI 托管隧道服务,而在客户环境中运行的代码规模小、可供审查,并由客户掌控。
支持企业身份验证,无须广泛的网络访问权限
私有 MCP 服务器很少只是允许匿名访问的内部 HTTP 端点。它们可能依赖 OAuth、私有证书颁发机构、出站代理,或连接 MCP 服务器这一跳所需的客户端证书。要支持这些服务器,就必须将企业网络的既有条件纳入隧道设计,而不能将它们视为需要客户自行绕过的例外情况。
关键约束是 MCP 服务器仍然保持私有。MCP 服务器的 OAuth 发现流程通过隧道进行,因此托管产品可以了解如何进行身份验证,而无须 MCP 服务器在公网上监听。在客户侧,隧道客户端可以根据本地环境进行配置,包括自定义 CA 证书包、代理设置和 MCP 侧的 mTLS。
我们也保持了明确的边界。隧道不会自动让 OpenAI 能够访问所有相关的企业端点。如果授权服务器是私有的,执行 OAuth 流程的组件仍必须能够访问它。这一边界是有意设定的:安全 MCP 隧道为已配置的私有工具提供范围有限的通路,而不是通用网络桥梁。
不止于 MCP
MCP 是模型工具的主要接入形式,但与客户开展的早期 Alpha 测试也揭示了一个密切相关的问题:并非客户的每个私有工作流都已封装为 MCP 服务器。有些重要工作流是位于同一防火墙边界内的现有 REST API。如果安全 MCP 隧道只解决 MCP 的可访问性问题,团队仍需为这些相关的私有 API 单独建立公网端点、引入隧道提供商、配置 VPN 通路,或开展对等连接项目。
Harpoon 将同样的有限连接模型扩展到了获准访问的 REST 目标。客户在隧道客户端上注册带标签的目标,而不是暴露任意 URL。OpenAI 侧的调用方通过安全 MCP 隧道调用这些标签,而实际的 HTTP 请求仍从客户环境内部、私有服务附近发起。
关键约束在于,标签并不是通用网络桥梁。调用始终受到客户管理的目标注册、允许使用的方法、响应大小限制、超时、重定向行为和隧道访问控制的约束。这样,获准运行的 OpenAI 工作流就能通过受控通路访问客户的私有 API,而无须客户开放入站网络访问,也无须赋予 OpenAI 类似 VPN 的网络身份。