
在 Alpic,我们相信,下一代产品和服务将围绕 以 AI 为核心的体验构建。在这样的界面中,用户与模型协作,而不是按照传统的、预先设定的 UI 工作流操作。
OpenAI 发布 Apps SDK 后,我们立即开始用它开发。在三个月内,我们开发了 24 个 ChatGPT 应用,既供内部使用,也服务于 旅游、零售和 SaaS 等 B2B 和 B2C 领域的客户。
我们很早就发现, 构建 ChatGPT 应用与构建传统的网页或移动应用有着根本区别。在网页开发中行之有效的模式,例如即时获取数据、由 UI 驱动状态、让用户显式配置等,在智能体环境中往往会失效,甚至损害体验。
本文提炼了我们在开发实际使用的 ChatGPT 应用时积累的 15 条最重要的经验 ,并介绍我们如何将这些经验融入面向社区的开源框架 Skybridge 和一项 Codex 技能,帮助开发者显著加快应用的构思、构建、测试和发布。
三体问题
在传统网页应用中,情况很简单:只有 用户 和 UI 两方。而在 ChatGPT 应用中,系统引入了第三方: 模型。
为 ChatGPT 开发应用时,最棘手的问题之一就是管理信息在这三方之间的流动。如果用户点击了您小组件中的“选择”按钮,UI 会发生可见的变化,但作为对话大脑的模型却对此毫不知情,除非您明确将这些上下文传递给它。如果用户接着说: “请详细介绍一下这款商品。” 模型根本不知道用户正在看什么。
我们将这种情况称为 上下文不对称 :每一方只掌握系统的部分信息,没有任何一方了解全貌。构建出色的 ChatGPT 应用,并不在于让一切始终同步,而在于决定应该共享 哪些 信息、 何时 共享,以及 谁 需要了解这些信息。能否解决这个问题,决定了应用是生硬难用,还是能提供流畅的智能体体验。
1. 并非所有上下文都应共享
我们最初的直觉是“把所有信息共享给所有地方就好”。结果,这成了我们最早犯下的错误之一。
在实际开发中,ChatGPT App 的不同部分往往需要看到同一状态的不同信息,而且这种差异是 有意设计的 。这是为什么?
- 出于性能考虑: UI 小组件需要的数据往往远多于模型所需。例如,旅游预订应用可能需要图片、不同价格方案和预加载的选项。将这些数据全部发送给模型,会增加 Token 用量、延迟和理解信息时的干扰。
- 出于逻辑需要: 某些信息必须在设计上保持不对称。在我们最早开发的一款应用,也就是推理游戏 Murder in the Valleys 中,模型需要知道凶手是谁,才能正确扮演角色,而 UI 和用户都不能知道。在 Time’s Up 这类游戏中,情况恰好相反:UI 向用户展示待猜词,但模型必须对此毫不知情。
我们学到的不是“始终同步所有信息”,而是: 明确决定谁需要知道什么。我们通过不同的 工具输出 字段,将这一原则落实下来:
| 字段 | 用途 | 可见对象 |
|---|---|---|
| structuredContent | 供小组件和模型使用的带类型数据 | 小组件和模型均可见(通过 toolOutput 和 callTool 函数) |
| _meta | 响应元数据 | 仅小组件可见,对模型隐藏 |
例如,在 Time’s Up 游戏中,我们通过 _meta 字段将待猜词仅传给小组件,让模型根据用户的提示来猜词。
2. 懒加载不太适合 AI 应用
由于有网页开发背景,我们习惯采用懒加载:用户点击时才获取数据,按需加载详情,并尽量减少首次加载的数据量。
但在 ChatGPT 中,思路恰好相反:工具调用会带来延迟,安全沙盒和模型推理往往会使一次调用耗时数秒。
在实践中,我们学会了尽可能提前加载数据:在首次工具响应中发送尽量多的数据,并通过 window.openai.toolOutput 将数据填充到小组件中。这种做法几乎总能带来更快、更灵敏的体验。
当然,如果小组件可以安全地从公开 API 端点获取数据,而且不需要与模型共享信息,您随时可以在小组件内使用传统的 XHR 调用。但大多数时候,您会希望模型能够自主调用工具,让整个体验保持对话式交互。
3. 模型需要了解界面状态
当用户与小组件交互(例如在列表中选择某款商品),然后在聊天中提问时,就会出现一个不易察觉却很关键的问题:如果模型不知道用户指的是 UI 的哪一部分,就无法正确回答。
为此,我们使用了 window.openai.setWidgetState(state)。它允许您存储特定的状态数据,并在用户下一次与模型交互时将这些数据加入模型的上下文。
随着应用日益复杂,我们发现,为了让模型跟上用户的导航操作,我们在很多地方都添加了 setWidgetState。于是,我们决定引入一种描述 UI 上下文的声明式方法:不再在每次交互时以命令式方式向模型更新信息,而是直接为组件附加 data-llm 属性:
<div
  data-llm={
    selectedTab === "details"
      ? "User is viewing product details"
      : "User is viewing reviews"
  }
>
为了让这套机制在后台运行,我们构建了一个 Vite 插件,用来提取这些属性并自动更新 widgetState。对模型来说,它只需在合适的时机接收相关的 UI 上下文,开发者无需再手动同步每一次交互。
我们创建了一个开源框架,用于向社区分享这些经验。您可以在其中找到这个 Vite 插件,以及本文介绍的许多其他技巧。
4. 不同的交互需要不同的 API
ChatGPT 应用在小组件、服务器和模型之间有多条交互路径。这些路径不能互相替代:每条路径都用于支持不同类型的交互。
构建 ChatGPT 应用的一条关键经验是:明确这些通信路径,并有意识地决定由哪种机制负责体验的哪一部分。
将这些路径画成图,大致如下:
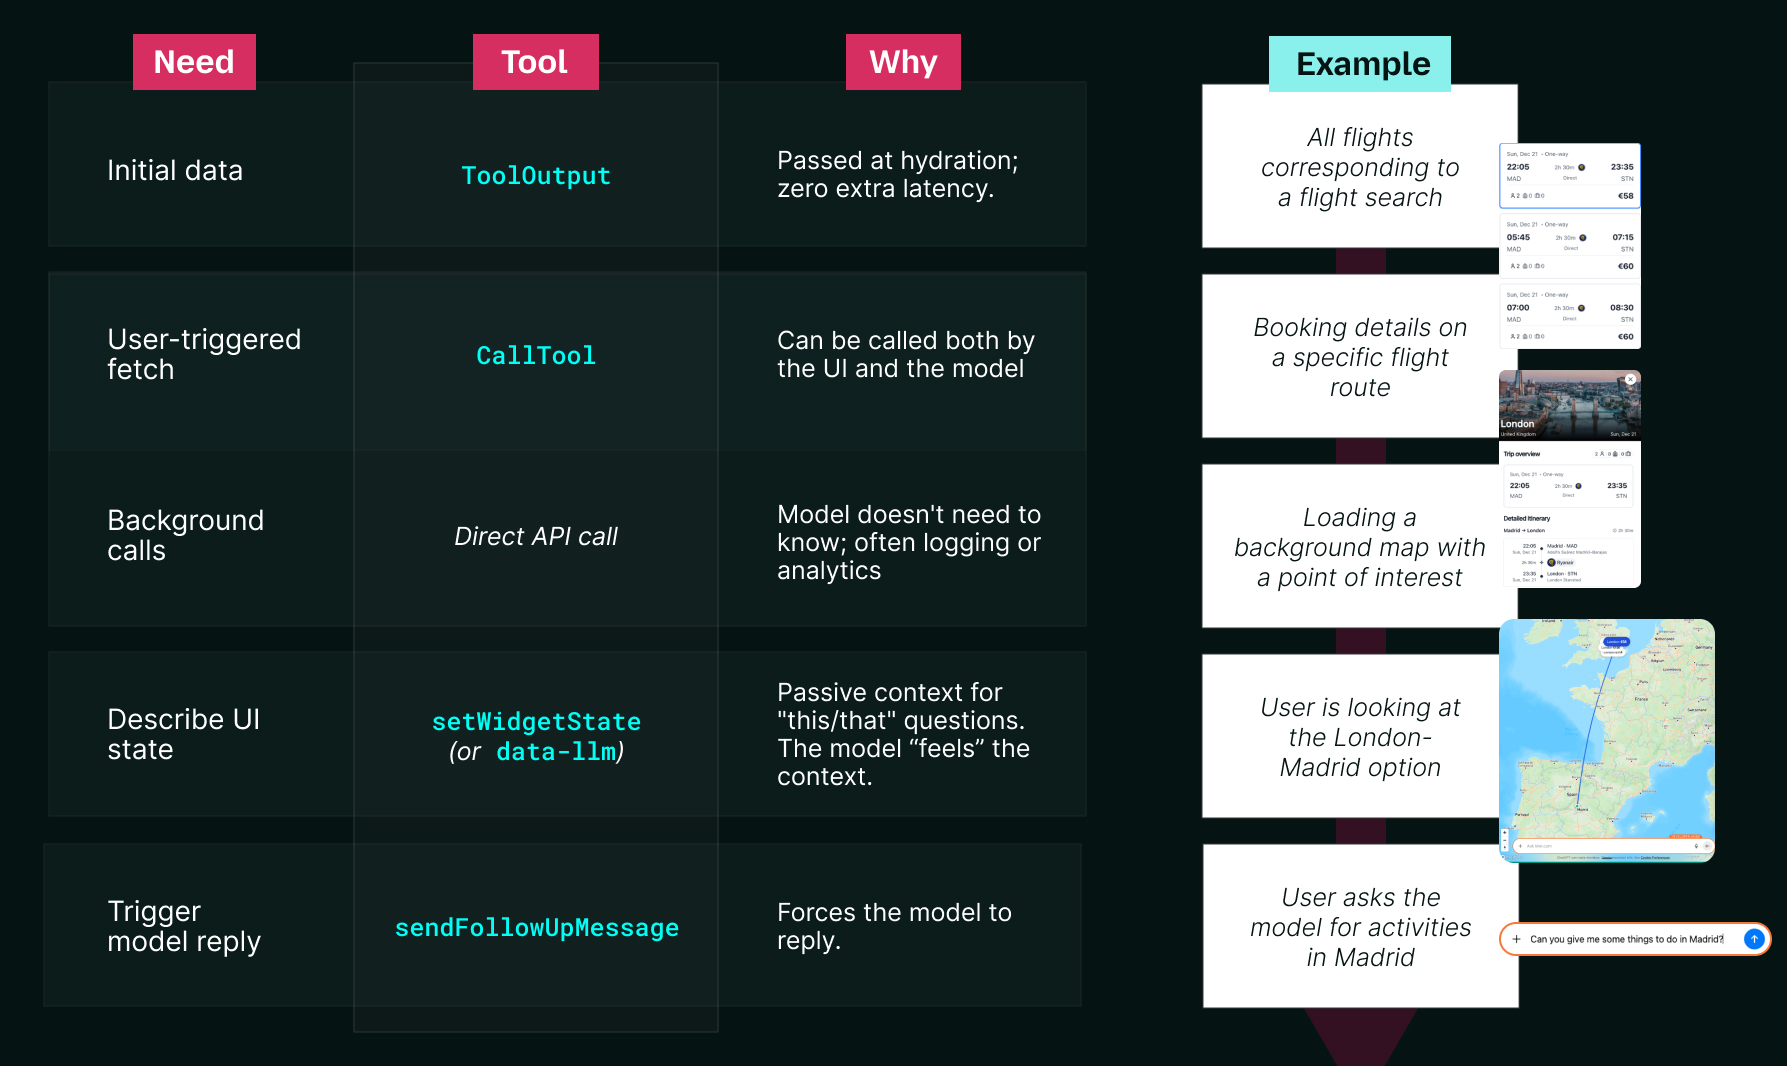
这些经验奠定了 ChatGPT App 的基础:如何共享上下文、如何让模型了解界面状态,以及不同的交互如何在系统中传递。下一节将在此基础上,重点讨论这些机制对 UI 设计的影响。
为 AI 重新设计 UI
ChatGPT 应用是一个全新的环境,因此我们很快学会了放下对 UI 的固有观念,充分运用新能力。本节介绍为了打造有效的应用,我们需要学习哪些界面设计理念,又需要放下哪些旧观念。
5. UI 必须适应多种显示模式及其限制
ChatGPT 应用并不局限于一种布局。根据调用方式和时机的不同,同一个小组件可以采用三种不同的显示模式。
应用可以 内嵌 在对话中,以 画中画(PiP) 形式悬浮在对话上方,或在需要更多空间时以 全屏 模式显示。画中画和全屏模式能够呈现更丰富的界面,但也会引入不受小组件控制的 UI 叠加层。要避免内容被裁切并优化交互,就必须考虑不同设备的安全区域,例如移动端始终显示的关闭按钮所占的区域。
随着经验积累,我们总结出了各显示模式的特点和适用场景:
| 显示效果 | 适用场景 | |
|---|---|---|
| 内嵌 | 默认显示模式。小组件保留在对话历史记录中。 | 适合快速交互 |
| 全屏 | 小组件占据整个屏幕,聊天栏位于底部。 | 适合复杂且需要较大空间的小组件(例如地图) |
| 画中画 | 大小与内嵌模式相同,但小组件会始终悬浮在对话上方 | 适合生成后仍与后续对话相关的小组件 |
6. 在嵌入式环境中,UI 一致性很重要
早期,我们曾拿不准 ChatGPT App 的视觉设计应该有多大的自由度。作为用户接触的新界面,它既需要在我们自己的应用之间保持一致,也需要与周围的 ChatGPT 生态协调,让用户感到熟悉。与独立产品不同,小组件嵌入在现有界面中,任何视觉上的不一致都会立刻显现。
幸运的是,OpenAI Apps SDK UI Kit 为我们提供了明确的设计基准。
它基于 Tailwind CSS 构建,提供符合 ChatGPT 设计系统的现成组件、图标和设计 Token。使用这套工具包让我们能够快速开发,同时确保小组件具有原生体验,并与周围界面在视觉上保持一致,即使构建自定义组件时也是如此,例如用于集成 Mapbox 的组件。
7. 优先用自然语言筛选
传统仪表盘依赖布满复选框和范围滑块的侧边栏。在智能体 UI 中,这种设计往往是一种倒退。当用户可以直接用自然语言表达意图,例如“预算低于 200 美元、阳光充足的欧洲目的地”时,强迫他们操作多个 UI 控件只会增加使用阻力。他们应该只需说出需求。
因此,我们决定让大多数应用采用“无筛选控件”的设计。我们不再提供带有筛选和排序选项的侧边栏,而是向模型提供工具参数的 值列表(LOV) 。
这样,模型就能直接以用户的消息作为输入,无需“猜测”有哪些可用选项。换句话说,它可以将自然语言直接映射为符合后端 API 要求的参数。如果用户说“晴天”,模型就知道应使用 weather="sunny" 调用工具。
8. 文件可以带来更丰富的交互
随着我们构建的应用越来越复杂,一条经验逐渐清晰:不应将文件视为次要输入。在 ChatGPT 应用中,文件可以带来新的交互方式。交互不必从表单或筛选器开始,也可以从用户已有的内容开始。
例如,在电商应用中,用户可以在聊天中上传一张商品照片,让模型识别它,然后直接在小组件中继续匹配或发现商品。
要实现这一点,需要让系统的模型端和 UI 端都能处理文件。在模型端,工具可以通过 openai/fileParams 直接使用用户在聊天中上传的文件,让模型能够基于图像或用户提供的其他素材进行推理。在 UI 端,小组件也可以使用 window.openai.uploadFile 和 window.openai.getFileDownloadUrl 直接处理文件,从而在 UI 流程中请求用户上传文件,或生成可供用户下载和重复使用的文件。
走向生产环境
接下来,当应用走出本地开发阶段,安全、配置和工具方面就会出现另一组需要考虑的问题。这正是第三组经验所要讨论的内容。
9. CSP 成了新的 CORS 难题
出于安全考虑,OpenAI 在双层嵌套的 iframe 中渲染应用。内容安全策略(CSP)是 iframe 隔离的原生机制,这种设置会严格执行这些策略,因此常常出现经典的“本地运行正常,到了生产环境就出问题”的情况。
在传统 Web 开发中,宽松的策略或许也能应付过去,但 Apps SDK 要求您进行精确配置。
这意味着,您需要在应用清单中仔细声明每种交互允许使用哪些域名:
| 字段 | 用途 | 示例 | 常见错误 |
|---|---|---|---|
| connectDomains | API 和 XHR 请求 | https://api.weather.com | 忘记区分预发布环境和生产环境的 API。 |
| resourceDomains | 图像、字体、脚本 | https://cdn.jsdelivr.net | 使用 delivr.net 之类的通用 CDN,却未将其加入允许列表 |
| frameDomains | 嵌入 iframe | https://www.youtube.com | 嵌入 YouTube 视频或 Mapbox 实例,却未将其加入允许列表。 |
| redirectDomains | 打开时不显示警告的外部链接 | https://app.alpic.ai | 遗漏结账或 OAuth 回调域名。 |
从一开始就重视 CSP 配置,为我们省下了后续大量的生产环境调试工作。
10. 小组件的标志虽小,影响却很大
除了 CSP,还有少量小组件级别的设置,决定了小组件、模型和宿主环境之间如何分配控制权。这些标志很容易被忽略,却定义了导航、工具访问和发布方面的关键边界。
宿主与导航边界
- 提交应用时必须设置
widgetDomain。它定义了全屏模式下“在 <App> 中打开”按钮默认指向的位置,同时也参与来源允许列表的配置,因为小组件是在<widgetDomain>.web-sandbox.oaiusercontent.com下渲染的。我们使用setOpenInAppUrl根据上下文将用户引导到合适的路径。
模型与工具边界
- 工具注解 必须遵循发布指南。
readOnly、destructiveHint和openWorldHint等标志是必填项,并会在提交时接受验证。 - 工具可见性 很重要:不应允许模型调用的工具,必须明确标记为私有。
小组件执行边界
widgetAccessible控制小组件能否使用callTool自行调用工具。
单独来看,这些设置都不起眼,但它们共同决定了应用发布后能否正常运行。
为快速迭代优化开发流程
Apps SDK 正在快速发展,我们也很高兴能在这一过程中不断构建应用。为了让开发流程更顺畅、更高效,我们决定开发自己的开源框架,并与社区分享。以下经验可以帮助您避开我们初期遇到的一些开发体验问题。
11. 快速迭代需要热重载
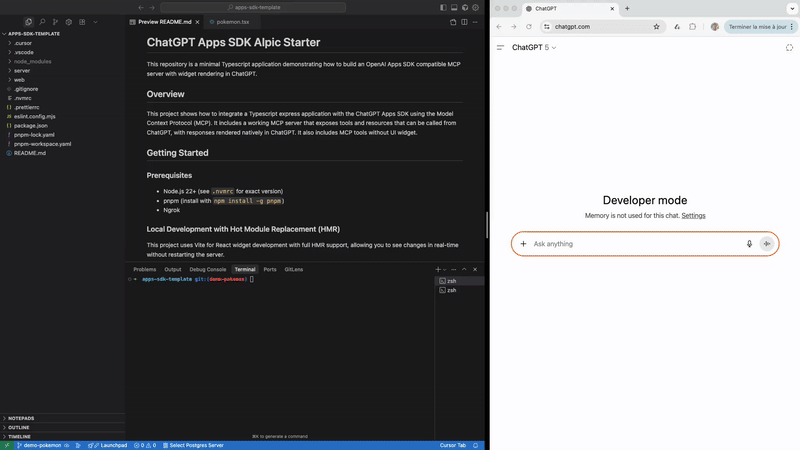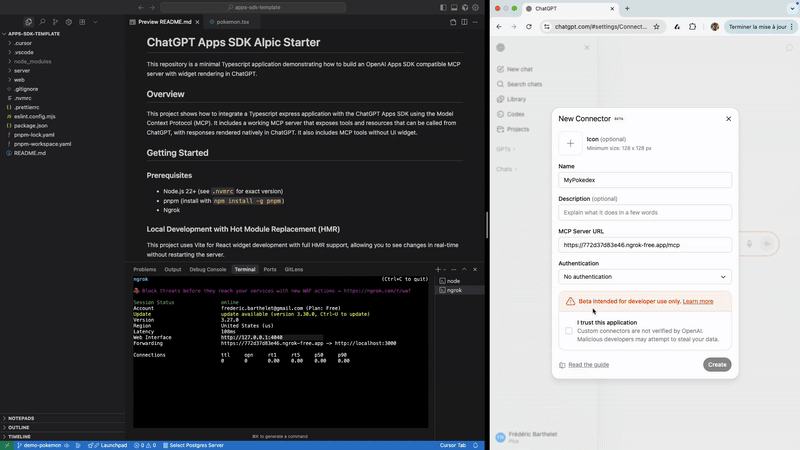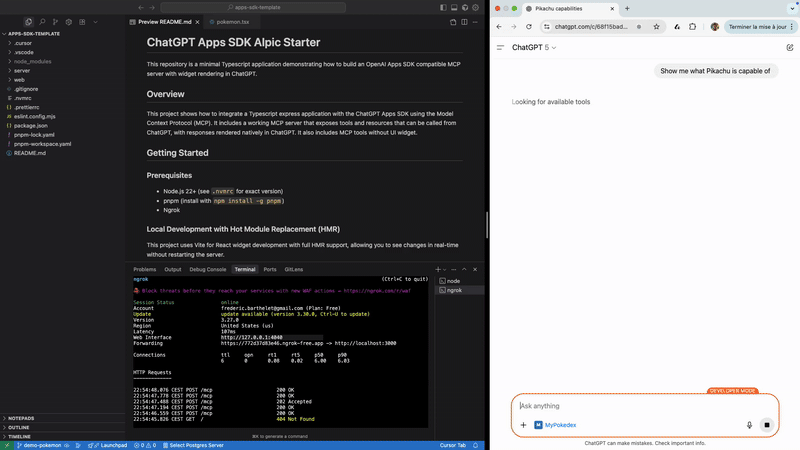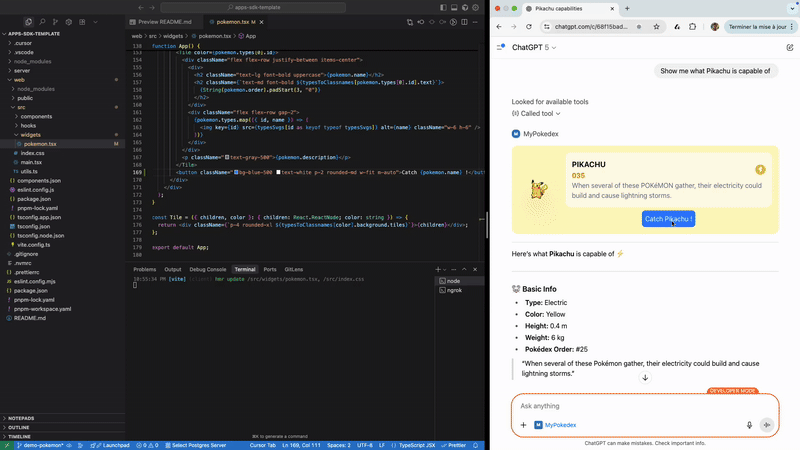
迭代速度是我们最早着手解决的问题之一。资源缓存的 TTL 较长,加上资源通过 JSON-RPC 转发,使得标准模块热重载功能(例如 Vite 或 Next.js 中的实现)无法直接用于 ChatGPT 应用。
在花了大量时间了解 Vite 的内部机制后,我们构建了一个 Vite 插件,让小组件能够直接在 ChatGPT 中实时重载。该插件会拦截发往 MCP 服务器的资源请求,并将实时更新注入 ChatGPT 的 iframe。在 IDE 中做出的修改能立即反映在 ChatGPT 中,大幅缩短了我们的反馈周期。
12. 并非所有测试都需要在 ChatGPT 中进行
在 ChatGPT 中测试是黄金标准,但在最初几轮迭代中,本地模拟器可以帮助您更快地推进开发,尤其是在修改工具定义、需要在开发者模式下重新加载应用时。
为了加快早期迭代,我们构建了一个轻量级本地模拟器,用于模拟 ChatGPT 宿主环境,并配备调试工具和应用专用日志。这样,我们就能以毫秒级速度迭代 React 状态和布局,将真实 ChatGPT 环境中的测试留给模型交互和边界情况的验证。
13. 移动端测试需要专门支持
移动端测试带来了另一个挑战:在 ChatGPT 中测试需要通过隧道连接本地服务器,但 Vite 默认使用 localhost,导致其他设备无法访问同一个 URL。
为了解决这个问题,我们扩展了 Vite 插件,使其支持隧道端口上的域名转发,从而让我们能够在 iOS 和 Android 设备上进行测试,并将移动端验证纳入日常工作流程。
14. 熟悉的抽象(如 React 钩子)能加快前端开发
Apps SDK 提供了强大的能力,但主要通过底层 JavaScript API 暴露。作为长期使用 React 的开发者,我们希望能以更贴近已掌握概念的方式使用这些能力。
因此,我们引入了一些适合 React 的抽象,例如 useCallTool、useWidgetState 和 useLocale 等钩子,以及用于复杂数据流的更高级状态管理方案,例如基于 Zustand 构建的 createStore。重新引入熟悉的前端模式,减少了样板代码,也让小组件开发更贴近现代 Web 工作流。
将经验转化为 Codex 技能
15. 将经验转化为可复用的工具
随着这些模式在多个应用中反复出现,我们逐渐意识到,反复摸索同样的经验正在拖慢开发速度。为了加快 ChatGPT App 开发,让开发过程更可预测,我们决定将这些经验直接融入工具中,既供自己使用,也分享给社区。
由此,我们开展了两项相辅相成的工作:
- Skybridge 框架: 这个开源 React 框架将本文介绍的许多模式封装成可复用的构建模块,包括我们开发的钩子(
useCallTool、useToolInfo)、开发工具(HMR 和本地模拟器),以及 data-llm 属性。 - chatgpt-apps-builder Codex 技能: 我们在该框架的基础上构建了一项专用的 Codex 技能,为应用的整个生命周期提供支持:
- 创意构思: 集思广益,探索如何让应用具备智能体能力,而不只是移植现有的网页应用。
- 代码生成: 同时编写 React 前端和 MCP 服务器后端,并预先配置所有适用的 UX 和 UI 模式。
- 本地测试: 启动开发服务器,将本地应用连接到 ChatGPT,通过热重载实时迭代。
- 质量保证与发布: 按照 OpenAI 的提交指南进行系统化检查,包括 CSP 验证、安全区域相关考量和生产环境测试。
- 应用部署: 协助完成应用上线和迭代所需的最后步骤。
要安装并使用该技能,只需运行以下命令:
npx skills add alpic-ai/skybridge结语
构建 ChatGPT 应用,需要重新思考上下文如何流转、界面如何运作,以及用户与模型如何协作。本文中的许多经验,都源于熟悉的网页开发模式与智能体系统实际情况之间的差异。
我们分享这些经验,并将其融入开源框架和 Codex 技能,希望帮助团队减少在相同问题上反复摸索的时间,将更多时间用于探索这种新交互模式带来的可能性。最吸引人的 ChatGPT 应用,不会只是现有产品的简单移植,而是围绕这种以 AI 为先的新体验精心设计而成。