选择您使用的 API,了解用量的计量方式,以及如何管理语音应用的成本。
GPT-Live 用量与成本
GPT-Live 将语音对话与执行推理和运行工具的后端分开。请分别估算这两部分成本:语音会话费用取决于时长,后端成本则取决于您使用的模型和工具。
语音会话成本
GPT-Live 语音会话按当前的模型费率逐秒计费。会话时长不会向上取整到下一整分钟。
会话的活跃时长包括用户说话、助手说话、双方都保持静默以及后端处理工作的时间。
估算时,请计算会话从开始到关闭的全部活跃时长。使用 API 报告的时长,而不是仅计算您播放的音频时长。将麦克风输入静音不会关闭会话。对话结束后,请关闭会话并收集最终用量。
后端模型和工具的价格请参阅 API 定价。
WebRTC 初始化费用
通过 POST /v1/live/sessions 请求创建 WebRTC 会话时,会在会话初始化期间收取 15 秒的语音时长费用。会话开始运行后,这笔费用将抵扣时长费用。估算运行中会话的成本时,请勿在其时长上再加 15 秒。
例如,下文中 90 秒的会话已包含初始化时计费的 15 秒,不会按 105 秒计费。在评估重新连接,或在用户准备好说话之前就创建会话的应用时,请将创建会话的费用考虑在内。
后端成本
后端调用与语音会话分开计费,计费方式与不含语音功能的应用相同。请计入模型输入和输出 Token、受支持的缓存输入,以及所有适用的图像或工具费用。如果您的应用调用其他服务,也请将这些服务的成本纳入估算。
您可以独立于语音前端优化后端工作。参照通用的 成本优化指南,减少请求次数 和 Token 用量。对于符合条件的后端模型,可使用提示缓存: 将可复用的指令、工具定义及其他 稳定内容放在提示的开头。
后端方案的选择也会影响对话时长。如果某项优化延长了用户等待时间,或改变了助手完成任务的可靠性,请比较优化前后的总成本。
估算对话成本
对于包含一个语音会话的对话:
总成本 =(计费语音秒数 ÷ 60 × 每分钟语音费率)+ 后端成本
例如,假设语音费率为每分钟 $0.05,那么 90 秒的语音会话费用为 $0.075。如果后端模型和工具费用合计为 $0.02,则该对话的成本为 $0.095:
| 费用项 | 计算方式 | 成本 |
|---|---|---|
| 语音会话 | 90 秒 ÷ 60 × $0.05 | $0.075 |
| 后端工作 | 模型和工具费用合计 | $0.02 |
| 对话总成本 | $0.075 + $0.02 | $0.095 |
上述费率和后端成本仅为示例;请使用当前语音费率、实测后端用量以及适用的模型和工具费率。如果任务跨越多个语音会话,请将各会话时长相加,并计入会话之间执行的后端工作。
优化策略
重点是减少不必要的对话和等待,帮助用户完成任务。请保留任务所需的确认和检查。
在会话开始前提供相关上下文
在开始语音会话前,收集您的应用已有权限使用的信息。例如,帮助处理订单的助手可以预先获取订单号和当前状态,这样用户就不必重复提供这些信息,也无需等待再次查询。
确保这些上下文保持最新,并聚焦于当前任务。向语音模型提供 对话所需的信息;将详细记录和工作流 保留在后端。请参阅会话配置 和委派与工具。
缩短等待工具的时间
缩短等待时间可以改善用户体验,并降低语音会话成本。
例如,假设您的后端使用 gpt-5.6-luna,并启用
快速模式,同时并行执行
相互独立的工具调用。如果这些优化能帮助用户提前一分钟完成任务并关闭
语音会话,就可以节省 $0.05 的语音费用。如果新增的后端成本
低于节省的费用,总成本就会下降。
您也可以在委派事件到达之前,根据转写片段发起推测性查询。 统计后端成本时,请将最终未被使用的推测性工作 也计算在内。
有关模型、连接、流式传输和工具的优化方法,请参阅降低后端延迟。 通过语音智能体评估验证提供有效语音回复所需的 时间以及任务是否成功完成。
在执行耗时较长的任务时关闭会话
语音前端和由您的应用管理的后端可以独立运行。 使用客户端委派时,无论语音会话保持开启 还是已经关闭,后端工作进程都可以继续运行。请在 关闭语音会话之前保存任务状态和对话上下文。
对于常驻智能体,当后端处理 长时间运行的任务(例如在目标模式下编程)时,请关闭语音会话。提供一个标为 恢复对话 的按钮,在用户返回时启动新的语音会话;或者利用后端的 完成事件启动新会话,并通知用户 结果已就绪。
启动新会话时,在 input 中提供已保存的上下文和
经过验证的任务结果,以恢复对话。例如,通过
新的 WebSocket 连接发送以下启动事件:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}等待收到 session.started 后再开始流式传输音频。请参阅
使用先前对话初始化会话,
了解支持的历史记录格式。
如果之前的会话已通过 store: true 保存,您也可以派生该会话。无论采用哪种方式,都请在您的应用中保留经过验证的后端任务状态。
关闭会话可以为每分钟的语音空闲时间节省 $0.05;请将这笔节省的费用与重新连接的成本以及对用户体验造成的中断进行权衡。
选择合适的后端模型
首先筛选满足任务准确性和可靠性要求的模型。 然后比较对话总成本,包括语音时长、模型用量、 工具调用和重试。模型选择指南 介绍了如何权衡这些因素。
如果较大的后端模型能更快地完成任务,且节省的语音会话费用超过其额外的 Token 费用,那么总成本可能更低。如果较便宜的模型耗时更长、重复调用工具或未能完成任务,那么总成本反而可能更高。
比较每项成功完成的任务的成本,同时考察完成率和完成耗时。将失败的尝试和重试计入总成本,避免让便宜的配置仅仅因为完成的工作更少而显得更优。规划比较方案时,请参考语音智能体评估 Cookbook。
监控实际用量
为每个会话分别记录语音时长和后端用量。GPT-Live 以秒为单位报告累计语音时长:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}每次更新都会替换先前的时长快照。请勿将这些快照相加。
发送 session.close 后,请继续接收事件,直到收到 session.closed,然后
记录其最终的 usage.seconds,只记录一次。请遵循
优雅关闭流程,
确保您的应用能在断开连接前收集最终用量。
对于 Responses 委派,请从通过 response.event 传递的嵌套
response.completed 事件中读取后端响应的 usage。根据响应 ID 对每个
后端响应仅计数一次,并保留按该模型费率计费所需的输入、输出和
缓存 Token 明细。对于您的
应用独立执行的后端工作,也请收集相应请求的用量。
针对有代表性的对话,比较估算总成本与实际总成本。将仅用于评估的模型调用与应用用量分开统计,并结合任务成功情况审查成本。
Realtime API 成本
本文介绍 Realtime API 的计费方式,并提供成本优化策略。语音智能体会话会累计文本、音频和图像模态的输入与输出 Token。流式翻译和流式转录会话按音频时长计费。不同模型的价格有所不同,具体价格见各模型页面,例如 gpt-realtime-2、gpt-realtime-translate、gpt-realtime-whisper 和 gpt-realtime。
对话式 Realtime API 会话由一系列 轮次组成。每一轮中,用户添加输入,触发一个 Response 来生成模型输出。服务器维护一个 Conversation,其中包含一组 Items ,构成下一轮的输入。Response 返回时,其输出会自动添加到 Conversation 中。
翻译和转录会话采用不同的流式架构。客户端持续流式传输音频,并随着源音频的到达接收翻译后的音频、转录文本增量或转录事件。这些会话不使用常规的 Response 生命周期,因此应根据其按时长计费的费率进行估算和监控,而不是使用每个 Response 的 Token 用量。
每个 Response 的费用
Realtime API 在创建 Response 时产生费用,并根据输入与输出 Token 数量计费(输入转录费用除外,详见下文)。目前不收取网络带宽或连接费用。Response 可以手动创建,也可以在开启语音活动检测(VAD)后自动创建。VAD 会有效过滤无声的输入音频,因此无声音频不会计入输入 Token,除非客户端手动将其添加为对话输入。
每次生成 Response 时,都会将整个对话发送给模型。每一轮的输出会作为 Items 添加到服务器上的 Conversation 中,成为后续轮次的输入,因此会话越往后,每轮的费用就越高。
您可以使用我们的 Token 化处理工具估算文本 Token 费用。用户消息中的音频每 100 毫秒计为 1 个 Token,助手消息中的音频每 50 毫秒计为 1 个 Token。请注意,Token 数量除了包含消息内容,还包含特殊 Token,因此实际计数会有小幅差异。例如,内容包含 10 个文本 Token 的用户消息可能会计为 12 个 Token。
示例
下面通过一个简单示例说明多轮 Realtime API 会话中的 Token 费用。
在对话的第一轮中,我们添加了 100 个 Token 的指令,以及一条包含 20 个音频 Token 的用户消息(例如由 VAD 根据用户的语音添加),输入共计 120 个 Token。创建 Response 后,会生成一条助手输出消息,其中包含 20 个音频 Token 和 10 个文本 Token。
接着,我们添加另一条用户音频消息,开始第二轮。第二轮的 Token 用量是多少?此时,Conversation 包含初始指令、第一条用户消息、第一轮的助手输出消息,以及第二条用户消息(25 个音频 Token)。这一轮的输入包含 110 个文本 Token 和 64 个音频 Token,此外还会产生另一条助手输出消息的输出 Token。
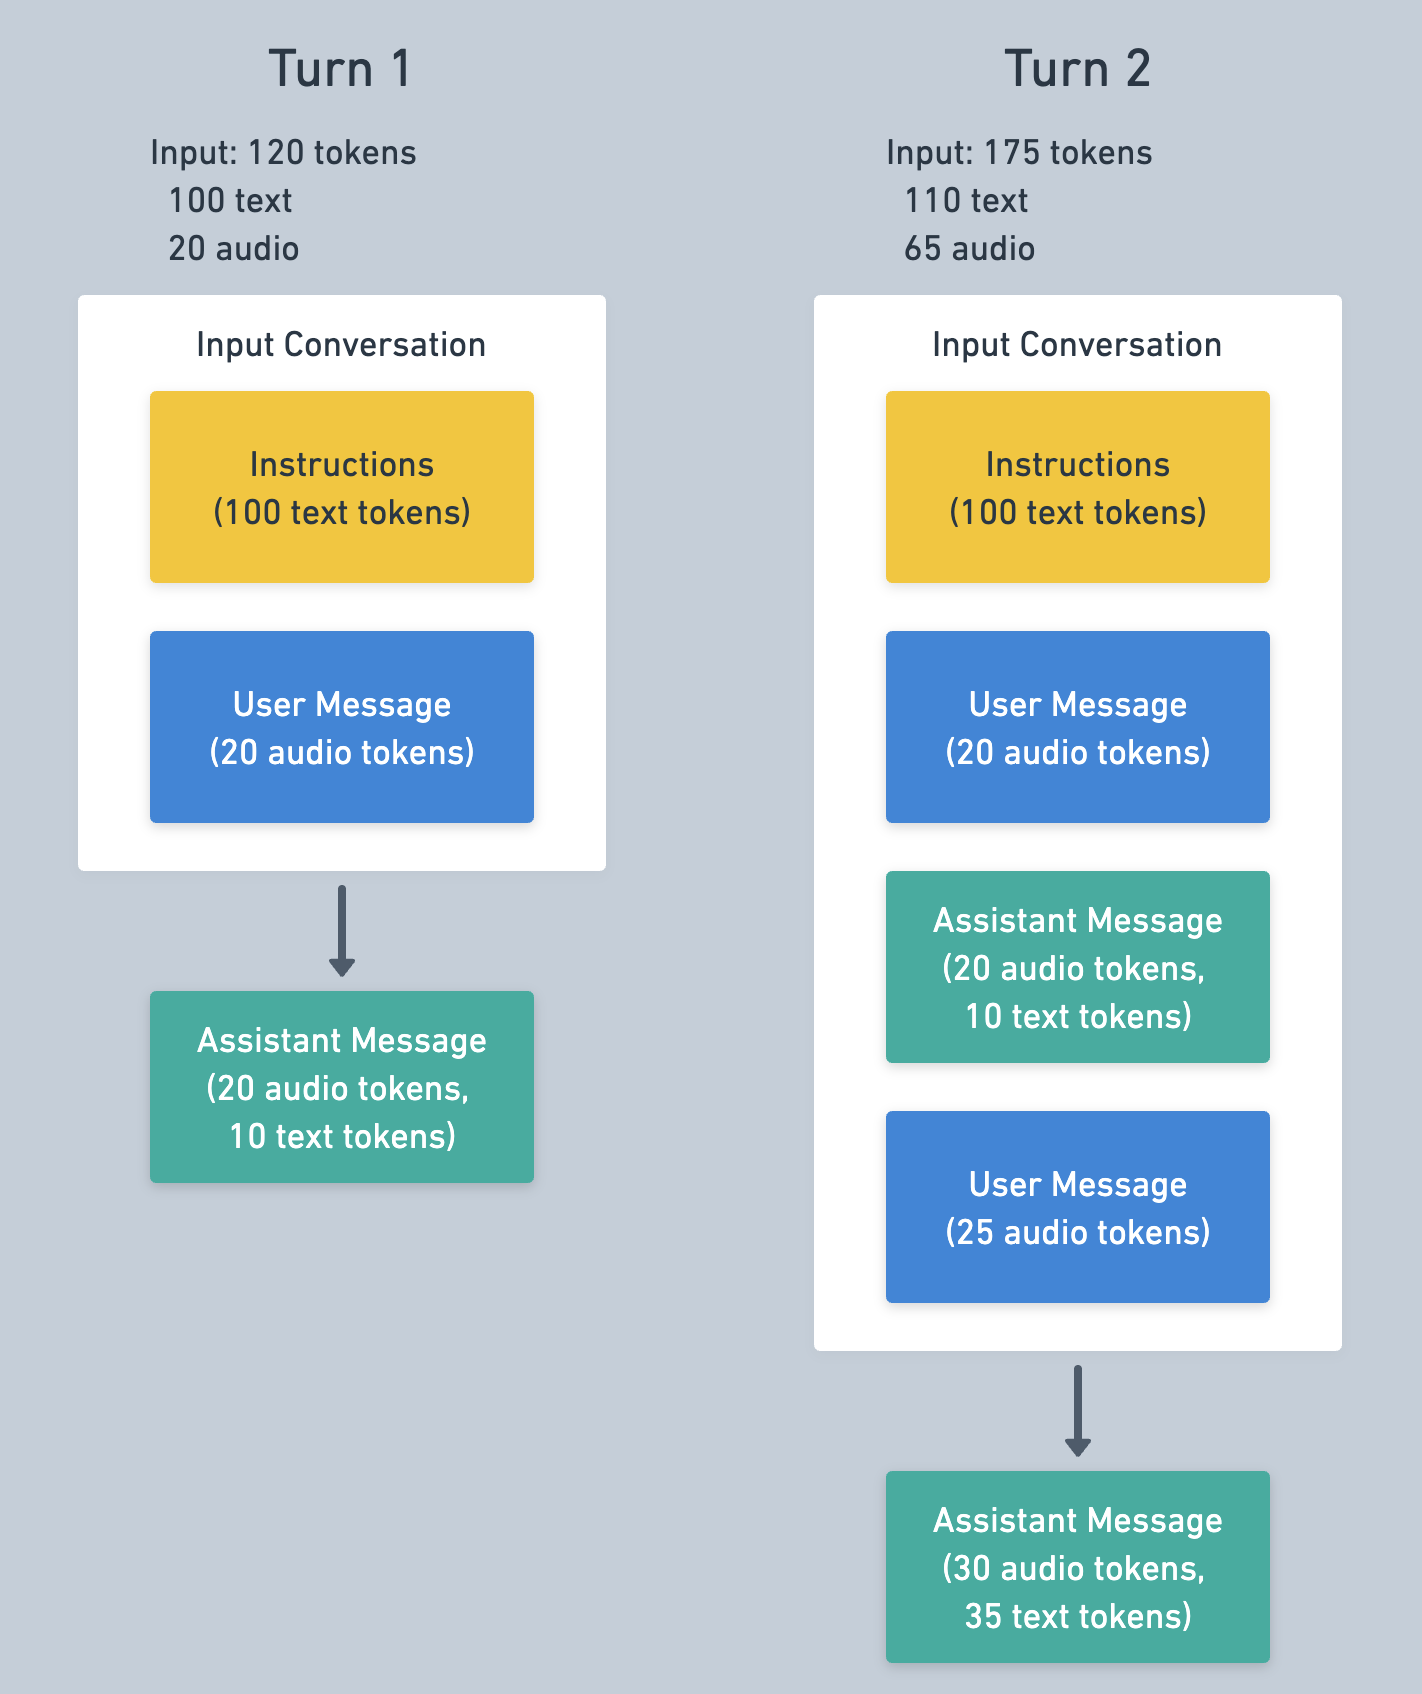
第一轮的消息很可能会在第二轮命中缓存,从而降低输入费用。有关缓存的更多信息,请参阅下文。
您可以从 response.done 事件中读取 Response 的 Token 用量,示例如下。
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}输入转录费用
除了对话式 Response 的费用外,如果启用了输入转录,Realtime API 还会收取输入转录费用。输入转录使用的模型与语音到语音模型不同,例如 whisper-1 或 gpt-4o-transcribe,因此适用不同的费率表。音频写入输入音频缓冲区并由客户端手动提交或由 VAD 提交后,便会进行转录。
您可以从 conversation.item.input_audio_transcription.completed 事件中读取输入转录的 Token 数量,示例如下。
{
"type": "conversation.item.input_audio_transcription.completed",
...
"transcript": "Hi, can you hear me?",
"usage": {
"type": "tokens",
"total_tokens": 26,
"input_tokens": 17,
"input_token_details": {
"text_tokens": 0,
"audio_tokens": 17
},
"output_tokens": 9
}
}缓存
Realtime API 支持提示缓存。该功能会自动应用,可大幅降低多轮会话中的输入 Token 费用。当 Response 的输入 Token 与之前某个 Response 的 Token 匹配时,系统会尽力使用缓存,但不保证一定命中。
要尽可能提高缓存命中率,最好的策略是保持会话历史不变。删除或更改对话内容会破坏缓存匹配,使可匹配的范围缩减到更改位置为止,输入与之前内容的匹配程度也会随之降低。请注意,指令和工具定义位于对话开头,因此在会话中途更改它们会降低后续轮次的缓存命中率。
截断
当对话中的 Token 数量超过模型的输入 Token 上限时,对话会被截断,即从最早的消息开始,将消息从 Response 输入中移除。对于上下文窗口为 32k、最大输出为 4,096 个 Token 的模型,上下文最多只能包含 28,224 个 Token,超过这个数量就会触发截断。
客户端可以设置一个低于模型上限的 Token 窗口,这是控制 Token 用量和成本的有效方式。该窗口由 token_limits.post_instructions 配置控制(前提是您按下方示例将截断类型配置为 retention_ratio)。顾名思义,该配置控制的是 Response 的输入 Token 上限,不包括指令 Token。将 post_instructions 设为 1,000 意味着,超出 1,000 个输入 Token 上限的条目不会发送给模型来生成 Response。
截断会使对话开头附近的缓存失效,如果每一轮都发生截断,缓存命中率就会很低。为缓解这一问题,客户端可以配置截断行为,使其移除比必要数量更多的消息,为后续内容留出更多空间,推迟下一次截断。这可以通过 session.truncation.retention_ratio 设置控制。服务器默认值为 1.0,表示截断只会移除必要的条目。值为 0.8 时,截断会保留上限的 80%,额外移除 20%。
如果您希望降低特定模型的 Realtime API 单次会话成本,我们建议降低 Token 数量上限,并将 retention_ratio 设为小于 1 的值,如下例所示。请注意,这可能需要做出权衡:成本降低了,但模型在某一轮中能记住的内容也可能减少。
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}您也可以完全禁用截断,如下所示。禁用后,如果 Conversation 过长,无法创建 Response,系统会返回错误。如果您打算手动管理 Conversation 的大小,这种方式可能会有帮助。
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}其他优化策略
使用 mini 模型
Realtime 语音到语音模型提供“常规”和 mini 两种规模,mini 模型的价格明显更低。相应的取舍通常在于指令遵循和函数调用方面的智能能力,mini 模型在这些方面的表现较弱。我们建议先使用较大的模型测试应用,完善应用和提示,再尝试使用 mini 模型优化成本。
编辑 Conversation
服务器会自动进行截断,您也可以通过手动编辑 Conversation 来管理成本。该 API 的一项设计原则是让客户端完全控制服务器端的 Conversation,允许客户端自由添加和移除条目。
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}清理旧消息是减少输入 Token 数量和降低成本的有效方式。这样可能会移除重要内容,因此一种常见策略是用摘要替换这些旧消息。您可以像上文那样使用 conversation.item.delete 消息从 Conversation 中删除条目,也可以使用 conversation.item.create 消息添加条目。
估算成本
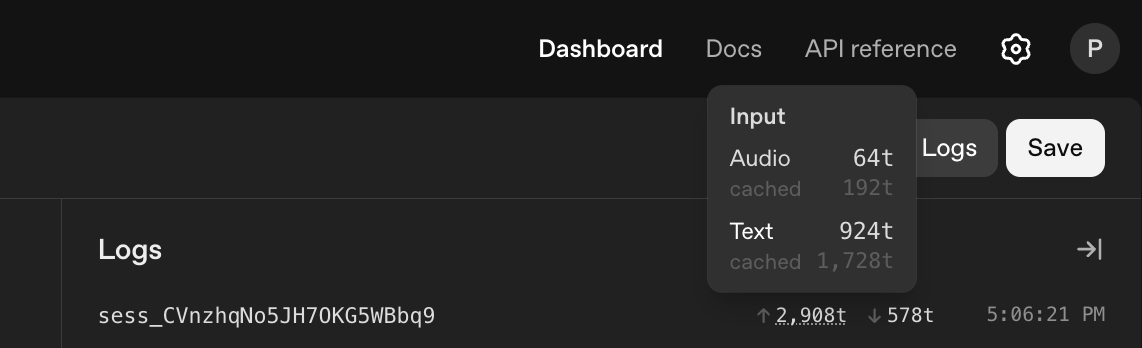
由于 Realtime API 的 Token 用量计算较为复杂,提前估算成本可能比较困难。一个有效的方法是在 Realtime Playground 中使用您计划采用的提示和函数,运行一次示例会话并测量 Token 用量。您可以在 Realtime Playground 的“日志”选项卡中,在会话 ID 旁边查看该会话的 Token 用量。