
Las capacidades de audio de la IA abren nuevas y emocionantes posibilidades para las experiencias de usuario. A principios de este año lanzamos varios modelos de audio nuevos, incluido gpt-realtime, junto con nuevas funciones de la API para que los desarrolladores puedan crear estas experiencias.
La semana pasada lanzamos nuevas instantáneas de modelos de audio diseñadas para abordar algunos de los desafíos comunes al crear agentes de audio confiables. Estas mejoran la confiabilidad y la calidad en los flujos de trabajo de voz en producción, desde la transcripción y la conversión de texto a voz hasta los agentes que procesan de forma nativa las interacciones de voz a voz en tiempo real.
Estas actualizaciones incluyen:
gpt-4o-mini-transcribe-2025-12-15para convertir voz a texto con la API de transcripción o la Realtime APIgpt-4o-mini-tts-2025-12-15para convertir texto a voz con la API de vozgpt-realtime-mini-2025-12-15para interacciones nativas de voz a voz en tiempo real con la Realtime APIgpt-audio-mini-2025-12-15para interacciones nativas de voz a voz con la API para completar chats
Las nuevas instantáneas comparten varias mejoras:
Con entrada de audio:
- Menores tasas de error de palabras en audio de situaciones reales y con ruido
- Menos alucinaciones durante los silencios o cuando hay ruido de fondo
Con salida de audio:
- Voz de salida más natural y estable, incluso al usar voces personalizadas
Los precios son los mismos que los de las instantáneas anteriores de los modelos, por lo que recomendamos cambiar a estas nuevas instantáneas para obtener un mejor rendimiento por el mismo precio.
Si estás creando agentes de voz, sistemas de atención al cliente o experiencias de voz de marca, estas actualizaciones te ayudarán a lograr implementaciones más confiables en producción. A continuación, detallamos las novedades y cómo se reflejan estas mejoras en los flujos de trabajo de voz en situaciones reales.
De voz a voz
Estamos implementando nuevos modelos Realtime mini y Audio mini optimizados para mejorar las llamadas a herramientas y el seguimiento de instrucciones. Estos modelos reducen la brecha de inteligencia entre los modelos mini y los de tamaño completo, lo que permite optimizar los costos de algunas aplicaciones al cambiar al modelo mini.
gpt-realtime-mini-2025-12-15
El modelo gpt-realtime-mini está diseñado para usarse con la Realtime API, nuestra API para interacciones multimodales nativas de baja latencia. Admite funciones como la entrada y salida de audio en streaming, el manejo de interrupciones (con detección opcional de actividad de voz) y la llamada a funciones en segundo plano mientras el modelo sigue hablando.
La nueva instantánea de Realtime mini se adapta mejor a los agentes en tiempo real, con mejoras claras en el seguimiento de instrucciones y las llamadas a herramientas. En nuestras evaluaciones internas de voz a voz, observamos una mejora de 18,6 puntos porcentuales en la precisión del seguimiento de instrucciones y de 12,9 puntos porcentuales en la precisión de las llamadas a herramientas con respecto a la instantánea anterior, además de una mejora en la prueba de referencia Big Bench Audio.
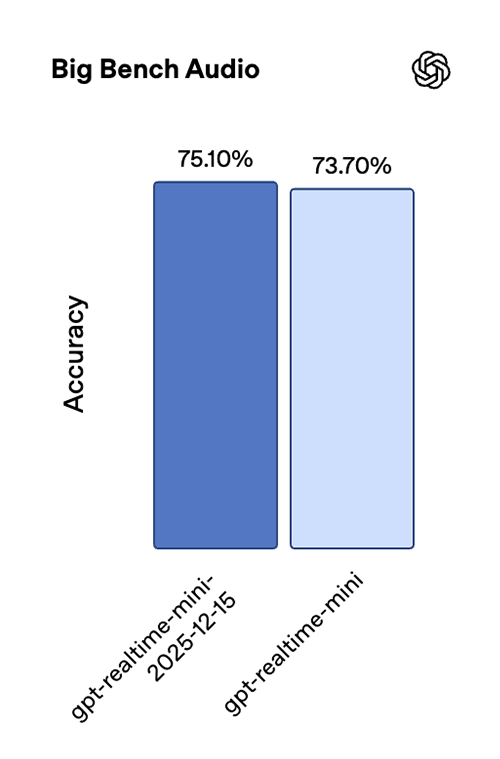
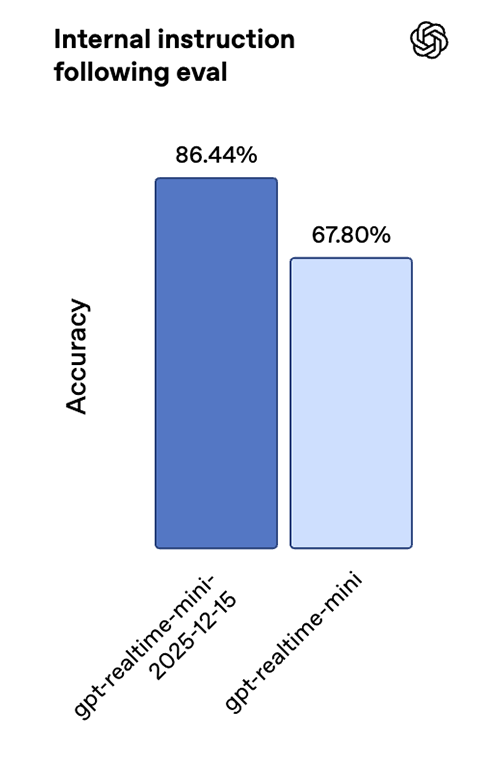
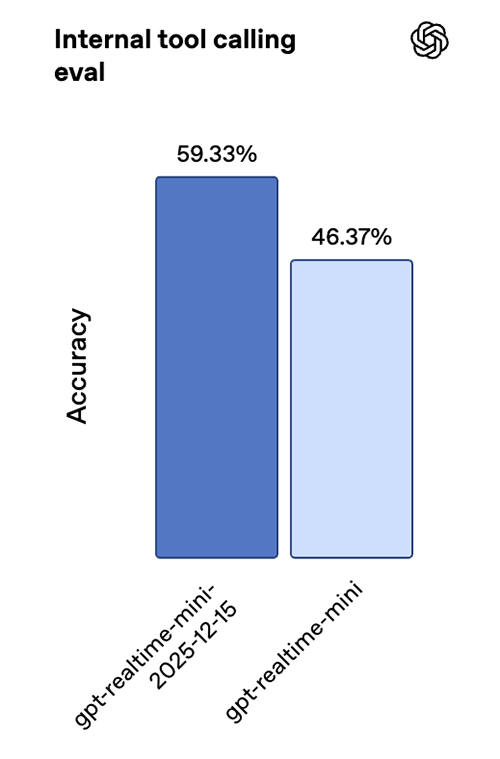
En conjunto, estas mejoras permiten interacciones de varios pasos más confiables y una ejecución de funciones más consistente en entornos en vivo de baja latencia.
Para los casos en los que la precisión del agente justifica un costo mayor, gpt-realtime sigue siendo nuestro modelo con mejor rendimiento. Pero cuando el costo y la latencia son prioritarios, gpt-realtime-mini es una excelente opción que ofrece un buen rendimiento en situaciones reales.
Por ejemplo, Genspark lo sometió a pruebas de estrés de traducción bilingüe y enrutamiento inteligente según la intención. Además de la mejora en la calidad de la voz, observó respuestas casi instantáneas y un reconocimiento preciso de la intención durante intercambios rápidos.
gpt-audio-mini-2025-12-15
El modelo gpt-audio-mini se puede usar con la API para completar chats en casos de uso de voz a voz que no requieren interacción en tiempo real.
Ambas instantáneas nuevas también incluyen un decodificador mejorado para producir voces más naturales y mantienen mejor la consistencia de la voz cuando se usan con voces personalizadas.
De texto a voz
Nuestro modelo más reciente de texto a voz, gpt-4o-mini-tts-2025-12-15, ofrece una mejora significativa en la precisión, con tasas de error de palabras considerablemente menores que las de la generación anterior en las pruebas de referencia estándar de voz. En Common Voice y FLEURS, observamos una WER aproximadamente un 35 % menor, además de mejoras consistentes en Multilingual LibriSpeech.
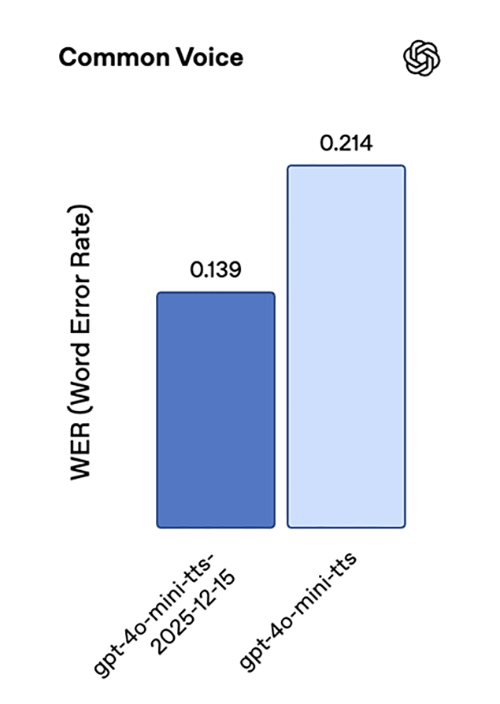
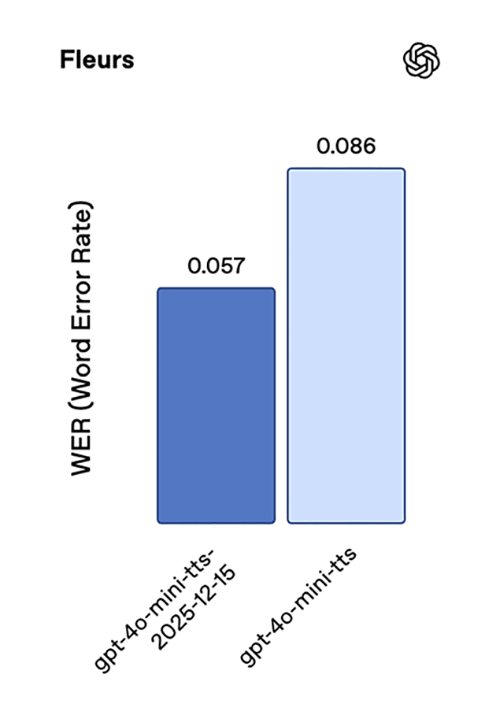
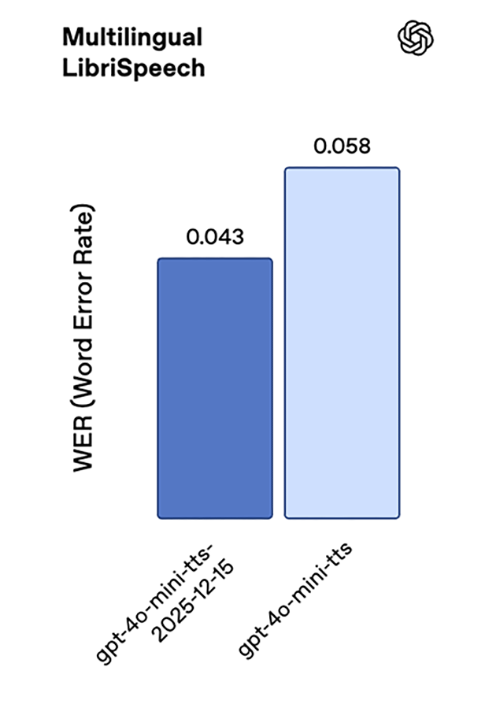
En conjunto, estos resultados reflejan mejoras en la precisión de la pronunciación y la robustez en una amplia variedad de idiomas.
Al igual que la nueva instantánea de gpt-realtime-mini, este modelo suena mucho más natural y funciona mejor con voces personalizadas.
De voz a texto
El modelo de transcripción más reciente, gpt-4o-mini-transcribe-2025-12-15, muestra mejoras importantes tanto en precisión como en confiabilidad. En pruebas de referencia estándar de ASR, como Common Voice y FLEURS (sin indicaciones sobre el idioma), ofrece tasas de error de palabras menores que las de los modelos anteriores. Optimizamos este modelo para conversaciones en situaciones reales, como intervenciones breves de los usuarios y entornos con ruido de fondo. En una evaluación interna de alucinaciones con ruido , en la que reprodujimos fragmentos de ruido de fondo de situaciones reales y audio con intervalos de habla variables (incluidos silencios), el modelo produjo aproximadamente un 90 % menos de alucinaciones que Whisper v2 y aproximadamente un 70 % menos que los modelos GPT-4o-transcribe anteriores.
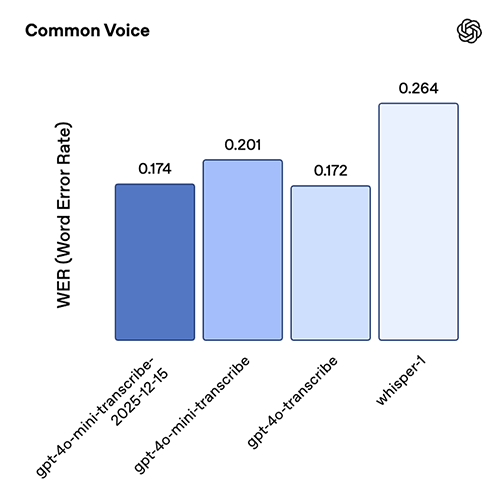
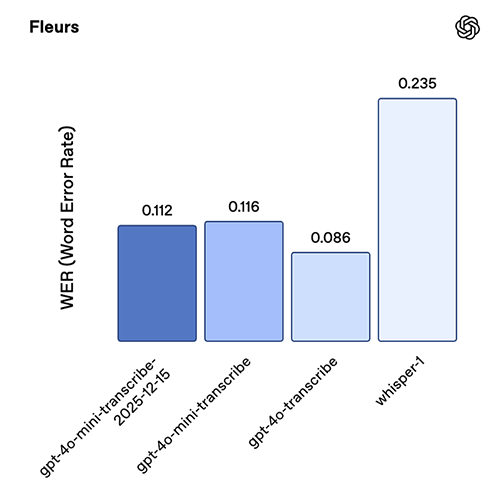
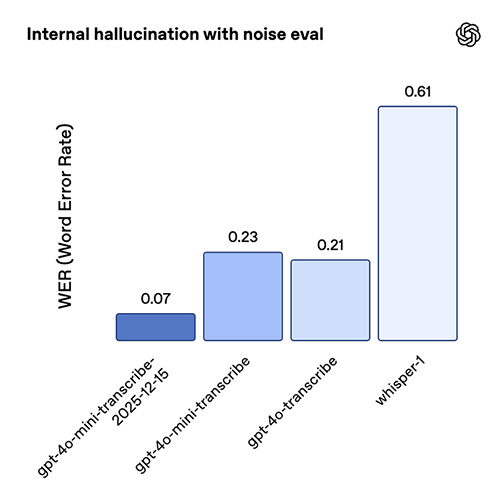
Esta instantánea del modelo se destaca especialmente en chino (mandarín), hindi, bengalí, japonés, indonesio e italiano.
Voces personalizadas
Las voces personalizadas permiten que las organizaciones se conecten con sus clientes mediante una voz propia de su marca. Ya sea que estés creando un agente de atención al cliente o un avatar de marca, la tecnología de voces personalizadas de OpenAI facilita la creación de voces distintivas y realistas.
Estos nuevos modelos de voz a voz y de texto a voz permiten mejorar las voces personalizadas con tonos más naturales, mayor fidelidad a la muestra original y mayor precisión en distintos dialectos.
Para garantizar el uso seguro de esta tecnología, las voces personalizadas están disponibles únicamente para clientes que cumplen los requisitos. Comunícate con tu director de cuenta o contacta a nuestro equipo de ventas para obtener más información.
Del prototipo a la producción
Las aplicaciones de voz suelen fallar en las mismas situaciones, principalmente en conversaciones largas, en casos extremos como el silencio y en flujos basados en herramientas en los que el agente de voz debe ser preciso. Estas actualizaciones se enfocan en esos tipos de fallas: menores tasas de error, menos alucinaciones, un uso más consistente de las herramientas y un mejor seguimiento de instrucciones. Además, mejoramos la estabilidad del audio de salida para que tus experiencias de voz puedan sonar más naturales.
Si actualmente estás lanzando experiencias de voz, te recomendamos cambiar a las nuevas instantáneas 2025-12-15 y volver a ejecutar tus casos de prueba clave de producción.
Quienes las probaron inicialmente confirmaron mejoras notables con solo cambiar a las nuevas instantáneas, sin modificar sus instrucciones. Aun así, recomendamos experimentar con tus propios casos de uso y ajustar los prompts según sea necesario.