Aprende a convertir texto en números para habilitar casos de uso como la búsqueda.
New embedding models
text-embedding-3-small and text-embedding-3-large, our newest and most performant embedding models, are now available. They feature lower costs, higher multilingual performance, and new parameters to control the overall size.
¿Qué son los embeddings?
Los embeddings de texto de OpenAI miden el grado de relación entre cadenas de texto. Los embeddings se usan comúnmente para:
Buscar (los resultados se ordenan según su relevancia para una cadena de consulta)
Agrupamiento (las cadenas de texto se agrupan por similitud)
Recomendaciones (se recomiendan elementos con cadenas de texto relacionadas)
Detección de anomalías (se identifican valores atípicos con poca relación con los demás)
Medición de la diversidad (se analizan las distribuciones de similitud)
Clasificación (las cadenas de texto se clasifican según la etiqueta más similar a ellas)
Un embedding es un vector (lista) de números de punto flotante. La distancia entre dos vectores mide su grado de relación. Las distancias pequeñas sugieren una mayor relación y las distancias grandes sugieren una menor relación.
Visita nuestra página de precios para conocer los precios de los embeddings. Las solicitudes se facturan según la cantidad de tokens en la entrada.
Cómo obtener embeddings
Para obtener un embedding, envía tu cadena de texto al punto de acceso de la API de embeddings junto con el nombre del modelo de embeddings (por ejemplo, text-embedding-3-small):
La respuesta contiene el vector de embedding (lista de números de punto flotante) junto con algunos metadatos adicionales. Puedes extraer el vector de embedding, guardarlo en una base de datos vectorial y utilizarlo en muchos casos de uso diferentes.
De forma predeterminada, la longitud del vector de embedding es de 1536 para text-embedding-3-small o de 3072 para text-embedding-3-large. Para reducir las dimensiones del embedding sin perder sus propiedades de representación de conceptos, proporciona el parámetro dimensions. Encontrarás más información sobre las dimensiones de los embeddings en la sección de casos de uso de embeddings.
Modelos de embeddings
OpenAI ofrece dos potentes modelos de embeddings de tercera generación (identificados con -3 en el ID del modelo). Lee la publicación del anuncio en el blog sobre los embeddings v3 para obtener más información.
El uso se cobra por token de entrada. A continuación se muestra un ejemplo de cuántas páginas de texto se pueden procesar por dólar estadounidense (suponiendo unos 800 tokens por página):
El conjunto de datos contiene un total de 568 454 reseñas de alimentos publicadas por usuarios de Amazon hasta octubre de 2012. Usamos un subconjunto de las 1000 reseñas más recientes a modo de ejemplo. Las reseñas están en inglés y tienden a ser positivas o negativas. Cada reseña tiene un ProductId, un UserId, un Score, un título (Summary) y un cuerpo (Text). Por ejemplo:
ID del producto
ID del usuario
Puntuación
Resumen
Texto
B001E4KFG0
A3SGXH7AUHU8GW
5
Alimento para perros de buena calidad
He comprado varios de los productos enlatados de Vitality...
B00813GRG4
A1D87F6ZCVE5NK
1
No es como se anuncia
El producto llegó etiquetado como maní salado jumbo...
A continuación, combinamos el resumen y el texto de la reseña en un solo texto. El modelo codifica este texto combinado y genera un único embedding vectorial.
Usar embeddings más grandes, por ejemplo, almacenándolos en un almacén vectorial para su recuperación, suele costar más y consumir más recursos de cómputo, memoria y almacenamiento que usar embeddings más pequeños.
Nuestros dos nuevos modelos de embeddings se entrenaron con una técnica que permite a los desarrolladores equilibrar el rendimiento y el costo de usar embeddings. En concreto, los desarrolladores pueden acortar los embeddings (es decir, eliminar algunos números del final de la secuencia) sin que pierdan su capacidad de representar conceptos, mediante el parámetro dimensions de la API. Por ejemplo, en la evaluación MTEB, un embedding de text-embedding-3-large puede reducirse a un tamaño de 256 y aun así superar el rendimiento de un embedding de text-embedding-ada-002 sin acortar, con un tamaño de 1536. Puedes leer más sobre cómo los cambios en las dimensiones afectan el rendimiento en nuestra publicación del blog sobre el lanzamiento de embeddings v3.
En general, se recomienda usar el parámetro dimensions al crear el embedding. En ciertos casos, es posible que necesites cambiar la dimensionalidad del embedding después de generarlo. Cuando la cambies manualmente, asegúrate de normalizar las dimensiones del embedding como se muestra a continuación.
Cambiar las dimensiones de forma dinámica permite un uso muy flexible. Por ejemplo, al usar un almacén de datos vectoriales que solo admite embeddings de hasta 1024 dimensiones, los desarrolladores ahora pueden usar nuestro mejor modelo de embeddings, text-embedding-3-large, y especificar un valor de 1024 para el parámetro dimensions de la API. Esto acorta el embedding desde sus 3072 dimensiones originales y sacrifica algo de exactitud a cambio de un vector más pequeño.
En muchos casos habituales, el modelo no se entrenó con datos que contengan los hechos y la información clave que quieres que estén disponibles al generar respuestas a una consulta del usuario. Una forma de resolver esto, como se muestra a continuación, es agregar información a la ventana de contexto del modelo. Esto es eficaz en muchos casos de uso, pero aumenta el costo en tokens. En este notebook, exploramos las ventajas y desventajas de este enfoque frente a la búsqueda basada en embeddings.
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constclient=newOpenAI();constarticle="At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";constquestion=`Use the article below to answer the question. If the answer cannot be found, say "I don't know."Article:${article}Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;constresponse=await client.chat.completions.create({ model: "gpt-4.1-mini", messages: [ { role: "system", content: "You answer questions about the 2022 Winter Olympics.", }, { role: "user", content: question }, ], temperature: 0,});console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."Article:\"\"\"{wikipedia_article_on_curling}\"\"\"Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""response = client.chat.completions.create( messages=[ { "role": "system", "content": "You answer questions about the 2022 Winter Olympics.", }, {"role": "user", "content": query}, ], model=GPT_MODEL, temperature=0,)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";String question = "Use the below article on the 2022 Winter Olympics to answer the subsequent question. " + "If the answer cannot be found, write \"I don't know.\"\n\n" + "Article:\n" + article + "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";ChatCompletionCreateParams params = ChatCompletionCreateParams.builder() .model("gpt-4.1-mini") .addSystemMessage("You answer questions about the 2022 Winter Olympics.") .addUserMessage(question) .temperature(0) .build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"client = OpenAI::Client.newarticle = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."question = <<~QUESTION Use the article below to answer the question. If the answer cannot be found, say "I don't know." Article: #{article} Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?QUESTIONresponse = client.chat.completions.create( model: "gpt-4.1-mini", messages: [ { role: :system, content: "You answer questions about the 2022 Winter Olympics." }, { role: :user, content: question } ], temperature: 0)puts(response.choices.fetch(0).message.content)
Para recuperar los documentos más relevantes, usamos la similitud del coseno entre los vectores de embeddings de la consulta y de cada documento, y devolvemos los documentos con las puntuaciones más altas.
La búsqueda de código funciona de manera similar a la búsqueda de texto basada en embeddings. Proporcionamos un método para extraer funciones de Python de todos los archivos de Python de un repositorio determinado. Luego, cada función se indexa con el modelo text-embedding-3-small.
Para realizar una búsqueda de código, generamos un embedding de la consulta en lenguaje natural con el mismo modelo. Luego, calculamos la similitud del coseno entre el embedding resultante de la consulta y cada uno de los embeddings de las funciones. Los resultados con mayor similitud del coseno son los más relevantes.
Como las distancias más cortas entre los vectores de embeddings representan una mayor similitud, los embeddings pueden ser útiles para generar recomendaciones.
A continuación, mostramos un sistema básico de recomendaciones. Recibe una lista de cadenas y una cadena de “referencia”, calcula sus embeddings y devuelve las cadenas ordenadas de mayor a menor similitud. Como ejemplo concreto, el notebook enlazado a continuación aplica una versión de esta función al conjunto de datos de noticias AG (reducido a una muestra de 2000 descripciones de artículos de noticias) para devolver los 5 artículos más similares a un artículo de referencia determinado.
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from"openai";constclient=newOpenAI();conststrings= ["A cheetah is a fast land animal.","A peregrine falcon is a fast bird.","A tortoise moves slowly.",];const { data } =await client.embeddings.create({ model: "text-embedding-3-small", input: strings,});constquery= data[0].embedding;constrecommendations= data .map(({ embedding }, index) => {constdotProduct= embedding.reduce( (total, value, dimension) => total + value * query[dimension],0 );constsimilarity= dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));return { index, text: strings[index], similarity }; }) .sort((left, right) => right.similarity - left.similarity);console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings( strings: list[str], index_of_source_string: int, model="text-embedding-3-small",) -> list[int]: """Return nearest neighbors of a given string.""" # get embeddings for all strings embeddings = [embedding_from_string(string, model=model) for string in strings] # get the embedding of the source string query_embedding = embeddings[index_of_source_string] # get distances between the source embedding and other embeddings (function from embeddings_utils.py) distances = distances_from_embeddings( query_embedding, embeddings, distance_metric="cosine" ) # get indices of nearest neighbors (function from embeddings_utils.py) indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances( distances ) return indices_of_nearest_neighbors
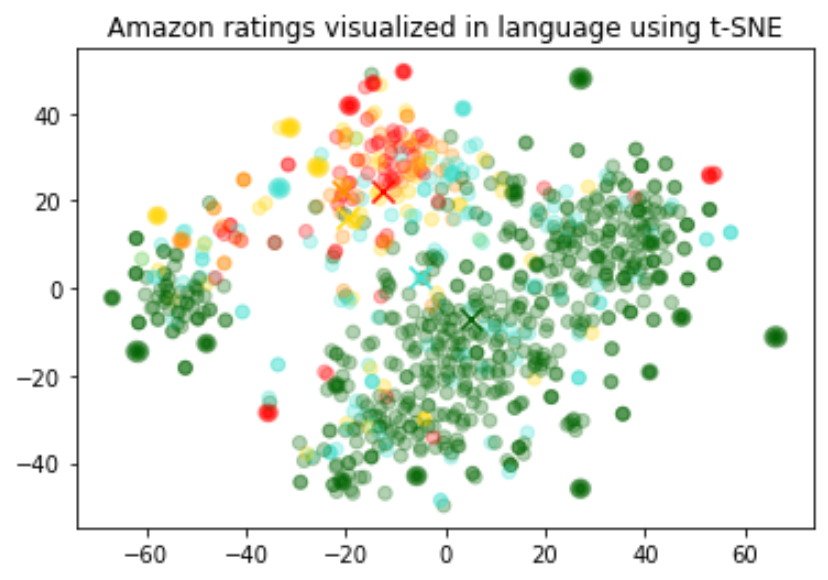
El tamaño de los embeddings varía según la complejidad del modelo subyacente. Para visualizar estos datos de alta dimensionalidad, usamos el algoritmo t-SNE para transformarlos a dos dimensiones.
Asignamos un color a cada reseña según la calificación en estrellas que le dio su autor:
1 estrella: rojo
2 estrellas: naranja oscuro
3 estrellas: dorado
4 estrellas: turquesa
5 estrellas: verde oscuro
La visualización parece haber producido aproximadamente 3 grupos, uno de los cuales contiene principalmente reseñas negativas.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import numpy as npimport pandas as pdfrom sklearn.manifold importTSNEimport matplotlib.pyplot as pltimport matplotlibdf = pd.read_csv("output/embedded_1k_reviews.csv")matrix = np.array(df.ada_embedding.apply(eval).to_list())# Create a t-SNE model and transform the datatsne = TSNE(n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200)vis_dims = tsne.fit_transform(matrix)colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]x = [x for x, y in vis_dims]y = [y for x, y in vis_dims]color_indices = df.Score.values -1colormap = matplotlib.colors.ListedColormap(colors)plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)plt.title("Amazon ratings visualized in language using t-SNE")
Un embedding puede usarse como codificador general de características de texto libre dentro de un modelo de aprendizaje automático. Incorporar embeddings mejorará el rendimiento de cualquier modelo de aprendizaje automático si algunas de las entradas relevantes son texto libre. Un embedding también puede usarse como codificador de características categóricas dentro de un modelo de aprendizaje automático. Esto aporta más valor cuando los nombres de las variables categóricas tienen significado y son numerosos, como los nombres de puestos de trabajo. Los embeddings de similitud suelen ofrecer un mejor rendimiento que los embeddings de búsqueda para esta tarea.
Observamos que, en general, la representación mediante embeddings es muy rica y concentra mucha información. Por ejemplo, reducir la dimensionalidad de las entradas mediante SVD o PCA, incluso en un 10 %, suele empeorar el rendimiento en tareas específicas posteriores.
Este código divide los datos en un conjunto de entrenamiento y uno de prueba, que se usarán en los dos casos de uso siguientes: regresión y clasificación.
Regresión con las características de los embeddings
Los embeddings ofrecen una forma elegante de predecir un valor numérico. En este ejemplo, predecimos la calificación en estrellas que dio el autor a partir del texto de su reseña. Como los embeddings contienen mucha información semántica, la predicción es aceptable incluso con muy pocas reseñas.
Suponemos que la calificación es una variable continua entre 1 y 5, y permitimos que el algoritmo prediga cualquier valor de punto flotante. El algoritmo de aprendizaje automático minimiza la distancia entre el valor predicho y la calificación real, y alcanza un error absoluto medio de 0,39. Esto significa que, en promedio, la predicción se desvía menos de media estrella.
Esta vez, en lugar de hacer que el algoritmo prediga cualquier valor entre 1 y 5, intentaremos clasificar las reseñas según su número exacto de estrellas en 5 categorías, de 1 a 5 estrellas.
Tras el entrenamiento, el modelo aprende a predecir las reseñas de 1 y 5 estrellas mucho mejor que las reseñas con más matices (de 2 a 4 estrellas), probablemente porque expresan sentimientos más extremos.
Podemos usar embeddings para realizar una clasificación sin ejemplos, sin datos de entrenamiento etiquetados. Para cada clase, generamos un embedding de su nombre o de una descripción breve. Para clasificar un texto nuevo sin ejemplos, comparamos su embedding con los de todas las clases y predecimos la clase con mayor similitud.
Podemos obtener el embedding de un usuario calculando el promedio de todas sus reseñas. Del mismo modo, podemos obtener el embedding de un producto calculando el promedio de todas las reseñas sobre ese producto. Para mostrar la utilidad de este enfoque, usamos un subconjunto de 50 000 reseñas que nos permite abarcar más reseñas por usuario y por producto.
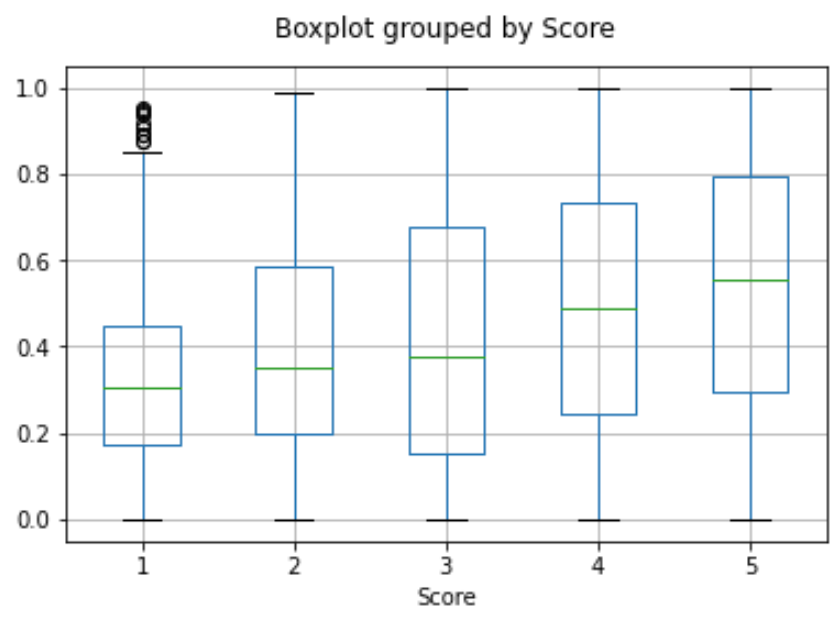
Evaluamos la utilidad de estos embeddings con un conjunto de prueba independiente, en el que graficamos la similitud entre el embedding del usuario y el del producto en función de la calificación. Curiosamente, con este enfoque podemos predecir si al usuario le gustaría el producto con una precisión superior al azar, incluso antes de que lo reciba.
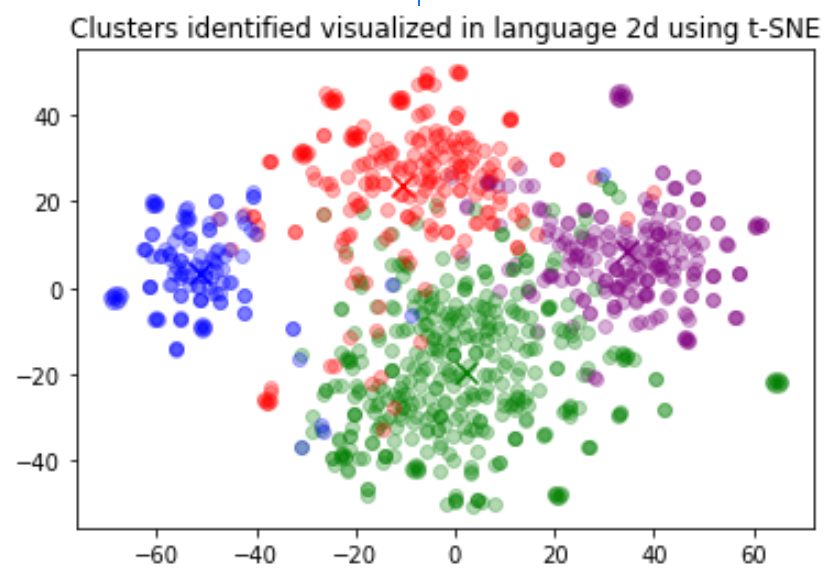
El agrupamiento es una forma de dar sentido a un gran volumen de datos textuales. Los embeddings son útiles para esta tarea porque proporcionan representaciones vectoriales que capturan el significado de cada texto. Así, el agrupamiento permite descubrir grupos ocultos en nuestro conjunto de datos de forma no supervisada.
En este ejemplo, descubrimos cuatro grupos distintos: uno centrado en comida para perros, otro en reseñas negativas y dos en reseñas positivas.
¿Cómo puedo saber cuántos tokens tiene una cadena antes de generar su embedding?
En Python, puedes dividir una cadena en tokens con tiktoken, el tokenizador de OpenAI.
Código de ejemplo:
1
2
3
4
5
6
7
8
9
10
11import tiktokendefnum_tokens_from_string(string: str, encoding_name: str) -> int:"""Returns the number of tokens in a text string.""" encoding = tiktoken.get_encoding(encoding_name) num_tokens =len(encoding.encode(string))return num_tokensnum_tokens_from_string("tiktoken is great!", "cl100k_base")
Para los modelos de embeddings de tercera generación, como text-embedding-3-small, usa la codificación cl100k_base.
¿Cómo puedo recuperar rápidamente los K vectores de embeddings más cercanos?
Para buscar rápidamente entre muchos vectores, recomendamos usar una base de datos vectorial. Puedes encontrar ejemplos de cómo trabajar con bases de datos vectoriales y la API de OpenAI en nuestro Cookbook en GitHub.
¿Qué función de distancia debo usar?
Recomendamos la similitud del coseno. Por lo general, la elección de la función de distancia no influye demasiado.
Los embeddings de OpenAI están normalizados a una longitud de 1, lo que significa que:
La similitud del coseno se puede calcular un poco más rápido usando solo un producto escalar
La similitud del coseno y la distancia euclidiana producen el mismo orden de resultados
¿Puedo compartir mis embeddings en línea?
Sí, los clientes son propietarios de los datos que ingresan a nuestros modelos y de los resultados que obtienen, incluidos los embeddings. Es tu responsabilidad asegurarte de que el contenido que ingresas a nuestra API no infrinja ninguna ley aplicable ni nuestros Términos de uso.
¿Los modelos de embeddings V3 conocen los acontecimientos recientes?
No, los modelos text-embedding-3-large y text-embedding-3-small no tienen conocimiento de los acontecimientos ocurridos después de septiembre de 2021. Por lo general, esto no supone una limitación tan grande como para los modelos de generación de texto, pero puede reducir el rendimiento en ciertos casos excepcionales.