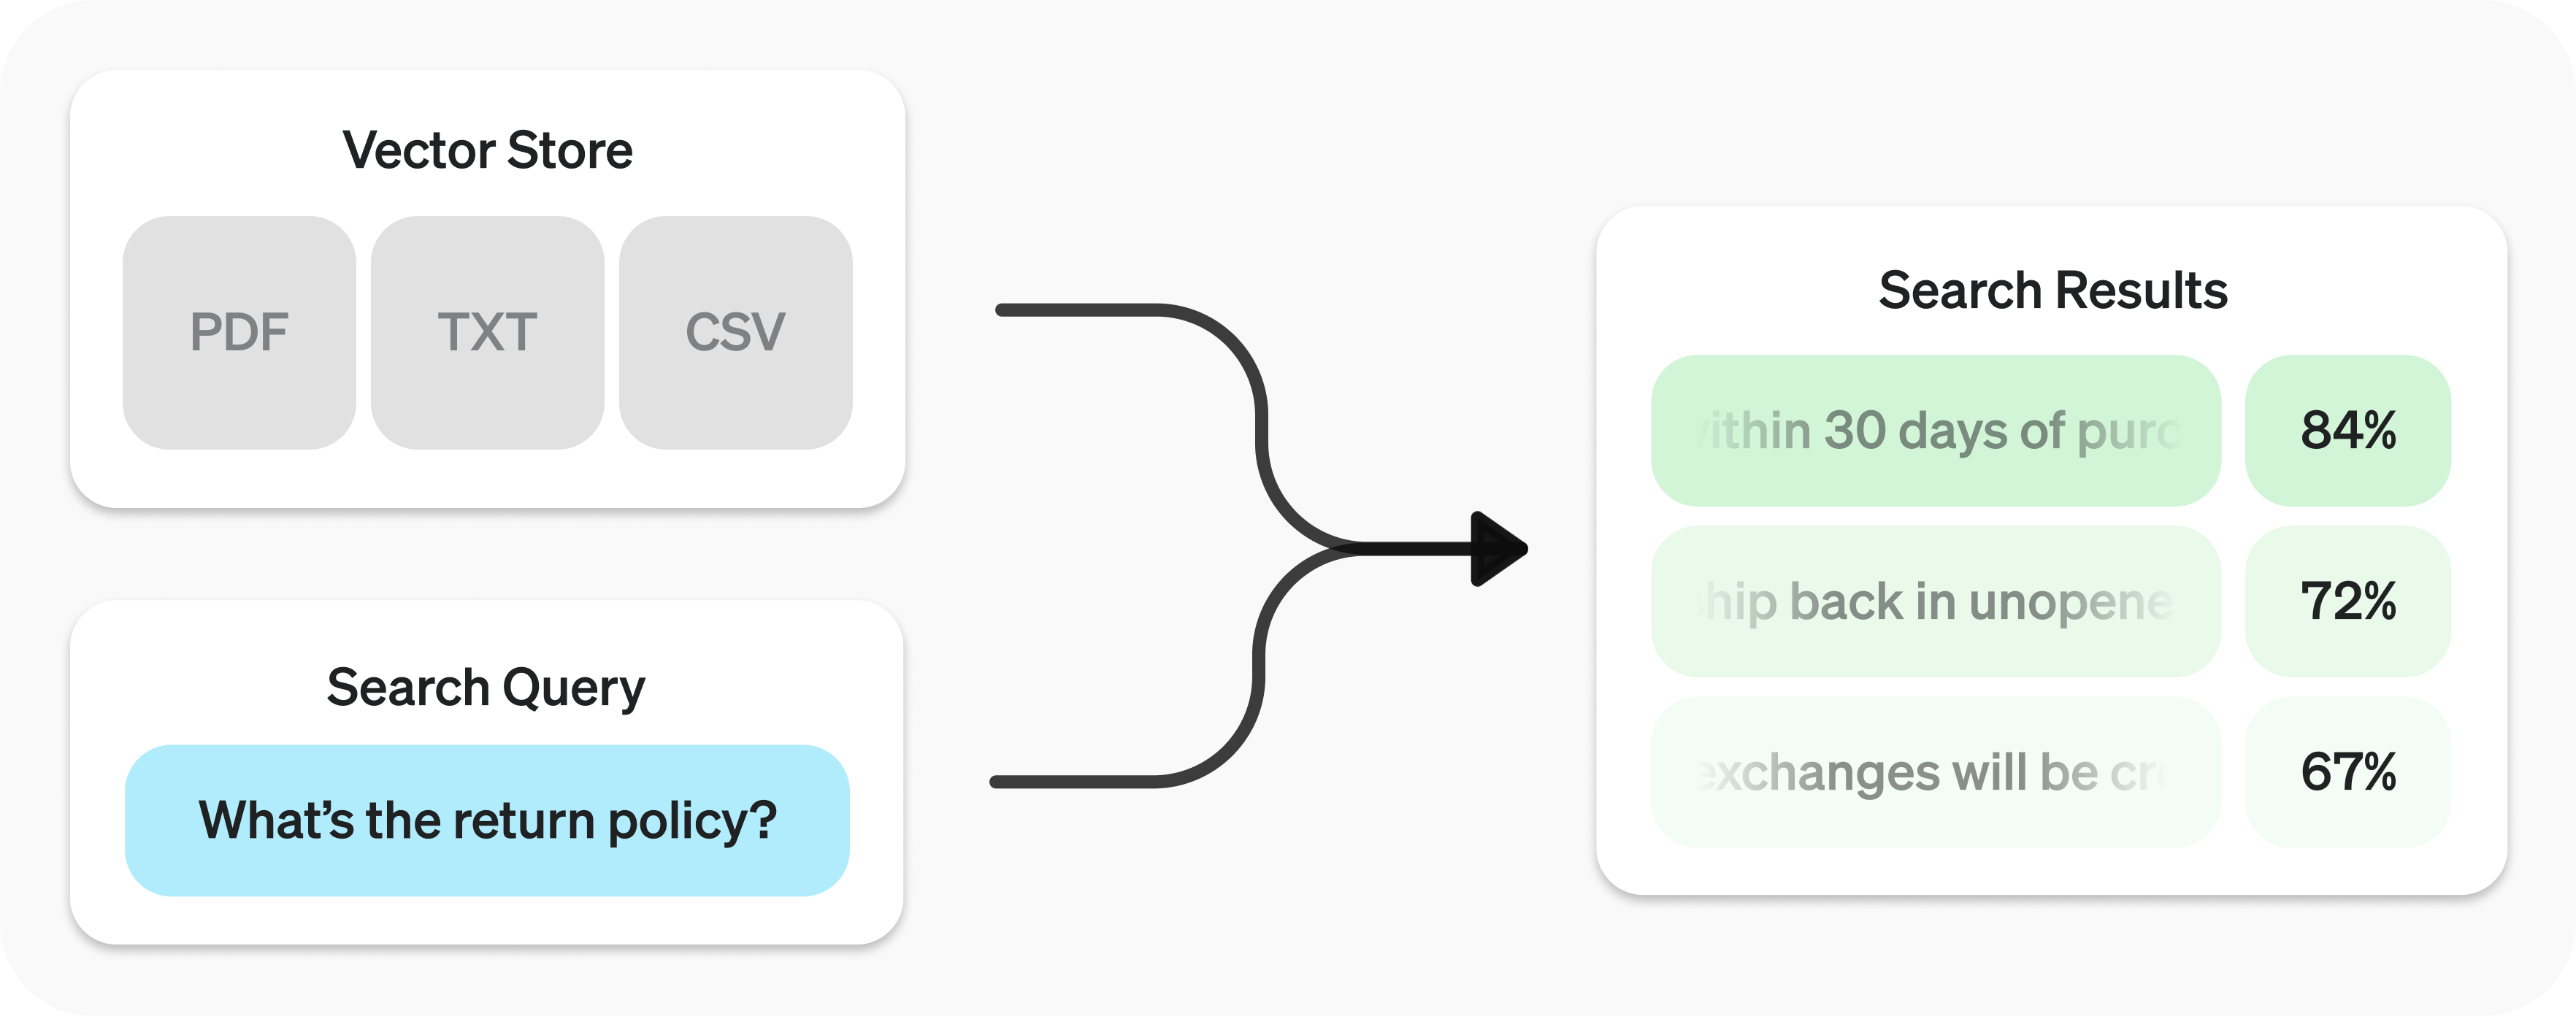
La API de recuperación te permite realizar búsquedas semánticas en tus datos. Esta técnica encuentra resultados semánticamente similares, incluso cuando coinciden pocas palabras clave o ninguna. La recuperación es útil por sí sola, pero resulta especialmente potente cuando se combina con nuestros modelos para sintetizar respuestas.
La API de recuperación utiliza almacenes vectoriales, que funcionan como índices para tus datos. Esta guía explica cómo realizar búsquedas semánticas y describe en detalle los almacenes vectoriales.
1
2
3
4
5require "openai"client = OpenAI::Client.newresults = client.vector_stores.search("vs_123", query: "What is the return policy?")puts(results.data&.first&.content)
Para aprender a usar los resultados con nuestros modelos, consulta la sección Síntesis de
respuestas.
Búsqueda semántica
La búsqueda semántica es una técnica que utiliza embeddings vectoriales para encontrar resultados semánticamente relevantes. Esto incluye resultados con pocas palabras clave en común o ninguna, que las técnicas de búsqueda tradicionales podrían pasar por alto.
Por ejemplo, veamos algunos resultados posibles para "When did we go to the moon?":
Texto
Similitud de palabras clave
Similitud semántica
El primer alunizaje ocurrió en julio de 1969.
0 %
65 %
El primer hombre en la Luna fue Neil Armstrong.
27 %
43 %
Cuando probé el pastel de luna, me pareció delicioso.
Observa cómo el resultado más relevante no contiene ninguna de las palabras de la consulta de búsqueda. Esta flexibilidad convierte la búsqueda semántica en una técnica potente para consultar bases de conocimiento de cualquier tamaño.
La búsqueda semántica utiliza almacenes vectoriales, que se describen en detalle más adelante en la guía. Esta sección se centra en el funcionamiento de la búsqueda semántica.
Realizar una búsqueda semántica
Puedes consultar un almacén vectorial con la función search, especificando una query en lenguaje natural. Esto devolverá una lista de resultados, cada uno con los fragmentos relevantes, las puntuaciones de similitud y el archivo de origen.
Consulta de búsqueda
Python
1
2
3const results = await client.vectorStores.search(vector_store.id, { query: "How many woodchucks are allowed per passenger?",});
1
2
3
4results = client.vector_stores.search(vector_store_id=vector_store.id,query="How many woodchucks are allowed per passenger?",)
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "How many woodchucks are allowed per passenger?")puts(results.data&.first&.content)
Resultados
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42{"object": "vector_store.search_results.page","search_query": "How many woodchucks are allowed per passenger?","data": [ {"file_id": "file-12345","filename": "woodchuck_policy.txt","score": 0.85,"attributes": {"region": "North America","author": "Wildlife Department" },"content": [ {"type": "text","text": "According to the latest regulations, each passenger is allowed to carry up to two woodchucks." }, {"type": "text","text": "Ensure that the woodchucks are properly contained during transport." } ] }, {"file_id": "file-67890","filename": "transport_guidelines.txt","score": 0.75,"attributes": {"region": "North America","author": "Transport Authority" },"content": [ {"type": "text","text": "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks." } ] } ],"has_more": false,"next_page": null}
De forma predeterminada, una respuesta contendrá un máximo de 10 resultados, pero puedes configurar hasta 50 con el parámetro max_num_results.
Reformulación de consultas
Ciertas formas de redactar las consultas producen mejores resultados, por lo que ofrecemos una opción para reformularlas automáticamente y optimizar su rendimiento. Activa esta función configurando rewrite_query=true al ejecutar search.
La consulta reformulada estará disponible en el campo search_query del resultado.
Original
Reformulada
Me gustaría saber la altura del edificio principal de oficinas.
altura del edificio principal de oficinas
¿Cuáles son las normas de seguridad para transportar materiales peligrosos?
normas de seguridad para materiales peligrosos
¿Cómo presento una queja por un problema con el servicio?
proceso para presentar una queja sobre el servicio
Filtrado por atributos
El filtrado por atributos permite acotar los resultados mediante criterios, como restringir las búsquedas a un intervalo de fechas específico. Puedes definir y combinar criterios en attribute_filter para seleccionar archivos según sus atributos antes de realizar la búsqueda semántica.
Usa filtros de comparación para comparar una key específica de los attributes de un archivo con un value determinado, y filtros compuestos para combinar varios filtros mediante and y or.
Filtro de comparación
1
2
3
4
5{"type": "eq"|"ne"|"gt"|"gte"|"lt"|"lte"|"in"|"nin", // comparison operators"key": "attributes_key", // attributes key"value": "target_value"// value to compare against}
Si los resultados de la búsqueda de archivos no son lo suficientemente relevantes, puedes ajustar ranking_options para mejorar la calidad de las respuestas. Esto incluye especificar un ranker, como auto o default-2024-08-21, y establecer un score_threshold entre 0,0 y 1,0. Un valor más alto de score_threshold limitará los resultados a los fragmentos más relevantes, aunque puede excluir algunos que podrían ser útiles. Cuando se proporciona ranking_options.hybrid_search, también puedes ajustar hybrid_search.embedding_weight (rrf_embedding_weight) y hybrid_search.text_weight (rrf_text_weight) para controlar cómo la fusión de rangos recíprocos equilibra las coincidencias semánticas de embeddings y las coincidencias de palabras clave con representaciones dispersas. Aumenta el primer peso para dar más importancia a la similitud semántica y el segundo para dar más importancia a la coincidencia textual, y asegúrate de que al menos uno de los pesos sea mayor que cero.
Almacenes vectoriales
Los almacenes vectoriales son los contenedores que permiten la búsqueda semántica en la API de recuperación y la herramienta de búsqueda de archivos. Cuando agregas un archivo a un almacén vectorial, se divide en fragmentos, se generan sus embeddings y se indexa automáticamente.
Los almacenes vectoriales contienen objetos vector_store_file, cada uno de los cuales se basa en un objeto file.
Tipo de objeto
Descripción
file
Representa contenido cargado mediante la API de archivos. Suele usarse con almacenes vectoriales, pero también para el ajuste fino y otros casos de uso.
vector_store
Contenedor de archivos en los que se pueden realizar búsquedas.
vector_store.file
Tipo contenedor que representa específicamente un file que se ha dividido en fragmentos, para el que se han generado embeddings y que se ha asociado con un vector_store. Contiene un mapa attributes que se usa para filtrar.
Precios
Se te cobrará según el almacenamiento total utilizado en todos tus almacenes vectoriales, determinado por el tamaño de los fragmentos analizados y sus embeddings correspondientes.
Almacenamiento
Costo
Hasta 1 GB (entre todos los almacenes)
Gratis
Más de 1 GB
$0,10/GB/día
Consulta las políticas de vencimiento para conocer las opciones que permiten minimizar los costos.
Algunas operaciones, como create para vector_store.file, son asíncronas y pueden tardar en completarse. Usa nuestras funciones auxiliares, como create_and_poll, para bloquear la ejecución hasta que se completen. También puedes consultar el estado. La eliminación de archivos de un almacén vectorial presenta consistencia eventual, y los resultados de búsqueda pueden seguir incluyendo contenido de un archivo eliminado durante un breve período.
Al crear un lote, puedes proporcionar file_ids con attributes y/o chunking_strategy opcionales, o usar el arreglo files para pasar objetos que incluyan un file_id y, de forma opcional, attributes y chunking_strategy para cada archivo. Las dos opciones son mutuamente excluyentes, lo que te permite controlar con claridad si todos los archivos comparten la misma configuración o si necesitas ajustes específicos para cada archivo.
Para lograr un mayor rendimiento de ingesta en un solo almacén vectorial, recomendamos crear archivos por lotes siempre que sea posible. Los lotes pueden incluir hasta 500 archivos en una sola solicitud, lo que suele reducir la contención y mejorar la latencia de extremo a extremo en comparación con el envío de muchas solicitudes de creación de archivos individuales.
Atributos
Cada vector_store.file puede tener un diccionario attributes asociado, cuyos valores se pueden consultar al realizar una búsqueda semántica con filtrado por atributos. El diccionario puede tener un máximo de 16 claves, con un límite de 256 caracteres cada una.
Crear un archivo en un almacén vectorial con atributos
Puedes establecer una política de vencimiento para los objetos vector_store con expires_after. Cuando venza un almacén vectorial, se eliminarán todos los objetos vector_store.file asociados y dejarán de generar cargos.
Establecer una política de vencimiento para un almacén vectorial
El tamaño máximo de archivo es de 512 MB. Cada archivo debe contener como máximo 5 000 000 de tokens (la cantidad se calcula automáticamente al adjuntar un archivo).
División en fragmentos
De forma predeterminada, max_chunk_size_tokens se establece en 800 y chunk_overlap_tokens en 400. Esto significa que cada archivo se indexa dividiéndolo en fragmentos de 800 tokens, con una superposición de 400 tokens entre fragmentos consecutivos.
Puedes ajustar este comportamiento configurando chunking_strategy al agregar archivos al almacén vectorial. La estrategia tiene ciertas limitaciones:
max_chunk_size_tokens debe estar entre 100 y 4096, ambos incluidos.
chunk_overlap_tokens debe ser mayor o igual que cero y no debería superar max_chunk_size_tokens / 2.
Para los tipos MIME text/, la codificación debe ser utf-8, utf-16 o ascii.
Después de realizar una consulta, quizá quieras sintetizar una respuesta a partir de los resultados. Para hacerlo, puedes proporcionar los resultados y la consulta original a nuestros modelos y obtener una respuesta fundamentada en ellos.
Realizar una consulta de búsqueda para obtener resultados
Python
1
2
3
4
5
6
7
8
9import OpenAI from "openai";const client = new OpenAI();const userQuery = "What is the return policy?";const results = await client.vectorStores.search(vector_store.id, { query: userQuery,});
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "What is the return policy?")puts(results.data)
Sintetizar una respuesta a partir de los resultados
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22const formattedResults = formatResults(results.data);// Join the text content of all resultsconst textSources = results.data .map((result) => result.content.map((c) => c.text).join("\n")) .join("\n");const completion = await client.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "developer", content: "Produce a concise answer to the query based on the provided sources.", }, { role: "user", content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`, }, ],});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20# Use results and user_query from the preceding search step.formatted_results = format_results(results.data)"\n".join("\n".join(c.text for c in result.content) for result in results.data)completion = client.chat.completions.create(model="gpt-6-astra",messages=[ {"role": "developer","content": "Produce a concise answer to the query based on the provided sources.", }, {"role": "user","content": f"Sources: {formatted_results}\n\nQuery: '{user_query}'", }, ],)print(completion.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46package mainimport ( "context" "fmt" "strings" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() userQuery := "What is the return policy?" results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{ Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)}, }) if err != nil { panic(err) } completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."), openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}func formatResults(results []openai.VectorStoreSearchResponse) string { var sources strings.Builder sources.WriteString("<sources>") for _, result := range results { fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename) for _, content := range result.Content { fmt.Fprintf(&sources, "<content>%s</content>", content.Text) } sources.WriteString("</result>") } sources.WriteString("</sources>") return sources.String()}