
Esta guía presenta los principios fundamentales que puedes aplicar para reducir la latencia en una amplia variedad de casos de uso relacionados con LLM. Estas técnicas surgen del trabajo con una gran variedad de clientes y desarrolladores en aplicaciones en producción, por lo que deberían servirte sin importar qué estés creando, desde un flujo de trabajo específico hasta una aplicación de chat completa.
Aunque existen muchas técnicas individuales, esta guía las agrupa en siete principios que ofrecen una clasificación general de los enfoques para reducir la latencia.
Al final, revisaremos un ejemplo para ver cómo se pueden aplicar.
Siete principios
- Procesa los tokens más rápido.
- Genera menos tokens.
- Usa menos tokens de entrada.
- Realiza menos solicitudes.
- Paraleliza.
- Haz que tus usuarios esperen menos.
- No recurras a un LLM por defecto.
Procesa los tokens más rápido
La velocidad de inferencia probablemente sea lo primero que se te ocurra al abordar la latencia (pero, como verás pronto, está lejos de ser lo único). Se refiere a la velocidad real a la que el LLM procesa los tokens y suele medirse en TPM (tokens por minuto) o TPS (tokens por segundo).
El principal factor que influye en la velocidad de inferencia es el tamaño del modelo: los modelos más pequeños suelen ejecutarse más rápido (y a menor costo) y, si se usan correctamente, pueden incluso superar a los modelos más grandes. Para mantener un desempeño de alta calidad con modelos más pequeños, puedes explorar las siguientes opciones:
- usar un prompt más detallado y extenso,
- añadir unos pocos ejemplos (o más), o
- aplicar ajuste fino / destilación.
También puedes emplear optimizaciones de inferencia como nuestra función de resultados predichos. Los resultados predichos te permiten reducir significativamente la latencia de una generación cuando conoces de antemano la mayor parte de la salida, como en las tareas de edición de código. Al darle una predicción al modelo, el LLM puede centrarse más en los cambios reales y menos en el contenido que permanecerá igual.
Otros factores que afectan la velocidad de inferencia son la capacidad de
cómputo que tienes disponible y las
optimizaciones adicionales de inferencia que empleas.
La mayoría de las personas no puede influir directamente en estos factores, pero si te interesa y
tienes cierto control sobre tu infraestructura, un hardware más rápido o
ejecutar los motores con un menor nivel de saturación puede darte un aumento modesto
de TPM. Y si trabajas de lleno en estos aspectos técnicos, hay muchas otras
optimizaciones de inferencia
que quedan un poco fuera del alcance de esta guía.
Genera menos tokens
Generar tokens casi siempre es el paso de mayor latencia al usar un LLM: como regla general, reducir un 50 % los tokens de salida puede reducir la latencia en aproximadamente un 50 %. La manera de reducir el tamaño de la salida dependerá de su tipo:
Si estás generando lenguaje natural, puede ser útil pedirle al modelo que sea más conciso (“menos de 20 palabras” o “sé breve”). También puedes usar unos pocos ejemplos y/o ajuste fino para enseñarle al modelo a dar respuestas más cortas.
Si estás generando un resultado estructurado, intenta reducir al mínimo la sintaxis de la salida siempre que sea posible: acorta los nombres de las funciones, omite los argumentos con nombre, combina parámetros, etc.
Por último, aunque no es habitual, también puedes usar max_tokens o stop_tokens para finalizar la generación antes de tiempo.
Recuerda siempre: ¡un token de salida menos es un (mili)segundo ganado!
Usa menos tokens de entrada
Aunque reducir la cantidad de tokens de entrada sí disminuye la latencia, por lo general no es un factor significativo: reducir tu prompt un 50 % puede mejorar la latencia apenas entre un 1 y un 5 %. A menos que trabajes con contextos realmente enormes (documentos, imágenes), quizá te convenga concentrar tus esfuerzos en otros aspectos.
Dicho esto, si sí trabajas con contextos enormes (o estás decidido a aprovechar hasta el último recurso para mejorar el rendimiento y ya agotaste todas las demás opciones), puedes usar las siguientes técnicas para reducir los tokens de entrada:
- Aplicar ajuste fino al modelo para eliminar la necesidad de instrucciones / ejemplos extensos.
- Filtrar el contexto de entrada, por ejemplo, recortando los resultados de RAG, limpiando el HTML, etc.
- Maximizar el prefijo compartido del prompt colocando las partes dinámicas (por ejemplo, los resultados de RAG y el historial) más adelante en el prompt. Esto permite que tu solicitud aproveche mejor la caché KV (que usan la mayoría de los proveedores de LLM) y reduce la cantidad de tokens de entrada que se procesan en cada solicitud.
Consulta nuestra documentación para conocer mejor cómo funciona el almacenamiento en caché de prompts .
Realiza menos solicitudes
Cada vez que realizas una solicitud, se genera cierta latencia de ida y vuelta que puede ir acumulándose.
Si el LLM debe realizar pasos secuenciales, en lugar de enviar una solicitud por paso, considera reunirlos en un solo prompt y obtener todos los resultados en una sola respuesta. Evitarás la latencia adicional de ida y vuelta y posiblemente también reducirás la complejidad de procesar varias respuestas.
Una forma de hacerlo es reunir los pasos en una lista numerada dentro del prompt combinado y luego pedirle al modelo que devuelva los resultados en campos con nombre de un objeto JSON. Así podrás analizar y referenciar cada resultado.
Paraleliza
El procesamiento en paralelo puede ser muy útil al realizar varios pasos con un LLM.
Si los pasos no son estrictamente secuenciales, puedes separarlos en llamadas paralelas. Dos camisas tardan lo mismo en secarse que una.
Sin embargo, si los pasos sí son estrictamente secuenciales, quizá aún puedas aprovechar la ejecución especulativa. Esto es especialmente eficaz en pasos de clasificación en los que un resultado es más probable que los demás (por ejemplo, la moderación).
- Inicia el paso 1 y el paso 2 al mismo tiempo (por ejemplo, la moderación de la entrada y la generación de una historia)
- Verifica el resultado del paso 1
- Si el resultado no fue el esperado, cancela el paso 2 (y vuelve a intentarlo si es necesario)
Si tu predicción para el paso 1 es correcta, ¡en la práctica habrás logrado ejecutarlo sin agregar latencia!
Haz que tus usuarios esperen menos
Hay una gran diferencia entre esperar y ver cómo avanza el proceso. Asegúrate de que tus usuarios tengan esta última experiencia. Estas son algunas técnicas:
- Streaming: es el enfoque más eficaz, ya que reduce el tiempo de espera a un segundo o menos. (La experiencia de usar ChatGPT sería muy distinta si no vieras nada hasta que cada respuesta estuviera completa).
- División en fragmentos: si la salida necesita más procesamiento antes de mostrarse al usuario (moderación, traducción), considera procesarla por fragmentos en lugar de toda a la vez. Para ello, transmítela mediante streaming al backend y luego envía los fragmentos procesados al frontend.
- Muestra los pasos: si realizas varios pasos o usas herramientas, muéstraselo al usuario. Cuanto más progreso real puedas mostrar, mejor.
- Estados de carga: los indicadores de carga y las barras de progreso ayudan mucho.
Ten en cuenta que, si bien mostrar los pasos y los estados de carga tiene un efecto principalmente psicológico, el streaming y la división en fragmentos sí reducen la latencia total al considerar el sistema formado por la aplicación y el usuario: el usuario terminará de leer la respuesta antes.
No recurras a un LLM por defecto
Los modelos de lenguaje son potentes y versátiles, por lo que a veces se usan en casos en los que sería más apropiado un método tradicional más rápido . Identificar esos casos puede permitirte reducir considerablemente la latencia. Considera los siguientes ejemplos:
- Definir contenido fijo en el código: si la salida está muy acotada, quizá no necesites un LLM para generarla. Las confirmaciones de acciones, los mensajes de rechazo y las solicitudes de datos habituales son buenos candidatos para definirse directamente en el código. (Incluso puedes recurrir al método de siempre: crear algunas variantes de cada uno).
- Calcular de antemano: si la entrada está acotada (por ejemplo, una selección de categoría), puedes generar varias respuestas con anticipación y simplemente asegurarte de no mostrarle nunca la misma dos veces a un usuario.
- Aprovechar la interfaz de usuario: a veces, las métricas resumidas, los informes o los resultados de búsqueda se comunican mejor con componentes tradicionales de interfaz diseñados a medida que con texto generado por un LLM.
- Técnicas tradicionales de optimización: una aplicación con LLM sigue siendo una aplicación; la búsqueda binaria, el almacenamiento en caché, los mapas hash y la complejidad temporal siguen siendo útiles en un mundo de modelos de lenguaje.
Ejemplo
¡Veamos ahora una aplicación de ejemplo, identifiquemos posibles optimizaciones de latencia y propongamos algunas soluciones!
Analizaremos la arquitectura y los prompts de un bot hipotético de atención al cliente inspirado en aplicaciones reales en producción. La sección Arquitectura y prompts presenta el contexto, y la sección Análisis y optimizaciones explica paso a paso el proceso de optimización de la latencia.
Notarás que este ejemplo no abarca todos los principios, del mismo modo que los casos de uso reales no requieren aplicar todas las técnicas.
Arquitectura y prompts
La siguiente es la arquitectura inicial de un bot de atención al cliente hipotético. Sobre esta arquitectura haremos los cambios.
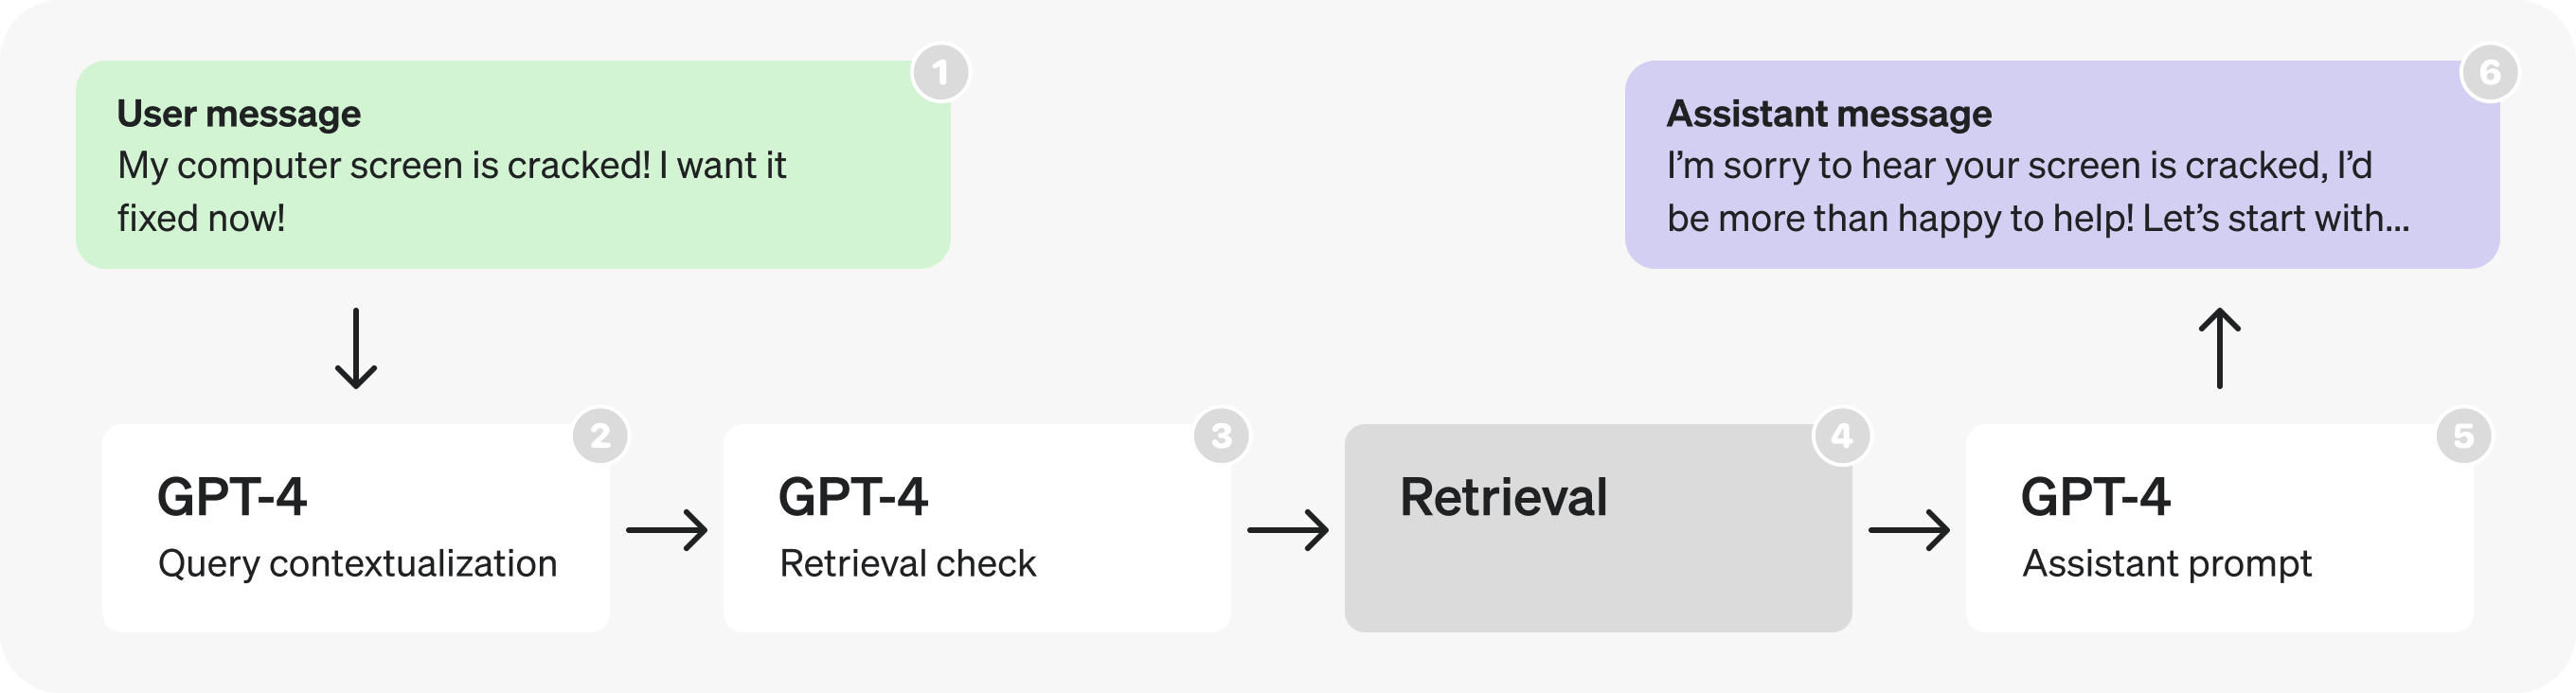
En términos generales, el flujo del diagrama describe el siguiente proceso:
- Un usuario envía un mensaje como parte de una conversación en curso.
- El último mensaje se convierte en una consulta que se entiende por sí sola (consulta los ejemplos del prompt).
- Determinamos si se necesita información adicional (recuperada) para responder a esa consulta.
- Se realiza la recuperación y se obtienen resultados de búsqueda.
- El asistente razona sobre la consulta del usuario y los resultados de búsqueda, y genera una respuesta.
- La respuesta se envía al usuario.
A continuación se muestran los prompts utilizados en cada parte del diagrama. Aunque siguen siendo hipotéticos y simplificados, tienen la misma estructura y redacción que encontrarías en una aplicación en producción.
Los marcadores de posición como “[user input here]” representan partes dinámicas que se reemplazarían por datos reales durante la ejecución.
Análisis y optimizaciones
Parte 1: análisis de los prompts de recuperación
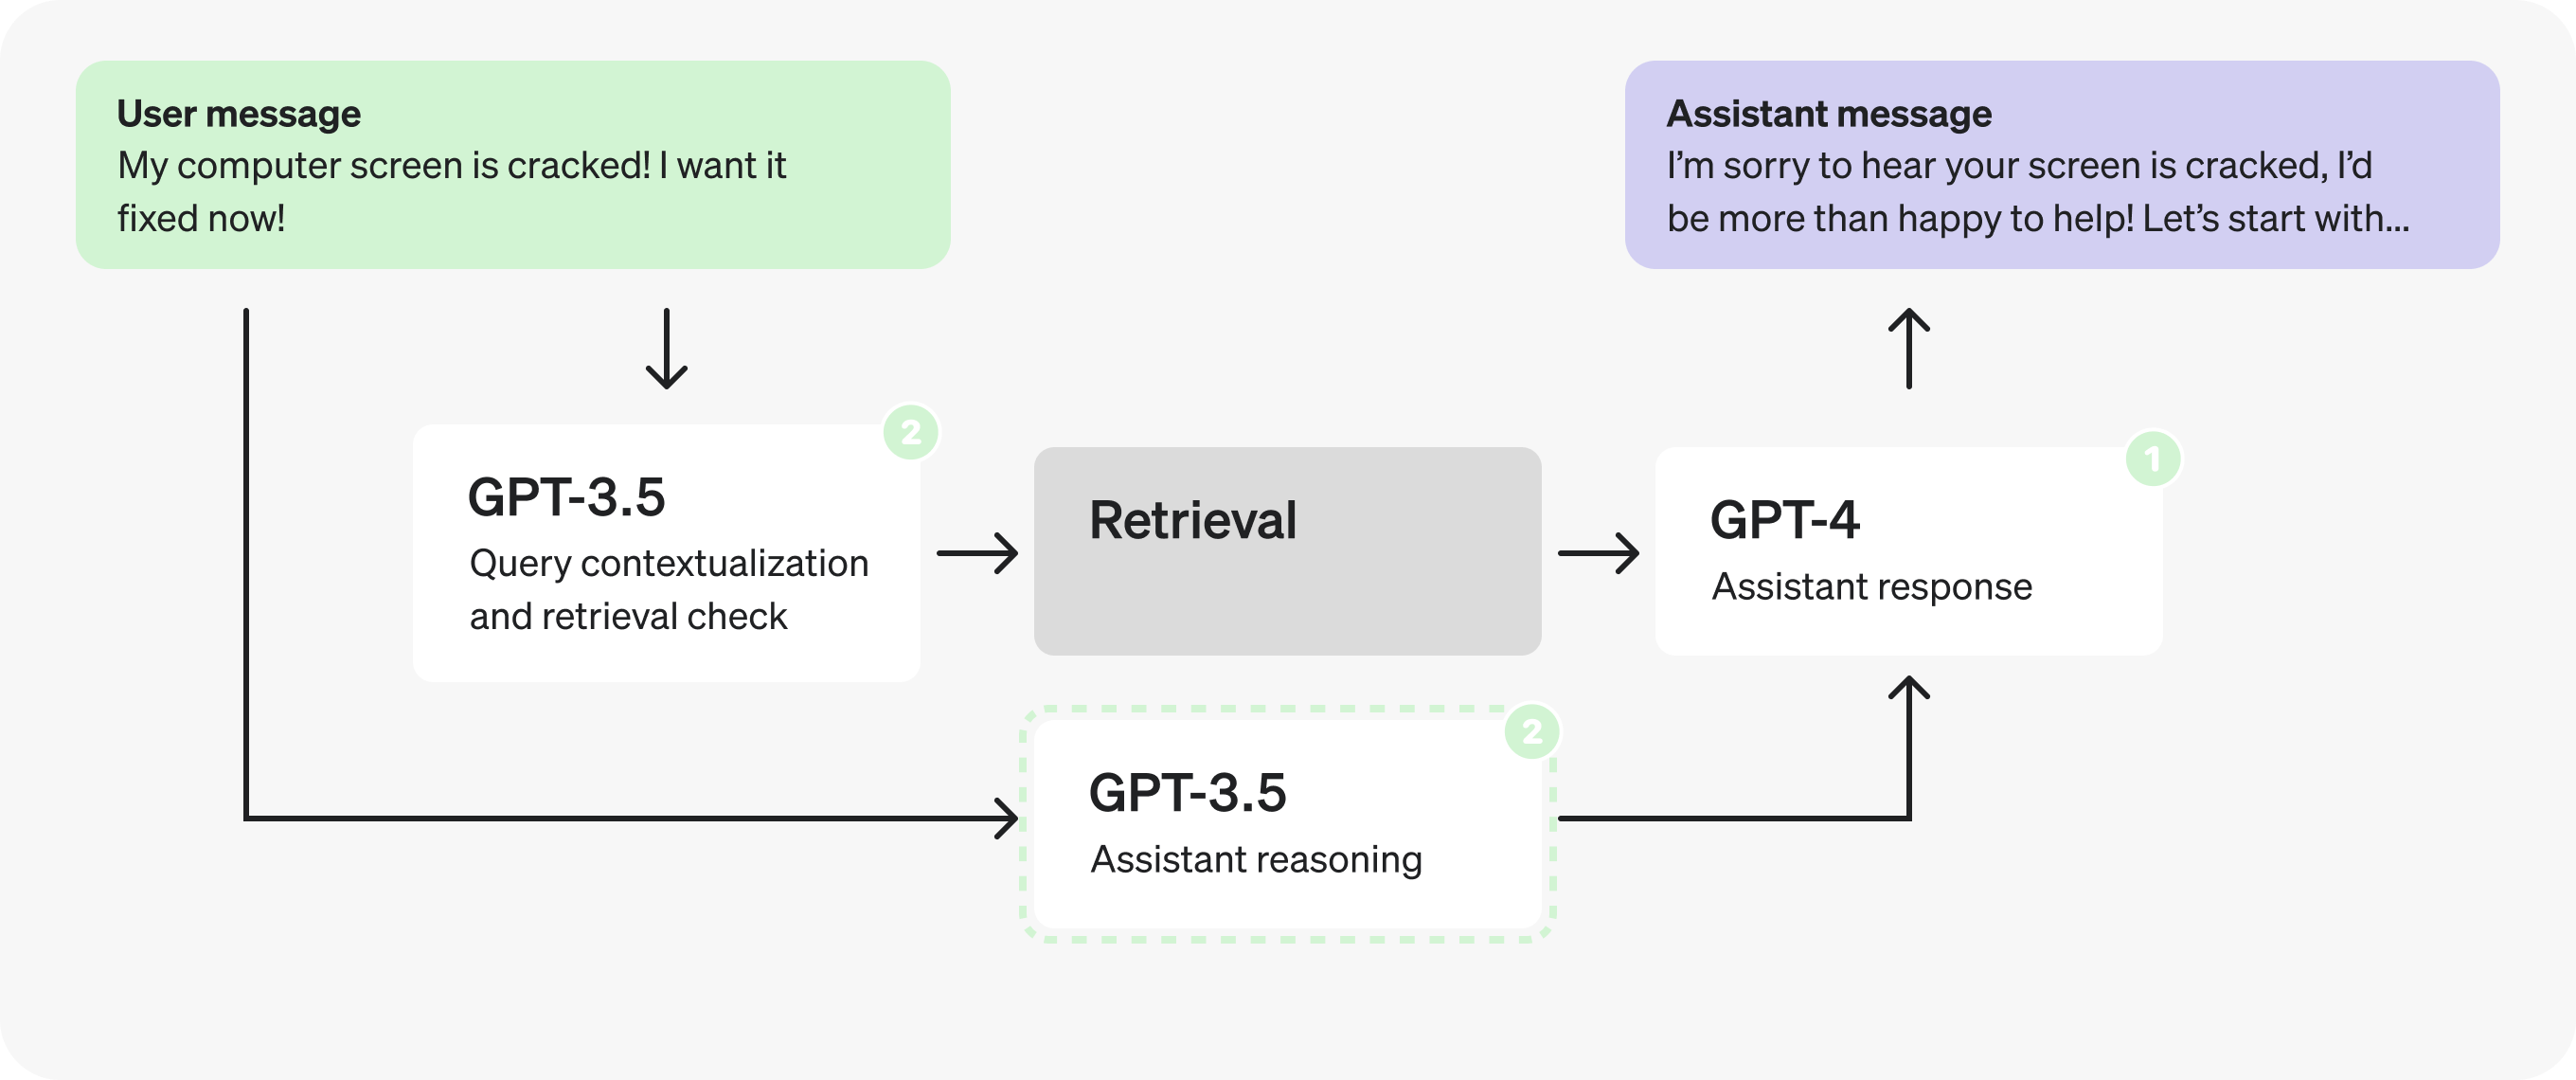
Al observar la arquitectura, lo primero que destaca son las llamadas consecutivas a GPT-4 . Estas sugieren una posible ineficiencia y, a menudo, se pueden reemplazar por una sola llamada o por llamadas en paralelo.
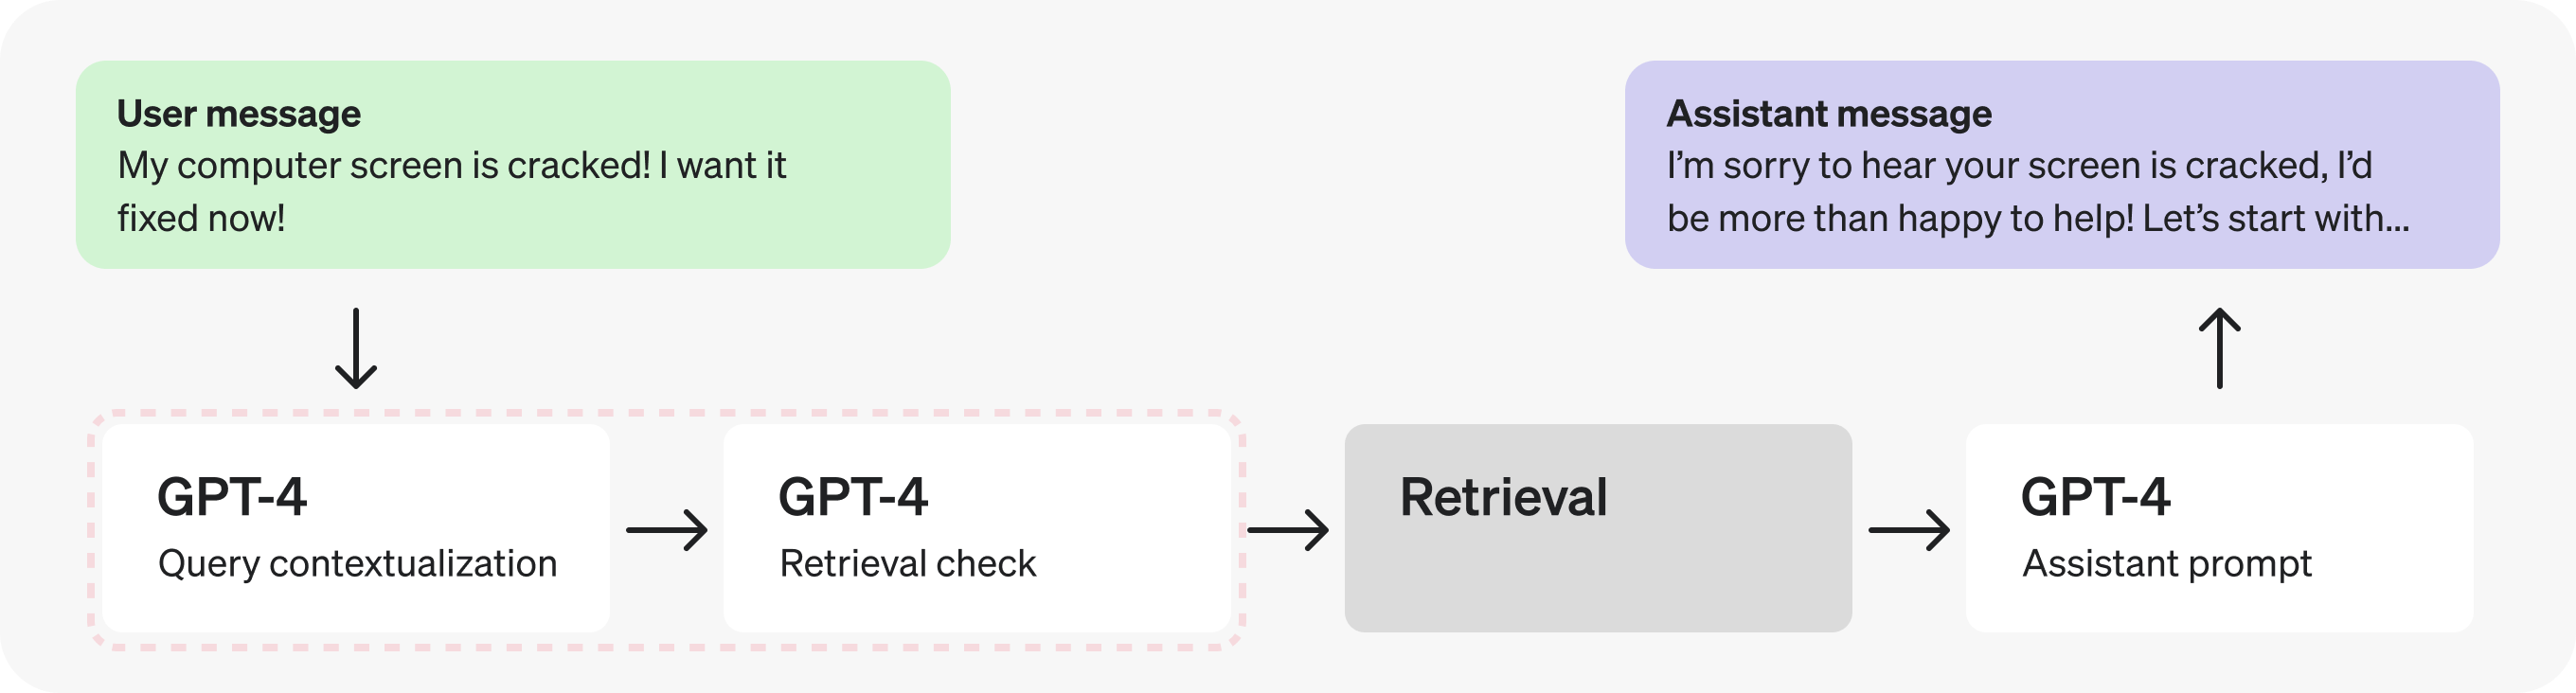
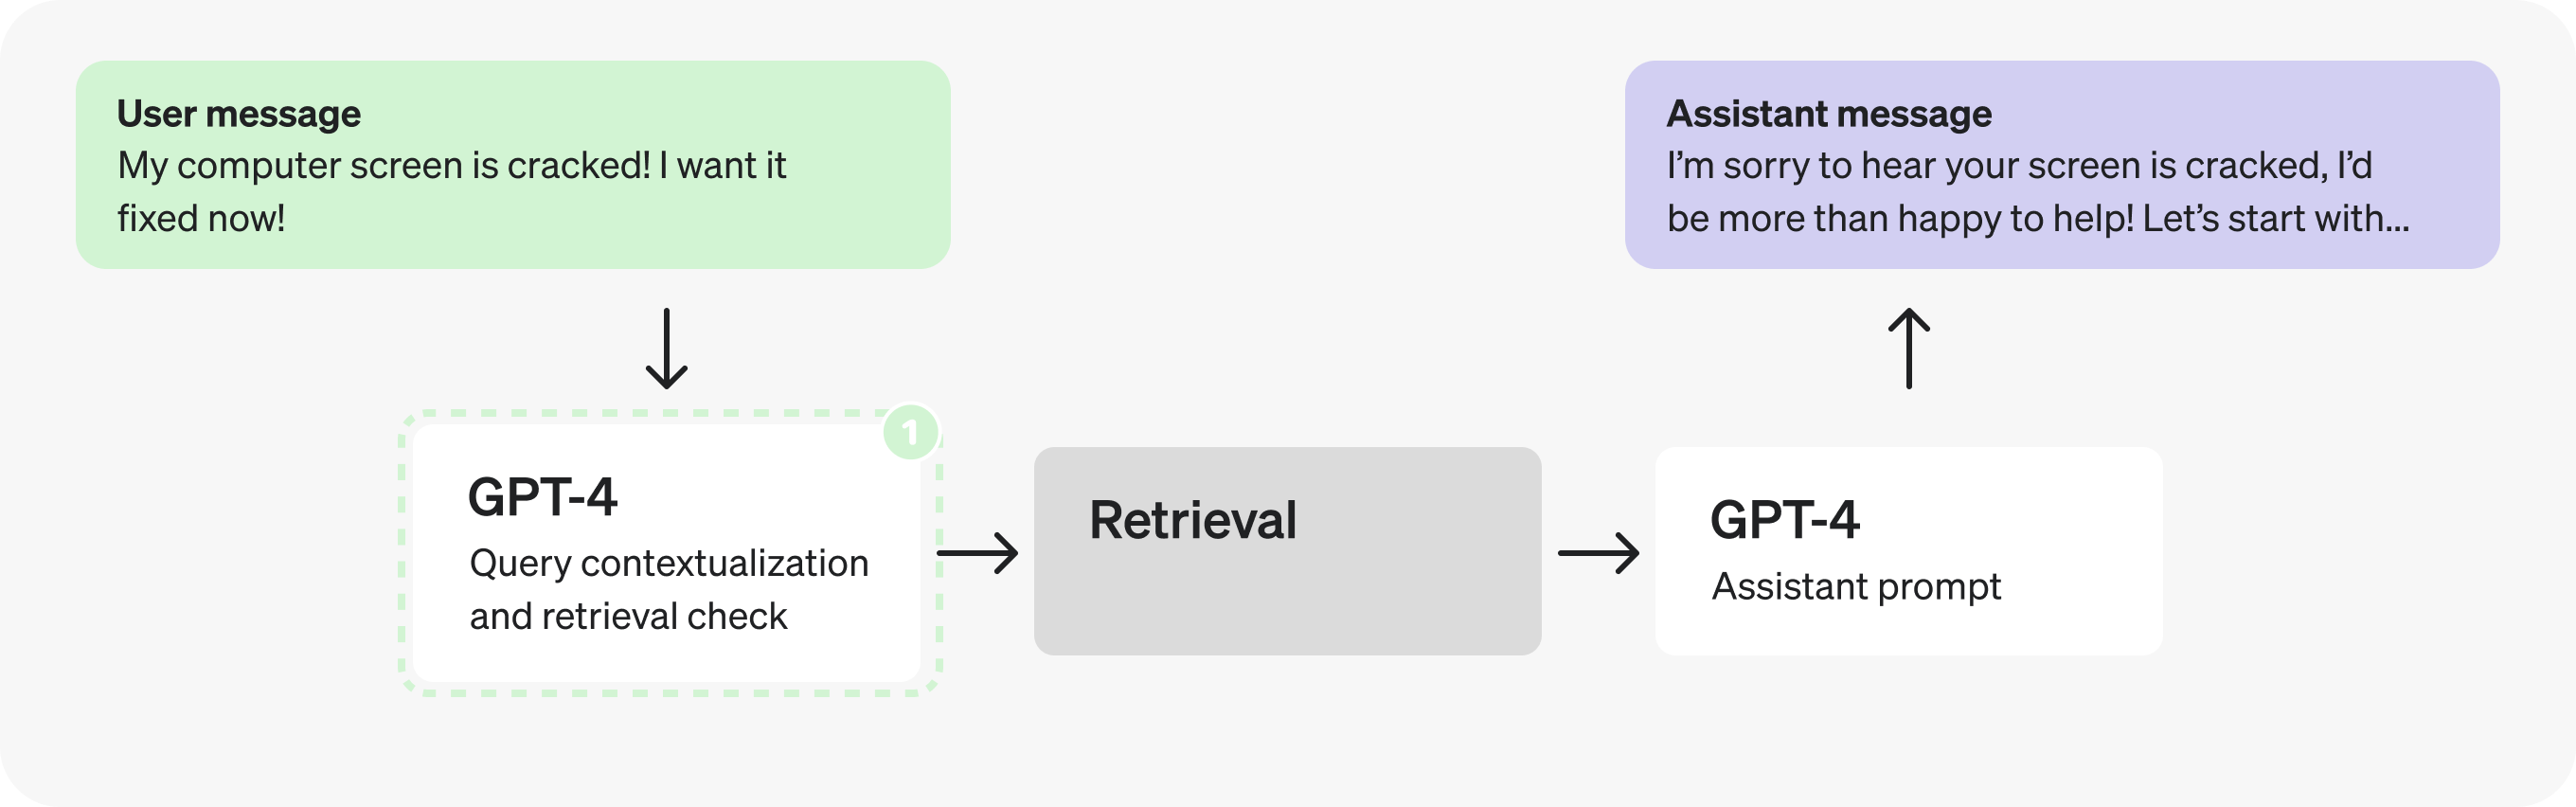
En este caso, como verificar si se necesita recuperar información requiere la consulta contextualizada, combinemos ambos pasos en un solo prompt para hacer menos solicitudes.
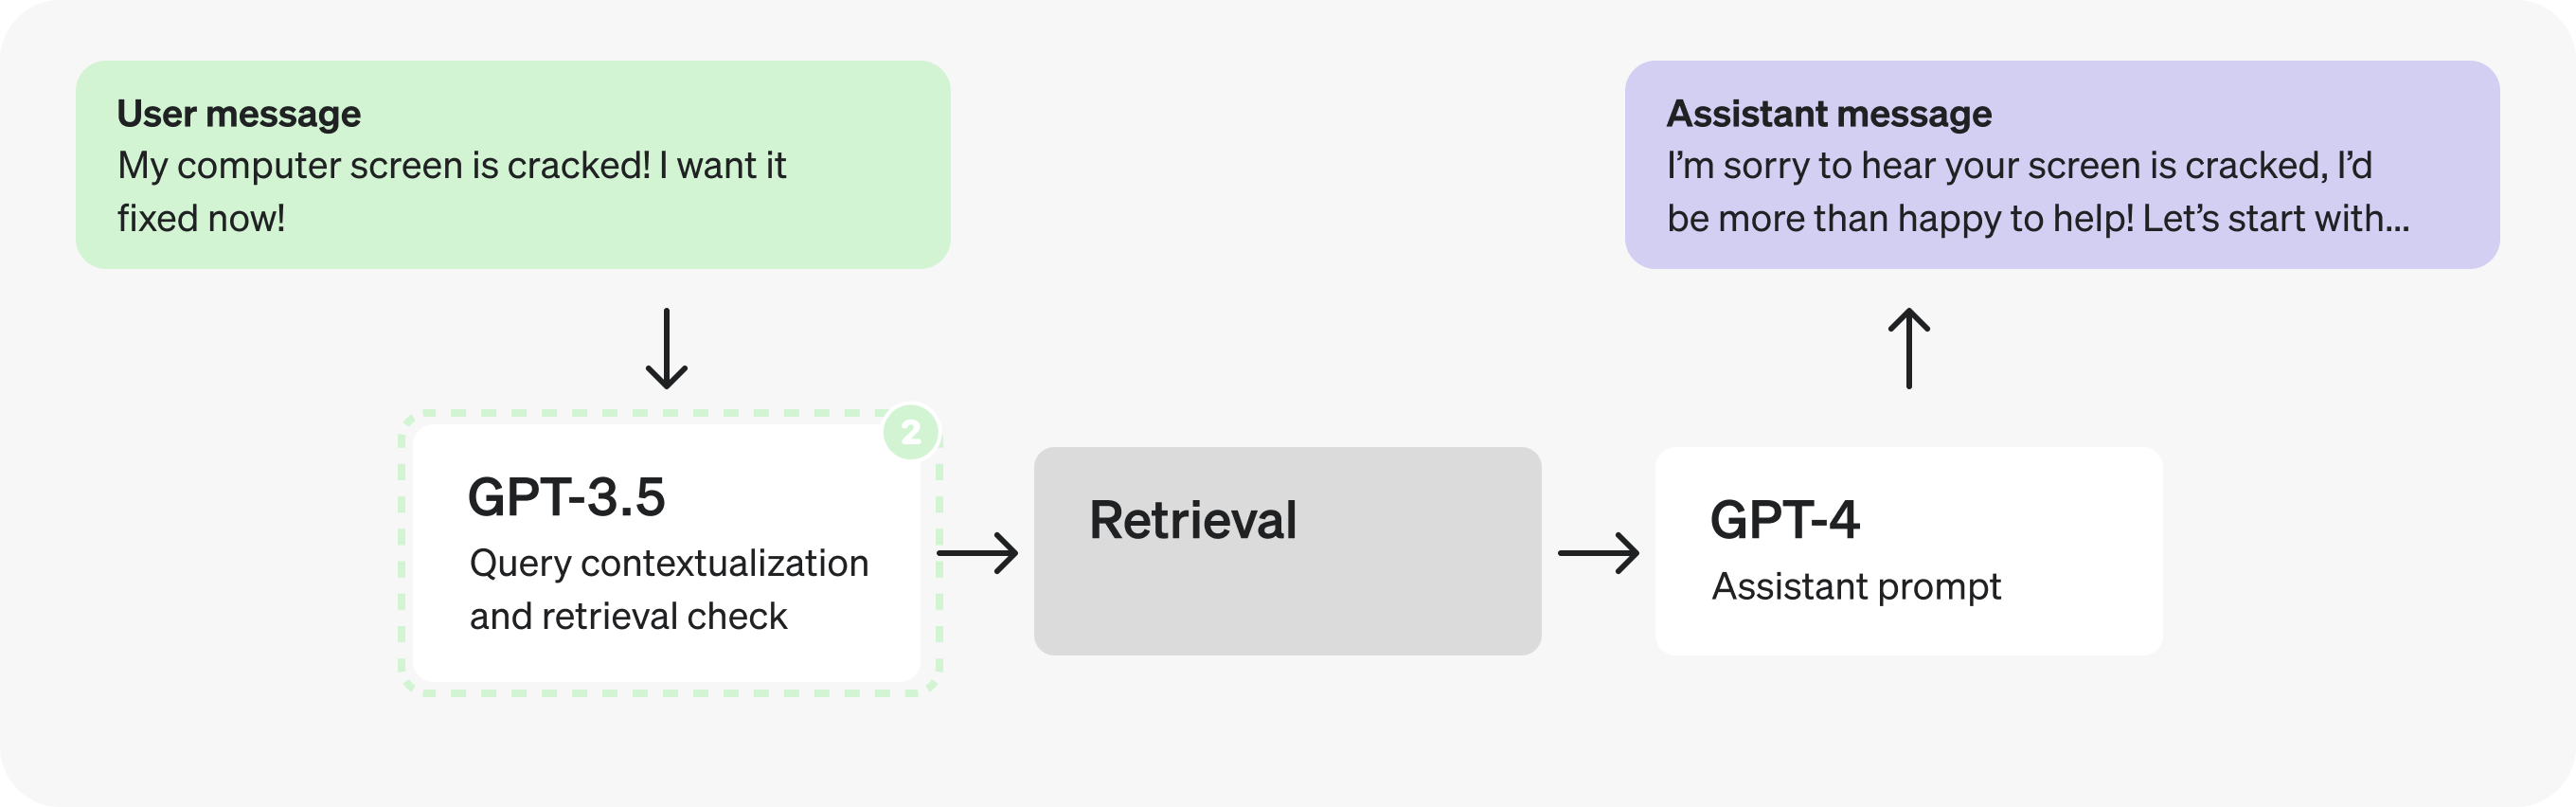
En realidad, agregar contexto y determinar si se necesita recuperar información son tareas sencillas y bien definidas, por lo que probablemente podamos usar un modelo más pequeño con ajuste fino . Cambiar a GPT-3.5 nos permitirá procesar tokens más rápido.
Parte 2: análisis del prompt del asistente
Centrémonos ahora en el prompt del asistente. Parece que se realizan muchos pasos distintos al completar los campos del JSON, lo que podría indicar una oportunidad para paralelizar.
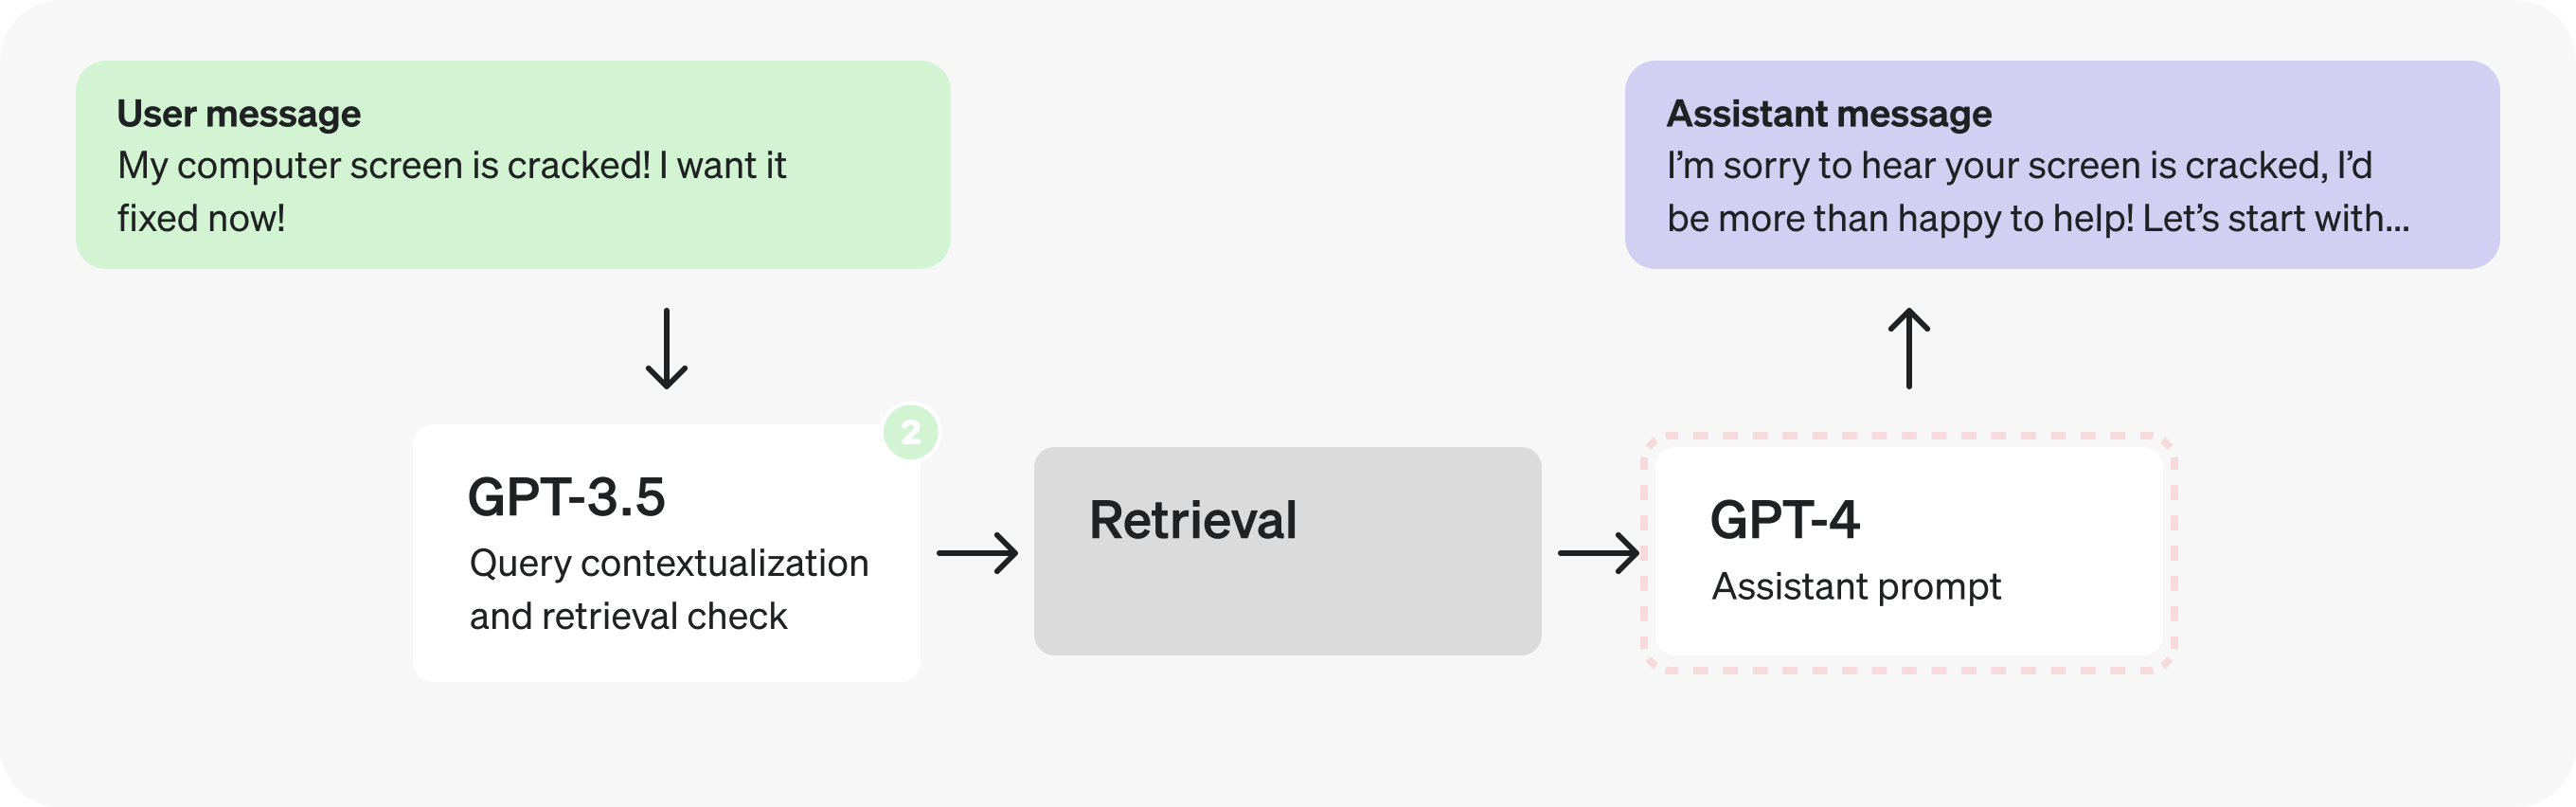
Sin embargo, supongamos que hicimos algunas pruebas y descubrimos que separar los pasos de razonamiento del JSON produce peores respuestas, por lo que necesitamos explorar otras soluciones.
¿Podríamos usar GPT-3.5 con ajuste fino en lugar de GPT-4? Tal vez, pero, en general, es mejor dejar las respuestas abiertas de los asistentes a GPT-4, ya que puede manejar mejor una mayor variedad de casos. Dicho esto, si analizamos los pasos de razonamiento en sí, es posible que no todos requieran un razonamiento del nivel de GPT-4. Su alcance limitado y bien definido los convierte en posibles buenos candidatos para el ajuste fino.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
}Esto plantea una decisión con ventajas y desventajas. ¿Mantenemos una sola solicitud cuya respuesta genere íntegramente GPT-4 o la dividimos en dos solicitudes secuenciales y usamos GPT-3.5 para todo excepto la respuesta final? Tenemos un caso de principios en conflicto: la primera opción nos permite hacer menos solicitudes, pero la segunda podría permitirnos procesar tokens más rápido.
Como ocurre con muchas decisiones de optimización que implican ventajas y desventajas, la respuesta dependerá de los detalles. Por ejemplo:
- La proporción de tokens en
responsefrente a los demás campos. - La reducción promedio de la latencia al procesar la mayoría de los campos más rápido.
- El aumento promedio de la latencia al hacer dos solicitudes en lugar de una.
La conclusión variará según el caso, y la mejor forma de decidir es hacer pruebas con ejemplos de producción. En este caso, supongamos que las pruebas indicaron que conviene dividir el prompt en dos para procesar tokens más rápido.
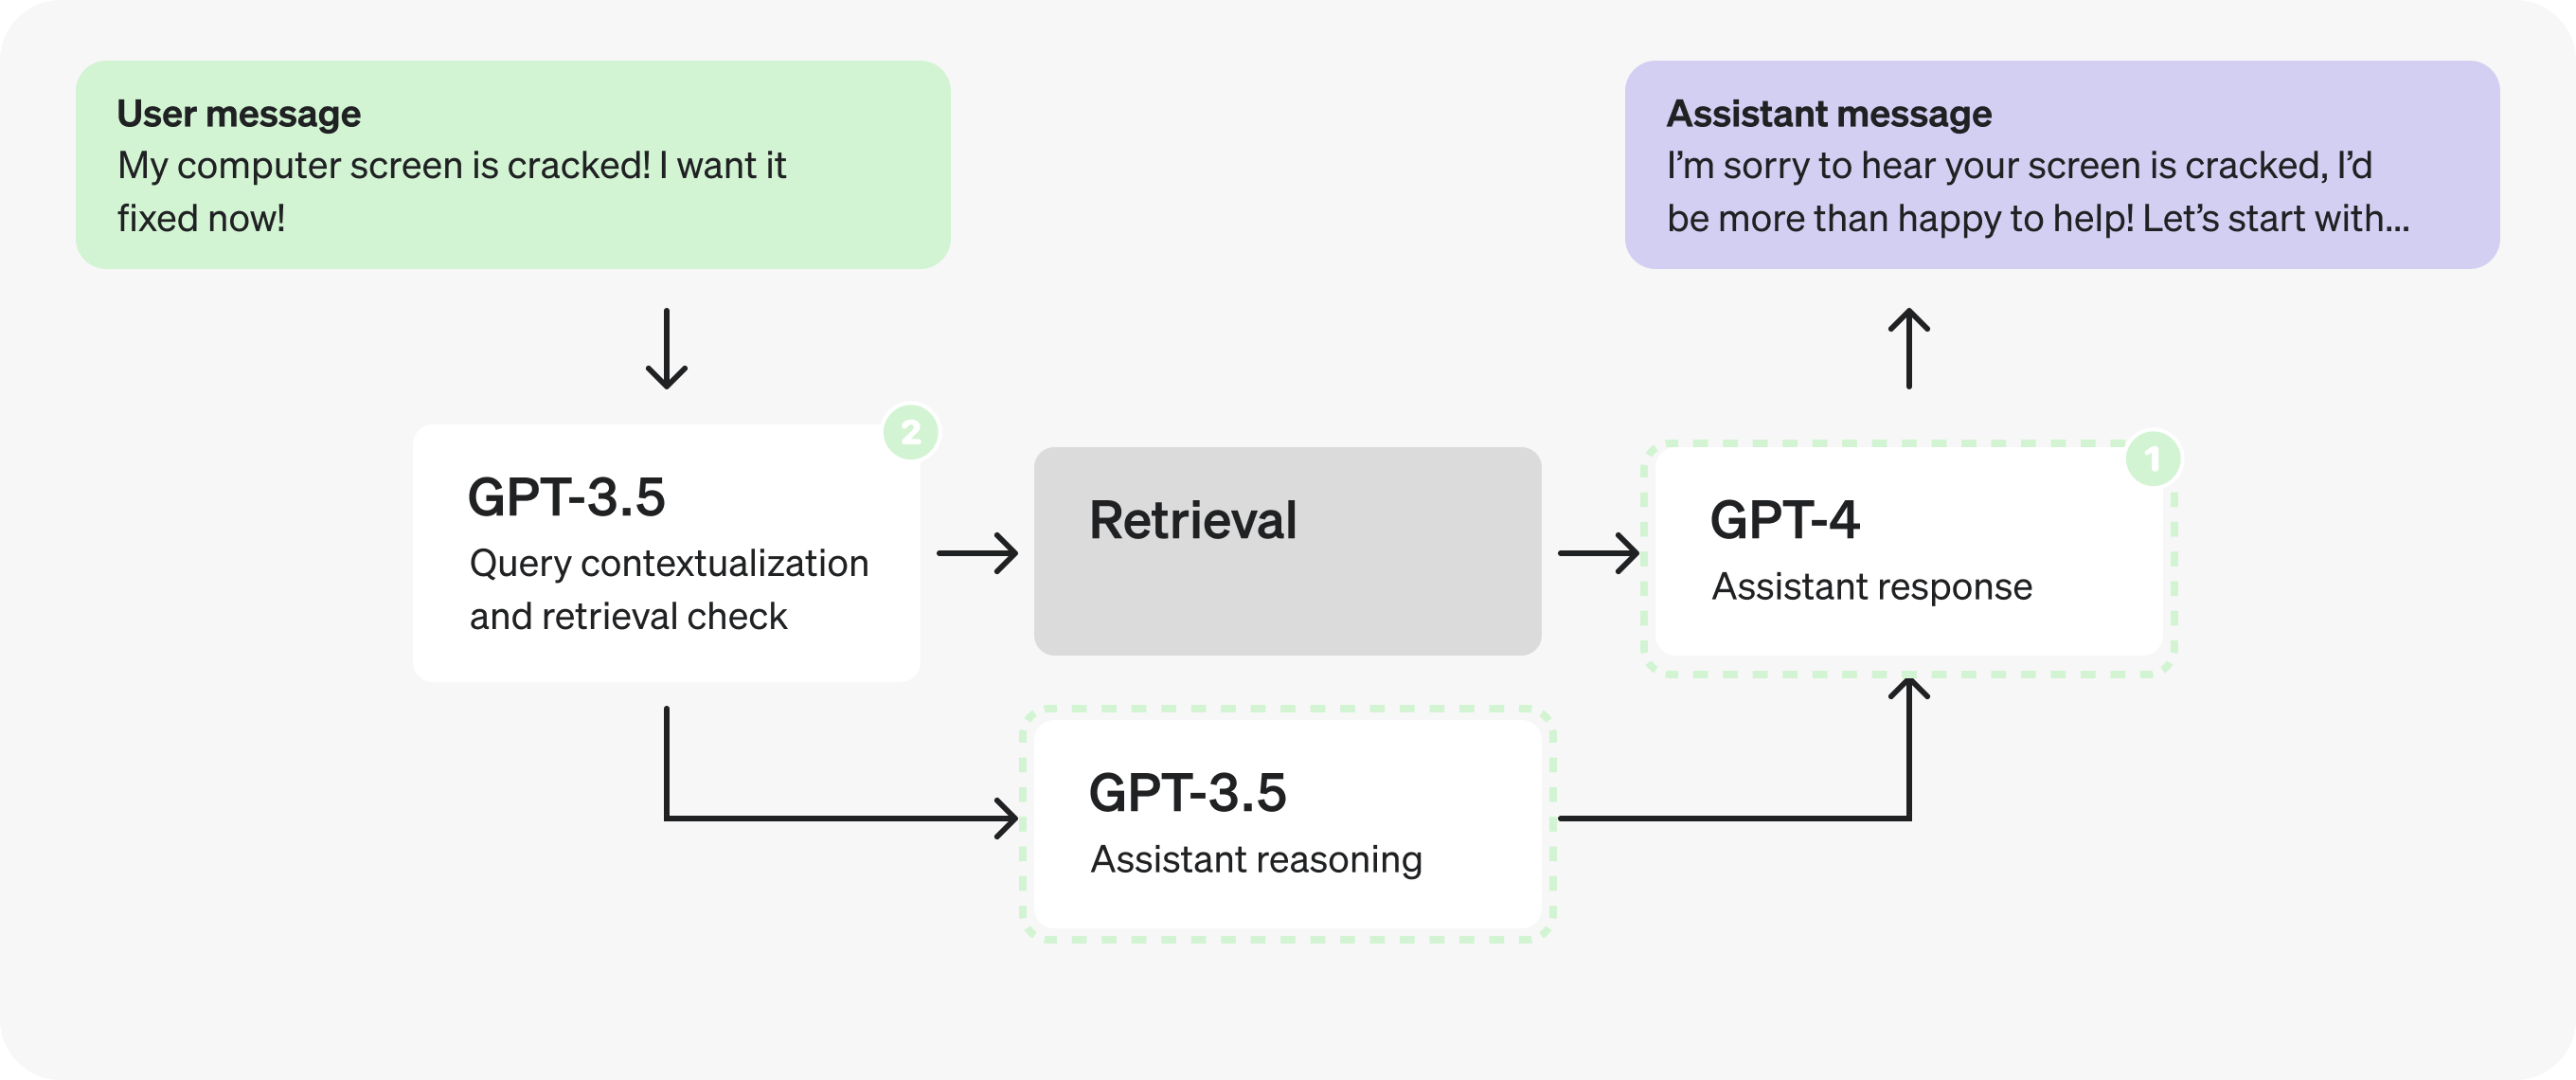
Nota: agruparemos response y enough_information_in_context en el segundo prompt para evitar pasar el contexto recuperado a ambos prompts nuevos.
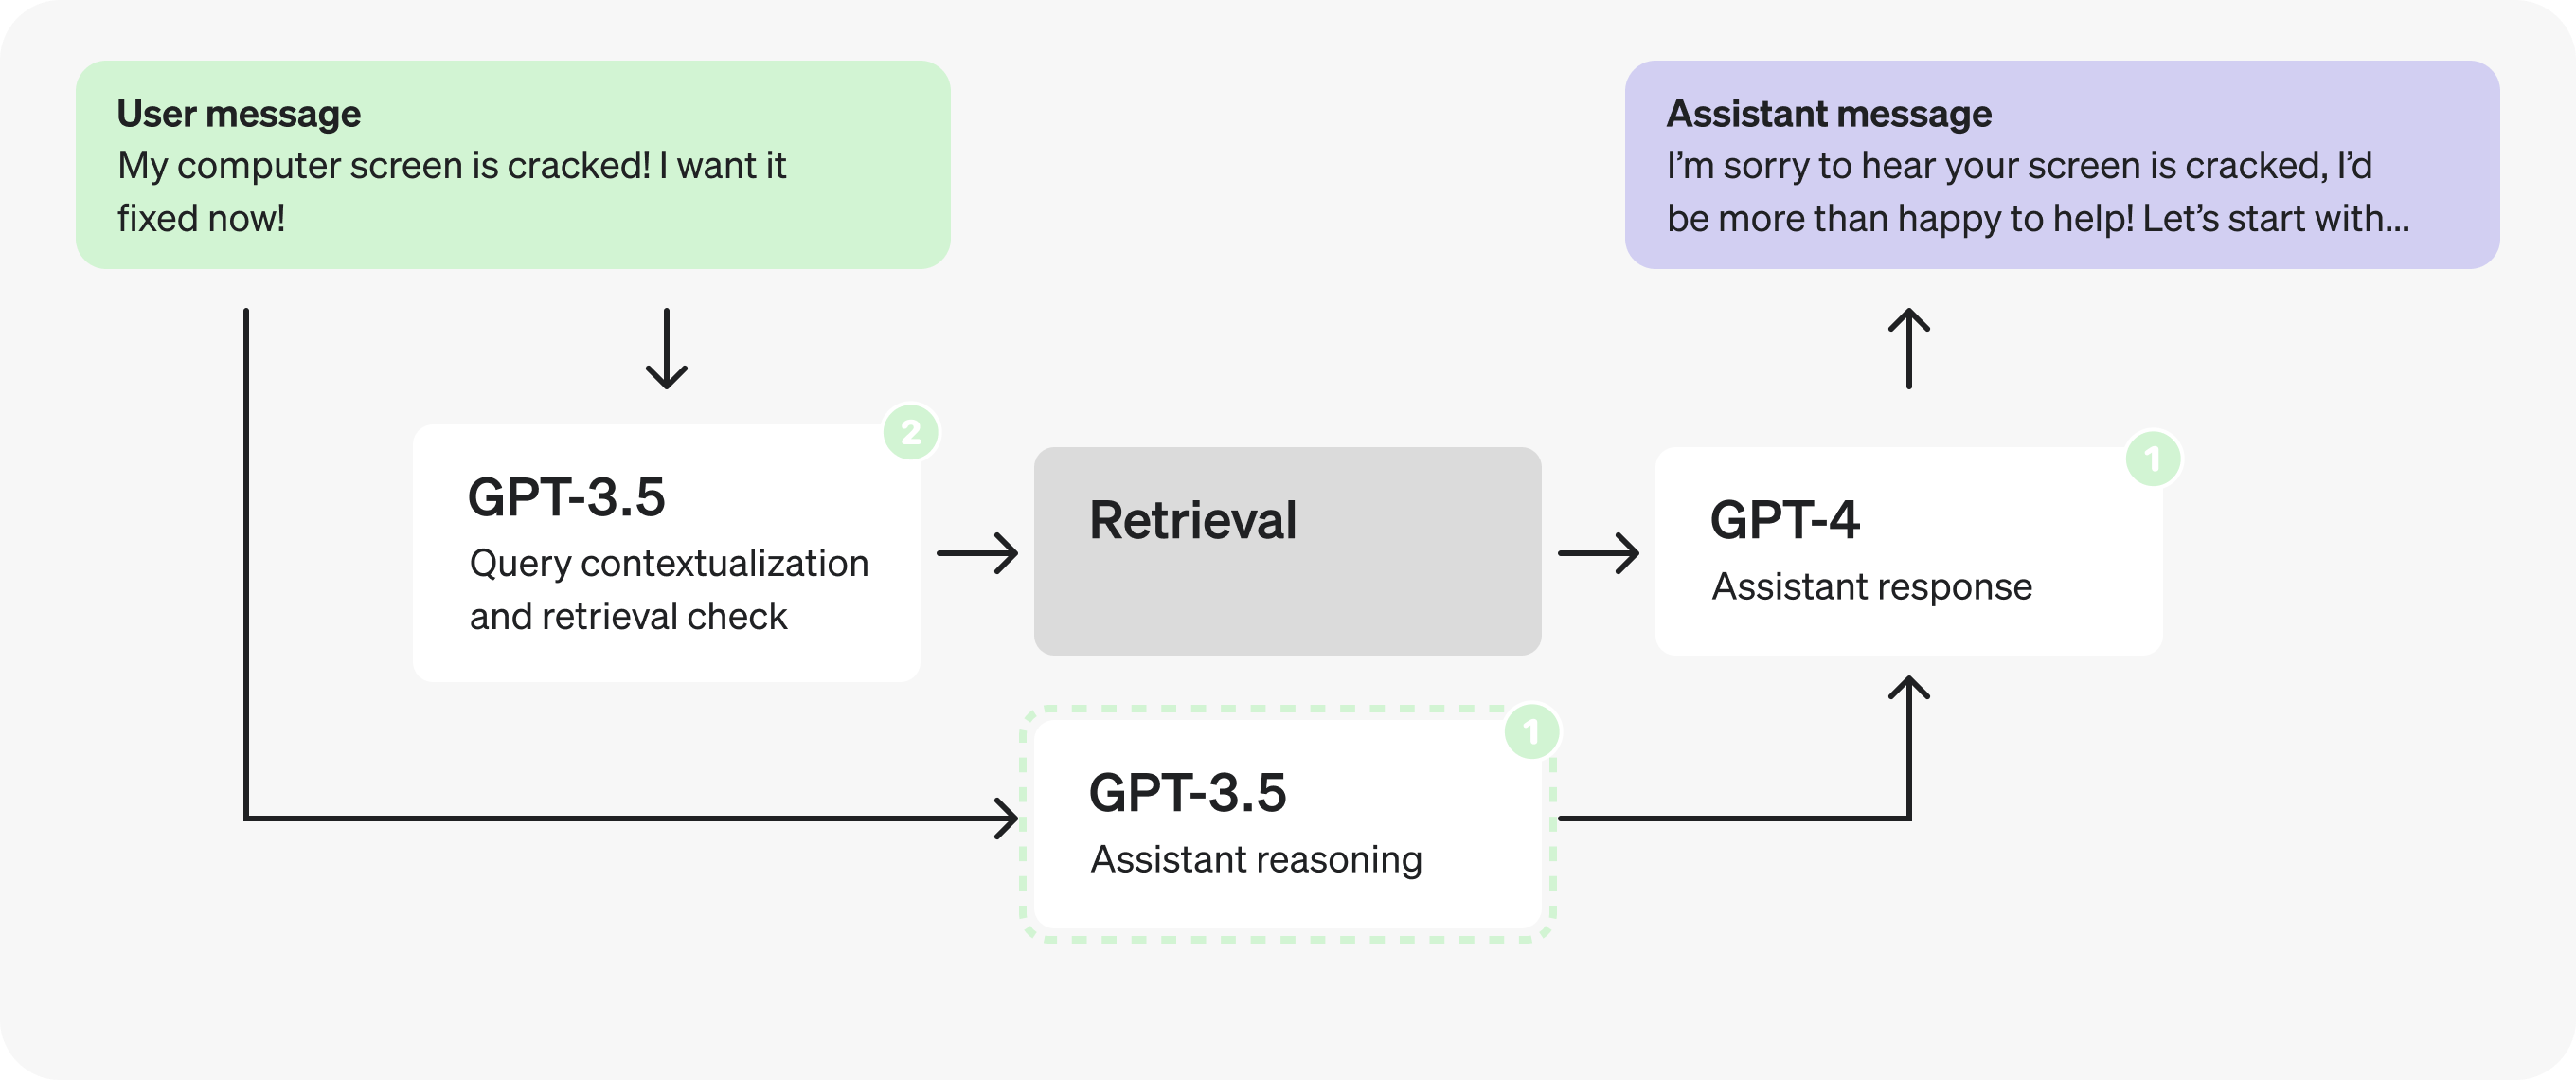
De hecho, ahora que el prompt de razonamiento no depende del contexto recuperado, podemos paralelizar y ejecutarlo al mismo tiempo que los prompts de recuperación.
Parte 3: optimización del resultado estructurado
Volvamos a revisar el prompt de razonamiento.
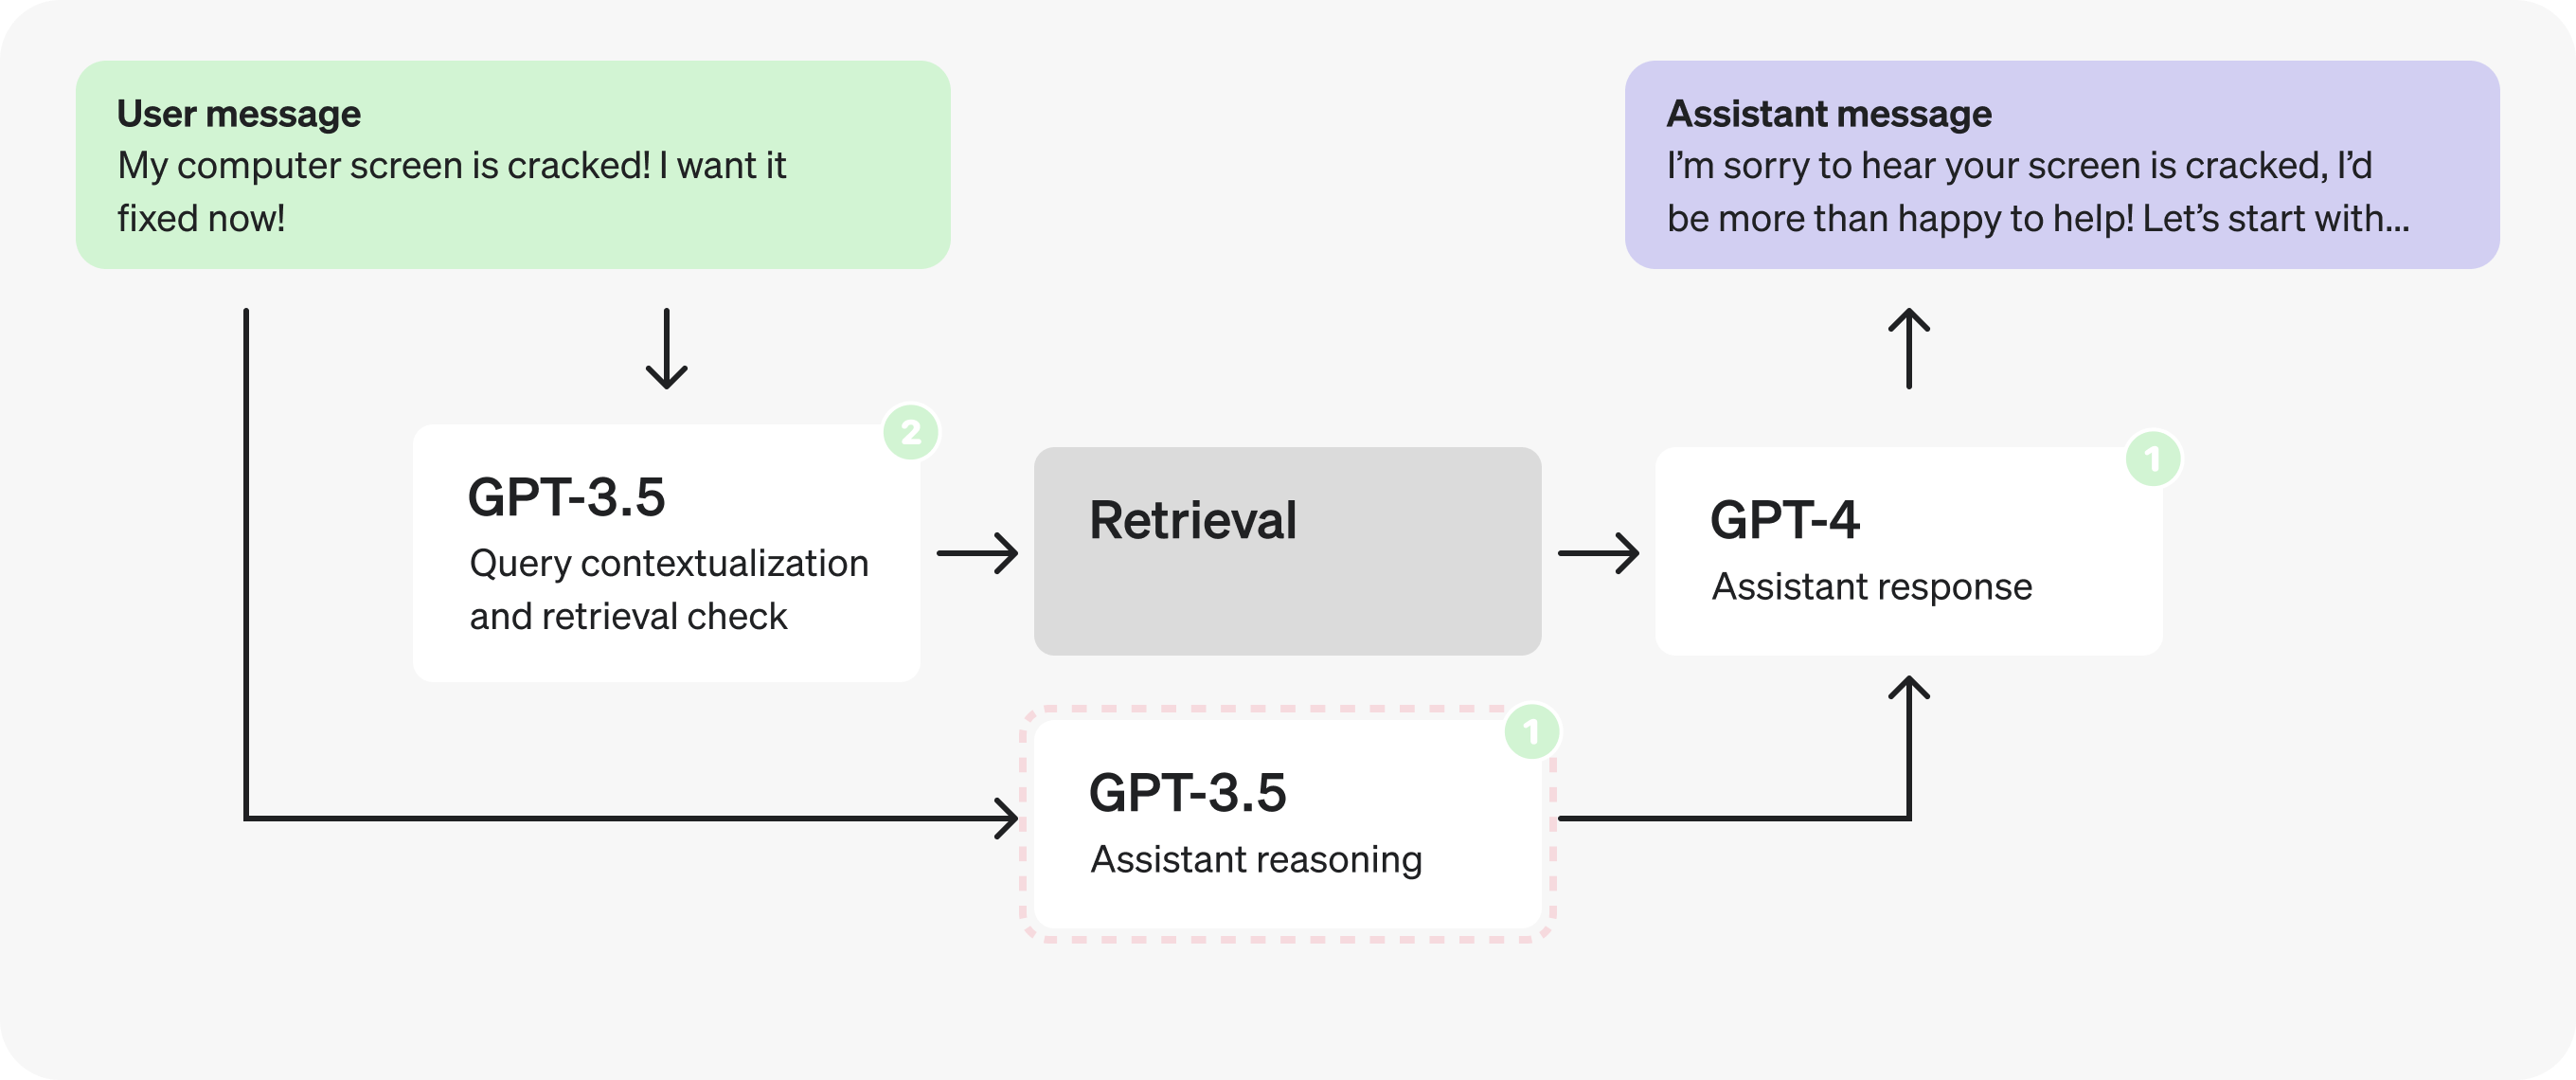
Al examinar más de cerca el JSON de razonamiento, notarás que los propios nombres de los campos son bastante largos.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
}Al acortarlos y mover las explicaciones a los comentarios, podemos generar menos tokens.
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
}
Este pequeño cambio eliminó 19 tokens de salida. Si bien con GPT-3.5 esto podría reducir la latencia solo unos milisegundos, con GPT-4 podría reducirla hasta un segundo.
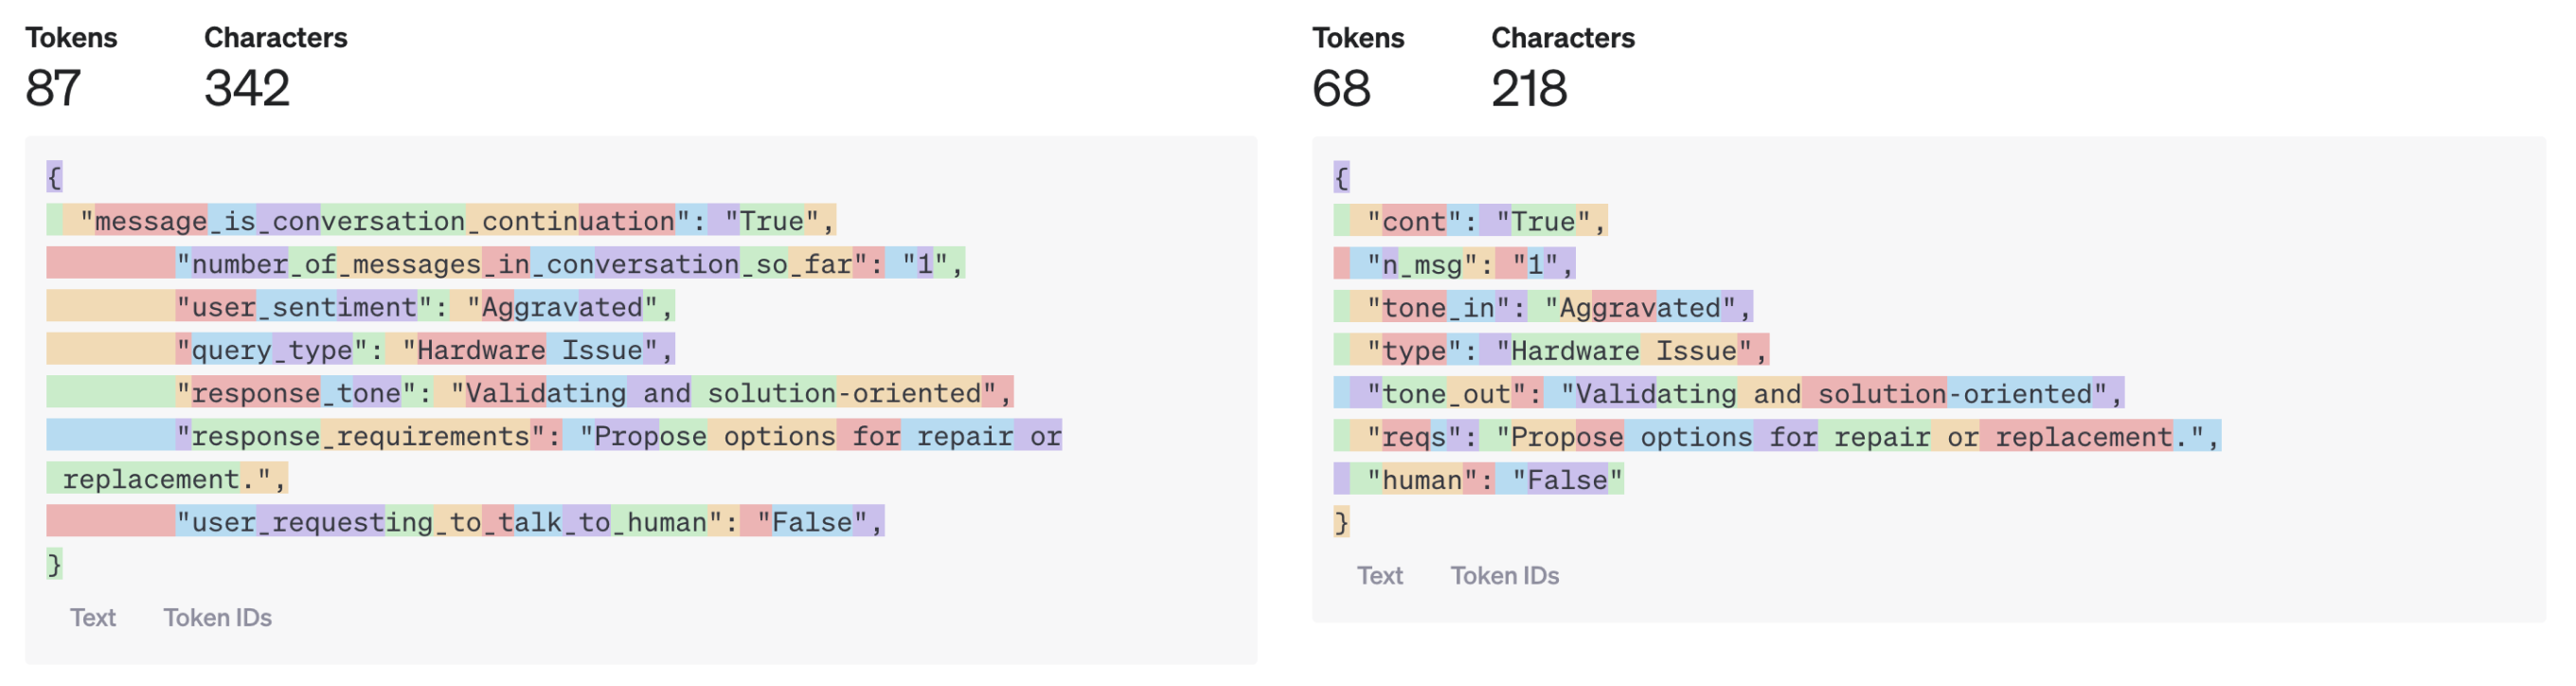
Sin embargo, puedes imaginar que esto puede tener un impacto considerable cuando el modelo genera respuestas más extensas.
Podríamos ir más allá y usar un solo carácter para cada nombre de campo del JSON, o poner todo en un arreglo, pero esto podría empezar a perjudicar la calidad de nuestras respuestas. Una vez más, la mejor manera de saberlo es mediante pruebas.
Resumen del ejemplo
Repasemos las optimizaciones que implementamos en el ejemplo del bot de atención al cliente:
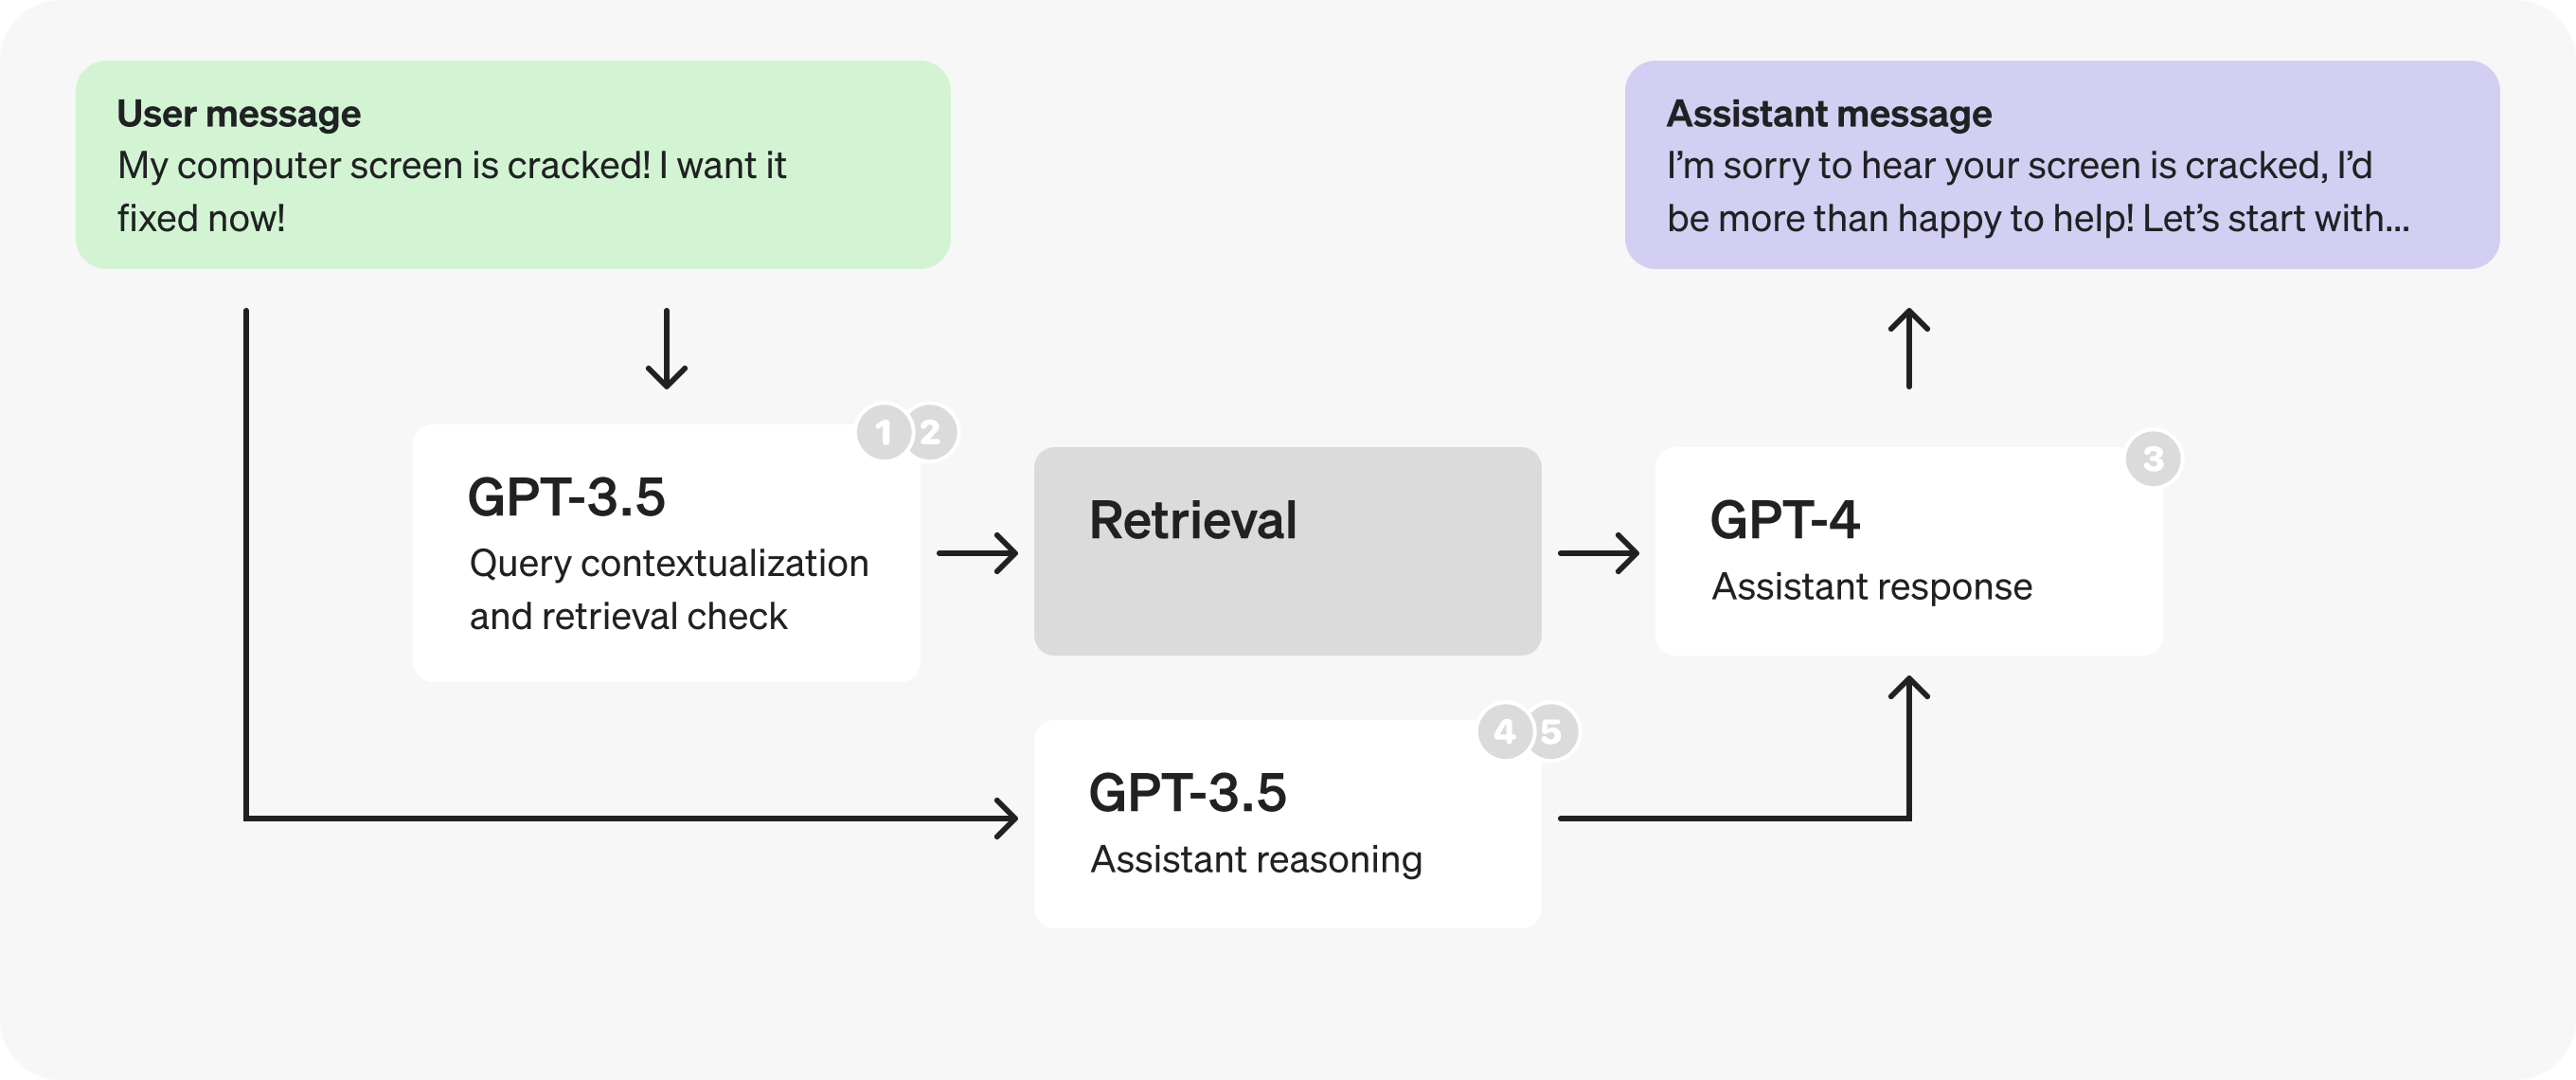
- Combinamos los pasos de contextualización de la consulta y de verificación de la necesidad de recuperación para hacer menos solicitudes.
- Para el nuevo prompt, cambiamos a GPT-3.5, un modelo más pequeño con ajuste fino , para procesar los tokens más rápido.
- Dividimos el prompt del asistente en dos y cambiamos a GPT-3.5, un modelo más pequeño con ajuste fino , para el razonamiento, también con el fin de procesar los tokens más rápido.
- Paralelizamos las verificaciones de la necesidad de recuperación y los pasos de razonamiento.
- Acortamos los nombres de los campos de razonamiento y trasladamos los comentarios al prompt para generar menos tokens.