Aprende a gestionar el estado de la conversación durante una interacción con un modelo.
Responses
OpenAI ofrece varias formas de gestionar el estado de la conversación, lo cual es importante para conservar información entre varios mensajes o turnos de una conversación.
Al solucionar problemas en los que GPT-5.5 interpreta una actualización intermedia como
la respuesta final, verifica que tu integración conserve correctamente el campo
phase de los mensajes del asistente. Consulta Parámetro
phase para obtener más información.
Gestionar manualmente el estado de la conversación
Aunque cada solicitud de generación de texto es independiente y no tiene estado, puedes implementar conversaciones de varios turnos proporcionando mensajes adicionales como parámetros en tu solicitud de generación de texto. Considera un chiste de “toc, toc”:
Al alternar mensajes de user y assistant, incluyes el estado anterior de una conversación en una sola solicitud al modelo.
Para compartir manualmente el contexto entre las respuestas generadas, incluye la salida de la respuesta anterior del modelo como entrada y agrega esa entrada a tu siguiente solicitud.
En las solicitudes sin estado a modelos de razonamiento, conserva todos los elementos del arreglo output de la respuesta. La API Responses devuelve elementos de razonamiento cifrados de forma predeterminada. Volver a enviar la salida completa mantiene intactos los elementos de razonamiento y los valores de phase del asistente. Los modelos que admiten razonamiento persistente pueden usar reasoning.context: "all_turns" para incorporar el razonamiento disponible de turnos anteriores en la siguiente generación. Consulta Conservar el razonamiento entre llamadas.
En el siguiente ejemplo, le pedimos al modelo que cuente un chiste y luego le pedimos otro. Agregar las respuestas anteriores a las nuevas solicitudes de esta manera ayuda a que las conversaciones sean naturales y conserven el contexto de las interacciones anteriores.
Gestionar manualmente el estado de la conversación con la API para completar chats.
Nuestras API facilitan la gestión automática del estado de la conversación, por lo que no tienes que pasar las entradas manualmente en cada turno.
Recomendamos usar la API Responses en su lugar. Como mantiene el estado, basta con un parámetro para gestionar el contexto entre conversaciones.
Si usas el punto de acceso de Chat Completions, tendrás que gestionar el estado manualmente, como se explica arriba.
Usar la API Conversations
La API Conversations funciona junto con la API Responses para conservar el estado de la conversación como un objeto de larga duración con su propio identificador persistente. Después de crear un objeto de conversación, puedes seguir usándolo en distintas sesiones, dispositivos o trabajos.
Las conversaciones almacenan elementos, que pueden ser mensajes, llamadas a herramientas, salidas de herramientas y otros datos.
En una interacción de varios turnos, puedes pasar conversation a las respuestas posteriores para conservar el estado y compartir el contexto entre ellas, en lugar de tener que encadenar varios elementos de respuesta.
Gestionar el estado de la conversación con las API Conversations y Responses
Python
1
2
3
4
5
6
7const response = await client.responses.create({ model: "gpt-6-astra", input: [{ role: "user", content: "What are the five Ds of dodgeball?" }], conversation: conversation.id,});console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(model="gpt-6-astra",input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],conversation=conversation.id,)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Conversation: responses.ResponseNewParamsConversationUnion{ OfString: openai.String(conversation.ID), }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("What are the five Ds of dodgeball?"), },})if err != nil { panic(err)}fmt.Println(response.OutputText())
1
2
3
4
5
6
7response = client.responses.create( model: "gpt-6-astra", conversation: conversation.id, input: "What are the five Ds of dodgeball?")puts(response.output_text)
Pasar el contexto de la respuesta anterior
Otra forma de gestionar el estado de la conversación es compartir el contexto entre las respuestas generadas mediante el parámetro previous_response_id. Este parámetro te permite encadenar respuestas y crear un hilo de conversación.
Encadenar respuestas entre turnos pasando el ID de la respuesta anterior
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
En el siguiente ejemplo, le pedimos al modelo que cuente un chiste. En una solicitud aparte, le pedimos que explique por qué es gracioso, y el modelo cuenta con todo el contexto necesario para dar una buena respuesta.
Gestionar manualmente el estado de la conversación con la API Responses
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
previous_response_id en modo WebSocket
Si usas el modo WebSocket de la API Responses, la continuación sigue la misma semántica de previous_response_id que en el modo HTTP, pero a través de un socket persistente con eventos response.create repetidos.
La caché local de la conexión mantiene en memoria las respuestas anteriores recientes para permitir la continuación con baja latencia. Cuando usas stream_id, cada canal puede conservar su respuesta más reciente; previous_response_id sigue controlando el linaje, por lo que un canal nuevo puede bifurcarse a partir de una respuesta de otro canal mientras esa respuesta siga disponible. Si no se puede resolver un ID que no está en caché, envía un nuevo turno con previous_response_id establecido en null y pasa todo el contexto de entrada.
Los objetos Response se guardan durante 30 días de forma predeterminada. Puedes verlos en la página de
registros del panel o
recuperarlos mediante la API.
Puedes desactivar este comportamiento estableciendo store en false
al crear un objeto Response.
Los objetos de conversación y los elementos que contienen no están sujetos al TTL de 30 días. Los elementos de cualquier respuesta asociada a una conversación se conservarán sin un TTL de 30 días.
OpenAI no usa los datos enviados mediante la API para entrenar nuestros modelos sin tu consentimiento explícito. Más información.
Incluso al usar previous_response_id, todos los tokens de entrada anteriores de las respuestas de la cadena se facturan como tokens de entrada en la API.
Gestionar la ventana de contexto
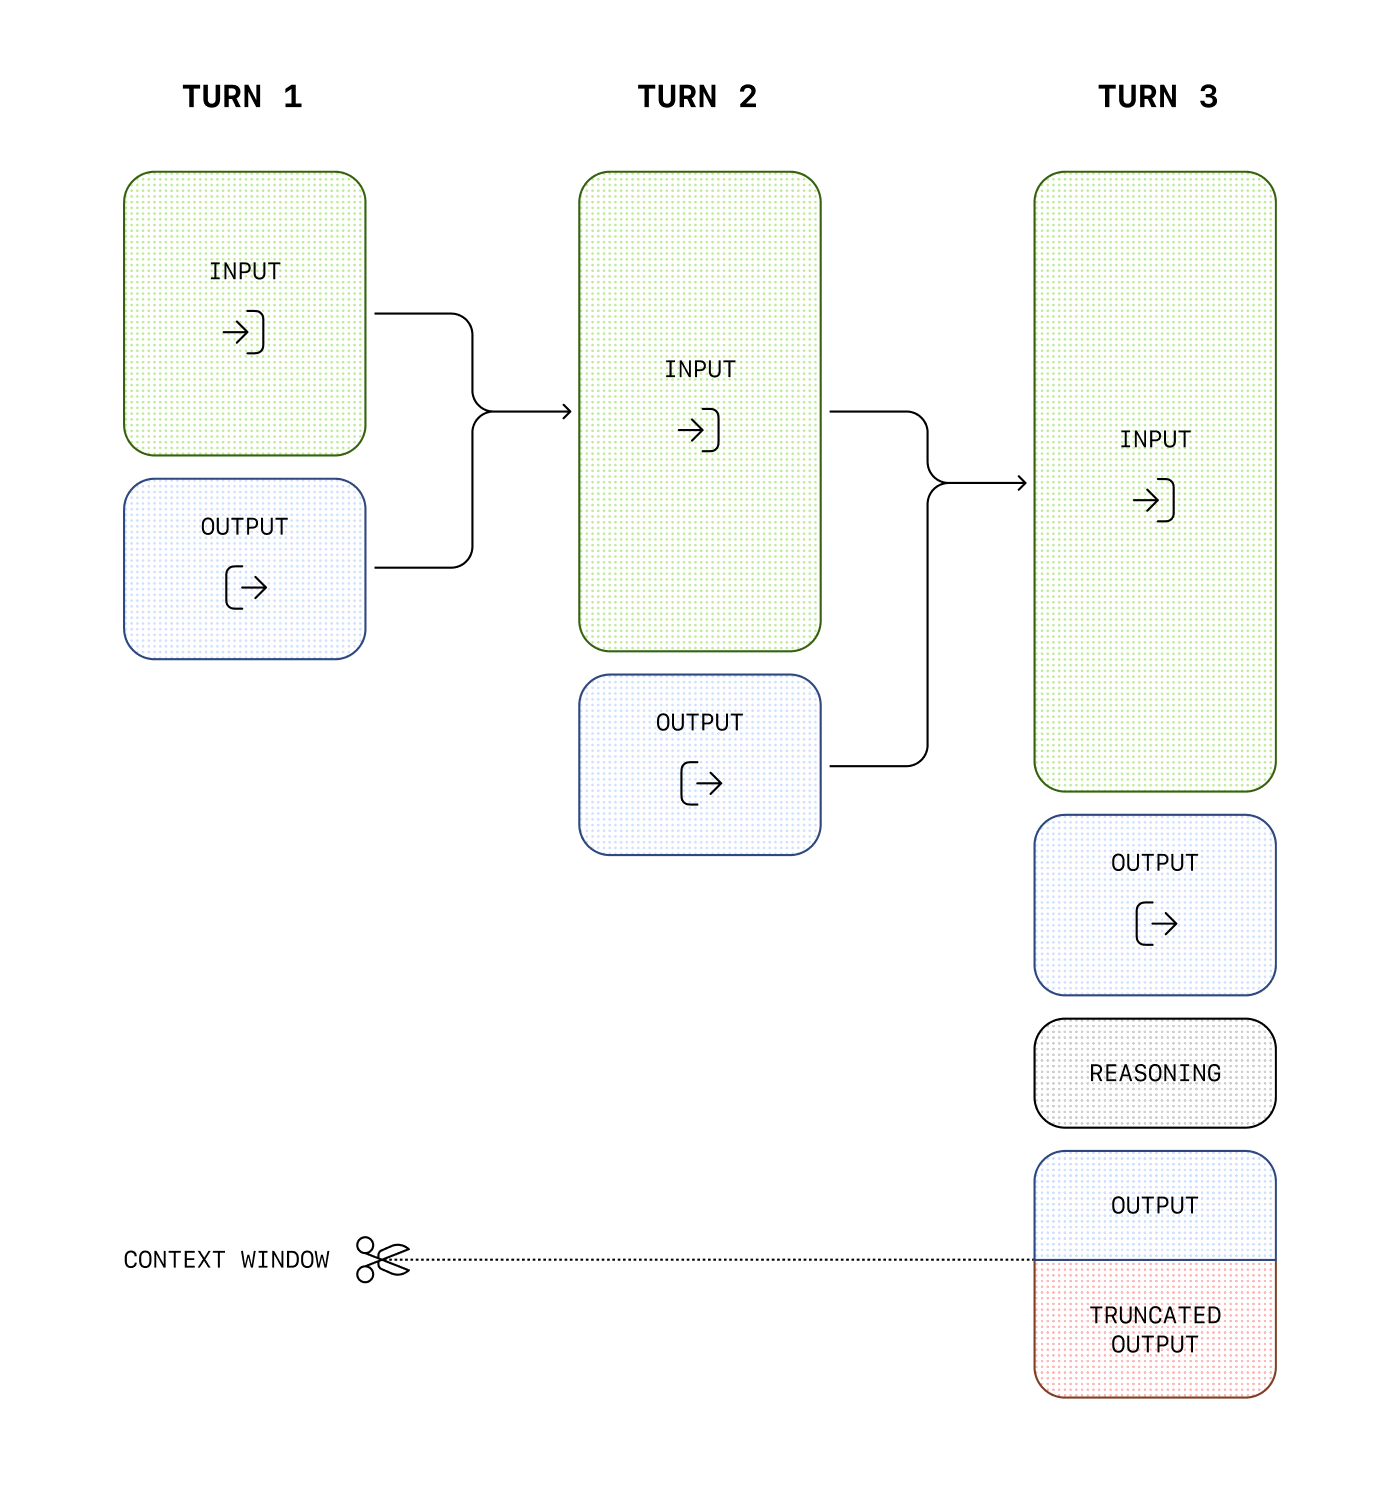
Comprender las ventanas de contexto te ayudará a crear hilos de conversación correctamente y a gestionar el estado entre interacciones con el modelo.
La ventana de contexto es la cantidad máxima de tokens que se pueden usar en una sola solicitud. Este máximo incluye los tokens de entrada, de salida y de razonamiento. Para conocer la ventana de contexto de tu modelo, consulta los detalles del modelo.
Gestionar el contexto para la generación de texto
A medida que tus entradas se vuelvan más complejas o incluyas más turnos en una conversación, tendrás que considerar tanto los límites de tokens de salida como los de la ventana de contexto . Las entradas y salidas del modelo se miden en tokens, que se extraen de las entradas para analizar su contenido e intención y se combinan para producir salidas lógicas. Los modelos tienen límites de uso de tokens durante el ciclo de vida de una solicitud de generación de texto.
Los tokens de salida son los tokens que genera un modelo en respuesta a un prompt. Cada modelo tiene distintos límites de tokens de salida. Por ejemplo, gpt-4o-2024-08-06 puede generar un máximo de 16 384 tokens de salida.
Una ventana de contexto describe la cantidad total de tokens que se pueden usar como tokens de entrada y de salida (y, en algunos modelos, como tokens de razonamiento). Compara los límites de la ventana de contexto de nuestros modelos. Por ejemplo, gpt-4o-2024-08-06 tiene una ventana de contexto total de 128k tokens.
Si creas un prompt extenso, a menudo al incluir contexto, datos o ejemplos adicionales para el modelo, corres el riesgo de superar la ventana de contexto asignada al modelo, lo que podría dar lugar a salidas truncadas.
Por ejemplo, al realizar una solicitud de API a Chat Completions con el modelo o1, las siguientes cantidades de tokens se contabilizan en el total de la ventana de contexto:
Tokens de entrada (datos que incluyes en el arreglo messages con Chat Completions)
Tokens de salida (tokens generados en respuesta a tu prompt)
Tokens de razonamiento (que el modelo usa para planificar una respuesta)
Por ejemplo, al realizar una solicitud a la API Responses con un modelo con razonamiento habilitado, como el modelo o1, los siguientes tokens se contabilizan en el total de la ventana de contexto:
Tokens de entrada (datos que incluyes en el arreglo input para la API Responses)
Tokens de salida (tokens generados en respuesta a tu prompt)
Tokens de razonamiento (que el modelo usa para planificar una respuesta)
Los tokens generados que excedan el límite de la ventana de contexto pueden truncarse en las respuestas de la API.