
OpenAI ofrece dos tipos de modelos: modelos de razonamiento (como o3 y o4-mini) y modelos GPT (como GPT-4.1). Estas familias de modelos se comportan de manera diferente.
Esta guía aborda:
- La diferencia entre nuestros modelos de razonamiento y nuestros modelos GPT sin razonamiento
- Cuándo usar nuestros modelos de razonamiento
- Cómo diseñar prompts eficaces para modelos de razonamiento
Obtén más información sobre los modelos de razonamiento y cómo funcionan.
Modelos de razonamiento frente a modelos GPT
En comparación con los modelos GPT, nuestros modelos de la serie o destacan en tareas distintas y requieren prompts diferentes. Ninguna familia de modelos es mejor que la otra; simplemente son diferentes.
Entrenamos nuestros modelos de la serie o (“los planificadores”) para que dediquen más tiempo y esfuerzo a pensar en tareas complejas. Esto los hace eficaces para formular estrategias, planificar soluciones a problemas complejos y tomar decisiones a partir de grandes volúmenes de información ambigua. Estos modelos también pueden ejecutar tareas con gran exactitud y precisión, lo que los hace ideales para ámbitos que de otro modo requerirían un experto humano, como las matemáticas, la ciencia, la ingeniería, los servicios financieros y los servicios legales.
Por su parte, nuestros modelos GPT (“los caballos de batalla”), de menor latencia y mayor eficiencia de costos, están diseñados para la ejecución de tareas directas. Una aplicación podría usar modelos de la serie o para planificar la estrategia con la que resolverá un problema y modelos GPT para ejecutar tareas específicas, en particular cuando la velocidad y el costo importan más que una exactitud perfecta.
Cómo elegir
¿Qué es lo más importante para tu caso de uso?
- Velocidad y costo → los modelos GPT son más rápidos y suelen costar menos
- Ejecución de tareas bien definidas → los modelos GPT manejan bien las tareas definidas de forma explícita
- Exactitud y confiabilidad → los modelos de la serie o son confiables para tomar decisiones
- Resolución de problemas complejos → los modelos de la serie o resuelven situaciones ambiguas y complejas
Si la velocidad y el costo son los factores más importantes al completar tus tareas y tu caso de uso consta de tareas sencillas y bien definidas, nuestros modelos GPT son la mejor opción para ti. Sin embargo, si la exactitud y la confiabilidad son los factores más importantes y tienes que resolver un problema muy complejo de varios pasos, nuestros modelos de la serie o probablemente sean los adecuados para ti.
La mayoría de los flujos de trabajo de IA usarán una combinación de ambos tipos de modelos: la serie o para la planificación y la toma de decisiones con agentes, y la serie GPT para ejecutar tareas.
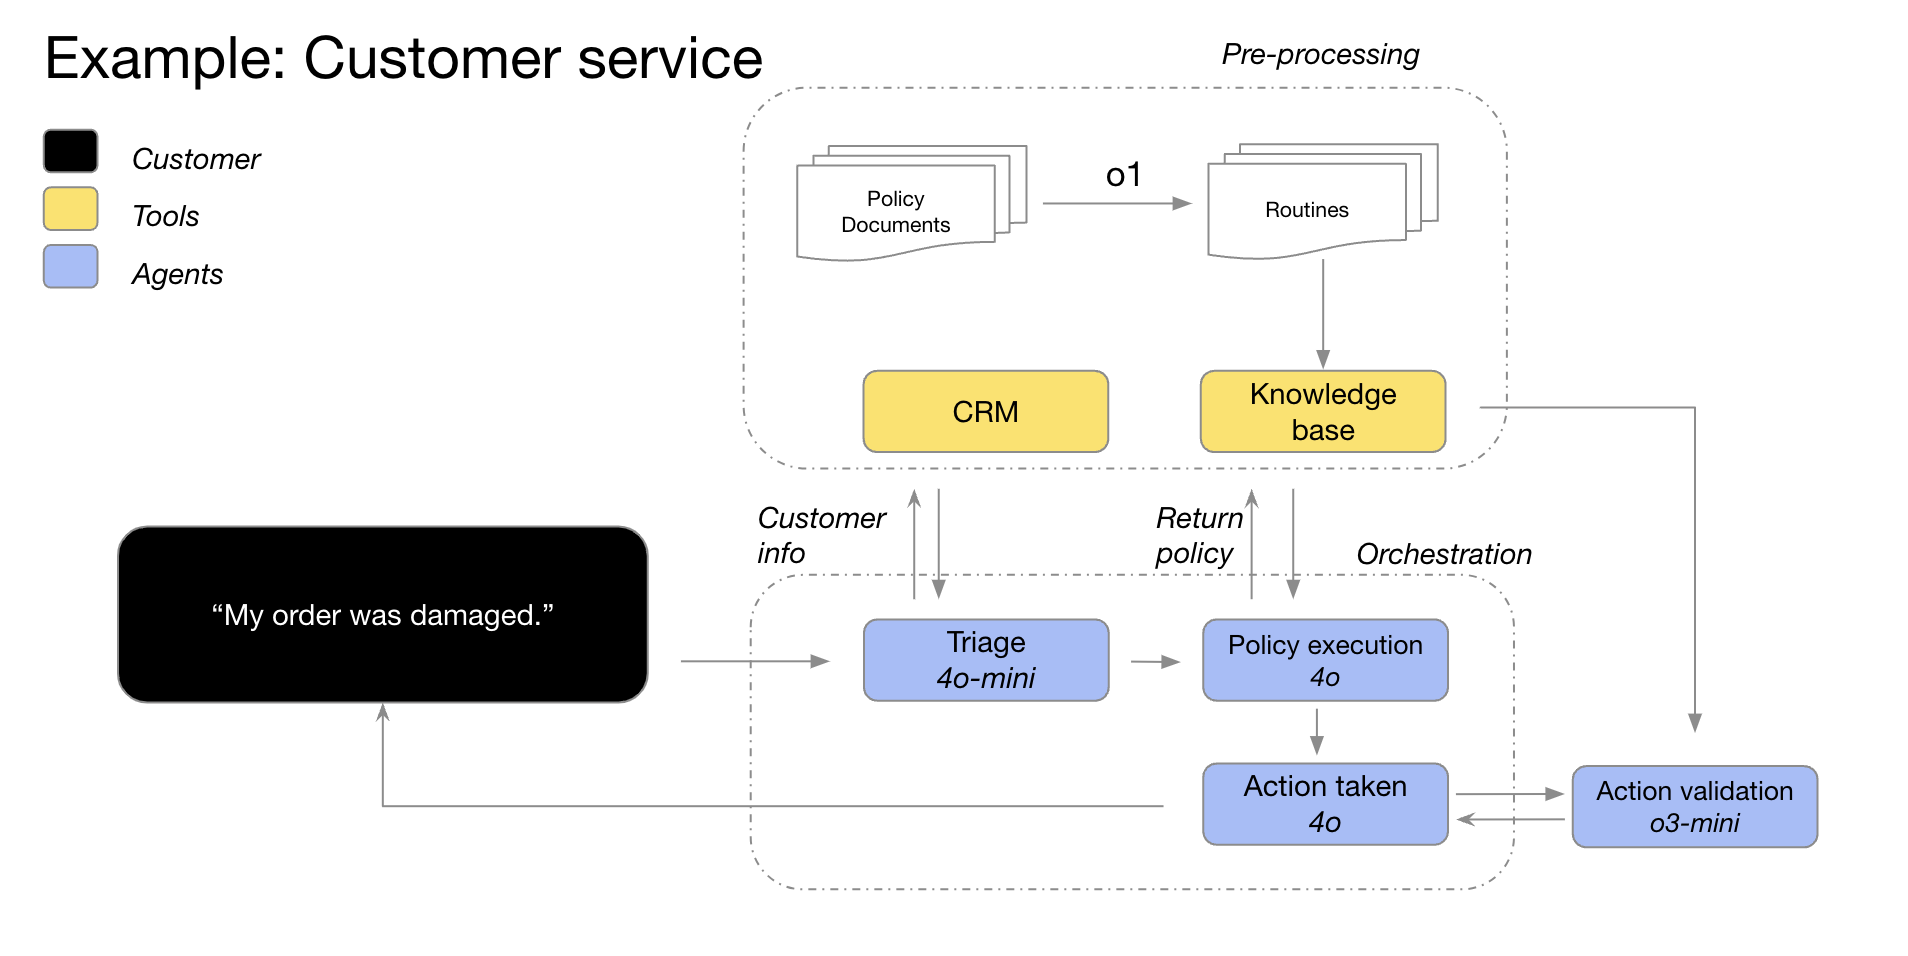
Nuestros modelos GPT-4o y GPT-4o mini clasifican los detalles del pedido junto con la información del cliente, identifican los problemas del pedido y la política de devoluciones, y luego proporcionan todos estos datos a o3-mini para que tome la decisión final sobre la viabilidad de la devolución según la política.
Cuándo usar nuestros modelos de razonamiento
Estos son algunos patrones de uso exitoso que hemos observado entre nuestros clientes y dentro de OpenAI. No se trata de una revisión exhaustiva de todos los casos de uso posibles, sino de orientación práctica para probar nuestros modelos de la serie o.
¿Todo listo para usar un modelo de razonamiento? Ve al inicio rápido →
1. Abordar tareas ambiguas
Los modelos de razonamiento son especialmente buenos para comprender la intención del usuario y manejar los vacíos en las instrucciones a partir de información limitada o fragmentos de información dispares y un prompt sencillo. De hecho, suelen hacer preguntas aclaratorias antes de formular conjeturas sin fundamento o intentar completar la información faltante.
“Las capacidades de razonamiento de o1 permiten que nuestra plataforma multiagente Matrix produzca respuestas exhaustivas, detalladas y con un buen formato al procesar documentos complejos. Por ejemplo, con un prompt básico, o1 permitió que Matrix identificara fácilmente los cupos disponibles para realizar pagos restringidos en un contrato de crédito. Ningún modelo anterior alcanza ese rendimiento. o1 obtuvo mejores resultados que otros modelos en el 52 % de los prompts complejos sobre contratos de crédito densos”.
—Hebbia, empresa de plataforma de conocimiento con IA para los sectores legal y financiero
2. Encontrar una aguja en un pajar
Cuando proporcionas grandes cantidades de información no estructurada, los modelos de razonamiento destacan por comprender y extraer solo la información más relevante para responder una pregunta.
“Para analizar la adquisición de una empresa, o1 revisó decenas de documentos de la compañía, como contratos y arrendamientos, en busca de condiciones problemáticas que pudieran afectar la operación. Se le pidió al modelo que señalara las condiciones clave y, al hacerlo, identificó una cláusula crucial de “cambio de control” en las notas al pie: si se vendía la empresa, tendría que liquidar de inmediato un préstamo de $75 millones. La extraordinaria atención al detalle de o1 permite que nuestros agentes de IA ayuden a los profesionales financieros a identificar información crucial”.
—Endex, plataforma de inteligencia financiera con IA
3. Encontrar relaciones y matices en un conjunto de datos grande
Hemos comprobado que los modelos de razonamiento son especialmente buenos para razonar sobre documentos complejos con cientos de páginas de información densa y no estructurada, como contratos legales, estados financieros y reclamaciones de seguros. Destacan en particular por establecer paralelismos entre documentos y tomar decisiones basadas en hechos implícitos en los datos.
“La investigación tributaria requiere sintetizar varios documentos para producir una respuesta final sólida. Sustituimos GPT-4o por o1 y comprobamos que o1 era mucho mejor para razonar sobre las relaciones entre documentos y llegar a conclusiones lógicas que no eran evidentes en ninguno de ellos por separado. Como resultado, al cambiar a o1, el rendimiento del proceso completo se multiplicó por cuatro. Increíble”.
—Blue J, plataforma de IA para la investigación tributaria
Los modelos de razonamiento también son hábiles para razonar sobre los matices de políticas y reglas, y aplicarlas a la tarea en curso para llegar a una conclusión razonable.
“En los análisis financieros, los analistas suelen abordar situaciones complejas relacionadas con el patrimonio de los accionistas y necesitan comprender los detalles legales pertinentes. Probamos unos 10 modelos de distintos proveedores con una pregunta difícil pero habitual: ¿cómo afecta una ronda de financiamiento a los accionistas existentes, especialmente cuando ejercen sus derechos antidilución? Esto exigía razonar sobre las valoraciones anteriores y posteriores a la inversión y resolver ciclos de dilución circular, algo que a los mejores analistas financieros les llevaría entre 20 y 30 minutos. ¡Descubrimos que o1 y o3-mini pueden hacerlo a la perfección! Los modelos incluso produjeron una tabla de cálculo clara que mostraba el impacto sobre un accionista con una participación de $100 000”.
–BlueFlame AI, plataforma de IA para la gestión de inversiones
4. Planificación de varios pasos con agentes
Los modelos de razonamiento son fundamentales para la planificación con agentes y el desarrollo de estrategias. Hemos observado buenos resultados cuando se usa un modelo de razonamiento como “el planificador”, que produce una solución detallada de varios pasos para un problema y luego selecciona y asigna el modelo GPT adecuado (“el ejecutor”) a cada paso, según si importa más una inteligencia elevada o una latencia baja.
“Usamos o1 como planificador en nuestra infraestructura de agentes y dejamos que orqueste otros modelos del flujo de trabajo para completar una tarea de varios pasos. Hemos comprobado que o1 es muy bueno para seleccionar tipos de datos y dividir preguntas amplias en partes más pequeñas, lo que permite que otros modelos se concentren en la ejecución”.
—Argon AI, plataforma de conocimiento con IA para la industria farmacéutica
“o1 impulsa muchos de nuestros flujos de trabajo con agentes en Lindy, nuestro asistente de IA para el trabajo. El modelo usa llamadas a funciones para obtener información de tu calendario o correo electrónico y luego puede ayudarte automáticamente a programar reuniones, enviar correos y gestionar otros aspectos de tus tareas cotidianas. ¡Migramos a o1 todos los pasos de nuestros agentes que solían causar problemas y vimos cómo nuestros agentes pasaban a funcionar prácticamente sin errores de la noche a la mañana!”.
—Lindy.AI, asistente de IA para el trabajo
5. Razonamiento visual
Actualmente, o1 es el único modelo de razonamiento que admite capacidades de visión. Lo que lo distingue de GPT-4o es que o1 puede comprender incluso el contenido visual más difícil, como gráficos y tablas con estructuras ambiguas o fotos de baja calidad.
“Automatizamos las revisiones de riesgos y cumplimiento de millones de productos en línea, incluidas imitaciones de joyería de lujo, especies en peligro de extinción y sustancias controladas. GPT-4o alcanzó un 50 % de exactitud en nuestras tareas más difíciles de clasificación de imágenes. o1 logró un impresionante 88 % de exactitud sin ninguna modificación en nuestro flujo de procesamiento”.
—SafetyKit, plataforma de riesgos y cumplimiento basada en IA
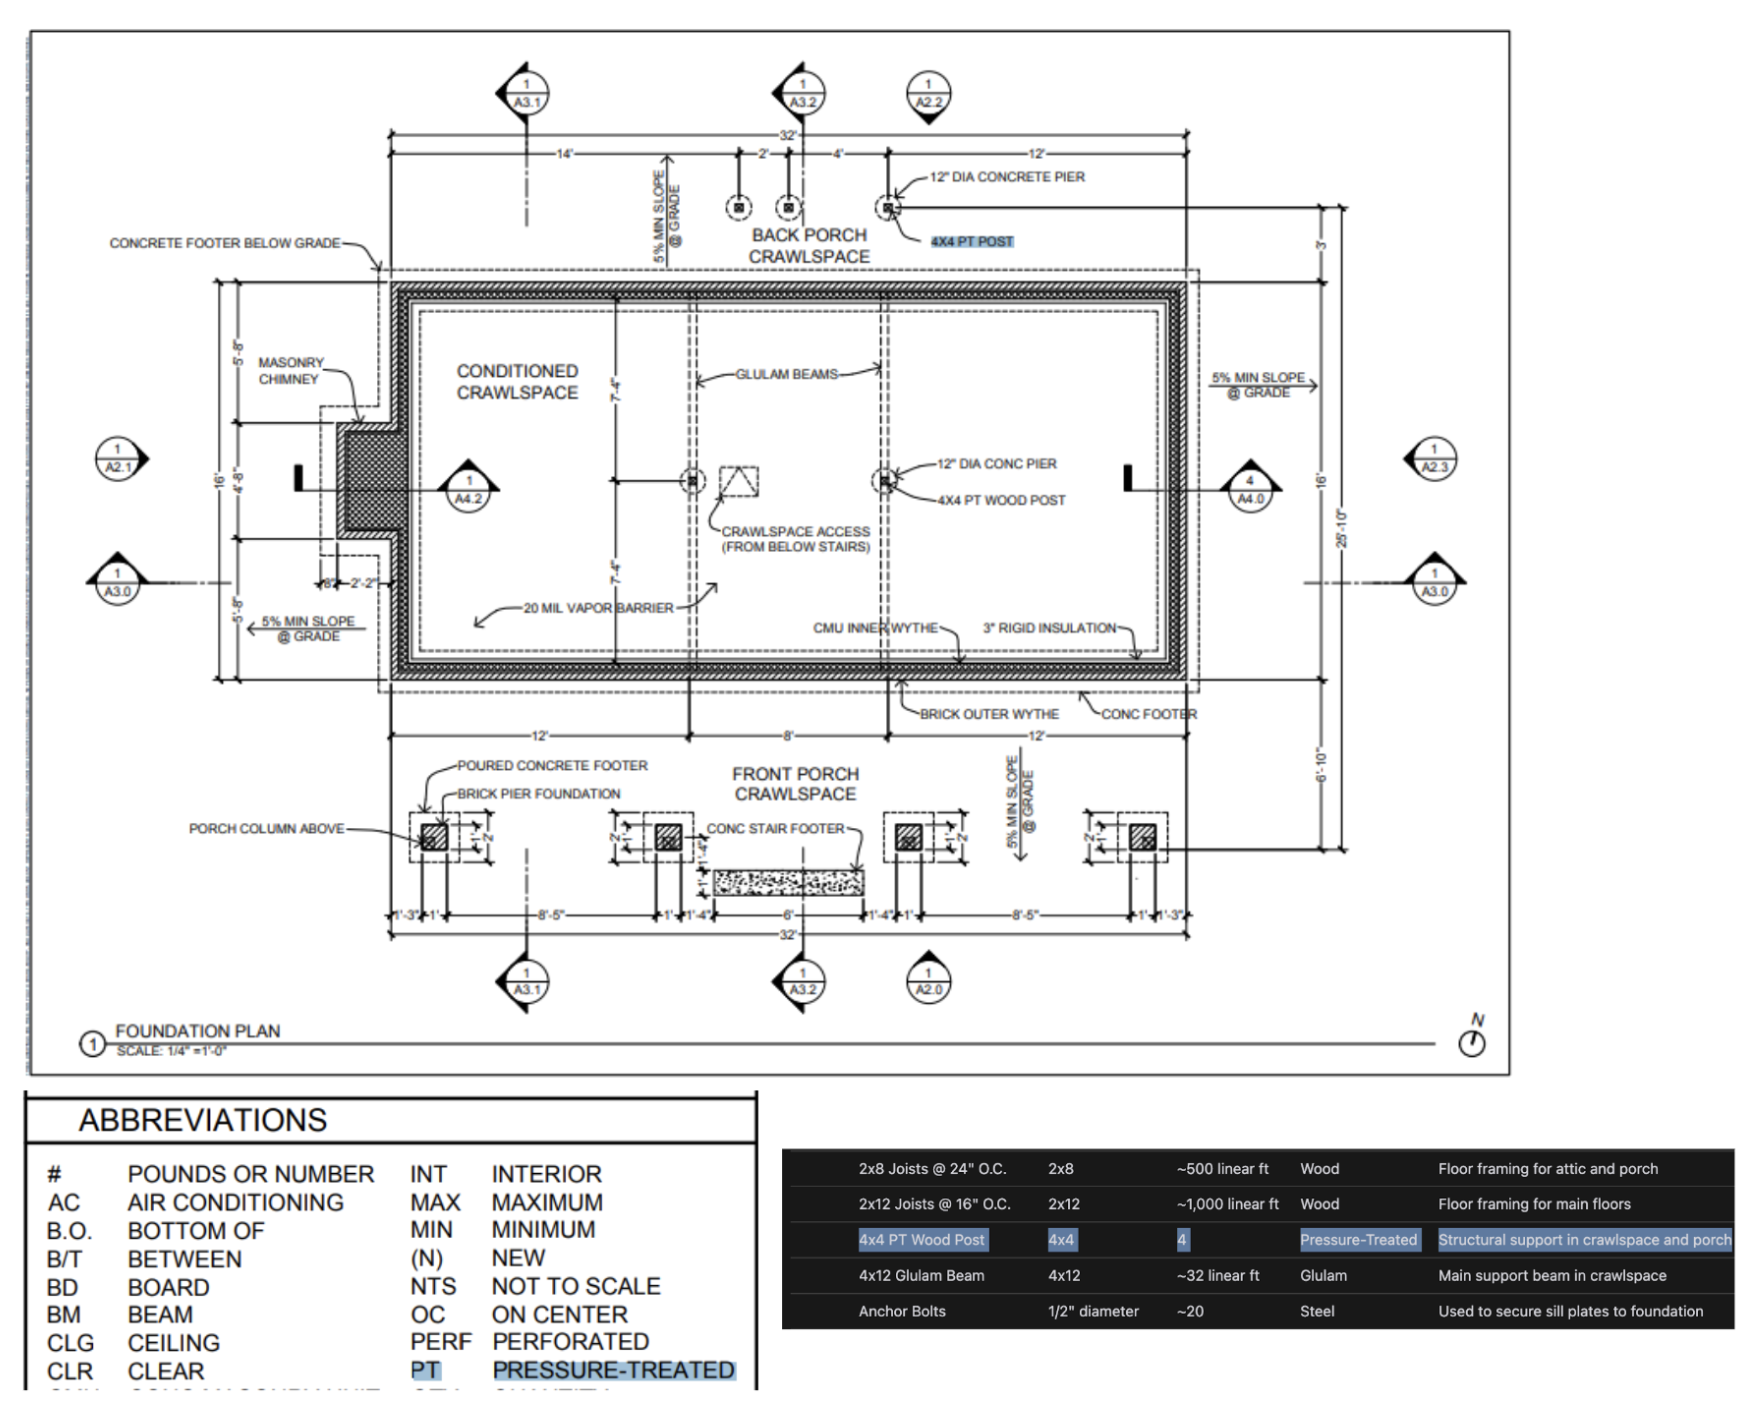
En nuestras pruebas internas, hemos observado que o1 puede identificar elementos fijos y materiales en planos arquitectónicos muy detallados para generar una lista completa de materiales. Una de las observaciones más sorprendentes fue que o1 puede establecer relaciones entre distintas imágenes: toma la leyenda de una página de los planos arquitectónicos y la aplica correctamente en otra página sin instrucciones explícitas. A continuación, puedes ver que, para los postes de madera PT de 4x4, o1 reconoció a partir de la leyenda que “PT” significa tratada a presión.
6. Revisar, depurar y mejorar la calidad del código
Los modelos de razonamiento son especialmente eficaces para revisar y mejorar grandes cantidades de código. Debido a su mayor latencia, estas revisiones suelen ejecutarse en segundo plano.
“Ofrecemos revisiones de código automatizadas con IA en plataformas como GitHub y GitLab. Si bien el proceso de revisión de código no es inherentemente sensible a la latencia, sí requiere comprender las diferencias de código entre varios archivos. Aquí es donde o1 realmente destaca: puede detectar de manera confiable pequeños cambios en una base de código que podrían pasar desapercibidos para un revisor humano. Logramos triplicar las tasas de conversión del producto después de cambiar a los modelos de la serie o”.
—CodeRabbit, startup de revisión de código con IA
Aunque GPT-4o y GPT-4o mini pueden ser más adecuados para escribir código gracias a su menor latencia, también hemos visto que o3-mini destaca en la generación de código para casos de uso un poco menos sensibles a la latencia.
“o3-mini produce de manera consistente código de alta calidad que resuelve el problema y llega con mucha frecuencia a la solución correcta cuando el problema está bien definido, incluso en tareas de programación muy difíciles. Mientras que otros modelos pueden ser útiles solo para iteraciones de código rápidas y de pequeña escala, o3-mini destaca en la planificación e implementación de diseños de sistemas de software complejos”.
—Windsurf, IDE colaborativo basado en IA con agentes, creado por Codeium
7. Evaluación y pruebas comparativas de las respuestas de otros modelos
También hemos observado que los modelos de razonamiento dan buenos resultados al evaluar y realizar pruebas comparativas de las respuestas de otros modelos. La validación de datos es importante para garantizar la calidad y la confiabilidad de los conjuntos de datos, especialmente en ámbitos sensibles como la atención médica. Los métodos de validación tradicionales usan reglas y patrones predefinidos, pero los modelos avanzados como o1 y o3-mini pueden comprender el contexto y razonar sobre los datos para ofrecer un enfoque de validación más flexible e inteligente.
“Muchos clientes usan un LLM como juez dentro de su proceso de evaluación en Braintrust. Por ejemplo, una empresa del sector salud podría resumir las preguntas de los pacientes con un modelo de ejecución como gpt-4o y luego evaluar la calidad del resumen con o1. ¡Un cliente de Braintrust vio cómo la puntuación F1 de un juez pasaba de 0,12 con 4o a 0,74 con o1! En estos casos de uso, han comprobado que el razonamiento de o1 marca una gran diferencia al detectar matices entre las respuestas en las tareas de calificación más difíciles y complejas”.
—Braintrust, plataforma de evaluaciones de IA
Cómo crear prompts eficaces para los modelos de razonamiento
Estos modelos funcionan mejor con prompts directos. Algunas técnicas de ingeniería de prompts, como indicarle al modelo que “piense paso a paso”, pueden no mejorar el rendimiento (e incluso perjudicarlo en ocasiones). Consulta las prácticas recomendadas a continuación o comienza con ejemplos de prompts.
- Los mensajes de desarrollador son los nuevos mensajes de sistema: a partir de
o1-2024-12-17, los modelos de razonamiento admiten mensajes de desarrollador en lugar de mensajes de sistema para ajustarse al comportamiento de la cadena de mando descrito en las especificaciones del modelo. - Mantén los prompts simples y directos: los modelos se destacan por comprender instrucciones breves y claras y responder a ellas.
- Evita los prompts de cadena de pensamiento: como estos modelos razonan internamente, no es necesario pedirles que “piensen paso a paso” o “expliquen su razonamiento”.
- Usa delimitadores para mayor claridad: usa delimitadores como Markdown, etiquetas XML y títulos de sección para distinguir claramente las partes de la entrada y ayudar al modelo a interpretar cada sección de forma adecuada.
- Prueba primero sin ejemplos y luego con pocos ejemplos si es necesario: los modelos de razonamiento suelen producir buenos resultados sin necesidad de ejemplos, así que primero intenta escribir prompts sin ellos. Si tienes requisitos más complejos para la salida deseada, puede ser útil incluir algunos ejemplos de entradas y salidas deseadas en el prompt. Solo asegúrate de que los ejemplos se ajusten con precisión a las instrucciones del prompt, ya que las discrepancias entre ambos pueden producir resultados deficientes.
- Proporciona pautas específicas: si quieres imponer restricciones concretas a la respuesta del modelo (como “propón una solución con un presupuesto inferior a $500”), indícalas explícitamente en el prompt.
- Define tu objetivo final con mucha precisión: en tus instrucciones, procura dar parámetros muy específicos para una respuesta satisfactoria y anima al modelo a seguir razonando e iterando hasta cumplir tus criterios de éxito.
- Formato Markdown: a partir de
o1-2024-12-17, los modelos de razonamiento de la API evitarán generar respuestas con formato Markdown. Para indicarle al modelo que sí quieres este formato en la respuesta, incluye la cadenaFormatting re-enableden la primera línea del mensaje de desarrollador.
Cómo mantener costos bajos y una alta precisión
Con la introducción de los modelos o3 y o4-mini, los elementos de razonamiento almacenados en la API Responses se procesan de otra manera. Antes (con o1, o3-mini, o1-mini y o1-preview), los elementos de razonamiento siempre se ignoraban en las solicitudes posteriores a la API, aunque se incluyeran entre los elementos de entrada de esas solicitudes. Con o3 y o4-mini, algunos elementos de razonamiento adyacentes a las llamadas a funciones se incluyen en el contexto del modelo para ayudar a mejorar su rendimiento usando la menor cantidad posible de tokens de razonamiento.
Para obtener los mejores resultados con este cambio, recomendamos usar la API Responses con el parámetro store establecido en true y pasar todos los elementos de razonamiento de las solicitudes anteriores (ya sea usando previous_response_id o tomando todos los elementos de salida de una solicitud anterior y pasándolos como elementos de entrada de una nueva). OpenAI incluirá automáticamente en el contexto del modelo los elementos de razonamiento pertinentes e ignorará los demás. En casos de uso más avanzados en los que quieras controlar con mayor precisión qué se incluye en el contexto del modelo, recomendamos incluir al menos todos los elementos de razonamiento entre la última llamada a una función y el mensaje de usuario anterior. Esto garantizará que el modelo no tenga que reiniciar su razonamiento cuando respondas a una llamada a una función, lo que mejorará el rendimiento de las llamadas a funciones y reducirá el uso total de tokens.
Si usas la API para completar chats, los elementos de razonamiento nunca se incluyen en el contexto del modelo. Esto se debe a que es una API sin estado. Como resultado, el rendimiento del modelo será ligeramente menor y el uso de tokens de razonamiento será mayor en casos complejos con agentes que impliquen muchas llamadas a funciones. En los casos que no impliquen múltiples llamadas complejas a funciones, no debería haber una disminución del rendimiento, independientemente de la API utilizada.
Otros recursos
Para encontrar más inspiración, visita el OpenAI Cookbook, que contiene código de ejemplo y enlaces a recursos de terceros, o aprende más sobre nuestros modelos y sus capacidades de razonamiento: