
Cómo maximizar la exactitud de los resultados y la consistencia del comportamiento al trabajar con LLM
Optimizar los LLM es difícil.
Hemos trabajado con muchos desarrolladores, tanto de startups como de grandes empresas, y las dificultades de la optimización suelen reducirse a lo siguiente:
- Saber cómo empezar a optimizar la precisión
- Cuándo usar cada método de optimización
- Qué nivel de precisión es suficiente para producción
Este documento presenta un modelo mental para optimizar la precisión y el comportamiento de los LLM. Exploraremos métodos como la ingeniería de prompts, la generación aumentada por recuperación (RAG) y el ajuste fino. También explicaremos cómo y cuándo usar cada técnica, y señalaremos algunos errores comunes.
A medida que leas, es importante relacionar estos principios con lo que significa la precisión en tu caso de uso específico. Puede parecer obvio, pero hay una diferencia entre generar un texto mal redactado que una persona debe corregir y reembolsarle a un cliente $1000 en lugar de $100. Antes de abordar cualquier conversación sobre la precisión de los LLM, debes tener una idea aproximada de cuánto te cuesta un error del LLM y cuánto ahorras o ganas cuando acierta. Retomaremos este tema al final, cuando veamos qué nivel de precisión es “suficiente” para producción.
Contexto de la optimización de los LLM
Muchas guías prácticas sobre optimización la presentan como un proceso lineal sencillo: empiezas con la ingeniería de prompts, luego pasas a la generación aumentada por recuperación y después al ajuste fino. Sin embargo, muchas veces no funciona así. Cada una de estas herramientas resuelve problemas distintos y, para optimizar en la dirección correcta, debes elegir la adecuada.
Resulta útil pensar en la optimización de los LLM como una matriz:

Una tarea típica con un LLM comienza en la esquina inferior izquierda con la ingeniería de prompts, donde hacemos pruebas, aprendemos y evaluamos para establecer una referencia inicial. Una vez que revisamos esos ejemplos iniciales y analizamos por qué son incorrectos, podemos recurrir a una de nuestras herramientas:
- Optimización del contexto: debes optimizar el contexto cuando 1) el modelo carece de conocimiento contextual porque no estaba en su conjunto de entrenamiento, 2) su conocimiento está desactualizado o 3) necesita conocer información de propiedad privada. Este eje maximiza la precisión de las respuestas.
- Optimización del LLM: debes optimizar el LLM cuando 1) el modelo produce resultados inconsistentes con un formato incorrecto, 2) el tono o el estilo de expresión no es el adecuado o 3) no sigue el razonamiento de manera consistente. Este eje maximiza la consistencia del comportamiento.
En la práctica, esto se convierte en una serie de pasos de optimización: evaluamos, formulamos una hipótesis sobre cómo optimizar, la ponemos en práctica, evaluamos de nuevo y reconsideramos la situación para definir el siguiente paso. Este es un ejemplo de un flujo de optimización bastante típico:
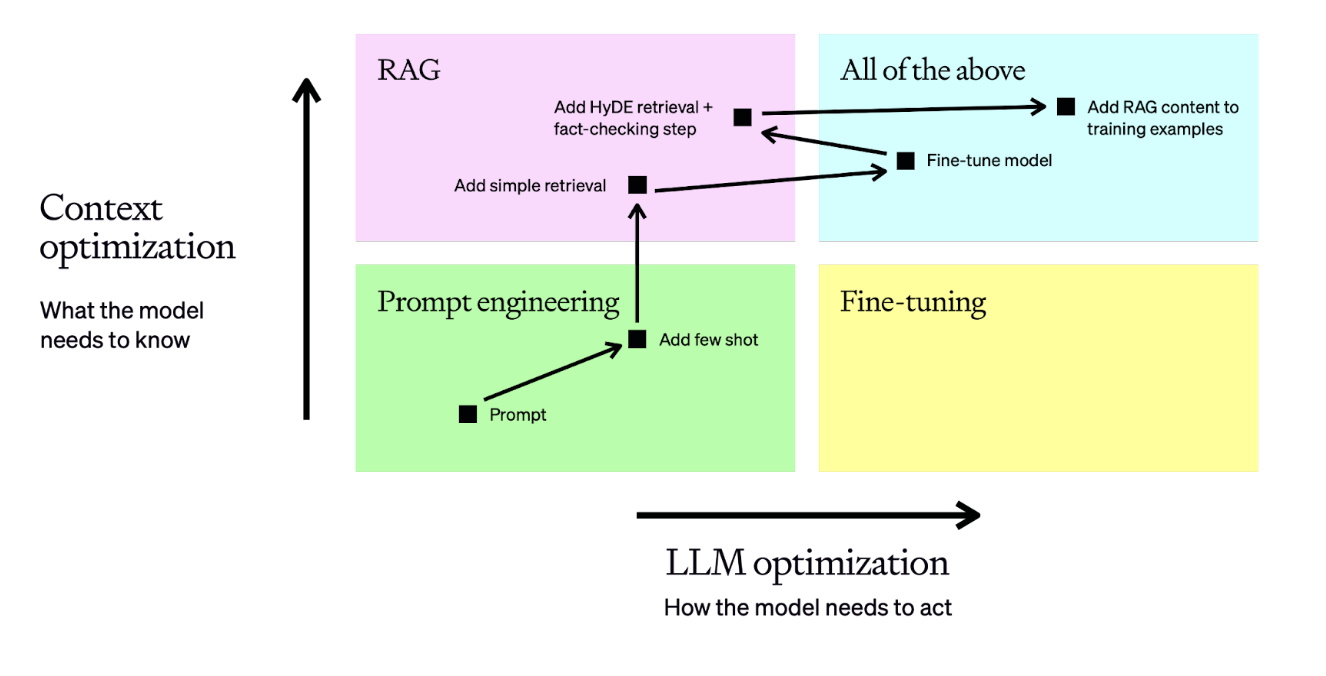
En este ejemplo, hacemos lo siguiente:
- Comenzamos con un prompt y luego evaluamos su rendimiento
- Agregamos unos pocos ejemplos estáticos, lo que debería mejorar la consistencia de los resultados
- Agregamos un paso de recuperación para incorporar dinámicamente esos pocos ejemplos según la pregunta. Esto mejora el rendimiento al garantizar un contexto relevante para cada entrada
- Preparamos un conjunto de datos de 50 o más ejemplos y realizamos el ajuste fino de un modelo para aumentar la consistencia
- Ajustamos la recuperación y agregamos un paso de verificación de hechos para detectar alucinaciones y lograr una mayor precisión
- Volvemos a entrenar el modelo con ajuste fino usando los nuevos ejemplos de entrenamiento, que incluyen nuestras entradas de RAG mejoradas
Este es un proceso de optimización bastante típico para un problema empresarial difícil. Nos ayuda a decidir si necesitamos un contexto más relevante o un comportamiento más consistente del modelo. Una vez que tomamos esa decisión, sabemos qué herramienta usar como primer paso hacia la optimización.
Ahora que tenemos un modelo mental, veamos los métodos para trabajar en cada una de estas áreas. Comenzaremos en la esquina inferior izquierda con la ingeniería de prompts.
Ingeniería de prompts
La ingeniería de prompts suele ser el mejor punto de partida**. A menudo es el único método necesario para casos de uso como la creación de resúmenes, la traducción y la generación de código, donde un enfoque sin ejemplos puede alcanzar niveles de precisión y consistencia aptos para producción.
Esto se debe a que te obliga a definir qué significa la precisión en tu caso de uso. Empiezas por lo más básico, proporcionando una entrada, por lo que necesitas poder determinar si la salida cumple tus expectativas. Si no obtienes lo que buscas, entender por qué te indicará qué usar para seguir optimizando.
Para lograrlo, siempre debes empezar con un prompt sencillo y una salida esperada en mente. Luego, optimiza el prompt agregando contexto, instrucciones o ejemplos hasta obtener lo que buscas.
Optimización
Para optimizar tus prompts, me basaré principalmente en las estrategias de la guía de ingeniería de prompts de la documentación de la API de OpenAI. Cada estrategia te ayuda a ajustar el contexto, el LLM o ambos:
| Estrategia | Optimización del contexto | Optimización del LLM |
|---|---|---|
| Escribe instrucciones claras | X | |
| Divide las tareas complejas en subtareas más sencillas | X | X |
| Dales tiempo a los GPT para “pensar” | X | |
| Prueba los cambios de manera sistemática | X | X |
| Proporciona texto de referencia | X | |
| Usa herramientas externas | X |
Estas estrategias pueden ser un poco difíciles de visualizar, así que las pondremos a prueba con un ejemplo práctico. Usemos gpt-4-turbo para corregir oraciones en islandés y ver cómo puede funcionar.
Hemos visto que la ingeniería de prompts es un excelente punto de partida y que, con los métodos de ajuste adecuados, podemos mejorar bastante el rendimiento.
Sin embargo, el mayor problema de la ingeniería de prompts es que a menudo no escala: o bien necesitamos proporcionar contexto dinámico para que el modelo pueda abordar una variedad de problemas más amplia de la que podemos cubrir agregando contenido al contexto, o bien necesitamos un comportamiento más consistente del que podemos lograr con unos pocos ejemplos.
Los modelos de contexto largo permiten llevar más lejos la ingeniería de prompts. Sin embargo, ten en cuenta que los modelos pueden tener dificultades para mantener la atención en prompts muy extensos con instrucciones complejas. Por eso, siempre debes acompañar el uso de modelos de contexto largo con evaluaciones de distintos tamaños de contexto para asegurarte de que la información no se pierda en medio del contexto. “Perderse en medio del contexto” es una expresión que describe la incapacidad de un LLM para prestar la misma atención a todos los tokens que recibe en un momento dado. Esto puede hacer que omita información de forma aparentemente aleatoria. No significa que debas evitar los contextos largos, sino que debes acompañarlos con evaluaciones exhaustivas. Un colaborador de código abierto, Greg Kamradt, creó una evaluación útil llamada Needle in A Haystack (NITA) que ocultaba un dato a distintas profundidades en documentos de contexto largo y evaluaba la calidad de la recuperación. Esto ilustra el problema de los contextos largos: prometen un proceso de recuperación mucho más sencillo, en el que puedes incluir todo en el contexto, pero a costa de la precisión.
Entonces, ¿hasta dónde puedes llegar realmente con la ingeniería de prompts? La respuesta es que depende, y las evaluaciones te permiten tomar esa decisión.
Evaluación
Por eso, un buen prompt acompañado de un conjunto de evaluación con preguntas y respuestas de referencia es el mejor resultado de esta etapa. Si tenemos un conjunto de 20 o más preguntas y respuestas, hemos analizado los errores en detalle y tenemos una hipótesis sobre sus causas, entonces contamos con la base adecuada para aplicar métodos de optimización más avanzados.
Antes de pasar a métodos de optimización más sofisticados, también conviene considerar cómo automatizar esta evaluación para acelerar las iteraciones. Algunas prácticas habituales que hemos visto dar buenos resultados son:
- Usar enfoques como ROUGE o BERTScore para obtener una valoración aproximada. Esta no se correlaciona tan estrechamente con las valoraciones de revisores humanos, pero puede ofrecer una medida rápida y eficaz de cuánto cambió una iteración los resultados del modelo.
- Usar GPT-4 como evaluador, tal como se describe en el artículo de G-Eval, donde se le proporciona al LLM una rúbrica para evaluar el resultado con la mayor objetividad posible.
Si quieres profundizar en estos enfoques, consulta este cookbook, que te guía por la aplicación práctica de cada uno.
Comprender las herramientas
Ya aplicaste ingeniería de prompts, tienes un conjunto de evaluación y tu modelo sigue sin hacer lo que necesitas. El siguiente paso más importante es diagnosticar en qué falla y qué herramienta funciona mejor para mejorarlo.
Este es un marco básico para hacerlo:
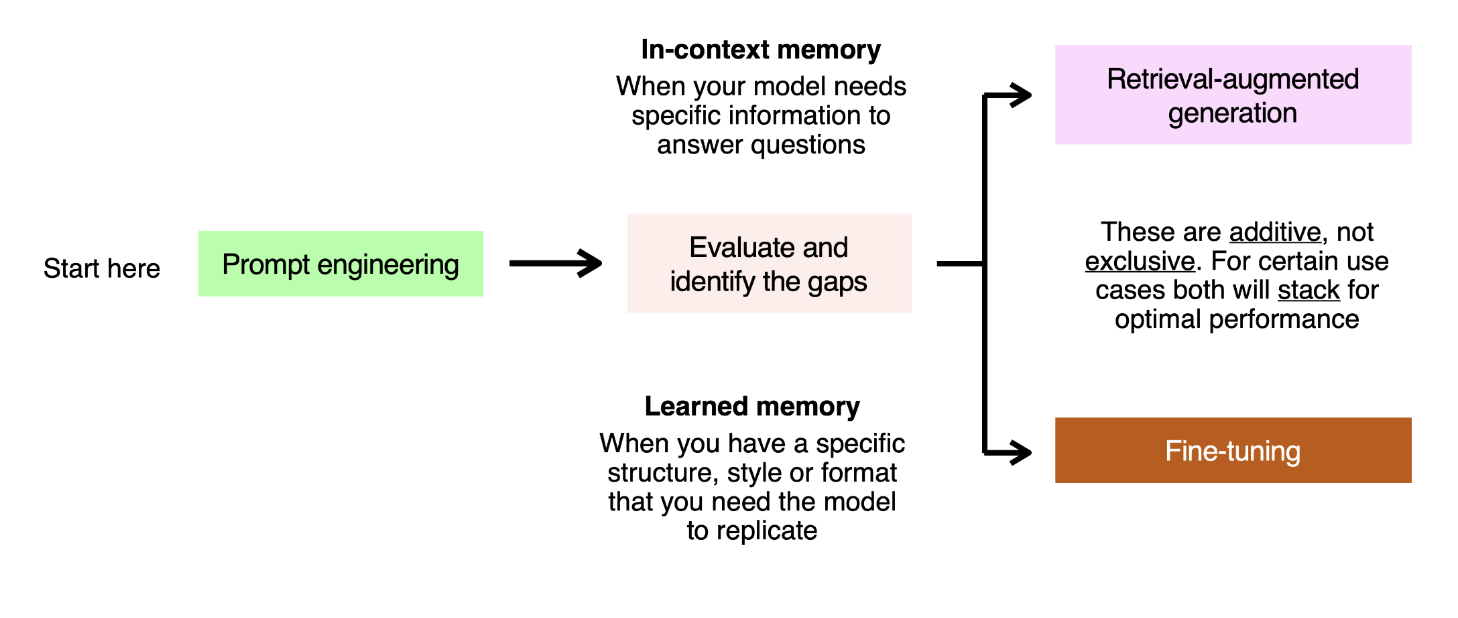
Puedes considerar cada pregunta de evaluación que el modelo respondió incorrectamente como un problema de memoria en contexto o aprendida . Como analogía, imagina que estás respondiendo un examen. Hay dos formas de asegurarte de dar la respuesta correcta:
- Has asistido a clase durante los últimos 6 meses y has visto muchos ejemplos repetidos de cómo funciona un concepto determinado. Esto es memoria aprendida . En los LLM, resuelves este problema mostrando ejemplos del prompt y la respuesta que esperas para que el modelo aprenda de ellos.
- Tienes el libro de texto contigo y puedes buscar la información adecuada para responder la pregunta. Esto es memoria en contexto . En los LLM, resolvemos este problema incorporando información relevante a la ventana de contexto, ya sea de forma estática mediante ingeniería de prompts o a escala mediante RAG.
Estos dos métodos de optimización se complementan, no se excluyen : se combinan, y algunos casos de uso requerirán que los utilices juntos para lograr un rendimiento óptimo.
Supongamos que enfrentamos un problema de memoria a corto plazo. Usaremos RAG para resolverlo.
Generación aumentada por recuperación (RAG)
RAG es el proceso de recuperar contenido para ampliar el prompt de tu LLM antes de generar una respuesta. Se utiliza para darle al modelo acceso a contexto específico de un dominio para resolver una tarea.
RAG es una herramienta sumamente valiosa para aumentar la precisión y la consistencia de un LLM. Muchas de nuestras implementaciones de mayor escala para clientes de OpenAI se realizaron únicamente con ingeniería de prompts y RAG.
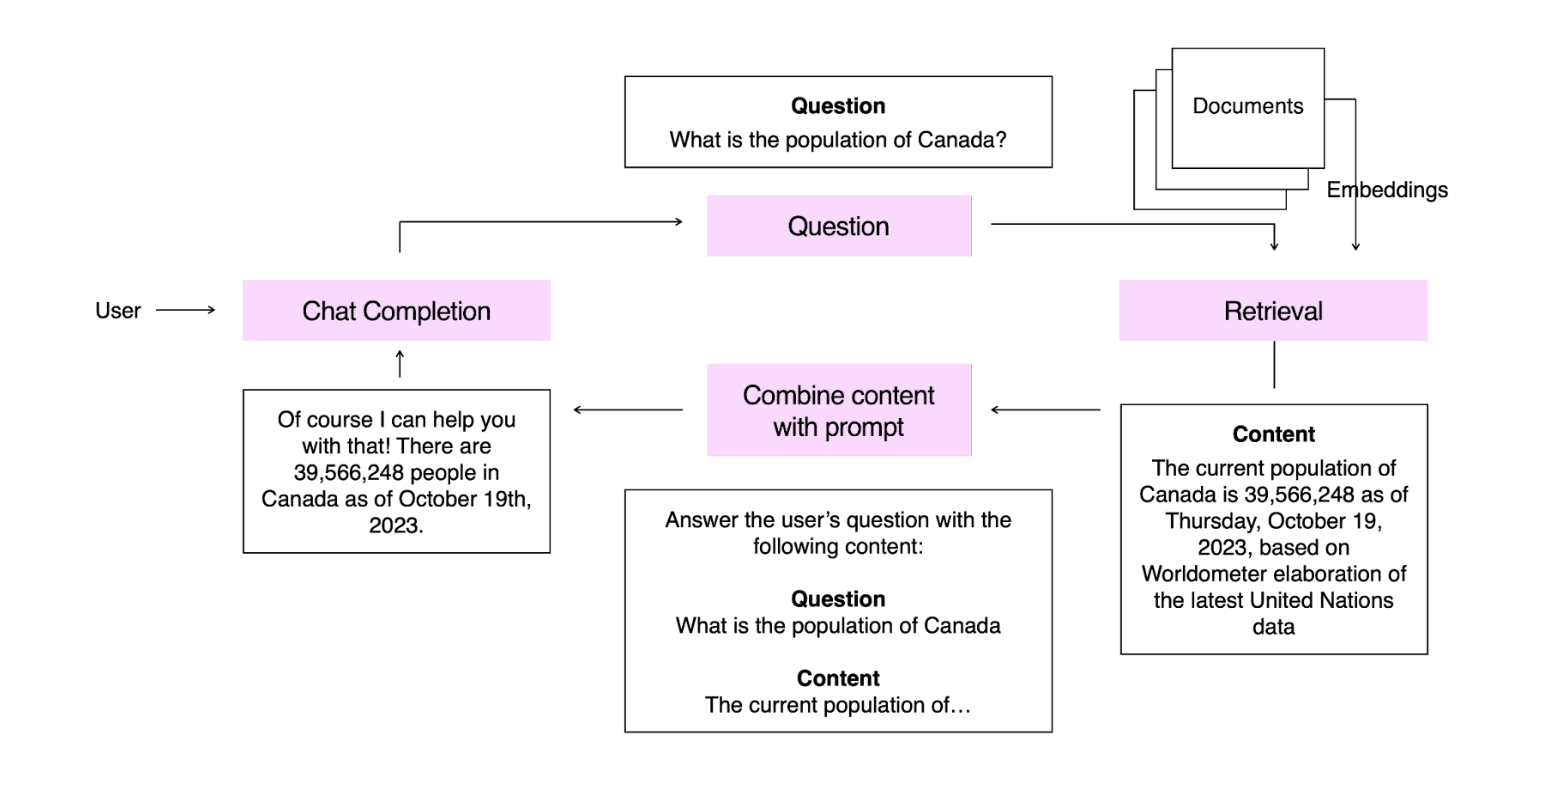
En este ejemplo, hemos generado embeddings de una base de conocimientos de estadísticas. Cuando el usuario hace una pregunta, generamos un embedding de esa pregunta y recuperamos el contenido más relevante de nuestra base de conocimientos. Ese contenido se presenta al modelo, que responde la pregunta.
Las aplicaciones RAG introducen un nuevo eje que debemos optimizar: la recuperación. Para que nuestro sistema RAG funcione, debemos darle al modelo el contexto adecuado y luego evaluar si responde correctamente. Organizaré estos aspectos en una matriz para mostrar una forma sencilla de abordar la evaluación con RAG:
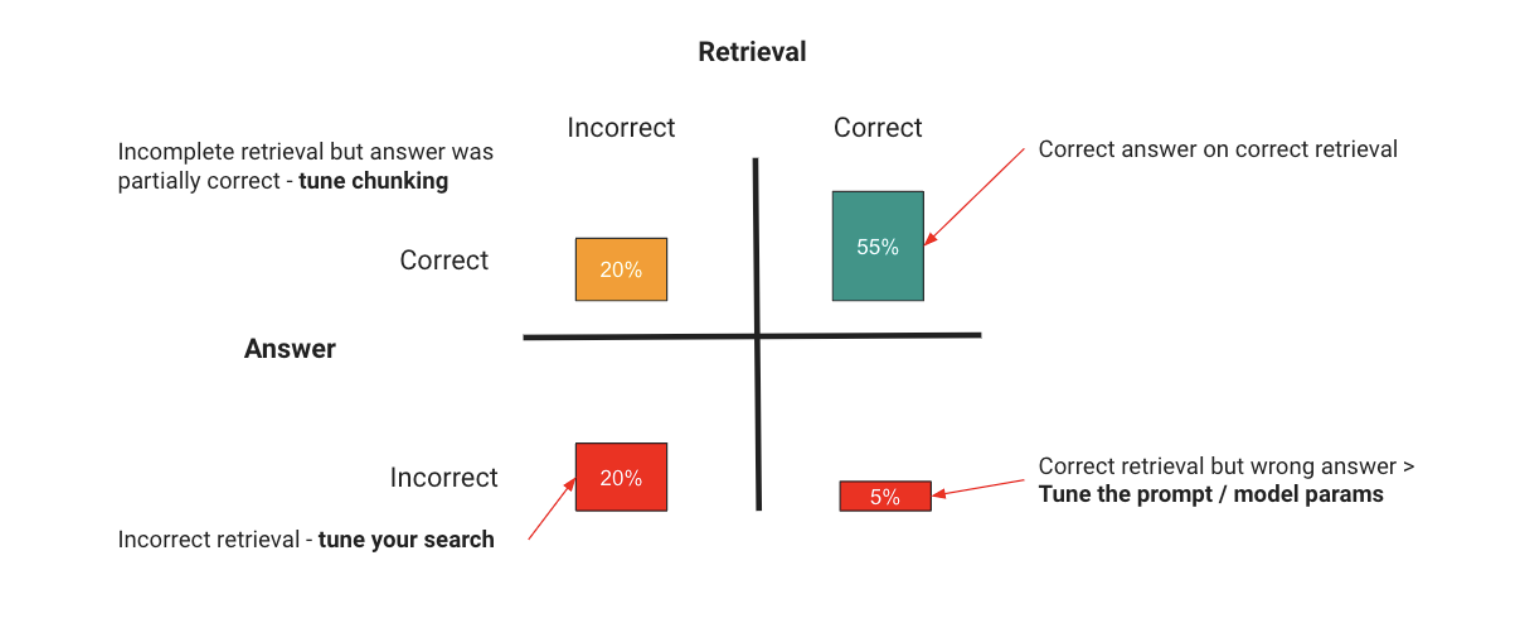
Hay dos áreas en las que tu aplicación RAG puede fallar:
| Área | Problema | Solución |
|---|---|---|
| Recuperación | Puedes proporcionar un contexto incorrecto que le impida al modelo responder, o demasiado contexto irrelevante que oculte la información real y provoque alucinaciones. | Optimizar la recuperación, lo que puede incluir: - Ajustar la búsqueda para que devuelva los resultados correctos. - Ajustar la búsqueda para que incluya menos ruido. - Proporcionar más información en cada resultado recuperado Estos son solo ejemplos, ya que optimizar el rendimiento de RAG es toda una especialidad, y bibliotecas como LlamaIndex y LangChain ofrecen muchos enfoques para hacerlo. |
| LLM | El modelo también puede recibir el contexto adecuado y utilizarlo de manera incorrecta. | Aplicar ingeniería de prompts para mejorar las instrucciones y el método que utiliza el modelo y, si mostrarle ejemplos aumenta la precisión, incorporar el ajuste fino |
La idea clave es que el principio sigue siendo el mismo que el de nuestro modelo mental inicial: evalúas para identificar qué salió mal y aplicas una optimización para corregirlo. La única diferencia con RAG es que ahora también debes considerar el eje de recuperación.
Aunque es útil, RAG solo resuelve nuestros problemas de aprendizaje en contexto. En muchos casos de uso, el desafío será asegurar que el LLM pueda aprender una tarea para realizarla de manera consistente y confiable. Para resolver este problema, recurrimos al ajuste fino.
Ajuste fino
Para resolver un problema de memoria aprendida, muchos desarrolladores continúan el proceso de entrenamiento del LLM con un conjunto de datos más pequeño y específico del dominio para optimizarlo para esa tarea. Este proceso se conoce como ajuste fino.
El ajuste fino suele realizarse por una de estas dos razones:
- Mejorar la precisión del modelo en una tarea específica: entrenar el modelo con datos específicos de la tarea para resolver un problema de memoria aprendida, mostrándole muchos ejemplos de esa tarea realizada correctamente.
- Mejorar la eficiencia del modelo: lograr la misma precisión con menos tokens o con un modelo más pequeño.
El proceso de ajuste fino comienza con la preparación de un conjunto de datos con ejemplos de entrenamiento. Este es el paso más crítico, ya que los ejemplos de ajuste fino deben representar exactamente lo que el modelo encontrará en el mundo real.
Muchos clientes utilizan un proceso conocido como prompt baking, en el que registran de forma exhaustiva las entradas y salidas de sus prompts durante una prueba piloto. Estos registros se pueden depurar para obtener un conjunto de entrenamiento eficaz con ejemplos realistas.
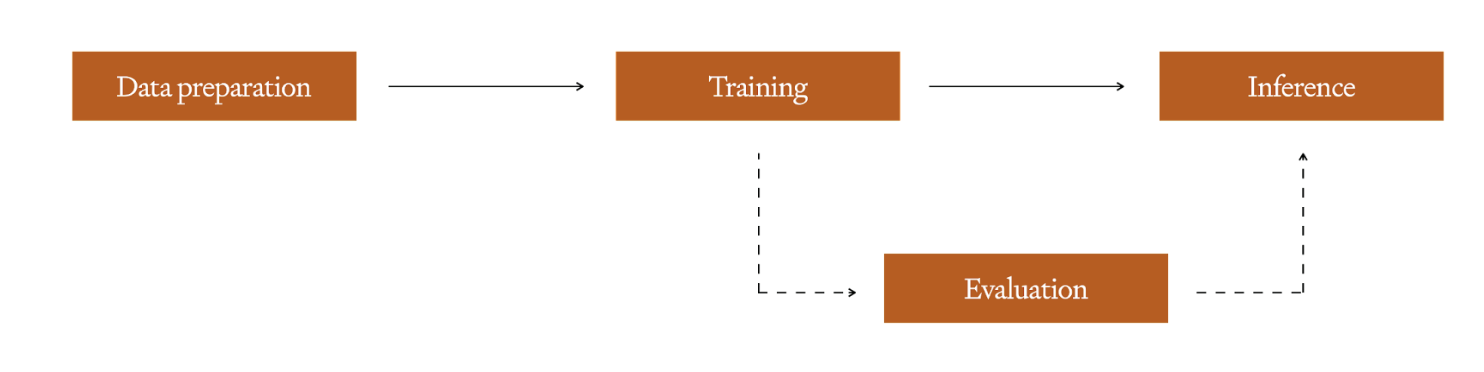
Una vez que tengas este conjunto depurado, puedes crear un modelo con ajuste fino mediante una ejecución de entrenamiento . Según la plataforma o el framework que utilices para entrenarlo, puede haber hiperparámetros que puedas ajustar, como en cualquier otro modelo de aprendizaje automático. Siempre recomendamos reservar un conjunto de datos para la evaluación posterior al entrenamiento, a fin de detectar sobreajuste. Para obtener consejos sobre cómo crear un buen conjunto de entrenamiento, consulta las recomendaciones de nuestra documentación de ajuste fino. Una vez completado el entrenamiento, el nuevo modelo con ajuste fino estará disponible para inferencia.
Para optimizar el ajuste fino, nos centraremos en las prácticas recomendadas que observamos con las soluciones de personalización de modelos de OpenAI, aunque estos principios también deberían ser válidos para otros proveedores y soluciones de código abierto. Las prácticas clave son:
- Comienza con la ingeniería de prompts: prepara un conjunto de evaluación sólido durante la ingeniería de prompts que puedas usar como referencia. Esto te permite mantener una inversión baja hasta que tengas confianza en tu prompt base.
- Comienza con pocos datos y prioriza la calidad: la calidad de los datos de entrenamiento es más importante que la cantidad al realizar ajuste fino sobre un modelo fundacional. Comienza con 50 o más ejemplos, evalúa y luego aumenta el tamaño del conjunto de entrenamiento si aún no alcanzas la precisión que necesitas y si los problemas que causan respuestas incorrectas se deben a la consistencia o al comportamiento, y no al contexto.
- Asegúrate de que tus ejemplos sean representativos: uno de los errores más comunes que observamos es usar datos de entrenamiento no representativos, cuyos ejemplos difieren sutilmente en formato o forma de lo que el LLM encuentra en producción. Por ejemplo, si tienes una aplicación RAG, realiza el ajuste fino del modelo con ejemplos de RAG para que no tenga que aprender a usar el contexto sin ejemplos.
Todo lo anterior
Estas técnicas se complementan. Si tus primeras evaluaciones muestran problemas tanto de contexto como de comportamiento, es probable que termines usando ajuste fino + RAG en tu solución de producción. Esto está bien: al combinarse, compensan las debilidades de ambos enfoques. Algunos de los principales beneficios son:
- Usar el ajuste fino para minimizar la cantidad de tokens utilizados en la ingeniería de prompts, al sustituir las instrucciones y los pocos ejemplos del prompt por numerosos ejemplos de entrenamiento que afiancen un comportamiento consistente en el modelo.
- Enseñar comportamientos complejos mediante un ajuste fino exhaustivo
- Usar RAG para incorporar contexto, contenido más reciente o cualquier otro contexto especializado que requieran tus casos de uso
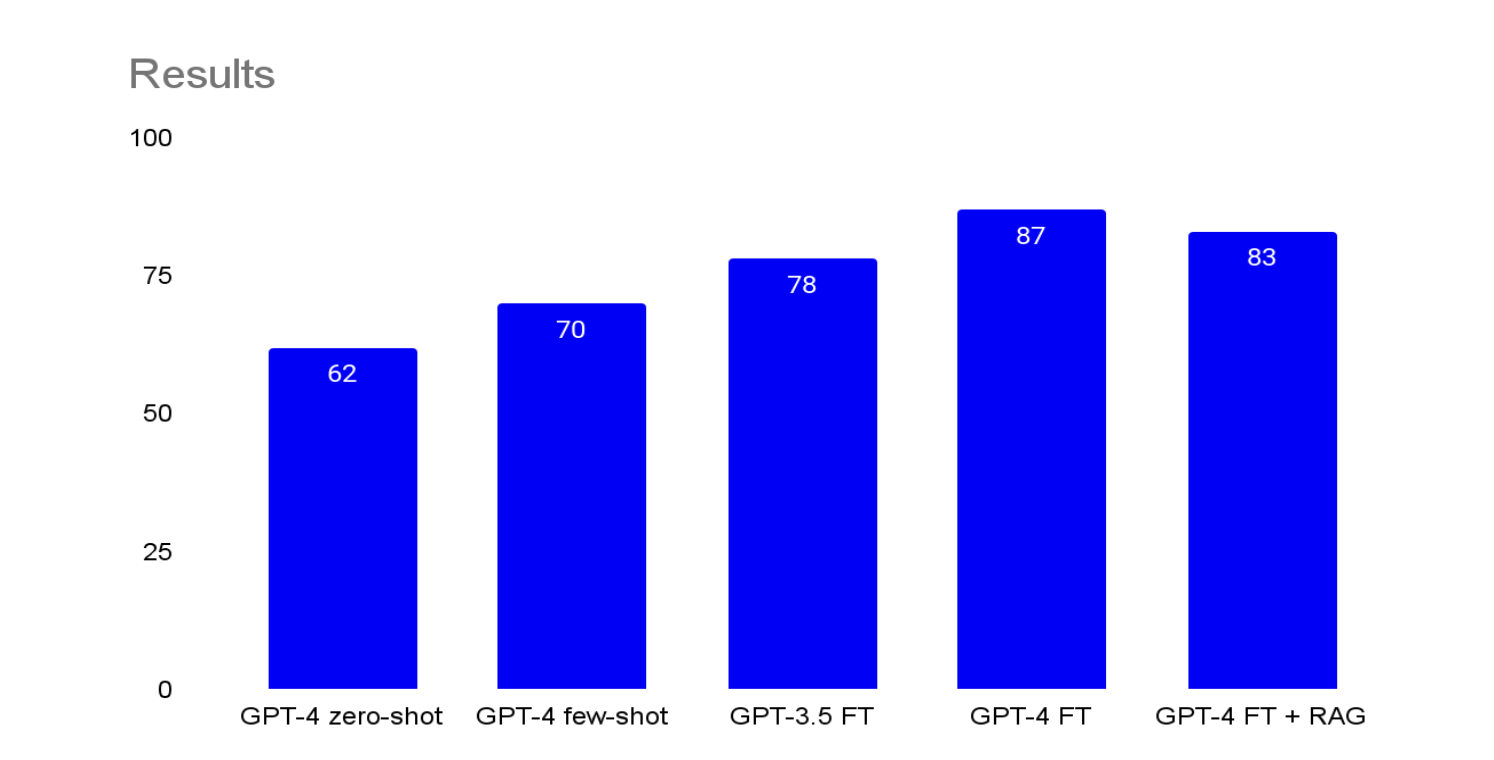 Puntuación Bleu por método de ajuste (sobre 100)
Ahora deberías comprender el valor de RAG y del ajuste fino, y cuándo conviene usar cada uno. Lo último que debes tener en cuenta es que incorporar estas herramientas tiene un costo en la velocidad de iteración:
- Con RAG, debes ajustar tanto la recuperación como el comportamiento del LLM
- Con el ajuste fino, debes volver a ejecutar el proceso de ajuste fino y gestionar tus conjuntos de entrenamiento y validación cada vez que realices ajustes adicionales.
Ambos procesos pueden ser complejos y requerir mucho tiempo, además de introducir regresiones a medida que tu aplicación con LLM se vuelve más compleja. Si te quedas con una sola idea de este artículo, que sea obtener la mayor precisión posible con métodos básicos antes de recurrir a opciones más complejas como RAG o el ajuste fino. Tu objetivo debe ser alcanzar la precisión que necesitas, no apresurarte a usar RAG + FT porque se consideran las opciones más sofisticadas.
Qué nivel de precisión es “suficiente” para producción
Optimizar la precisión de los LLM puede ser una tarea interminable: es poco probable que alcancen una precisión del 99,999 % con métodos listos para usar. Esta sección se centra en decidir cuándo la precisión es suficiente: cómo sentirte seguro al poner un LLM en producción y cómo gestionar el riesgo de la solución que lanzas.
Me resulta útil analizar esto tanto desde la perspectiva del negocio como desde la perspectiva técnica . Describiré los enfoques generales para abordar ambas y usaré un caso de uso de una mesa de ayuda de atención al cliente para ilustrar cómo gestionamos el riesgo en cada una.
Negocio
Para una empresa, puede ser difícil confiar en los LLM después de la relativa previsibilidad de los sistemas basados en reglas o de aprendizaje automático tradicional, ¡o incluso de las personas! Un sistema cuyos fallos pueden adoptar formas muy diversas e impredecibles plantea un desafío difícil de resolver.
Un enfoque que he visto funcionar en este ámbito se aplicó a un caso de uso de atención al cliente. Hicimos lo siguiente:
Primero identificamos los principales casos de éxito y de fallo, y les asignamos un costo estimado. Esto nos da una idea clara de lo que la solución probablemente ahorre o cueste según su desempeño en la prueba piloto.
- Por ejemplo, un caso resuelto por una IA que antes resolvía una persona puede generar un ahorro de $20.
- Derivar a una persona a un agente humano cuando no es necesario podría costar $40
- En el peor de los casos, un cliente se frustra tanto con la IA que deja de usar el servicio, lo que nos cuesta $1000. Suponemos que esto ocurre en el 5 % de los casos.
| Evento | Valor | Número de casos | Valor total |
|---|---|---|---|
| Éxito de la IA | +20 | 815 | $16 300 |
| Fallo de la IA (derivación) | -40 | 175,75 | $7030 |
| Fallo de la IA (pérdida del cliente) | -1000 | 9,25 | $9250 |
| Resultado | +20 | ||
| Precisión en el punto de equilibrio | 81,5 % |
También recopilamos estadísticas empíricas del proceso que nos ayudarán a medir el impacto global de la solución. Volviendo al ejemplo de atención al cliente, podrían ser las siguientes:
- La puntuación CSAT de las interacciones exclusivamente humanas frente a las interacciones con IA
- La precisión de las decisiones en los casos revisados retrospectivamente, comparando a las personas con la IA
- El tiempo de resolución de las personas frente al de la IA
En el ejemplo de atención al cliente, esto nos ayudó a tomar dos decisiones clave después de realizar algunas pruebas piloto para obtener datos claros:
- Aunque nuestra solución con LLM derivaba más casos a personas de lo que queríamos, seguía generando un enorme ahorro en costos operativos frente a la solución existente. Esto significaba que incluso una precisión del 85 % podía ser aceptable si ese 15 % restante correspondía principalmente a derivaciones tempranas.
- Cuando el costo de un error era muy alto, como resolver incorrectamente un caso de fraude, decidimos que la persona llevaría el control y la IA actuaría como asistente. En este caso, la métrica de precisión de las decisiones nos ayudó a determinar que no nos sentíamos cómodos con una autonomía total.
Aspectos técnicos
En el aspecto técnico, la situación es más clara: ahora que la empresa tiene claro el valor que espera y el costo de lo que puede salir mal, tu función es crear una solución que gestione los errores adecuadamente sin interrumpir la experiencia del usuario.
Retomemos el ejemplo de atención al cliente para ilustrar esto y supongamos que tenemos un modelo con una precisión del 85 % al determinar la intención. Como equipo técnico, podemos minimizar el impacto del 15 % de errores de las siguientes maneras:
- Podemos usar ingeniería de prompts para que el modelo le pida más información al cliente cuando no esté seguro. Así, nuestra precisión en el primer intento podría disminuir, pero podríamos lograr una mayor precisión con 2 intentos para determinar la intención.
- Podemos darle al asistente de segundo nivel la opción de volver a la etapa de determinación de la intención. Esto permite, una vez más, que la experiencia del usuario se recupere por sí sola, a costa de un tiempo de espera algo mayor.
- Podemos usar ingeniería de prompts para que el modelo derive el caso a una persona si la intención no está clara. Esto reduce parte del ahorro operativo a corto plazo, pero podría compensar el riesgo de perder clientes a largo plazo.
Estas decisiones repercuten en la experiencia del usuario, que se vuelve más lenta a cambio de una mayor precisión, o generan más intervenciones humanas, que a su vez repercuten en el modelo de costos descrito en la sección de negocio anterior.
Ahora tienes un enfoque para desglosar las decisiones de negocio y técnicas necesarias para establecer un objetivo de precisión basado en la realidad de la empresa.
Cómo seguir adelante
Este es un modelo mental general para pensar en cómo maximizar la precisión de los LLM, las herramientas que puedes usar para lograrlo y el enfoque para decidir qué nivel es suficiente para producción. Tienes el marco y las herramientas que necesitas para llegar a producción de forma consistente. Si quieres inspirarte en lo que otros han logrado con estos métodos, consulta nuestras historias de clientes, donde casos de uso como los de Morgan Stanley y Klarna muestran lo que puedes conseguir al aplicar estas técnicas.
¡Mucho éxito! Nos entusiasma ver lo que crearás con todo esto.