
En septiembre de 2025, OpenAI presentó GPT-5-Codex como la primera versión de GPT-5 optimizada para la codificación con agentes. En diciembre de 2025, lanzamos 5.2, y fue entonces cuando la gente empezó a creer que los agentes autónomos de programación podían ser confiables. En particular, vimos un gran aumento en el tiempo durante el cual el modelo podía seguir instrucciones de manera confiable.
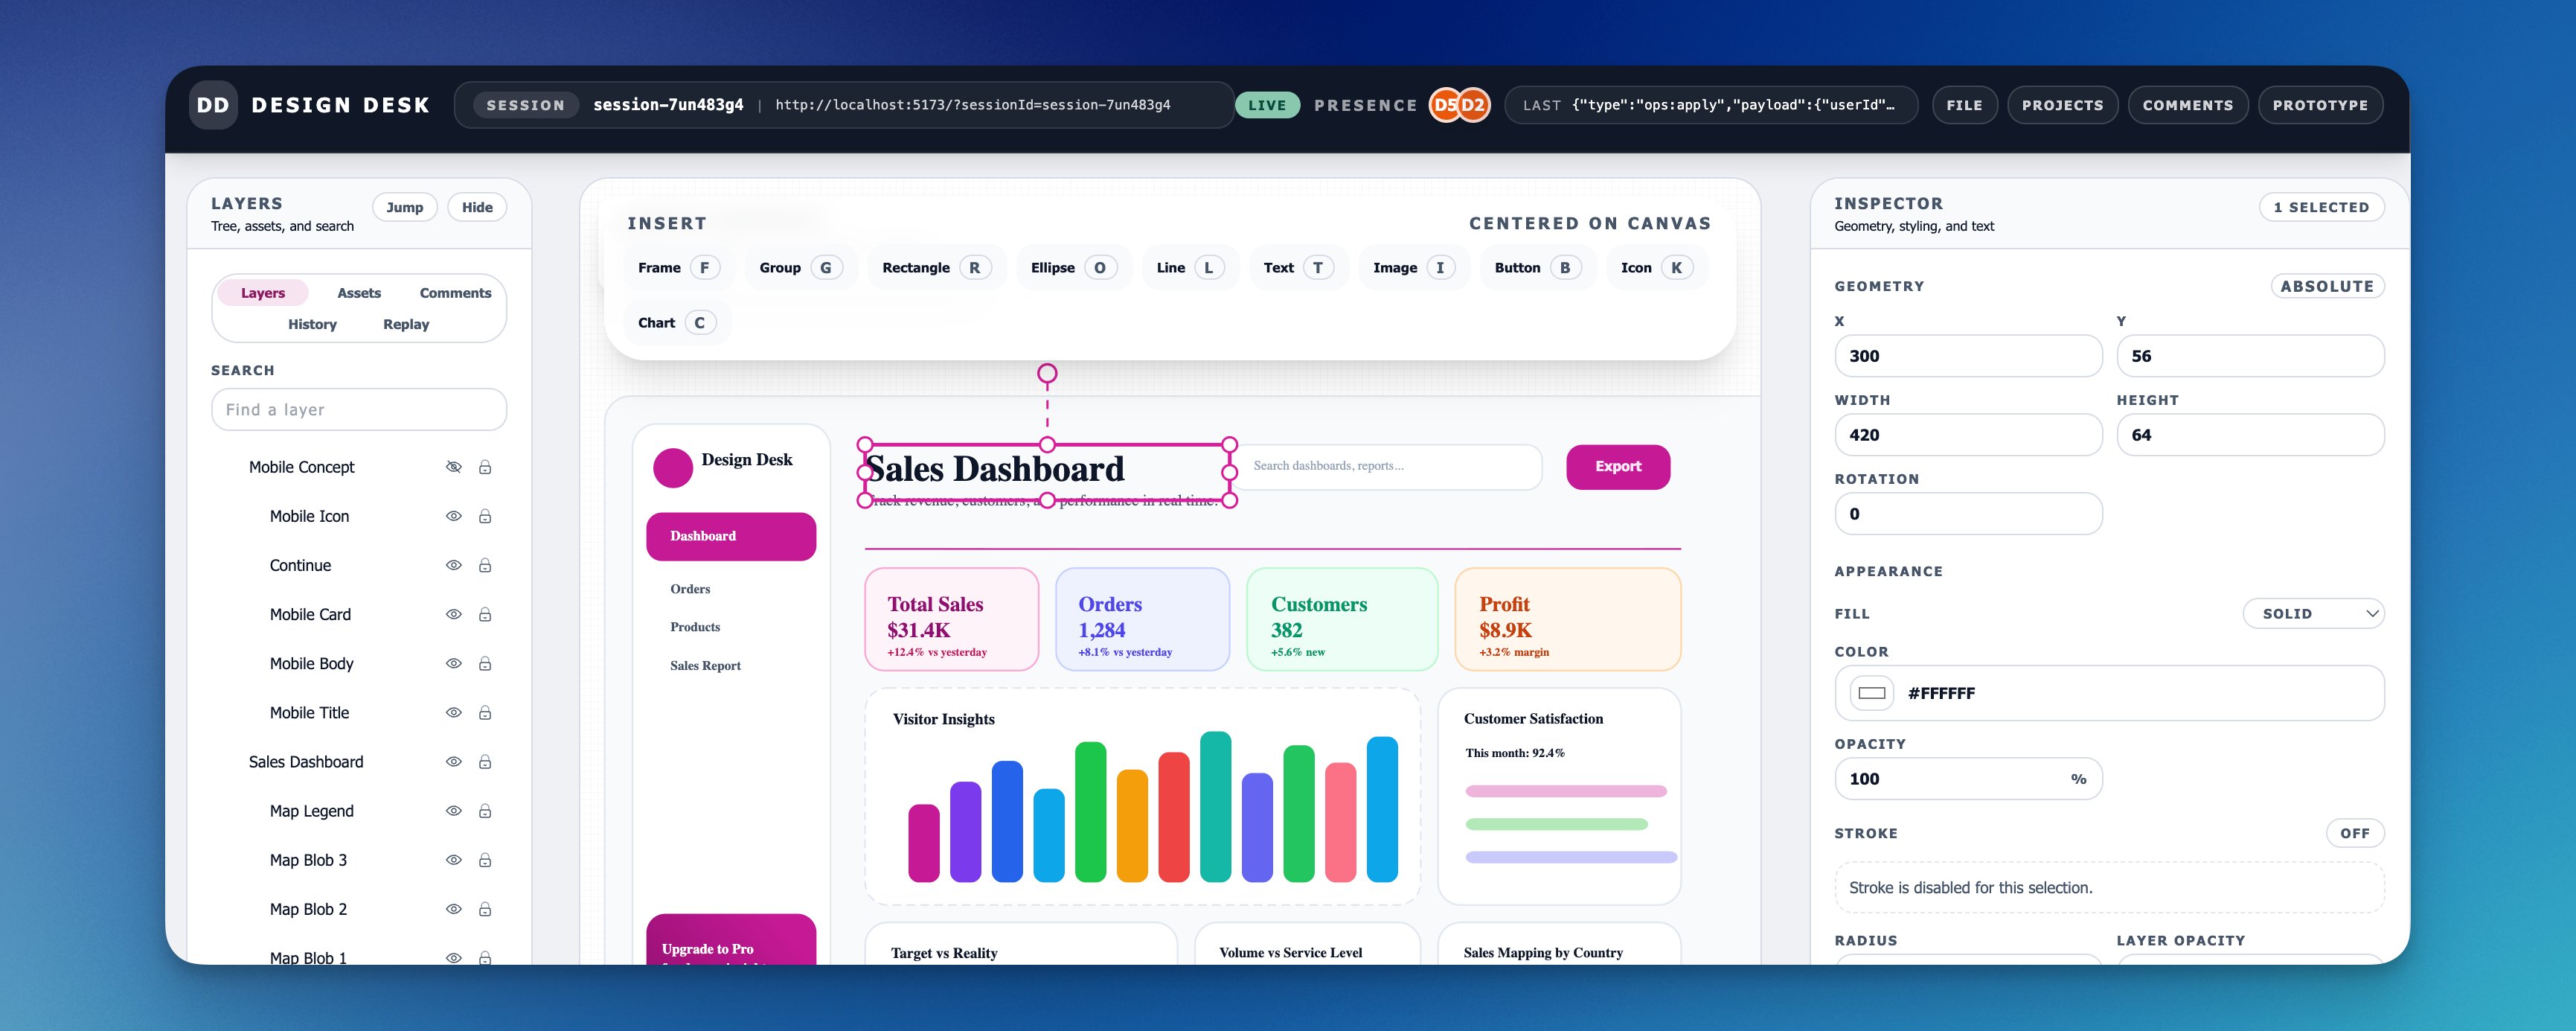
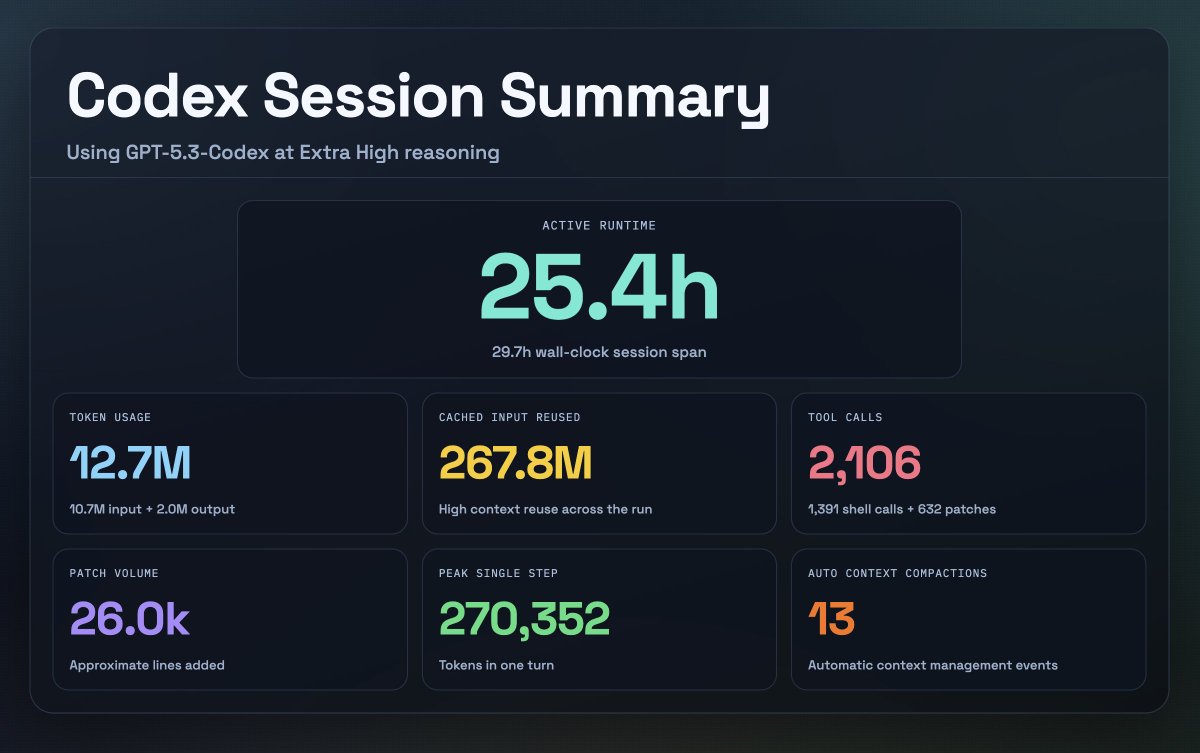
Quería poner a prueba ese límite. Así que le di a Codex un repositorio vacío, acceso completo y una sola tarea: crear una herramienta de diseño desde cero. Luego lo dejé trabajar con GPT-5.3-Codex en el nivel de razonamiento “Muy alta”. Codex trabajó durante unas 25 horas sin interrupciones, utilizó alrededor de 13 millones de tokens y generó unas 30 000 líneas de código.
Esto fue un experimento, no un despliegue en producción. Pero tuvo un buen desempeño en los aspectos que importan para el trabajo de larga duración: seguir la especificación, mantenerse enfocado en la tarea, ejecutar verificaciones y corregir errores sobre la marcha.
Cómo es una sesión de larga duración de Codex
Le pedí a Codex que generara una página con un resumen de los datos de la sesión:
Y aquí se muestran las estadísticas de la sesión de la CLI y el uso de tokens:
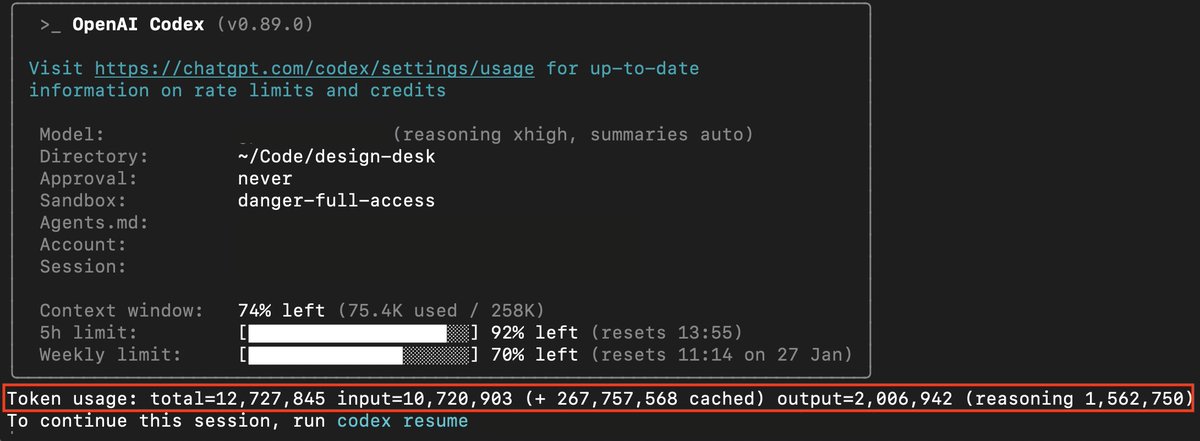
Estas capturas de pantalla son útiles porque hacen visible el cambio fundamental: la codificación con agentes depende cada vez más del horizonte temporal, no solo de la inteligencia demostrada en una sola respuesta.
El verdadero cambio está en el horizonte temporal
No se trata solo de que “los modelos se volvieron más inteligentes”. El cambio práctico es que los agentes pueden mantener la coherencia durante más tiempo, completar bloques más grandes de trabajo de principio a fin y recuperarse de los errores sin perder el hilo.
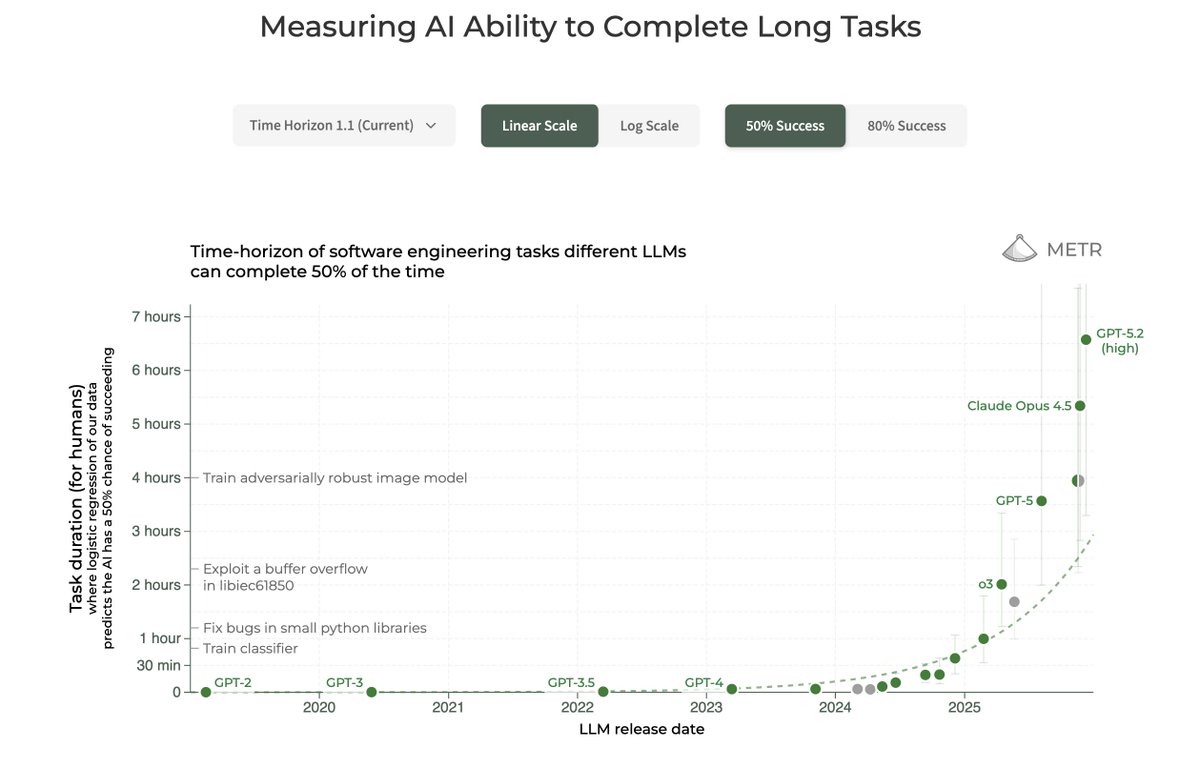
El trabajo de METR sobre pruebas de referencia del horizonte temporal ofrece un marco útil para entender esta tendencia: la duración de las tareas de software que los agentes de vanguardia pueden completar con una confiabilidad de aproximadamente el 50 % y el 80 % ha aumentado rápidamente y se duplica aproximadamente cada 7 meses. Consulta Medición de la capacidad de la IA para completar tareas largas (METR).
Nuestro reciente anuncio del lanzamiento de GPT-5.3-Codex lleva esta tendencia más lejos en el trabajo de los agentes de dos maneras prácticas:
- Ejecuta mejor las tareas de varios pasos (planificar → implementar → validar → corregir).
- Es más fácil orientarlo sobre la marcha sin reiniciar toda la ejecución (las correcciones de rumbo no borran el progreso).
También me inspiraron las publicaciones de Cursor sobre sistemas autónomos de programación de larga duración, incluido su experimento de crear un navegador: cómo Cursor creó un navegador web (Escalar agentes).
El equipo de Cursor escribió que los modelos de OpenAI son “mucho mejores en el trabajo autónomo prolongado: siguen instrucciones, mantienen el enfoque, evitan desviarse e implementan las cosas de forma precisa y completa”.
Por qué Codex puede mantener la coherencia en tareas largas
El trabajo de larga duración depende menos de un prompt enorme y más del ciclo del agente en el que opera el modelo.
En Codex, el ciclo es, a grandes rasgos, el siguiente:
- Planificar
- Editar código
- Ejecutar herramientas (pruebas/compilación/lint)
- Observar los resultados
- Corregir errores
- Actualizar la documentación y el estado
- Repetir
Ese ciclo es importante porque le proporciona al agente:
- Retroalimentación real (errores, diferencias de código, registros)
- Estado almacenado externamente (repositorio, archivos, documentación, worktrees, resultados)
- La posibilidad de recibir orientación a lo largo del tiempo (puedes corregir el rumbo según los resultados)
Esto también explica por qué los modelos de Codex se sienten mejores en las interfaces de Codex que en una ventana de chat genérica: el arnés de ejecución proporciona contexto estructurado (metadatos del repositorio, árbol de archivos, diferencias de código, salidas de comandos) y exige una rutina disciplinada con criterios para dar el trabajo por terminado.
Recientemente publicamos un artículo sobre el ciclo del agente de Codex que ofrece más detalles.
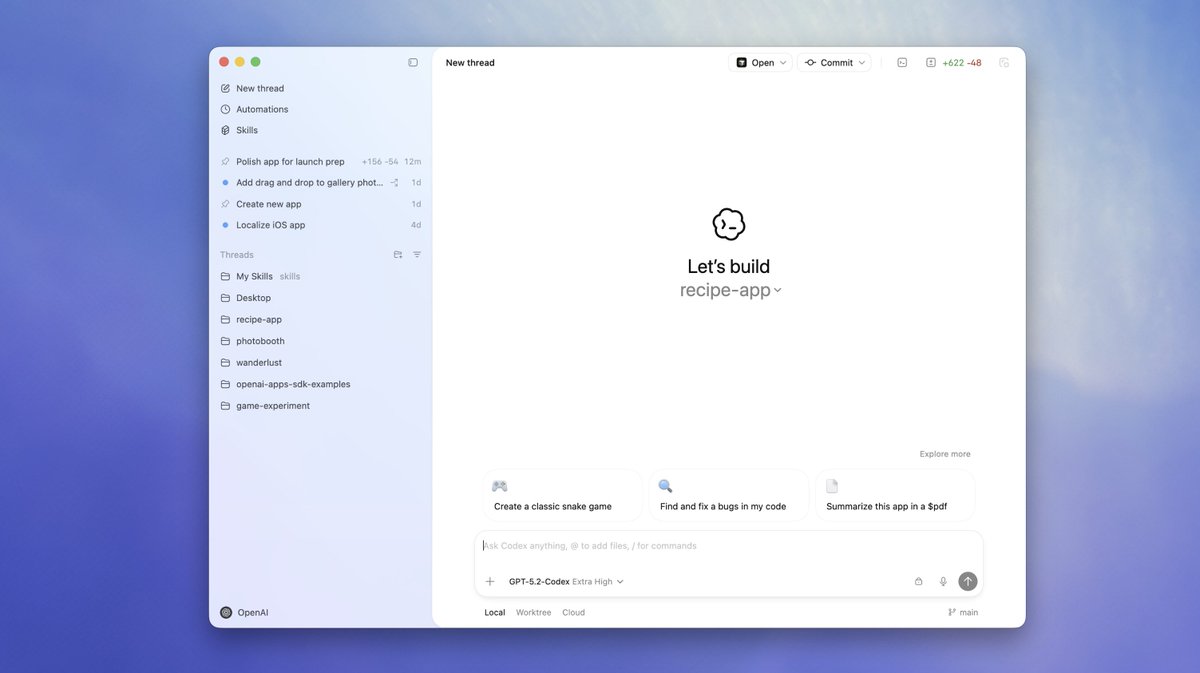
Para complementar todo esto, también lanzamos Codex App, que permite usar ese ciclo en el día a día:
- Hilos en paralelo en distintos proyectos (el trabajo de larga duración no bloquea tus tareas cotidianas)
- Habilidades (estandarizan la planificación, la implementación, las pruebas y los informes)
- Automatizaciones (trabajo rutinario en segundo plano)
- Worktrees de Git (aíslan las ejecuciones, facilitan la revisión de las diferencias de código y reducen los cambios innecesarios)
Mi configuración para la prueba
Elegí una herramienta de diseño para este “experimento” porque es una prueba que no perdona errores: interfaz de usuario + modelo de datos + operaciones de edición + muchos casos límite. No basta con aparentar que funciona. Si la arquitectura está mal, falla rápidamente.
Le di a GPT-5.3-Codex una especificación detallada y lo ejecuté en el nivel de razonamiento “Muy alta”. Terminó trabajando sin interrupciones durante unas 25 horas, mantuvo la coherencia y entregó código de calidad. El modelo también ejecutó pasos de verificación (pruebas, lint, comprobación de tipos) por cada hito que completó.
La idea clave: memoria persistente del proyecto
La técnica más importante fue la memoria persistente del proyecto. Escribí la especificación, el plan, las restricciones y el estado en archivos Markdown que Codex podía consultar una y otra vez. Eso evitó que se desviara y mantuvo una definición estable de lo que significaba “terminado”.
El enlace al repositorio está más abajo, y el conjunto de archivos era el siguiente:
Prompt.md (especificación + entregables)
Propósito: fijar el objetivo para que el agente no “construya algo impresionante pero equivocado”.
Secciones clave del archivo:
- Objetivos + lo que queda fuera del alcance
- Restricciones estrictas (rendimiento, determinismo, UX, plataforma)
- Entregables (lo que debe existir al terminar)
- “Terminado cuando” (verificaciones + recorrido de la demo)
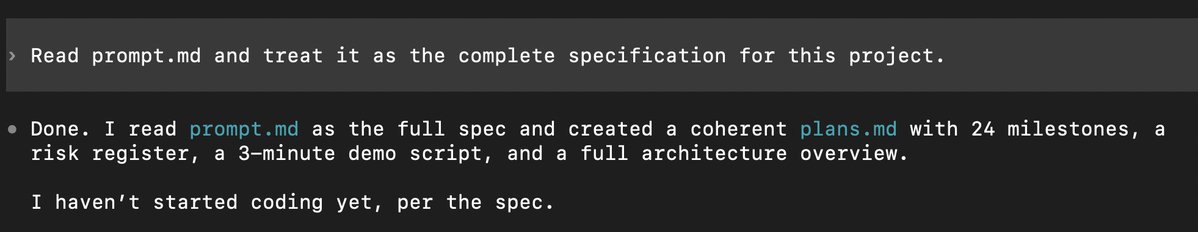
El prompt inicial le indicaba a Codex que tratara el archivo del prompt y la especificación como la especificación completa del proyecto y generara un plan basado en hitos:
Plan.md (hitos + validaciones)
Propósito: convertir el trabajo sin una estructura definida en una secuencia de puntos de control que el agente pueda completar y verificar.
Secciones clave del archivo:
- Hitos lo suficientemente pequeños para completarse en un solo ciclo
- Criterios de aceptación + comandos de validación por hito
- Regla de detenerse y corregir: si la validación falla, corrige el problema antes de continuar
- Notas sobre las decisiones para evitar cambios de rumbo repetidos
- Arquitectura prevista para la base de código
Ten en cuenta que recientemente agregamos un modo plan nativo a Codex App, la CLI y la extensión para IDE. Este modo ayuda a dividir una tarea grande en una secuencia clara de pasos que puedes revisar antes de hacer cambios, para acordar el enfoque desde el principio. Si hace falta aclarar algo más, Codex hará preguntas de seguimiento. Para activarlo, usa el comando slash /plan.
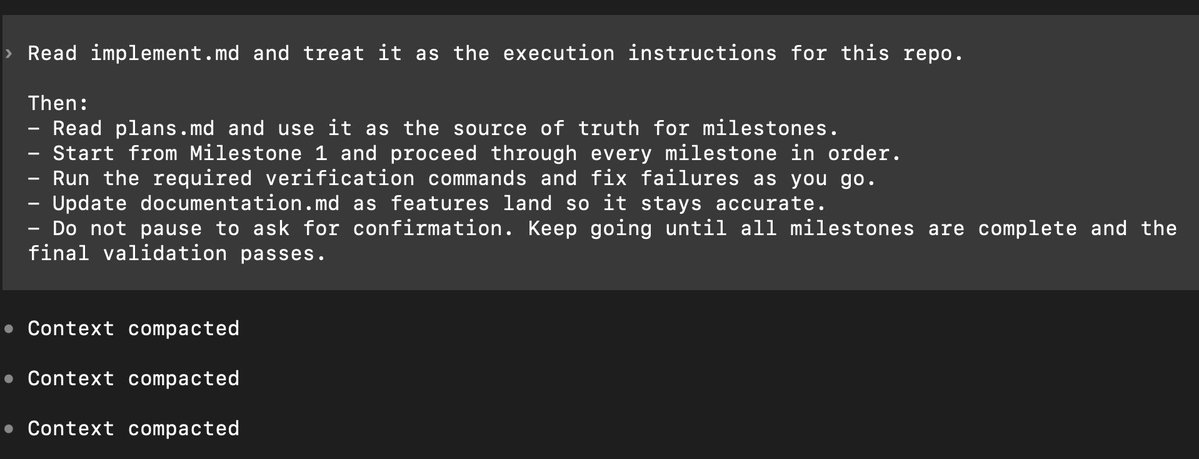
Implement.md (instrucciones de ejecución que hacen referencia al plan)
Propósito: este es el manual de ejecución. Le indica a Codex exactamente cómo proceder: seguir el plan, mantener los cambios dentro del alcance definido, ejecutar validaciones y actualizar la documentación.
Secciones clave del archivo:
- El archivo Markdown de planes es la fuente de referencia (hito por hito)
- Ejecuta la validación después de cada hito (corrige las fallas de inmediato)
- Mantén los cambios dentro del alcance definido (no amplíes el alcance)
- Actualiza continuamente el archivo Markdown de documentación
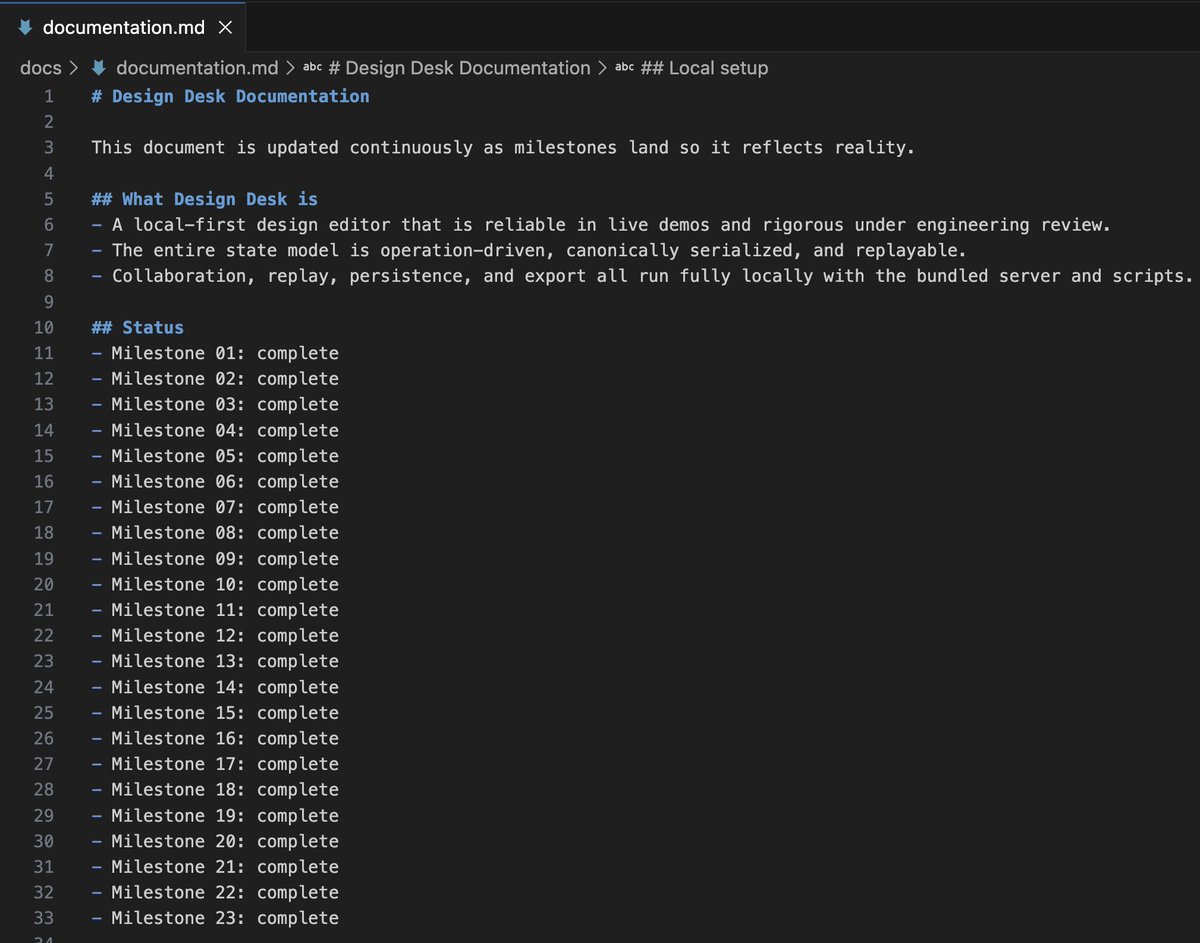
Documentation.md (estado + decisiones a medida que se entregaban los avances)
Propósito: este archivo sirve como memoria compartida y registro de auditoría. Me permite ausentarme durante horas y aun así entender qué pasó.
Secciones clave del archivo:
- Estado actual de los hitos (qué se completó y qué sigue)
- Decisiones tomadas (y sus motivos)
- Cómo ejecutar y hacer una demostración (comandos + pruebas básicas rápidas)
- Problemas conocidos / tareas de seguimiento
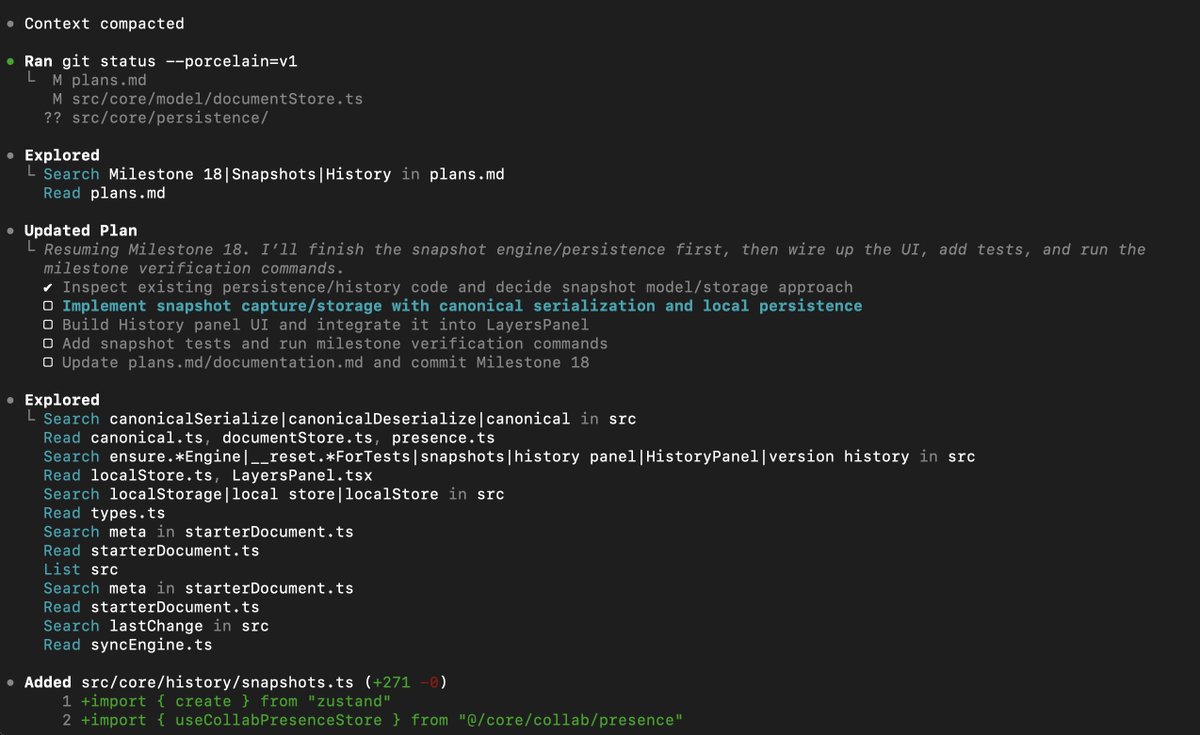
Así se veía en la práctica la verificación de hitos durante la ejecución:
Verificación en cada hito
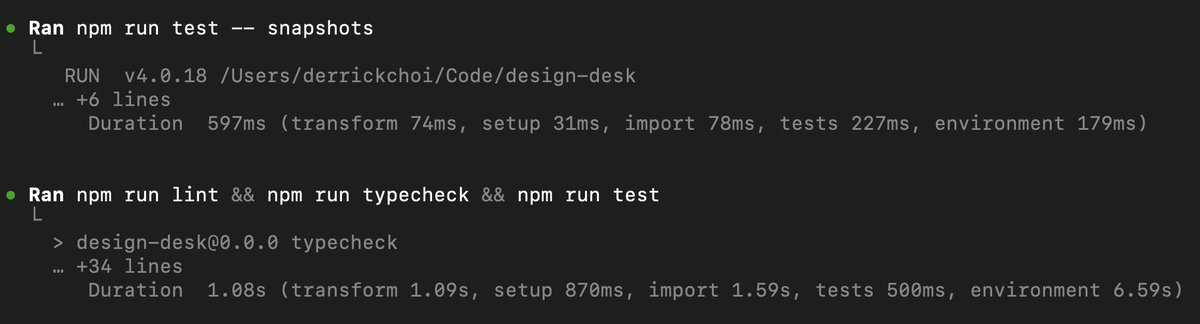
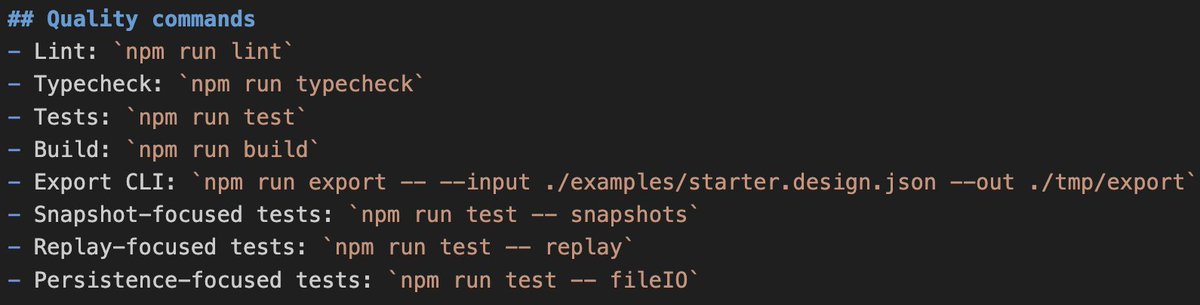
Codex no se limitó a escribir código y esperar que funcionara. Después de cada hito, ejecutó comandos de verificación y corrigió las fallas antes de continuar.
Estos son algunos ejemplos de los comandos de verificación de calidad que se le indicó usar:
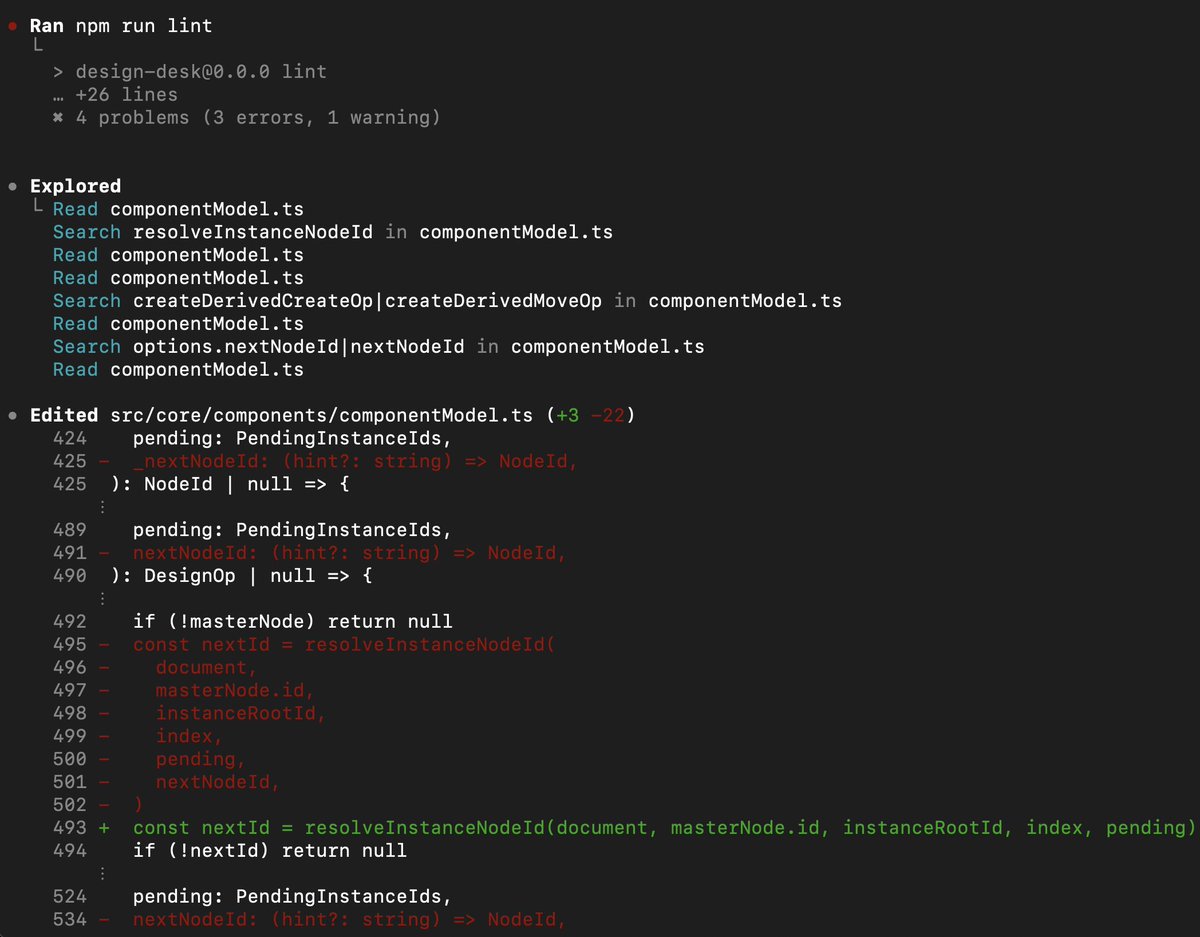
Y un ejemplo de cómo Codex corrigió problemas tras una falla de lint:
Lo que construyó el agente
El resultado no era perfecto ni estaba listo para producción, pero era real y se podía probar. El criterio para esta ejecución no era “compila”, sino “¿sigue las instrucciones y funciona de verdad?”.
Resumen de las capacidades implementadas:
- Edición en canvas (marcos, grupos, formas, texto, imágenes/íconos, botones, gráficos)
- Colaboración en tiempo real (presencia, cursores, selecciones y ediciones sincronizados entre pestañas)
- Controles del inspector (geometría, estilos, texto)
- Gestión de capas (buscar, renombrar, bloquear/ocultar, reordenar)
- Guías/alineación/ajuste automático
- Instantáneas del historial + restauración
- Línea de tiempo de reproducción + creación de una rama desde un punto anterior
- Modo prototipo (zonas interactivas + navegación por el flujo)
- Comentarios (hilos fijados que se pueden resolver y reabrir)
- Exportación (guardar/importar/exportar + exportación por CLI a JSON y React + Tailwind)
Lecciones para las tareas de larga duración con Codex
Lo que hizo que esta ejecución funcionara no fue un único prompt ingenioso. Fue la combinación de:
- Un objetivo y restricciones claros (archivo de especificaciones)
- Hitos con puntos de control y criterios de aceptación (
plans.md) - Un manual de ejecución que indica cómo debe proceder el agente (
implement.md) - Verificación continua (pruebas/lint/verificación de tipos/compilación)
- Un registro de estado y auditoría actualizado (
documentation.md) que permitía inspeccionar la ejecución en todo momento
Hacia ahí avanza el trabajo de programación de larga duración: menos supervisión constante y más delegación con medidas de protección.
Prueba Codex con tu propia tarea de larga duración
Esta ejecución de Codex de 25 horas anticipa hacia dónde va el desarrollo con código. Estamos pasando de los prompts de una sola interacción y los ciclos de programación en pareja con intervención constante a compañeros de equipo que pueden trabajar durante períodos prolongados y encargarse de una parte real del trabajo de principio a fin. Tú orientas el trabajo en cada hito en lugar de supervisar cada línea al detalle.
Nuestro rumbo con Codex es sencillo: que actúe cada vez mejor como compañero de equipo, se integre más estrechamente con tu contexto real y cuente con medidas de protección que mantengan el trabajo confiable, fácil de revisar y de entregar. Ya vemos que los desarrolladores avanzan más rápido cuando el agente se encarga de la implementación y la verificación rutinarias, lo que permite a las personas concentrarse en lo más importante: el diseño, la arquitectura, las decisiones de producto y los problemas nuevos para los que no hay una plantilla.
Y esto no se limitará a los desarrolladores. A medida que Codex mejore aún más su capacidad para entender la intención y ofrecer una estructura de apoyo segura (planes, validaciones, vistas previas, reversiones), más personas que no se dedican al desarrollo podrán crear e iterar sin pasar todo el día en un IDE. Habrá más novedades en las interfaces y los modelos de Codex, pero el objetivo sigue siendo el mismo: que el agente se sienta menos como una herramienta que requiere supervisión constante y más como un compañero de equipo en quien puedes confiar para trabajos de larga duración.
Si quieres probarlo por tu cuenta, empieza por: