選擇你使用的 API,瞭解用量的計算方式,以及管理語音應用程式成本的方法。
GPT-Live 用量與成本
GPT-Live 將語音對話與負責推理及執行工具的後端分開。請分別估算這兩部分的成本:語音工作階段依持續時間計費,後端成本則取決於你使用的模型和工具。
語音工作階段成本
GPT-Live 語音工作階段以目前的模型費率按秒計費。工作階段的持續時間不會無條件進位至整分鐘。
工作階段的使用時間包含使用者說話、助理說話、雙方都未說話,以及後端執行工作的時間。
估算時,請計入工作階段從開始到關閉的完整使用時間。請採用 API 回報的持續時間,而非只計算播放音訊的時間。將麥克風輸入靜音並不會關閉工作階段。對話結束時,請關閉工作階段並收集最終用量。
後端模型和工具的價格請參閱 API 定價。
WebRTC 初始化費用
透過 POST /v1/live/sessions 請求建立 WebRTC 工作階段時,會在初始化期間收取 15 秒的語音費用。工作階段開始執行後,這筆金額會抵扣按持續時間計算的費用。估算成本時,請勿在執行中工作階段的持續時間上再加計 15 秒。
例如,下方的 90 秒工作階段已包含初始化時收費的 15 秒,並不會以 105 秒計費。評估重新連線,或在使用者準備好說話前就建立工作階段的應用程式時,請將建立工作階段的費用納入考量。
後端成本
後端呼叫與語音工作階段分開計費,計費方式與不含語音功能的應用程式相同。請計入模型的輸入與輸出 Token、支援時的快取輸入,以及任何適用的圖像或工具費用。如果應用程式還會呼叫其他服務,也請將其成本納入估算。
你可以針對後端工作進行最佳化,與語音前端分開處理。請參考一般性的 成本最佳化指南,減少請求次數 與 Token 用量。對於符合條件的後端模型,可使用提示詞快取: 將可重複使用的指令、工具定義及其他 穩定不變的內容放在提示詞開頭。
後端的選擇也可能改變對話長度。若某項最佳化讓使用者等待更久,或改變助理完成任務的可靠性,請比較語音與後端合計的成本。
估算對話成本
對於只包含一個語音工作階段的對話:
總成本 =(計費語音秒數 ÷ 60 × 每分鐘語音費率)+ 後端成本
例如,假設語音費率為每分鐘 $0.05,90 秒語音工作階段的成本就是 $0.075。若後端模型和工具的成本合計為 $0.02,則整段對話的成本為 $0.095:
| 項目 | 計算方式 | 成本 |
|---|---|---|
| 語音工作階段 | 90 秒 ÷ 60 × $0.05 | $0.075 |
| 後端工作 | 模型與工具成本合計 | $0.02 |
| 對話總計 | $0.075 + $0.02 | $0.095 |
上述費率與後端成本僅為範例;請採用目前的語音費率、實際測得的後端用量,以及適用的模型和工具費率。如果任務橫跨多個語音工作階段,請加總各工作階段的持續時間,並計入工作階段之間執行的後端工作。
最佳化策略
重點是減少不必要的對話與等待,協助使用者完成任務。同時,請保留任務所需的確認與檢查。
在工作階段開始前提供相關上下文
在開始語音工作階段之前,先收集應用程式已有權限使用的資訊。例如,協助處理訂單的助理可以在開始時就取得訂單編號和目前狀態,讓使用者不必重複提供資訊,也不必等待另一次查詢。
請確保這些上下文保持最新,並聚焦於任務。提供語音模型 對話所需的資訊;詳細紀錄與工作流程則 保留在後端。請參閱工作階段組態 與委派與工具。
縮短等待工具的時間
縮短等待時間可以改善使用者體驗,並降低語音工作階段的成本。
例如,假設你的後端使用 gpt-5.6-luna 搭配
快速模式,並平行執行
彼此獨立的工具呼叫。如果這些最佳化能讓使用者提前一分鐘完成任務
並關閉語音工作階段,就能節省 $0.05 的語音費用。
只要增加的後端成本低於節省的金額,總成本就會下降。
你也可以在委派事件到達前,根據轉錄片段啟動推測性查詢。 計算後端成本時,也請納入 未被採用的推測性工作。
模型、連線、串流和工具的最佳化方式,請參閱降低後端延遲。 使用語音智慧體評估,驗證產生實用語音回覆 所需的時間,以及任務是否成功完成。
執行耗時任務時關閉工作階段
語音前端與應用程式管理的後端可以各自獨立執行。 使用用戶端委派時,無論語音工作階段開啟或關閉, 後端工作程序都能持續執行。請在 關閉語音工作階段之前,儲存任務狀態與對話上下文。
對於常駐型智慧體,當後端處理 長時間執行的任務時,例如在目標模式下編寫程式碼,請關閉語音工作階段。提供標示為 繼續對話 的按鈕,讓使用者返回時開始新的語音工作階段;或透過後端 完成事件啟動新的工作階段,並通知使用者 結果已準備就緒。
啟動新的工作階段,並在 input 中加入已儲存的上下文與
經過驗證的任務結果,即可恢復對話。例如,透過
新的 WebSocket 連線傳送以下啟動事件:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}請等到收到 session.started 後再串流傳送音訊。請參閱
以先前對話初始化工作階段,
瞭解支援的歷史紀錄格式。
如果先前的工作階段是以 store: true 儲存的,你也可以為該工作階段建立分支。無論採用哪種方式,都請在應用程式中保留已驗證的後端任務狀態。
關閉工作階段,每分鐘可節省 $0.05 的語音閒置費用;請將這筆節省的金額與重新連線的成本,以及中斷對使用者體驗的影響一起權衡。
選擇合適的後端模型
先挑選符合任務準確度與可靠性要求的模型。 接著比較整段對話的總成本,包括語音持續時間、模型用量、 工具呼叫及重試。模型選擇指南 說明了如何權衡這些因素。
如果較大的後端模型能更快完成任務,而且節省的語音工作階段費用超過增加的 Token 成本,整體成本就可能更低。較便宜的模型若耗時更久、重複呼叫工具,或未能完成任務,整體成本反而可能更高。
請一併比較每次成功完成任務的成本、完成率,以及完成所需的時間。將失敗的嘗試與重試納入總成本,避免較便宜的組態僅因完成的工作較少,就看起來更划算。規劃比較方式時,請參考語音智慧體評估 Cookbook。
監控實際用量
針對每個工作階段,分別記錄語音持續時間與後端用量。GPT-Live 會以秒為單位回報累計的語音持續時間:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}每次更新都會取代前一次的持續時間快照。請勿將這些快照相加。
傳送 session.close 後,請持續接收事件,直到收到 session.closed,並
將其中最終的 usage.seconds 記錄一次。請遵循
正常關閉程序,
讓應用程式能在中斷連線前收集最終用量。
使用 Responses 委派時,請從透過 response.event 傳遞的巢狀
response.completed 事件中,讀取後端回應的 usage。請根據回應 ID,
確保每個後端回應只計算一次,並保留輸入、輸出與
快取 Token 的詳細資料,以套用該模型的費率。對於
應用程式獨立執行的後端工作,也請收集其請求的用量。
選取具代表性的對話,比較估算與實際的總成本。請將僅供評估的模型呼叫與應用程式用量分開計算,並一併檢視成本與任務成功情況。
Realtime API 成本
本文說明 Realtime API 的計費方式,並提供成本最佳化策略。語音智慧體工作階段會累計文字、音訊和圖像等模態的輸入與輸出 Token。串流翻譯和串流轉錄工作階段則依音訊時長計費。價格因模型而異,各模型頁面均列有價格,例如 gpt-realtime-2、gpt-realtime-translate、gpt-realtime-whisper 和 gpt-realtime。
對話式 Realtime API 工作階段由一連串 回合組成,使用者加入的輸入會觸發 Response ,產生模型輸出。伺服器會維護一個 Conversation,其中包含一份 Items 清單,構成下一回合的輸入。Response 傳回時,其輸出會自動加入 Conversation。
翻譯和轉錄工作階段採用不同的串流架構。用戶端持續串流傳送音訊,並隨著來源音訊抵達,接收翻譯後的音訊、轉錄文字增量或轉錄事件。這些工作階段不使用一般的 Response 生命週期,因此請依據其按時長計費的費率估算和監控成本,而非使用每個 Response 的 Token 用量。
每個 Response 的成本
Realtime API 在建立 Response 時產生費用,並依輸入與輸出 Token 數量計費(輸入轉錄費用除外,詳見下文)。目前不收取網路頻寬或連線費用。Response 可以手動建立,也可以在啟用語音活動偵測(VAD)後自動建立。VAD 會有效濾除無聲的輸入音訊,因此除非用戶端手動將其加入對話輸入,否則無聲音訊不會計入輸入 Token。
每個 Response 都會將整段對話傳送給模型。一個回合的輸出會以 Items 的形式加入伺服器上的 Conversation,成為後續回合的輸入,因此工作階段中越後面的回合,費用就越高。
你可以使用我們的 Token 化處理工具估算文字 Token 費用。使用者訊息中的音訊每 100 毫秒計為 1 個 Token,助理訊息中的音訊則每 50 毫秒計為 1 個 Token。請注意,Token 數量除了訊息內容外,也包含特殊 Token,因此實際數量會略有差異。例如,內容包含 10 個文字 Token 的使用者訊息,可能會計為 12 個 Token。
範例
以下用一個簡單範例,說明多回合 Realtime API 工作階段的 Token 費用。
在對話的第一回合,我們加入了 100 個 Token 的指示,以及一則包含 20 個音訊 Token 的使用者訊息(例如由 VAD 根據使用者的發言加入),共計 120 個輸入 Token。建立 Response 後,會產生一則助理輸出訊息(20 個音訊 Token、10 個文字 Token)。
接著,我們再加入一則使用者音訊訊息,建立第二回合。第二回合的 Token 數量會是多少?此時的 Conversation 包含初始指示、第一則使用者訊息、第一回合的助理輸出訊息,以及第二則使用者訊息(25 個音訊 Token)。這一回合的輸入包含 110 個文字 Token 和 64 個音訊 Token,另外還有新一則助理輸出訊息的輸出 Token。
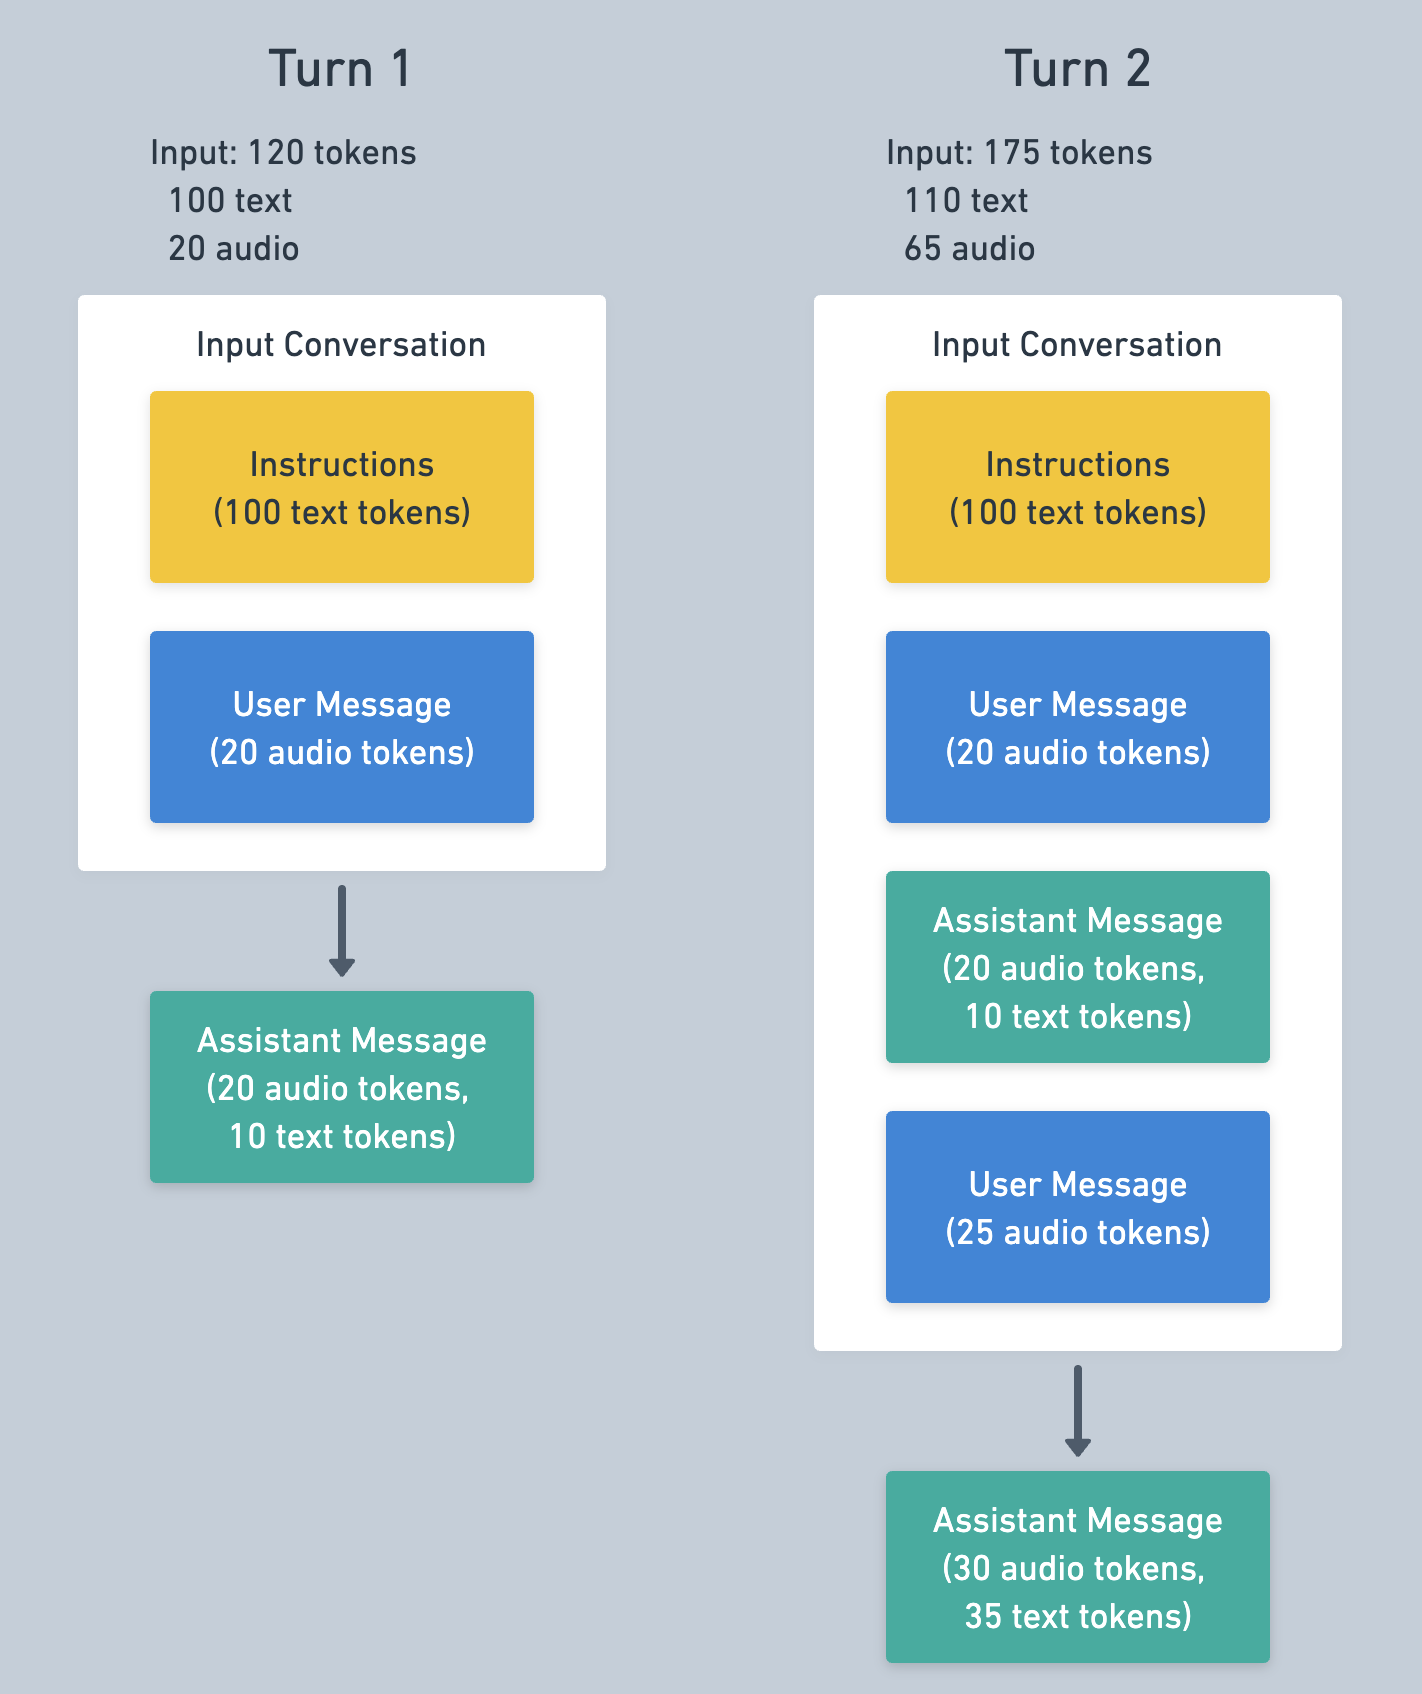
第一回合的訊息很可能在第二回合命中快取,從而降低輸入費用。如需快取的詳細資訊,請參閱下文。
你可以從 response.done 事件讀取 Response 使用的 Token 數量,如下所示。
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}輸入轉錄費用
除了對話式 Response 的費用外,如果啟用輸入轉錄,Realtime API 也會收取輸入轉錄費用。輸入轉錄使用的模型與語音到語音模型不同,例如 whisper-1 或 gpt-4o-transcribe,因此適用不同的費率表。音訊寫入輸入音訊緩衝區,並由用戶端手動或透過 VAD 提交後,就會進行轉錄。
你可以從 conversation.item.input_audio_transcription.completed 事件讀取輸入轉錄的 Token 數量,如下列範例所示。
{
"type": "conversation.item.input_audio_transcription.completed",
...
"transcript": "Hi, can you hear me?",
"usage": {
"type": "tokens",
"total_tokens": 26,
"input_tokens": 17,
"input_token_details": {
"text_tokens": 0,
"audio_tokens": 17
},
"output_tokens": 9
}
}快取
Realtime API 支援提示詞快取,此功能會自動套用,可大幅降低多回合工作階段中的輸入 Token 費用。當某個 Response 的輸入 Token 與先前 Response 的 Token 相符時,系統會盡可能使用快取,但不保證一定命中。
要盡可能提高快取命中率,最佳策略是保持工作階段的歷史紀錄不變。移除或變更對話內容會在變更位置使快取失效,導致輸入中可匹配的部分減少。請注意,指示和工具定義位於對話開頭,因此在工作階段中途變更這些內容,會降低後續回合的快取命中率。
截斷
當對話中的 Token 數量超過模型的輸入 Token 上限時,對話就會被截斷,也就是從最舊的訊息開始,將訊息從 Response 的輸入中移除。上下文容量為 32k、輸出 Token 上限為 4,096 的模型,上下文最多只能包含 28,224 個 Token,超過就會觸發截斷。
用戶端可以設定低於模型上限的 Token 視窗,藉此有效控制 Token 用量與成本。如果你依照下方範例,將截斷類型設為 retention_ratio,就可以透過 token_limits.post_instructions 組態控制此視窗。顧名思義,這項設定控制的是 Response 的輸入 Token 上限,但不包含指示的 Token。將 post_instructions 設為 1,000,表示超出 1,000 個輸入 Token 上限的項目,不會傳送給模型來產生 Response。
截斷會在接近對話開頭的位置使快取失效,如果每一回合都發生截斷,快取命中率就會很低。為了緩解這個問題,用戶端可以設定截斷時移除比必要數量更多的訊息,預留更多空間,延後下一次截斷。這可以透過 session.truncation.retention_ratio 設定控制。伺服器的預設值為 1.0,表示截斷時只會移除必要的項目。若設為 0.8,截斷後會保留上限的 80%,額外移除 20%。
如果你希望降低特定模型每個 Realtime API 工作階段的成本,我們建議調低 Token 數量上限,並將 retention_ratio 設為小於 1 的值,如下列範例所示。請記住,這可能需要取捨:成本雖然降低,但模型在各回合能記住的內容也可能減少。
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}你也可以完全停用截斷,如下所示。停用後,如果 Conversation 過長而無法建立 Response,系統就會傳回錯誤。如果你打算手動管理 Conversation 的大小,這項設定可能會很實用。
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}其他最佳化策略
使用 mini 模型
Realtime 語音到語音模型提供「一般」規模和 mini 規模,後者的費用低得多。主要的取捨通常在於遵循指示和函式呼叫方面的智慧能力,mini 模型在這些方面的表現較弱。我們建議先使用較大的模型測試應用程式,改善應用程式與提示詞後,再嘗試使用 mini 模型進行最佳化。
編輯 Conversation
雖然伺服器會自動截斷對話,但另一種成本管理策略是手動編輯 Conversation。此 API 的一項設計原則,是讓用戶端完全控制伺服器端的 Conversation,能夠自由新增和移除項目。
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}清除舊訊息能有效減少輸入 Token 數量與成本。這可能會移除重要內容,因此常見的策略是用摘要取代這些舊訊息。你可以使用上文所示的 conversation.item.delete 訊息,從 Conversation 中刪除項目,也可以使用 conversation.item.create 訊息新增項目。
估算成本
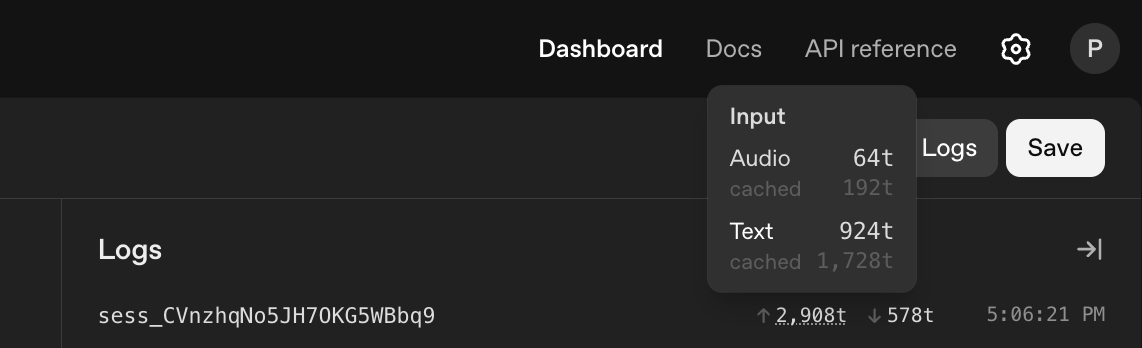
由於 Realtime API 的 Token 用量較為複雜,事先估算成本可能並不容易。一個實用的方法是在 Realtime Playground 中使用預計採用的提示詞與函式,透過範例工作階段測量 Token 用量。你可以在 Realtime Playground 的「紀錄」分頁中,於工作階段 ID 旁查看該工作階段的 Token 用量。