
本指南介紹一組核心原則,協助你降低各種 LLM 相關使用案例的延遲。這些技巧來自我們與各類客戶及開發人員合作打造正式環境應用程式的經驗,因此無論你正在建置的是細部工作流程,還是端到端的對話應用程式,都應該適用。
個別技巧雖然很多,本指南將它們歸納為 七項原則 ,從整體層面分類說明降低延遲的方法。
最後,我們會透過一個範例,逐步說明如何運用這些原則。
七項原則
加快 Token 處理速度
處理延遲問題時,你最先想到的可能是推論速度 (但你很快就會看到,需要考量的遠不只這一項)。這指的是 LLM 實際處理 Token 的速率,通常以 TPM(每分鐘 Token 數)或 TPS(每秒 Token 數)衡量。
影響推論速度的主要因素是 模型大小。較小的模型通常執行得更快,成本也更低;運用得當時,表現甚至能超越較大的模型。若要讓較小的模型維持高品質表現,可以嘗試:
你也可以採用推論最佳化功能,例如我們的預測輸出。當你事先知道大部分的輸出內容時,例如在程式碼編輯任務中,預測輸出能大幅降低生成延遲。提供預測內容給模型後,LLM 就能更專注於實際變更,減少在不變內容上花費的時間。
影響推論速度的其他因素包括你可用的
運算資源,以及你採用的其他
推論最佳化方法。
大多數人無法直接影響這些因素,但如果你有興趣,
也能對基礎架構做一些調整,使用更快的硬體或
讓引擎在較低的飽和度下執行,或許能讓
TPM 小幅提升。如果你正在深入處理底層實作,還有許多其他的
推論最佳化方法
,不過這些已超出本指南的範圍。
減少生成的 Token
使用 LLM 時,生成 Token 幾乎總是延遲最高的步驟。根據一般經驗, 將輸出 Token 減少 50%,可能就能將延遲降低約 50%。如何縮減輸出量,取決於輸出類型:
如果你生成的是 自然語言, 要求模型更精簡 (例如「少於 20 個詞」或「簡短回答」)可能會有幫助。你也可以使用少樣本範例、微調,或兩者並用,教模型產生更簡短的回覆。
如果你生成的是 結構化輸出,請盡可能 精簡輸出語法 ,例如縮短函式名稱、省略具名引數、合併參數等。
最後,雖然不常見,你也可以使用 max_tokens 或 stop_tokens 提早結束生成。
請記住:每少輸出一個 Token,就多省下一點時間,哪怕只是幾毫秒!
減少輸入 Token
減少輸入 Token 的確能降低延遲,但通常影響不大:將提示詞縮減 50%,可能只能改善 1–5% 的延遲。除非你處理的上下文非常龐大(例如文件、圖像),否則不妨將心力投入其他地方。
不過,如果你 確實 在處理龐大的上下文(或是你決心榨出最後一點效能, 而且 已經試遍其他方法),可以使用以下技巧減少輸入 Token:
- 微調模型,讓你不再需要提供冗長的指示或範例。
- 篩選輸入的上下文,例如刪減 RAG 結果、清理 HTML 等。
- 盡量擴大共用的提示詞前綴,將動態部分(例如 RAG 結果和歷史紀錄)放在提示詞後段。這能讓請求更有效地利用大多數 LLM 供應商都採用的 KV 快取,減少每次請求需要處理的輸入 Token。
請參閱我們的文件,進一步了解提示詞 快取 的運作方式。
減少請求次數
每次發出請求都會產生一些往返延遲,這些時間會逐漸累積。
如果你需要 LLM 依序執行多個步驟,可以考慮 將這些步驟放進同一個提示詞,並在同一則回覆中取得所有結果,而不是每個步驟都發出一次請求。這樣就能避免額外的往返延遲,也可能降低處理多則回覆的複雜度。
其中一種做法是在合併後的提示詞中,將步驟整理成編號清單,再要求模型將結果放入 JSON 物件的具名欄位中回傳。如此一來,你就能解析及引用各項結果。
平行處理
使用 LLM 執行多個步驟時,平行處理可以發揮很大的效益。
如果這些步驟 不必 嚴格依序執行,你可以 將它們拆成平行呼叫。就像同時晾兩件襯衫,晾乾所需的時間和一件一樣。
不過,即使這些步驟 必須 嚴格依序執行,你仍可能 運用推測執行。對於某個結果比其他結果更可能出現的分類步驟(例如內容審核),這個方法特別有效。
- 同時啟動步驟 1 和步驟 2(例如輸入內容審核與故事生成)
- 驗證步驟 1 的結果
- 如果結果不如預期,取消步驟 2(必要時重試)
如果你猜對了步驟 1 的結果,就等於在沒有增加任何延遲的情況下執行了這個步驟!
讓使用者少等一點
等待 與 看著進度往前推進,感受截然不同。請確保你的使用者體驗到的是後者。以下是幾個技巧:
- 串流:這是最有效的方法,能將 等待 時間縮短至一秒以內。(如果每次都要等到回覆完成才看得到任何內容,ChatGPT 用起來會很不一樣。)
- 分塊處理:如果輸出必須經過進一步處理(例如內容審核、翻譯)才能顯示給使用者,可以考慮 分塊處理 ,而非一次處理全部內容。做法是先將輸出串流傳送至後端,再將處理完成的區塊傳送至前端。
- 顯示執行步驟:如果你的應用程式正在執行多個步驟或使用工具,就讓使用者看見這些活動。能顯示越多實際進度,效果越好。
- 載入狀態:旋轉載入圖示和進度列就能帶來很大的幫助。
請注意, 顯示執行步驟與載入狀態 主要是改善 心理感受;但若將應用程式與使用者視為一個整體, 串流與分塊處理 確實能降低整體延遲,因為使用者能 更早讀完回覆。
別一開始就選用 LLM
語言模型功能強大、用途廣泛,因此有時會被用在其實更適合採用 更快的傳統方法 的情境中。找出這些情境,可能就能大幅降低延遲。請參考以下範例:
- 寫死內容: 如果 輸出 的範圍非常有限,你可能不需要用 LLM 來生成。動作確認、拒絕訊息,以及要求使用者提供標準輸入的提示,都很適合直接寫死在程式中。(你甚至可以沿用老方法,為每種訊息準備幾個不同版本。)
- 預先計算: 如果 輸入 的範圍有限(例如類別選擇),你可以事先生成多則回覆,只要確保不會向同一位使用者重複顯示相同的回覆即可。
- 善用 UI: 彙整後的指標、報告或搜尋結果,有時使用傳統、專門設計的 UI 元件來呈現,會比 LLM 生成的文字更清楚。
- 傳統最佳化技巧: LLM 應用程式終究還是應用程式;二分搜尋、快取、雜湊表,以及時間複雜度等技巧與概念,在語言模型的世界裡 依然 有用。
範例
現在來看看一個範例應用程式,找出可以改善延遲的地方,並提出解決方案!
我們將分析一個假想客服機器人的架構與提示詞,其設計靈感來自正式環境中的實際應用程式。架構與提示詞一節會先介紹背景,接著在分析與最佳化一節逐步說明延遲最佳化的過程。
你會發現這個範例並未涵蓋所有原則,就像實際的使用案例也不需要套用每一種技巧。
架構與提示詞
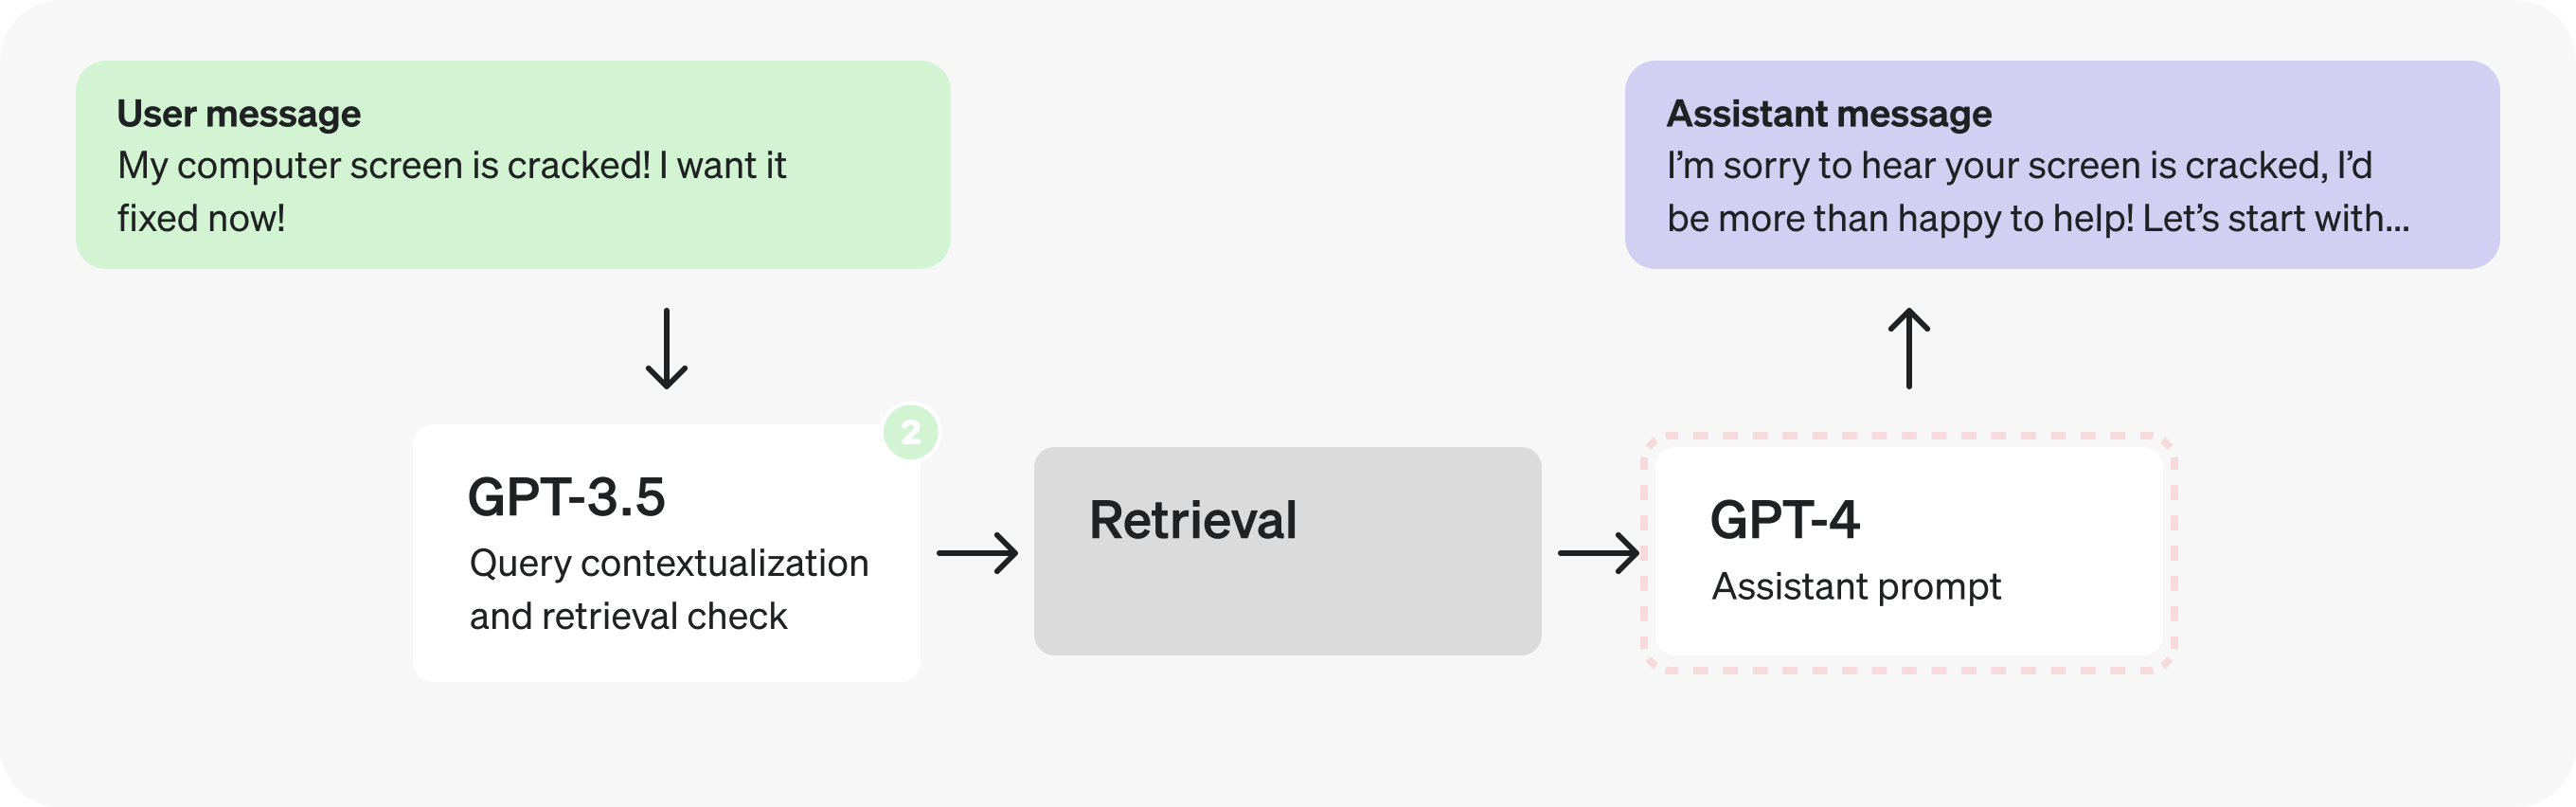
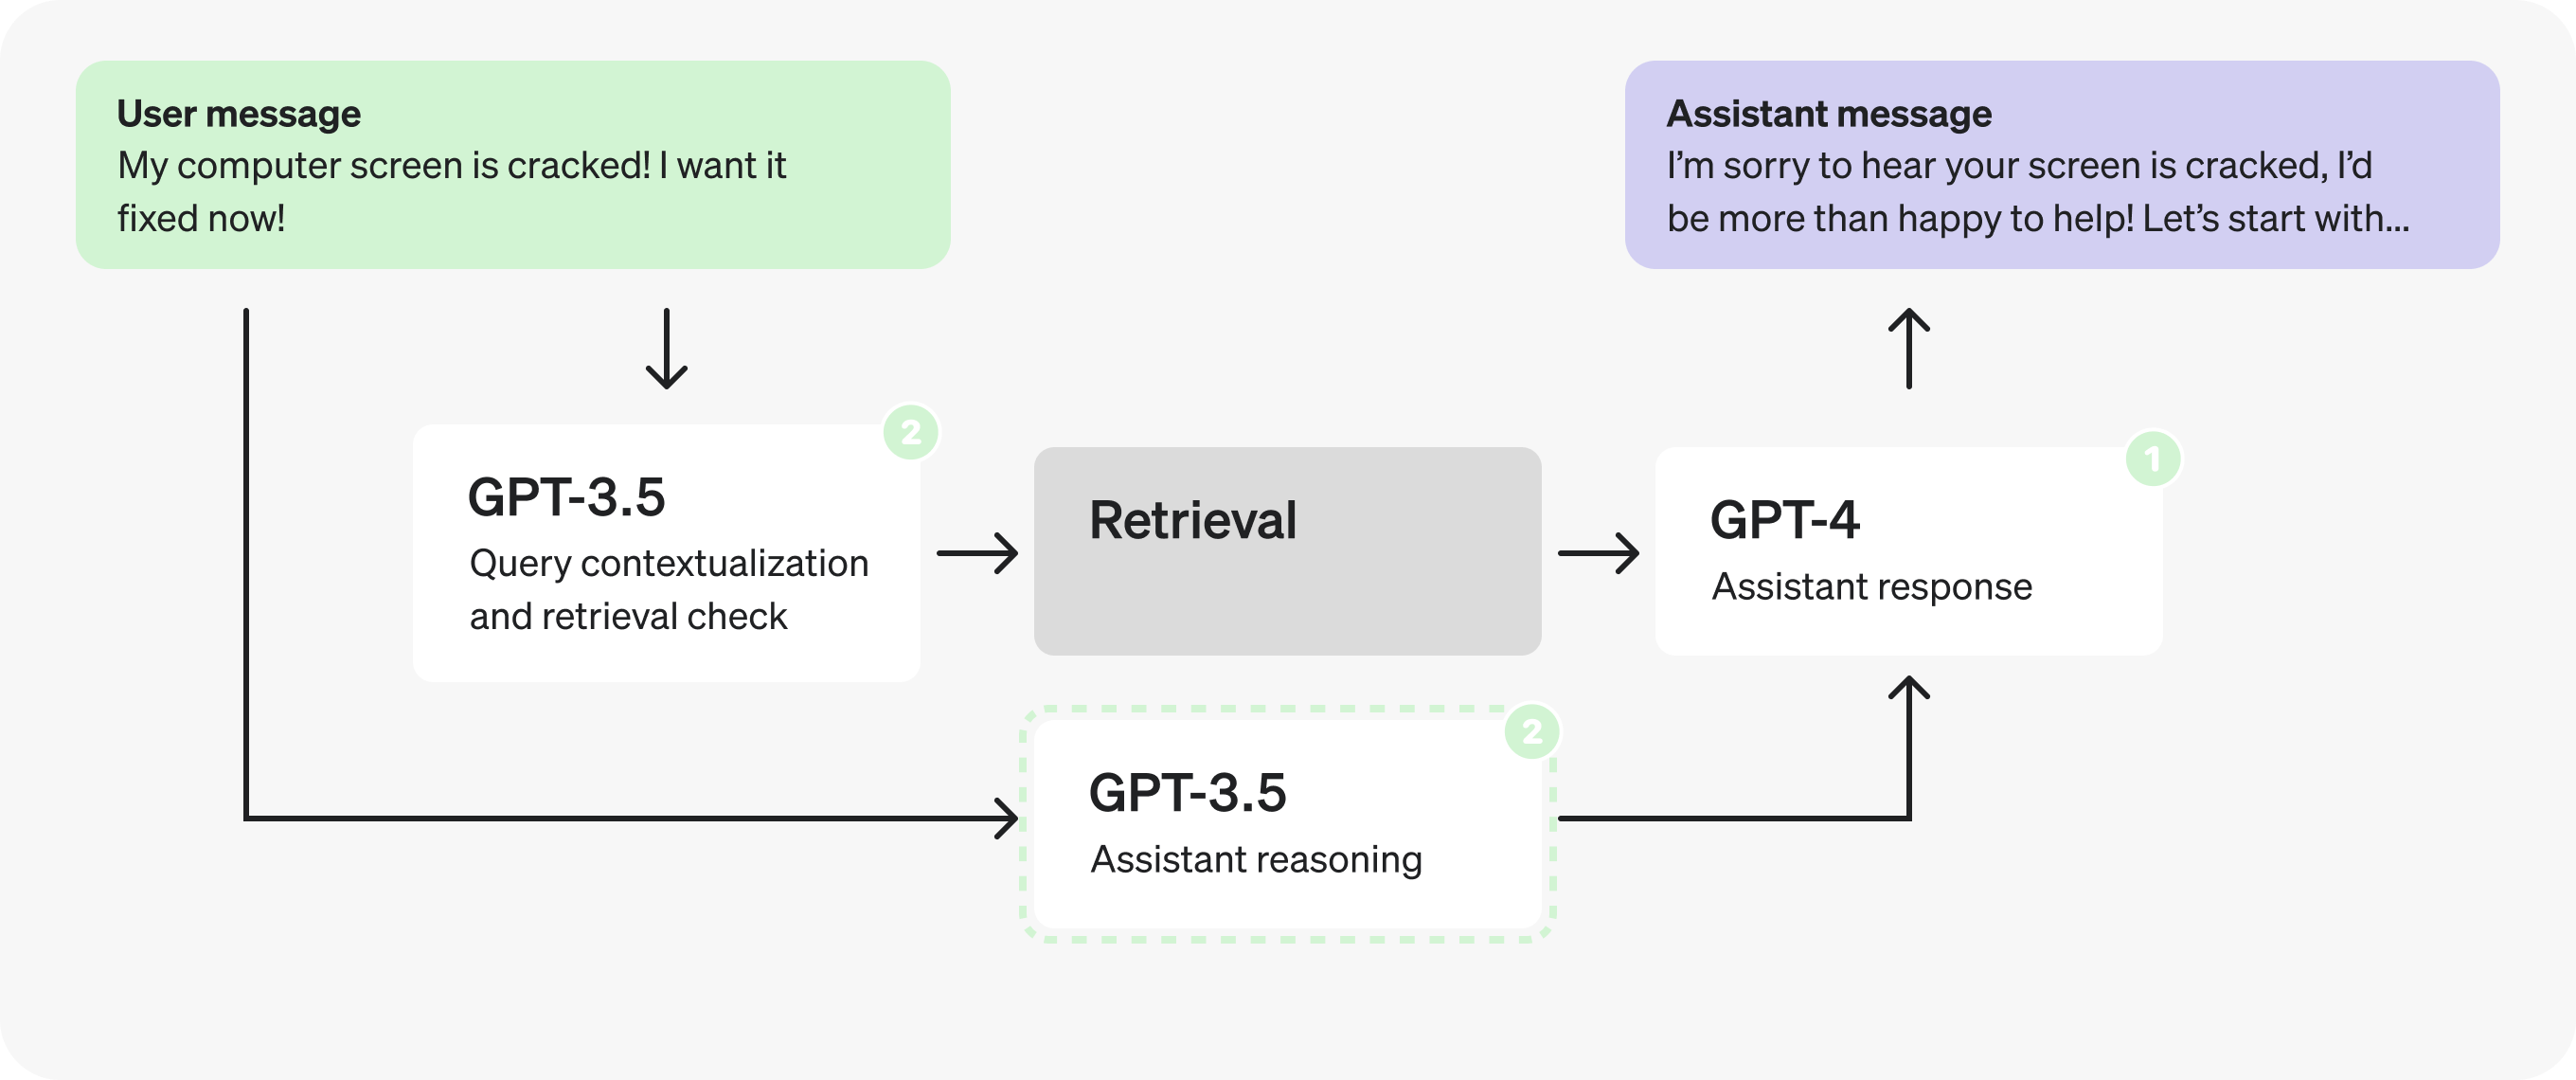
以下是一個假想 客服機器人的 初始架構 。接下來我們會以此為基礎進行調整。
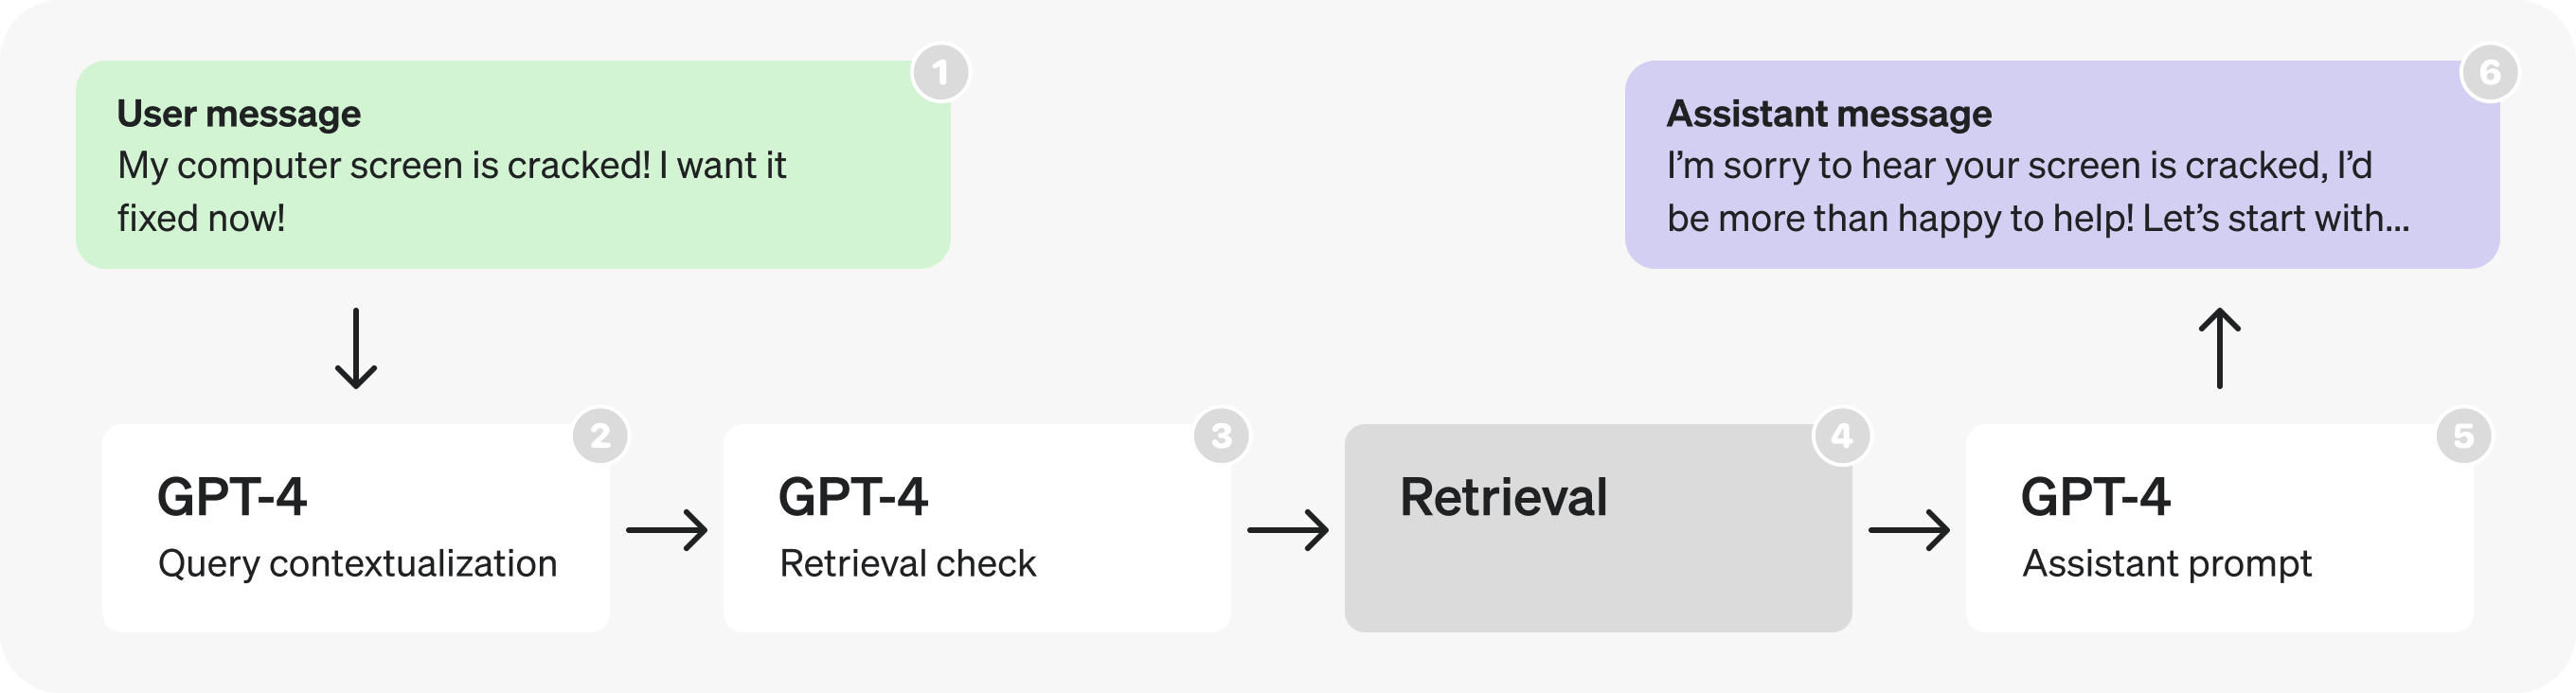
概括來說,圖中呈現的流程如下:
- 使用者在進行中的對話裡傳送一則訊息。
- 將最新一則訊息轉換為 可獨立理解的查詢 (請見提示詞中的範例)。
- 判斷回覆該查詢是否 需要額外資訊(透過檢索取得) 。
- 執行檢索 ,取得搜尋結果。
- 助理根據使用者的查詢與搜尋結果進行 推理 ,並 產生回覆。
- 將回覆傳回給使用者。
以下是圖中各個環節使用的提示詞。雖然這些提示詞是假設且經過簡化的範例,但其結構與措辭都與正式環境中的應用程式相同。
像「[user input here]」這樣的預留位置表示 動態內容,執行時會以實際資料取代。
分析與最佳化
第 1 部分:檢視檢索提示詞
檢視架構時,首先引人注意的是 接連執行的 GPT-4 呼叫 。這表示效率可能有改善空間,通常可以改為單次呼叫或平行呼叫。
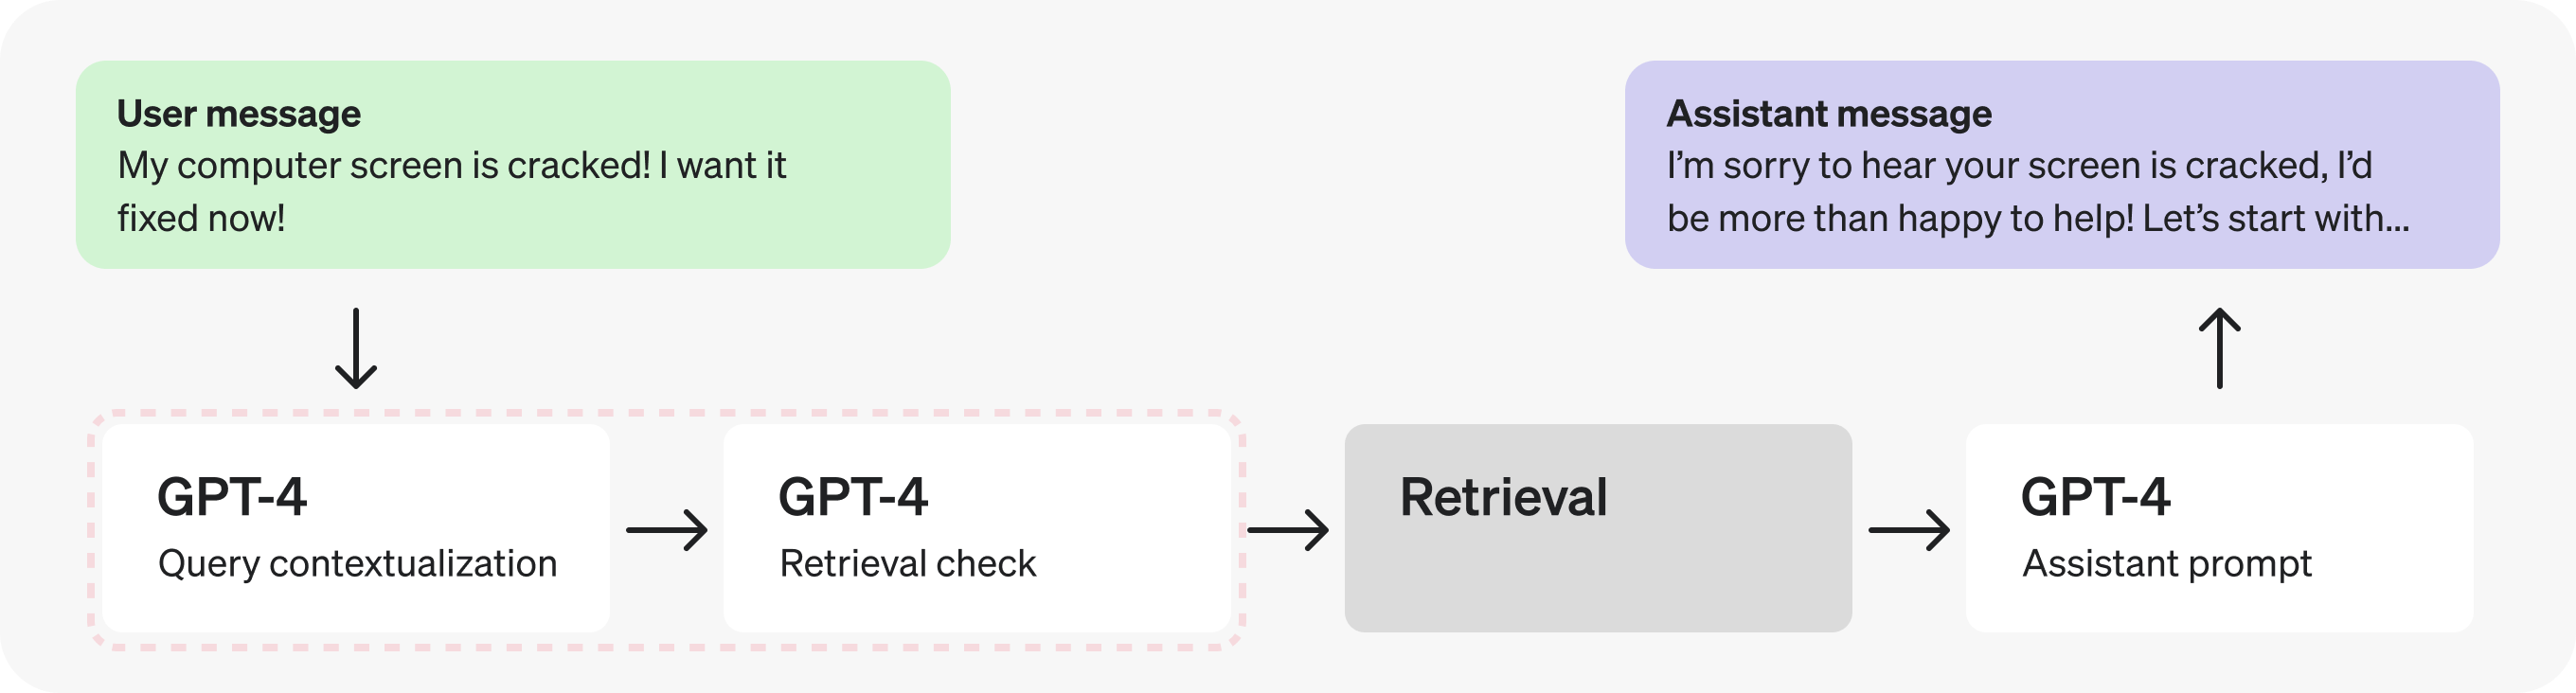
在這個案例中,判斷是否需要檢索時,必須使用已補充上下文的查詢,因此我們將這兩個步驟 合併為單一提示詞 ,以減少請求次數。
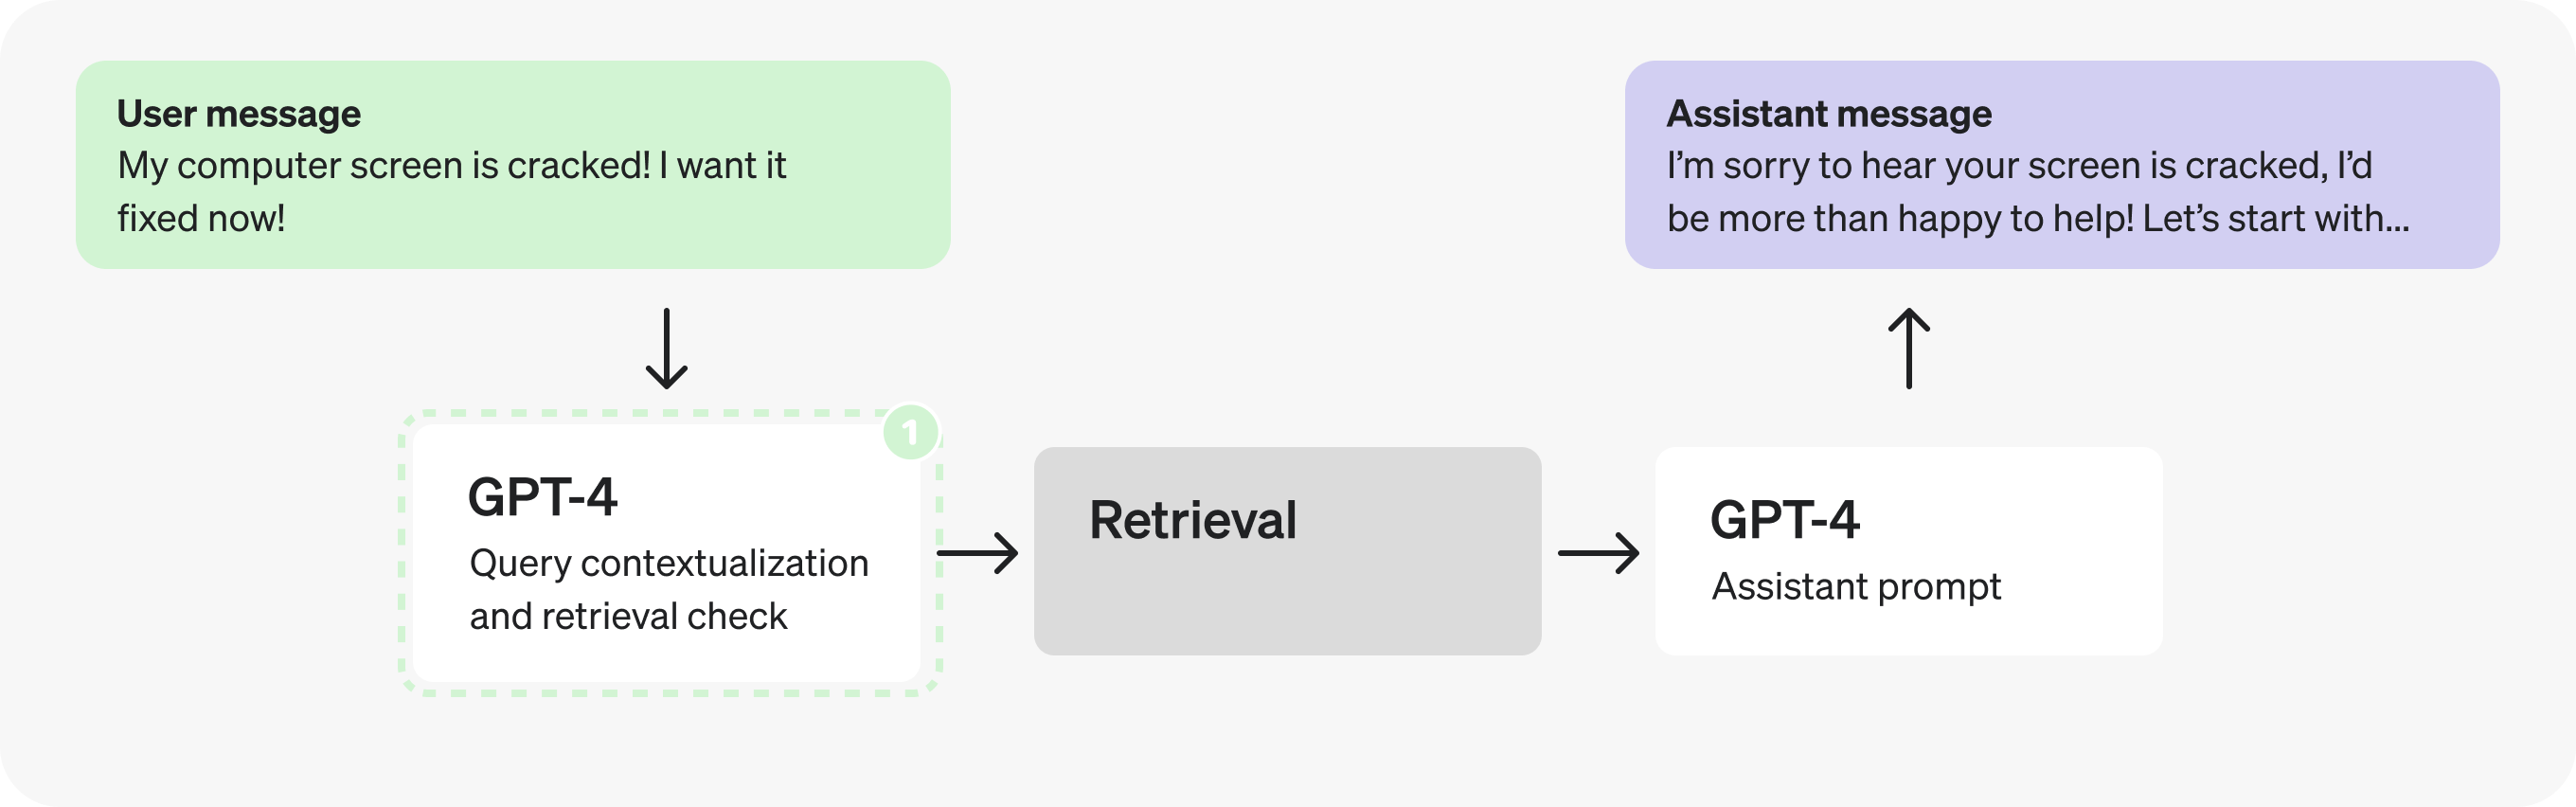
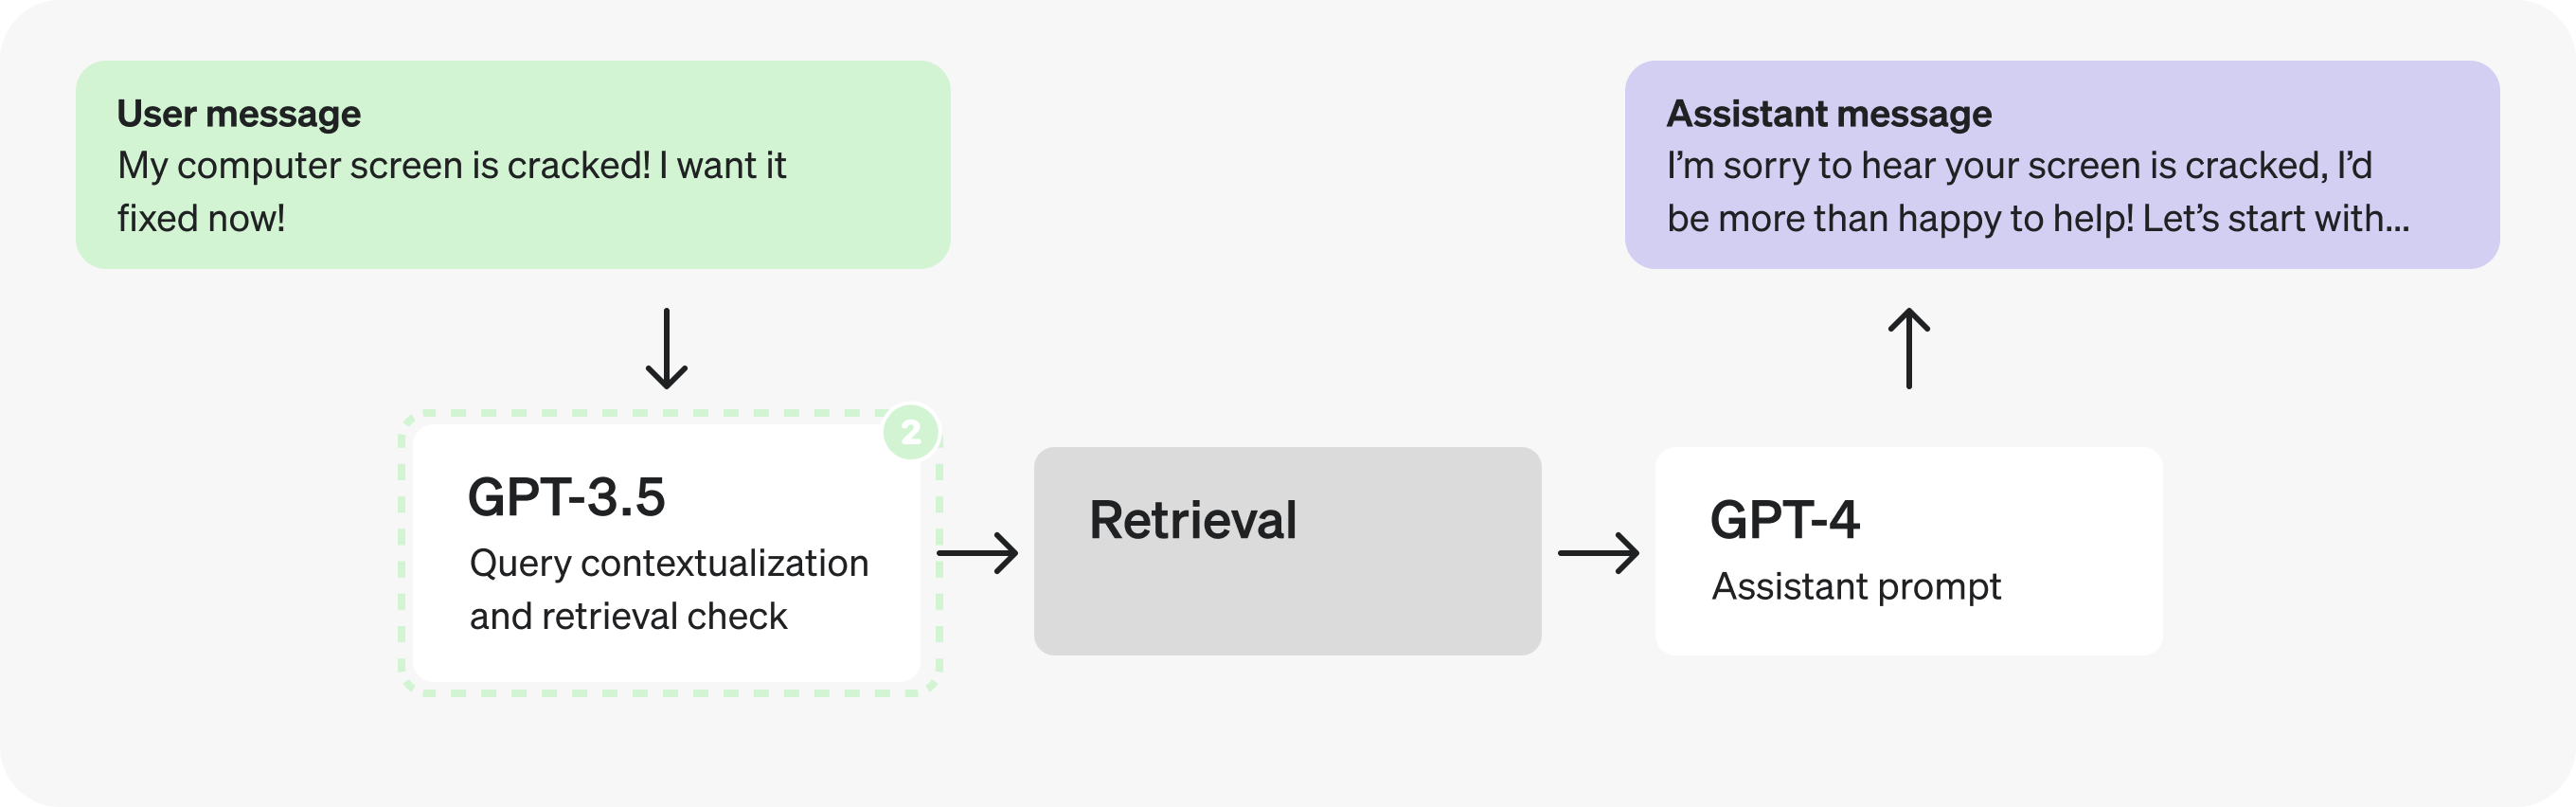
其實,補充上下文和判斷是否需要檢索,都是簡單且定義明確的任務,因此我們很可能可以改用 經過微調的較小模型 。改用 GPT-3.5 能讓我們更快處理 Token。
第 2 部分:分析助理提示詞
現在將焦點轉向助理提示詞。填入 JSON 欄位的過程似乎包含許多不同的步驟,這表示可能有機會採用平行處理。
不過,假設我們執行了一些測試,發現拆開 JSON 中的推理步驟會讓回覆品質變差,因此需要探索其他解決方案。
能否用經過微調的 GPT-3.5 取代 GPT-4? 或許可以,但一般來說,助理的開放式回覆最好還是交給 GPT-4,因為它能更妥善地處理更多不同情況。不過,若單看各個推理步驟,未必每一步都需要 GPT-4 等級的推理能力才能完成。這些步驟的範圍明確且有限,因此 很適合考慮透過微調來處理。
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
}這就帶來了取捨。我們應該維持 單一請求,全部由 GPT-4 生成,還是 拆成兩個依序執行的請求 ,除了最終回覆外,其餘都使用 GPT-3.5?這裡遇到了原則互相衝突的情況:第一種做法能減少請求次數,第二種則可能讓我們更快處理 Token。
如同許多最佳化取捨,答案取決於具體情況。例如:
response與其他欄位的 Token 數量比例。- 加快大多數欄位的處理速度,平均能減少多少延遲。
- 將一次請求改為兩次請求,平均會 增加 多少延遲。
結論會因情況而異,最好的判斷方式是使用正式環境中的範例進行測試。在這個案例中,假設測試結果顯示,將提示詞一分為二以更快處理 Token,整體效果較好。
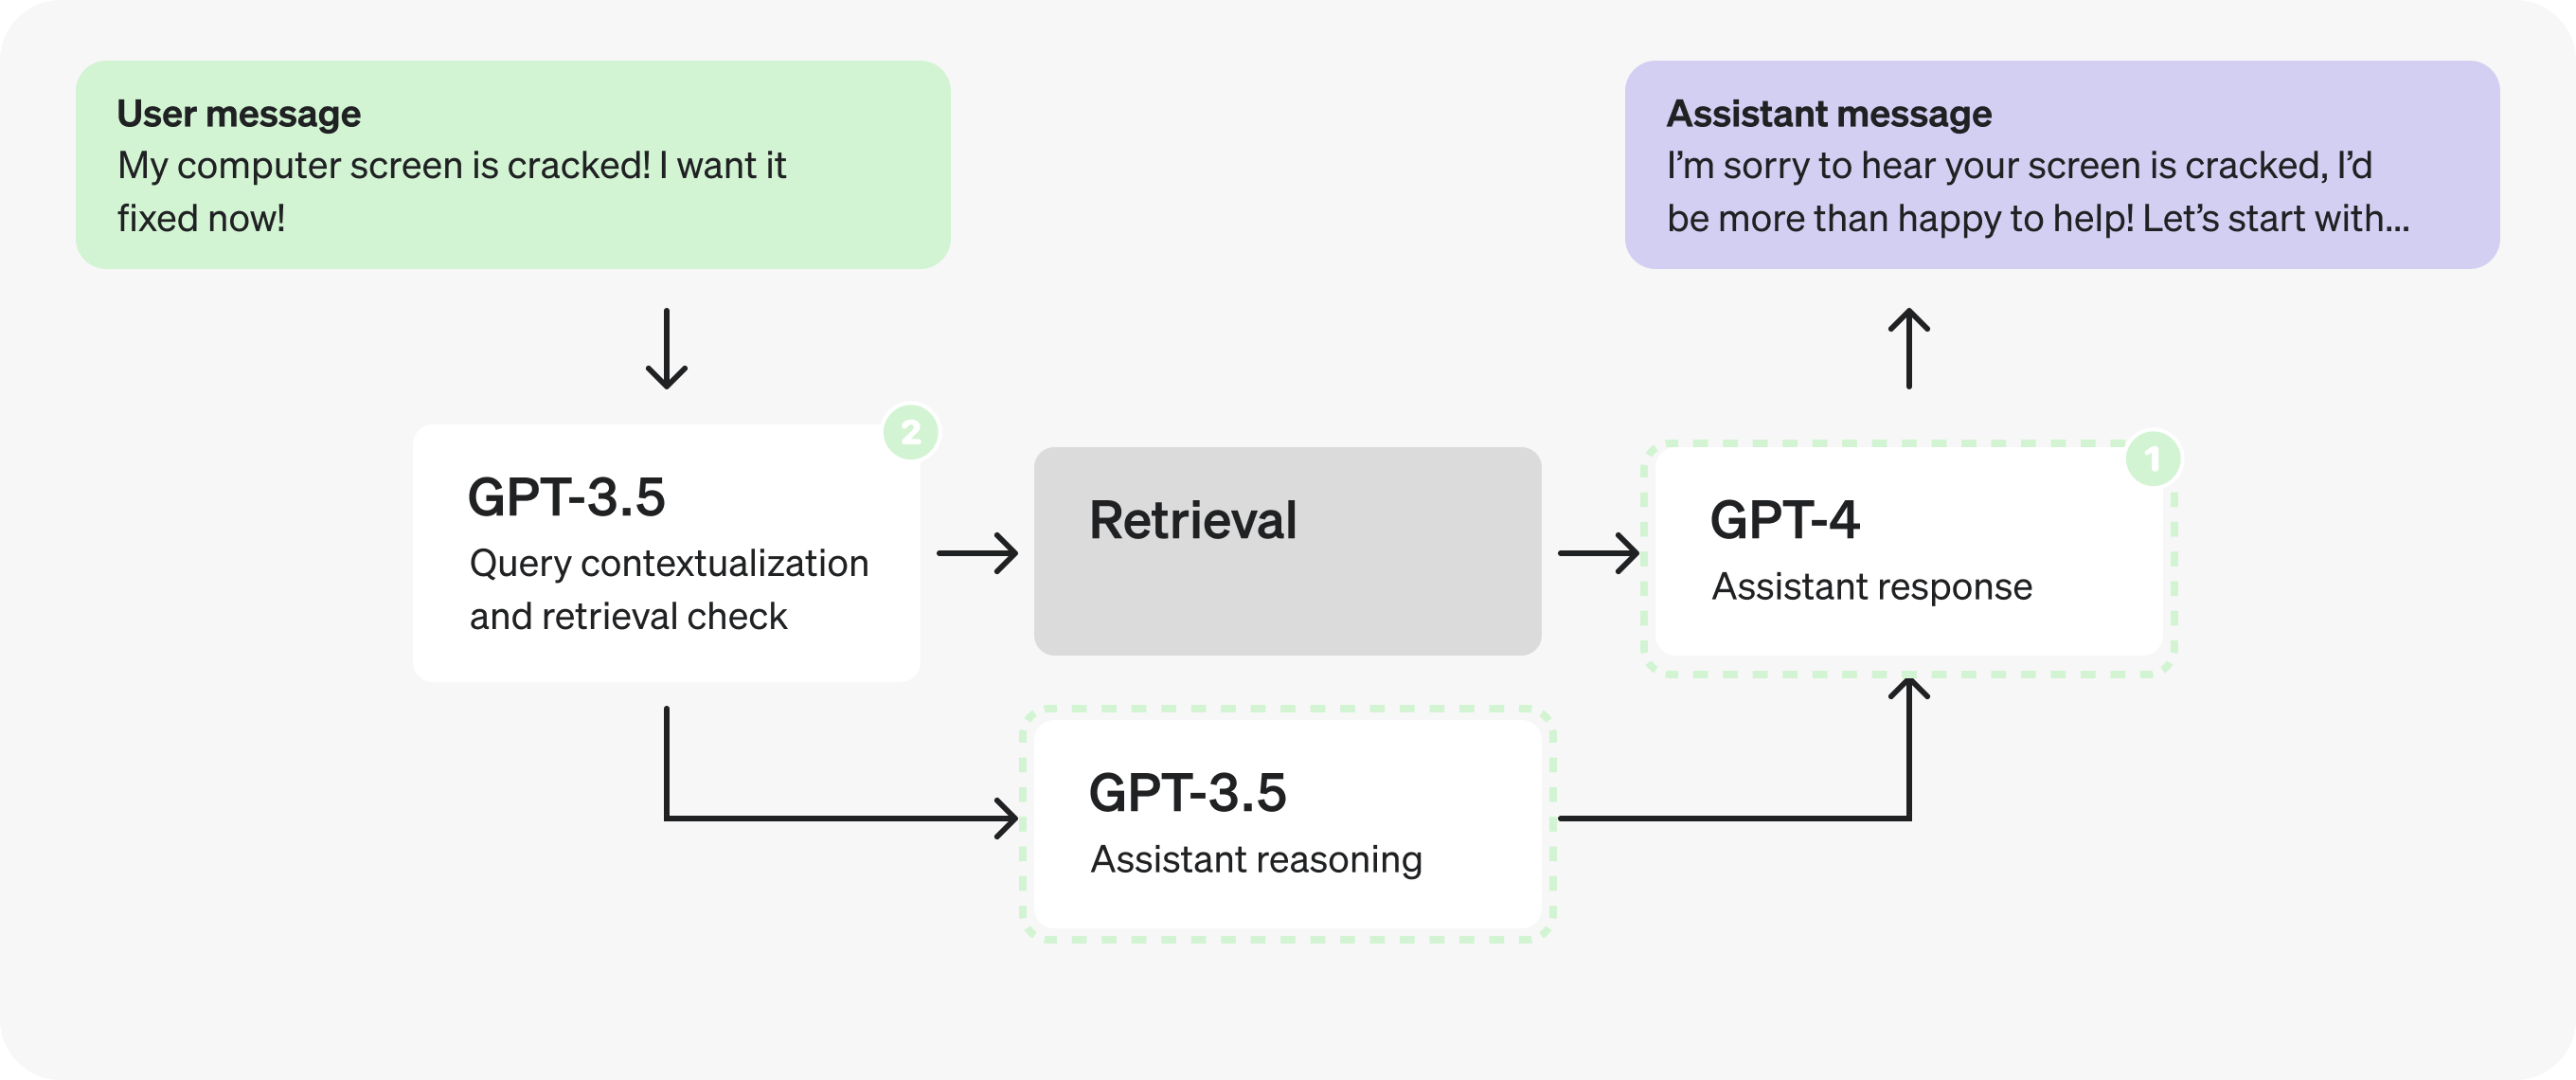
注意: 我們會將 response 和 enough_information_in_context 一起放在第二個提示詞中,以免兩個新提示詞都需要接收檢索到的上下文。
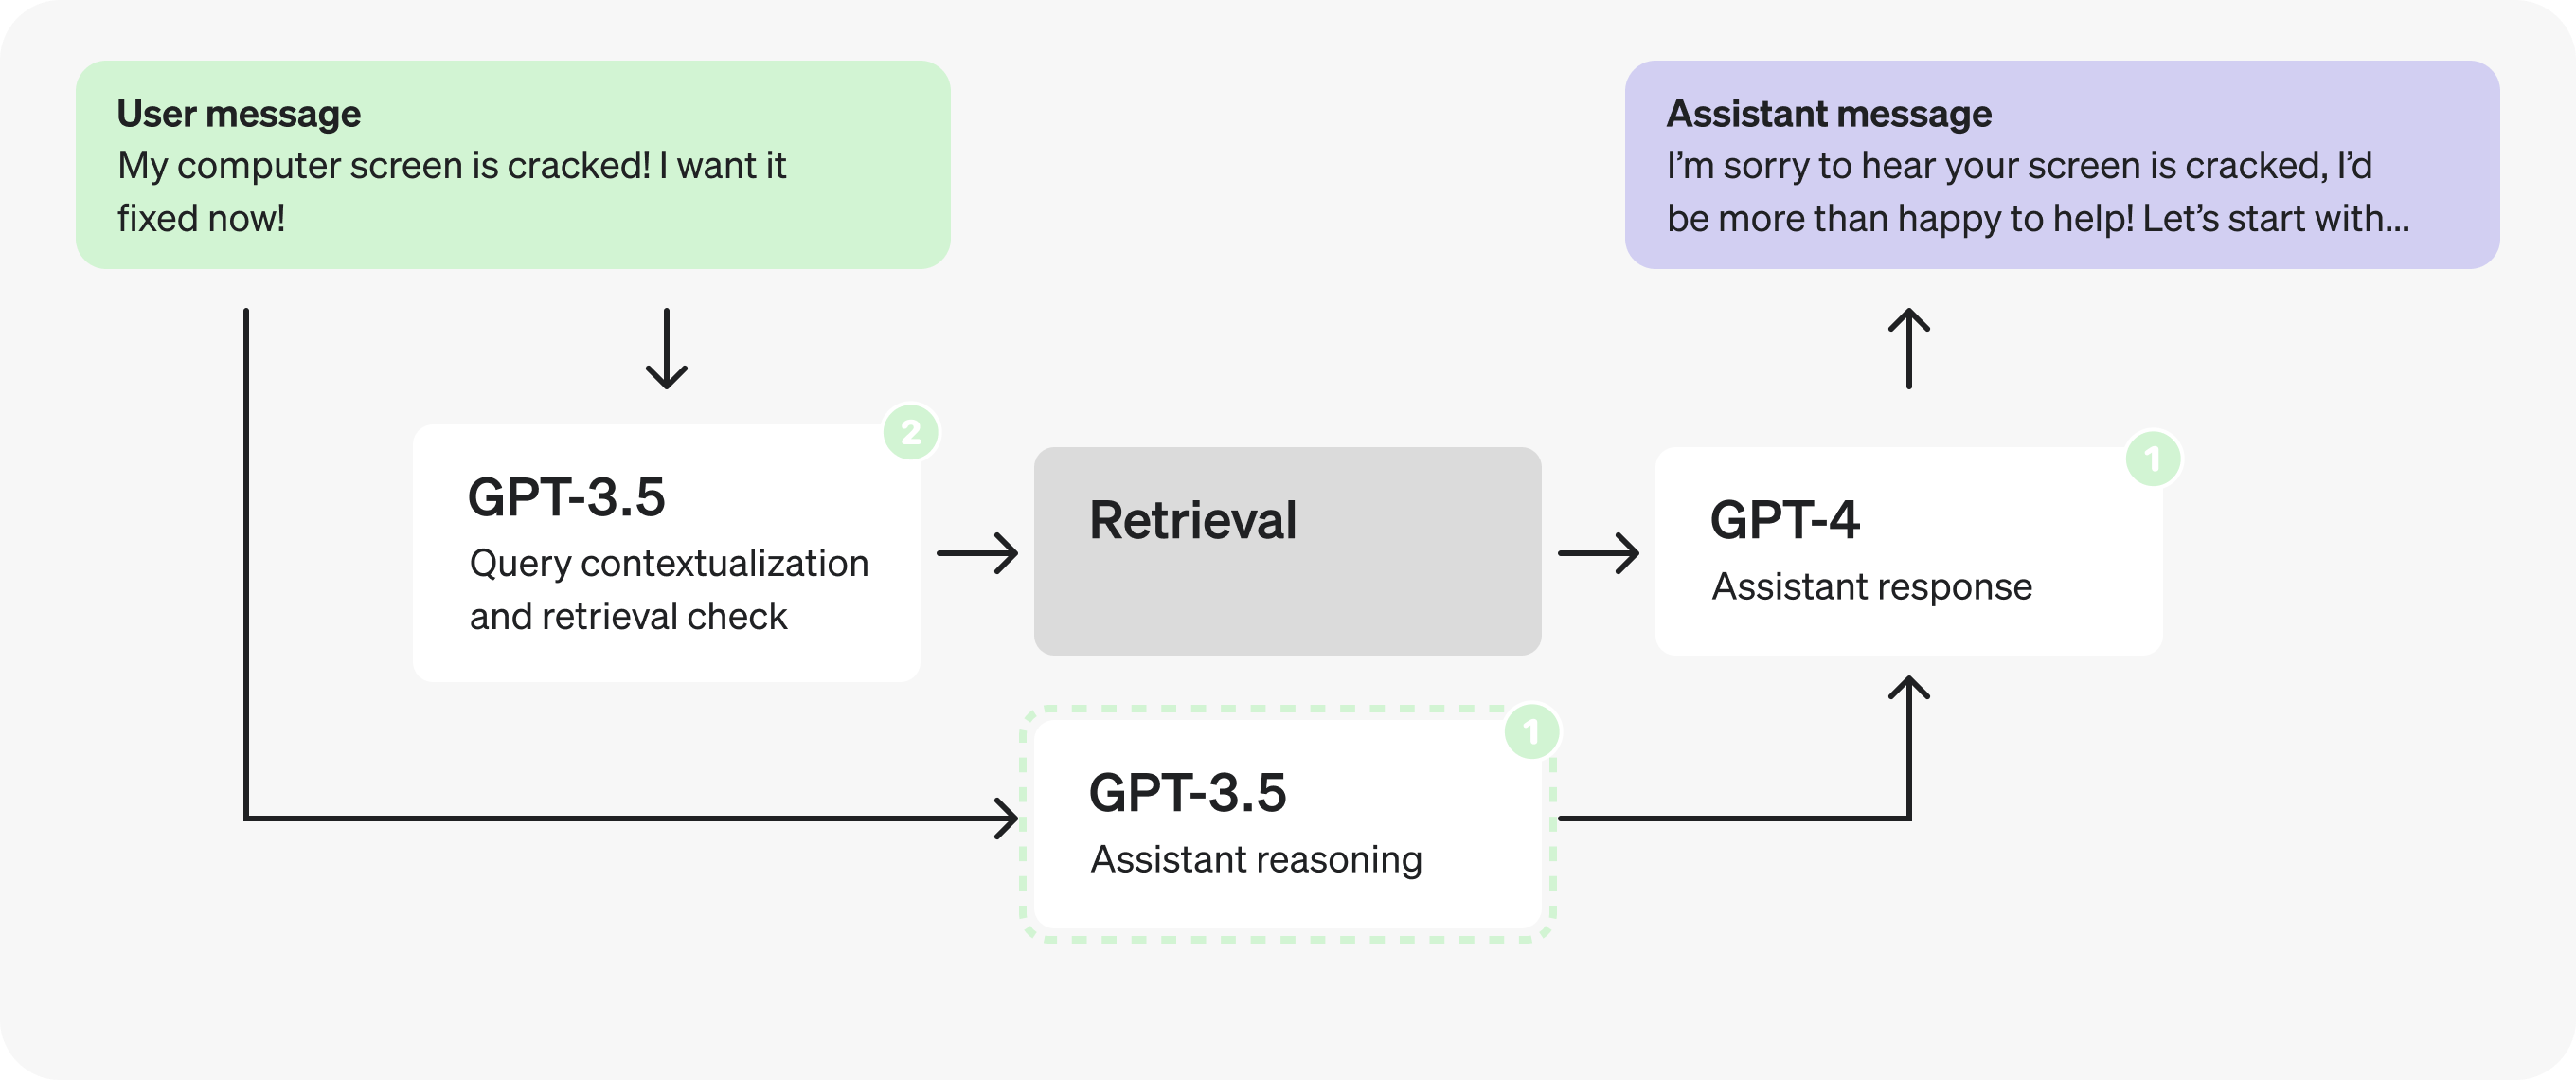
事實上,既然推理提示詞不再依賴檢索到的上下文,我們就能採用平行處理,同時送出推理提示詞與檢索提示詞。
第 3 部分:最佳化結構化輸出
讓我們再看一次推理提示詞。
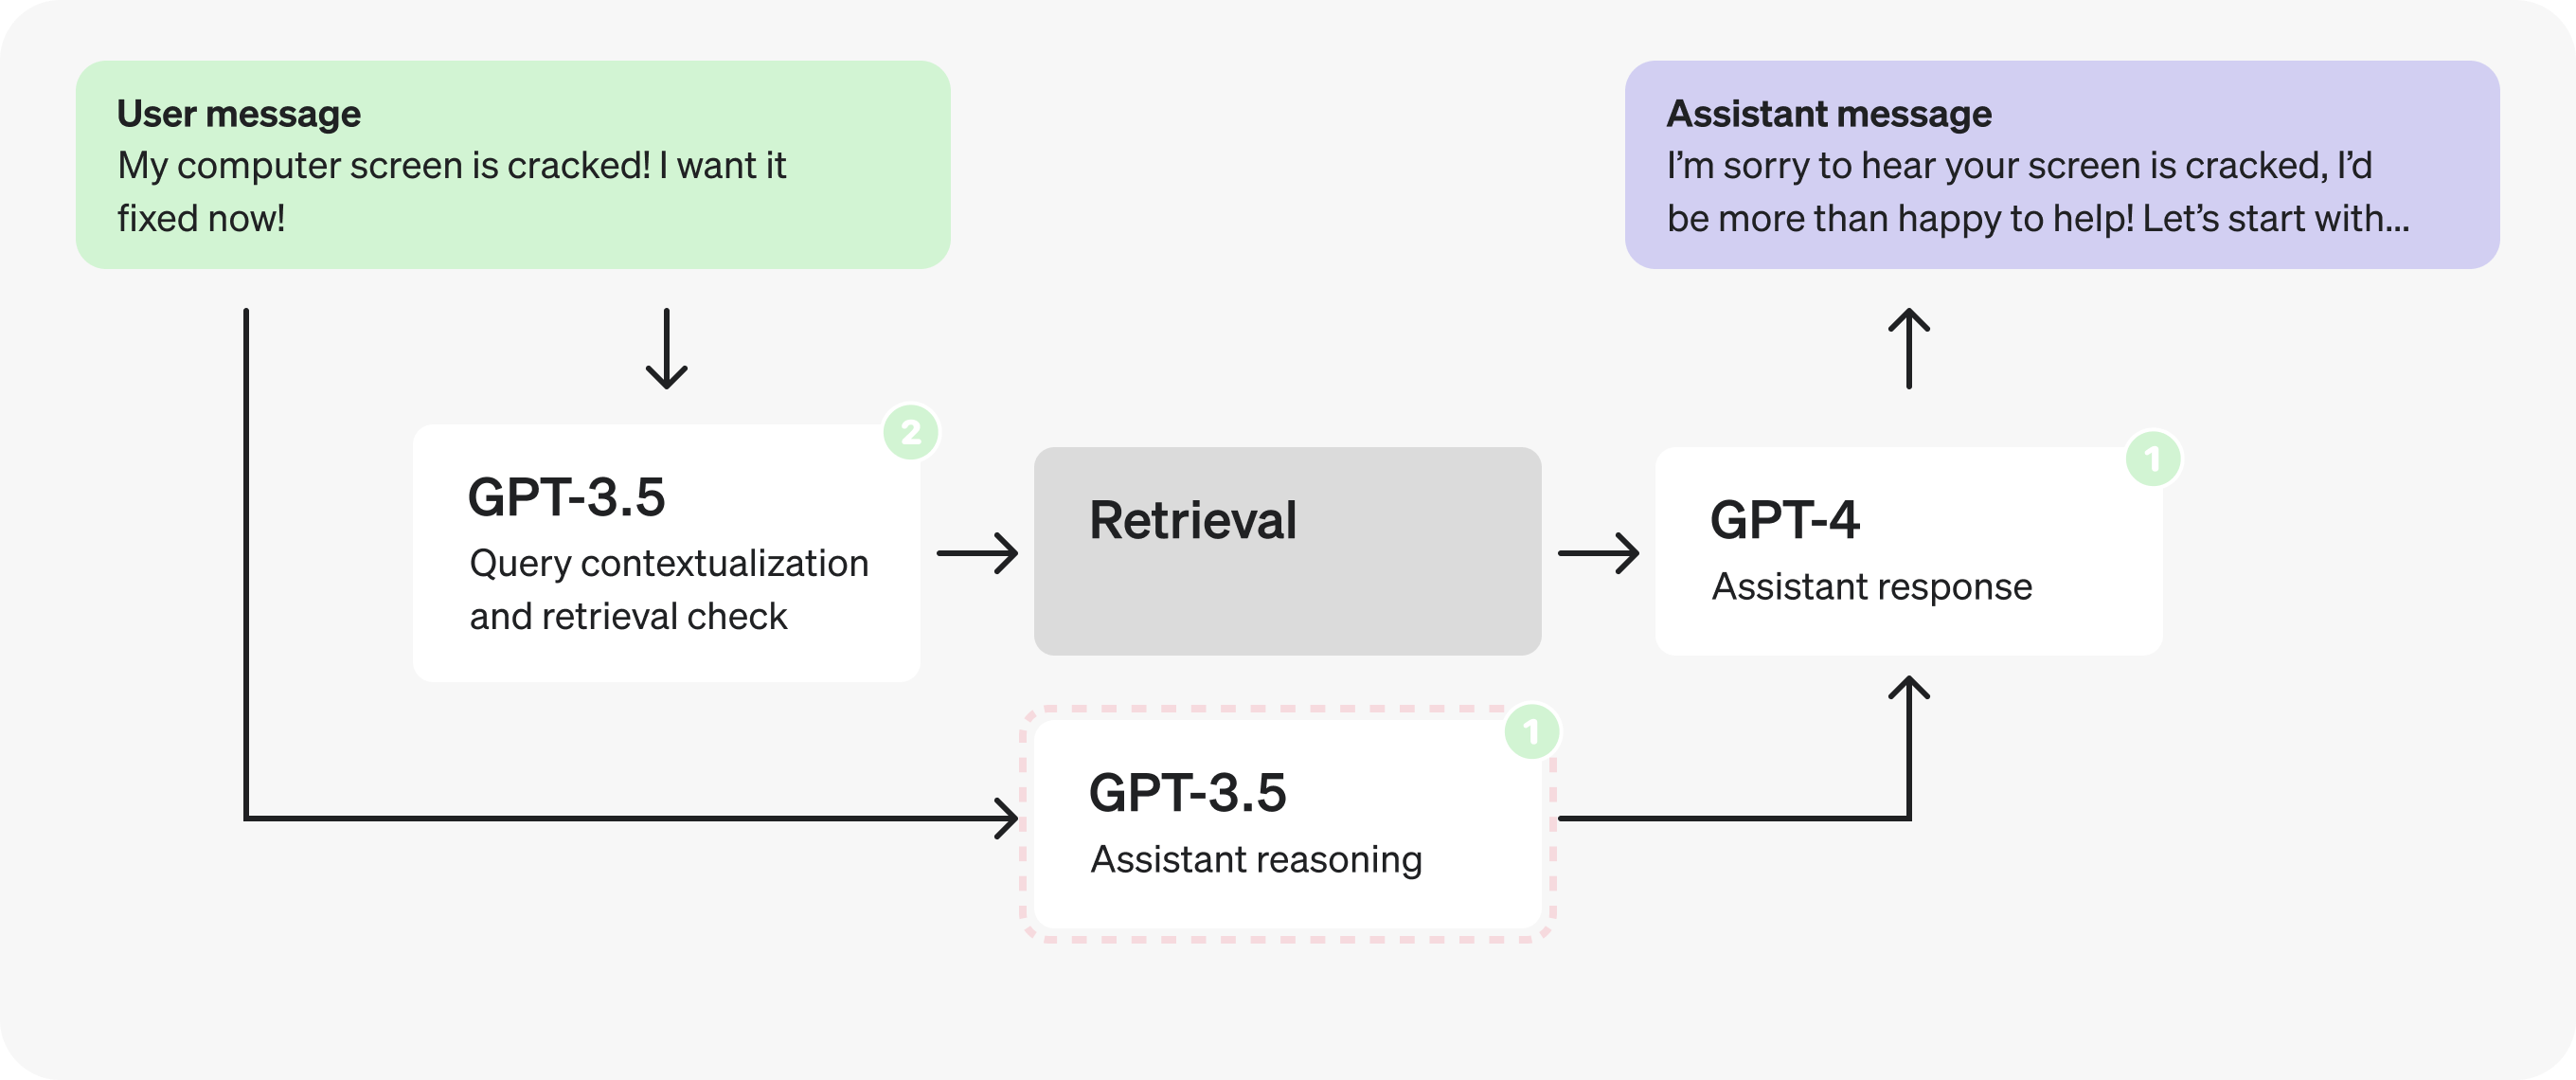
仔細查看推理用的 JSON,你可能會發現欄位名稱本身相當長。
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
}縮短欄位名稱,並將說明移至註解,就能生成更少 Token。
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
}
這項小幅變更減少了 19 個輸出 Token。對 GPT-3.5 而言,這可能只改善幾毫秒,但對 GPT-4 而言,最多可能節省一秒。
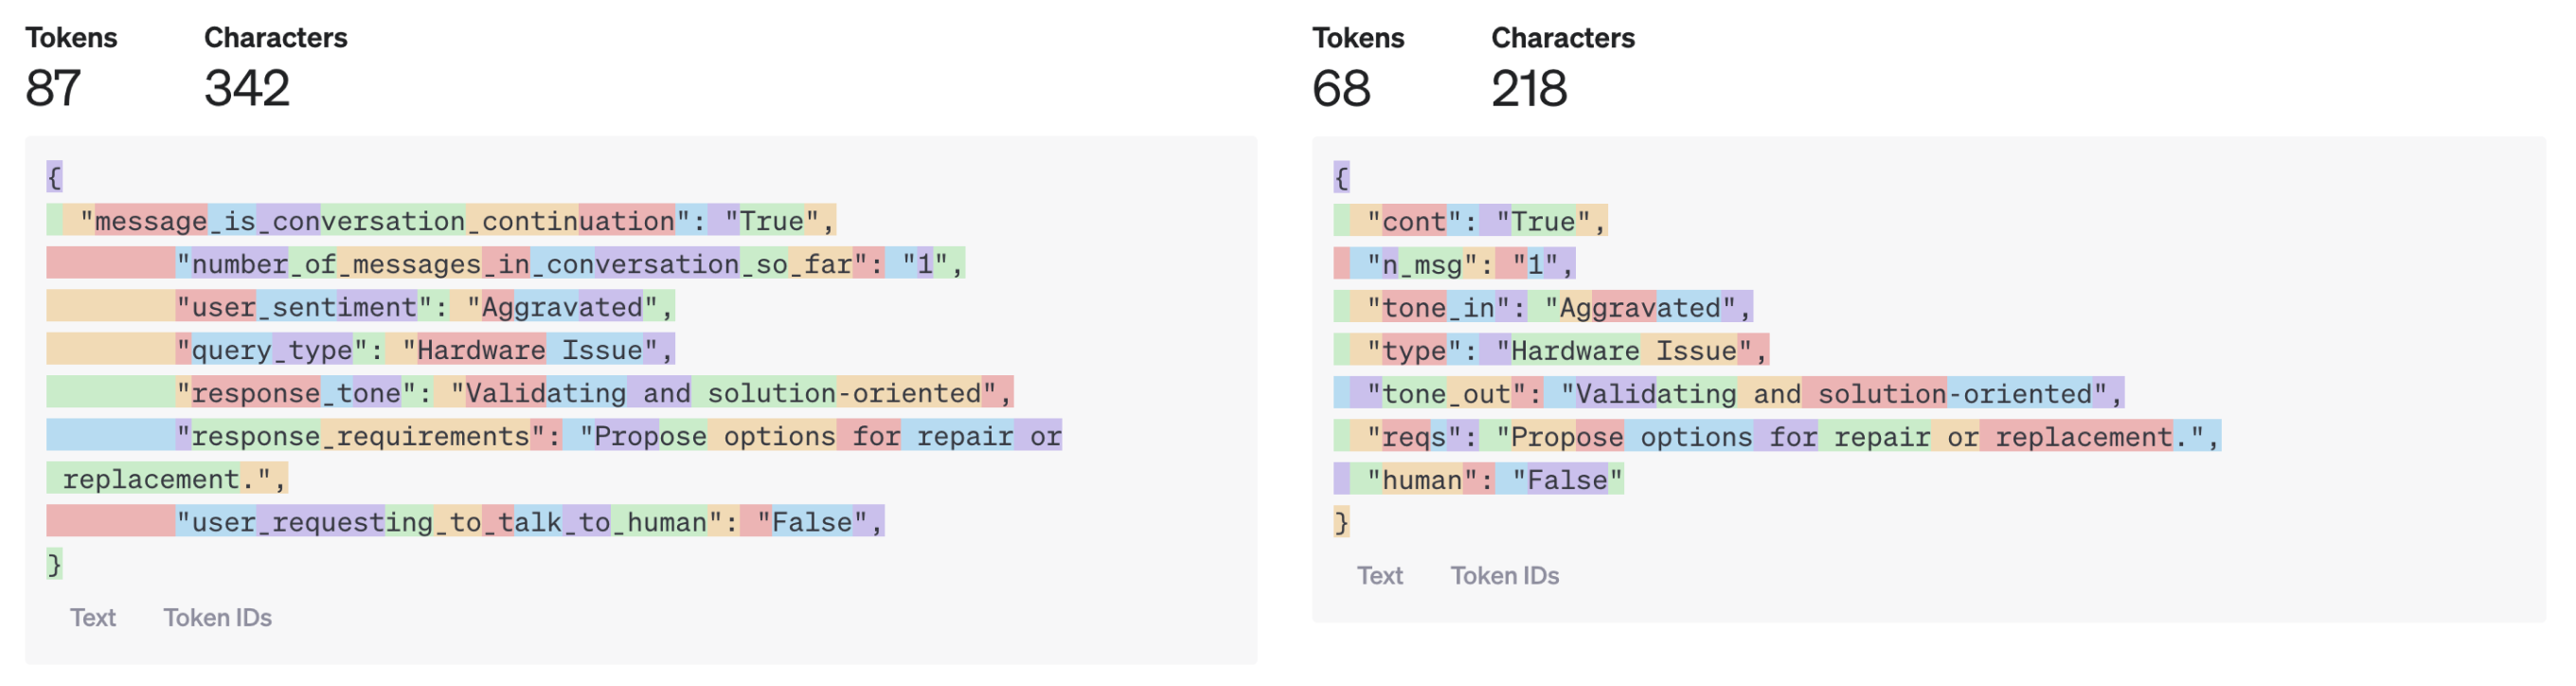
不過,不難想像,當模型輸出較長時,這種做法就能帶來相當顯著的影響。
我們可以進一步將 JSON 欄位名稱縮短為單一字元,或將所有內容放進陣列,但這可能開始影響回應品質。要確認實際效果,最好的方法仍然是測試。
範例總結
讓我們回顧在客服機器人範例中採用的最佳化措施:
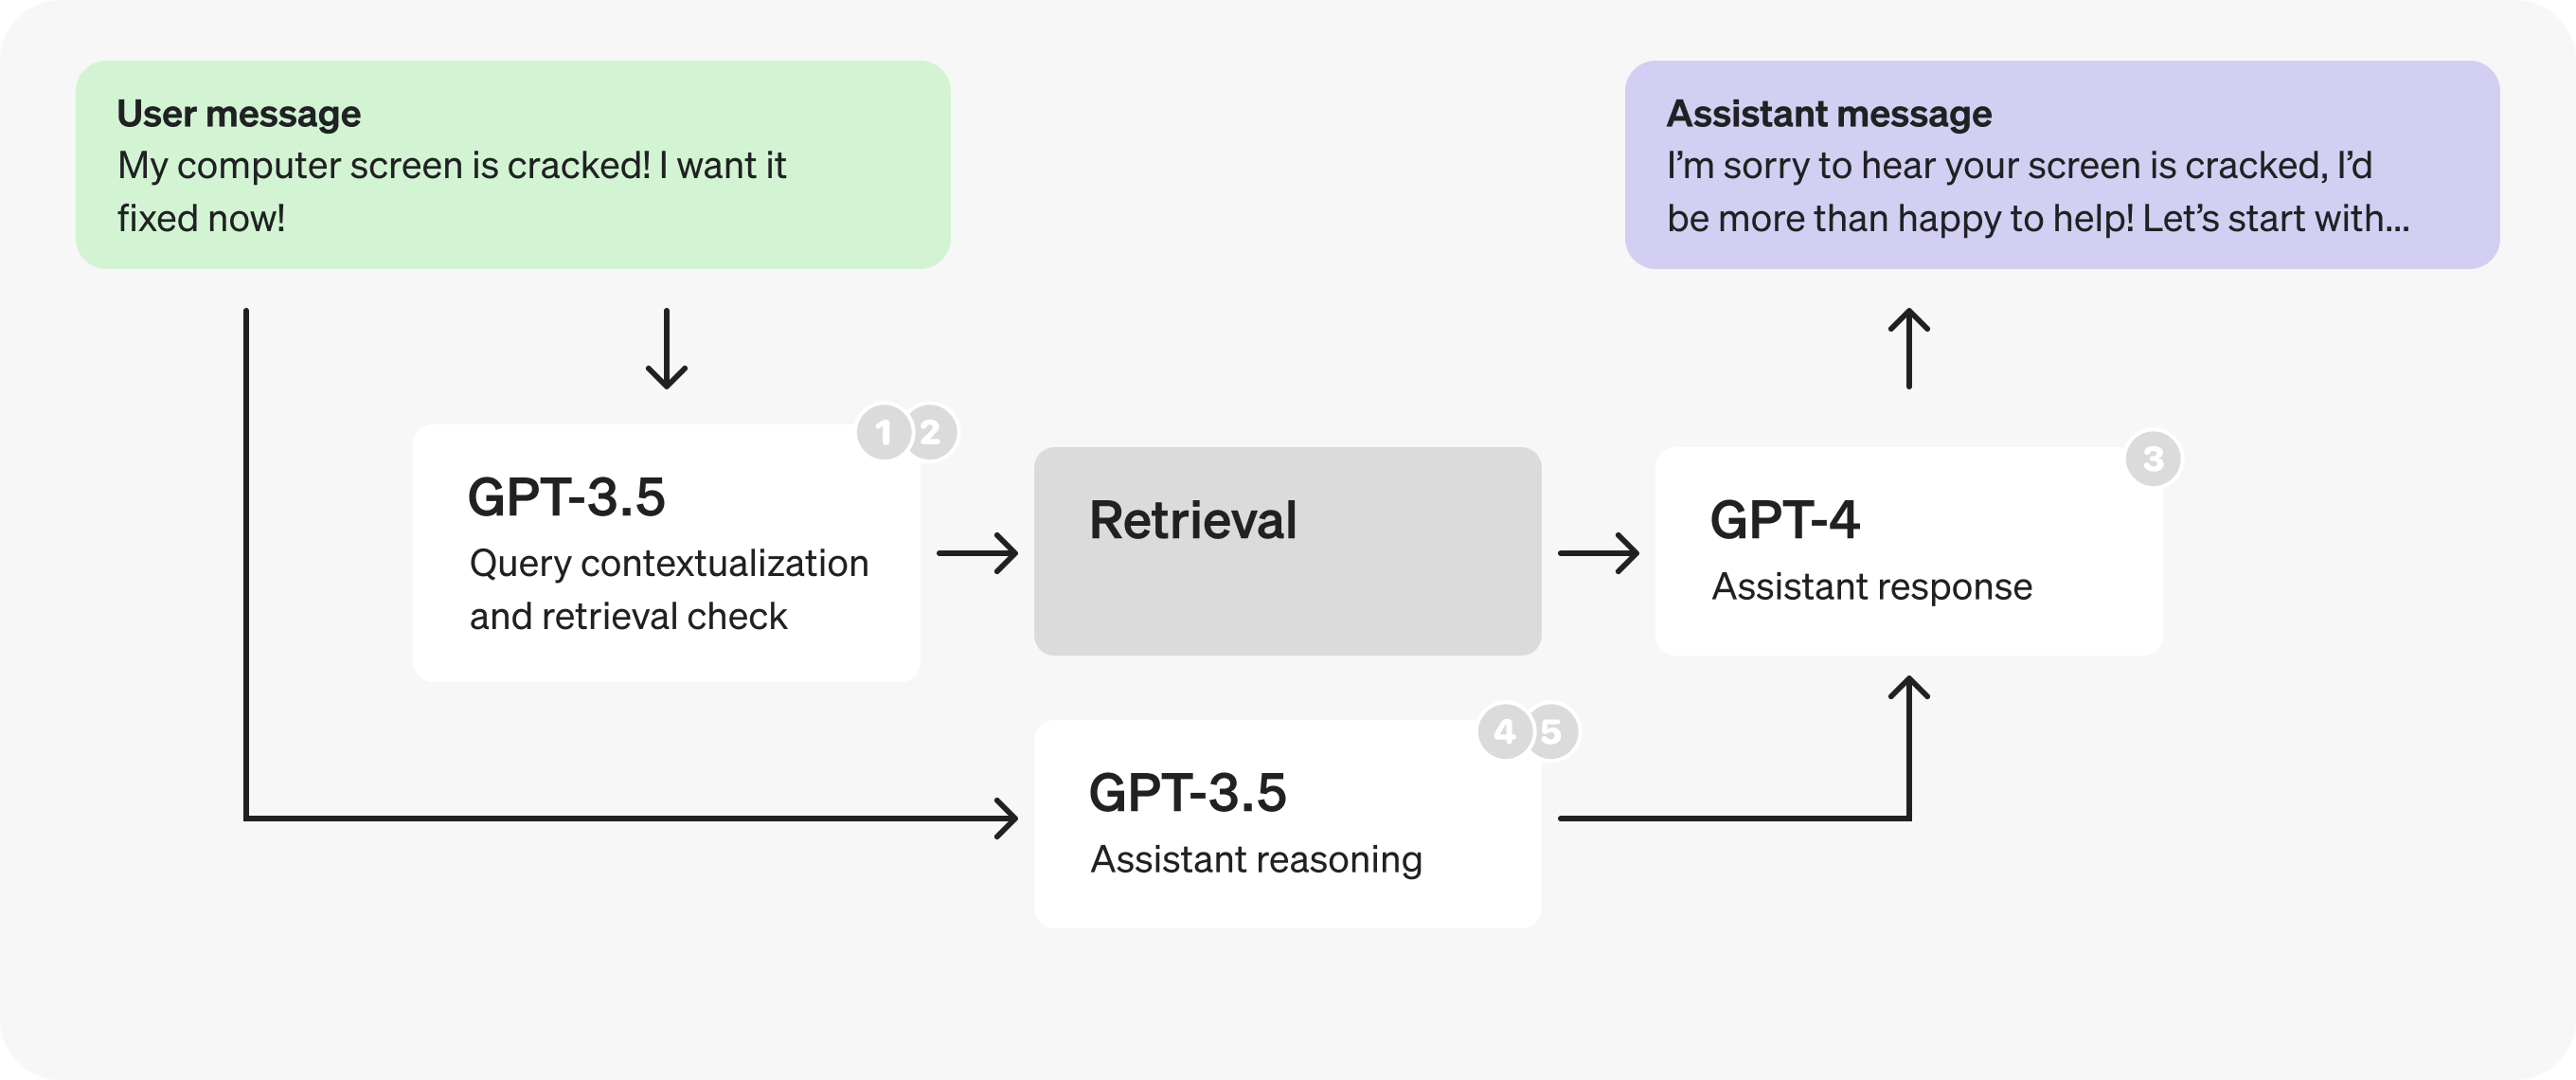
- 合併 為查詢補充上下文與檢查是否需要檢索的步驟,以減少請求次數。
- 針對新的提示詞, 改用規模較小、經過微調的 GPT-3.5 ,以加快 Token 處理速度。
- 將助理提示詞拆成兩個,並 改用規模較小、經過微調的 GPT-3.5 進行推理,同樣是為了加快 Token 處理速度。
- 平行執行檢索需求檢查與推理步驟。
- 縮短推理欄位名稱 ,並將註解移至提示詞中,以減少生成的 Token 數量。