
En septembre 2025, OpenAI a présenté GPT-5-Codex, la première version de GPT-5 optimisée pour la programmation agentique. En décembre 2025, nous avons lancé 5.2, et c’est à ce moment-là que les utilisateurs ont commencé à croire à la fiabilité des agents de programmation autonomes. Nous avons notamment constaté une forte augmentation de la durée pendant laquelle le modèle pouvait suivre les instructions de manière fiable.
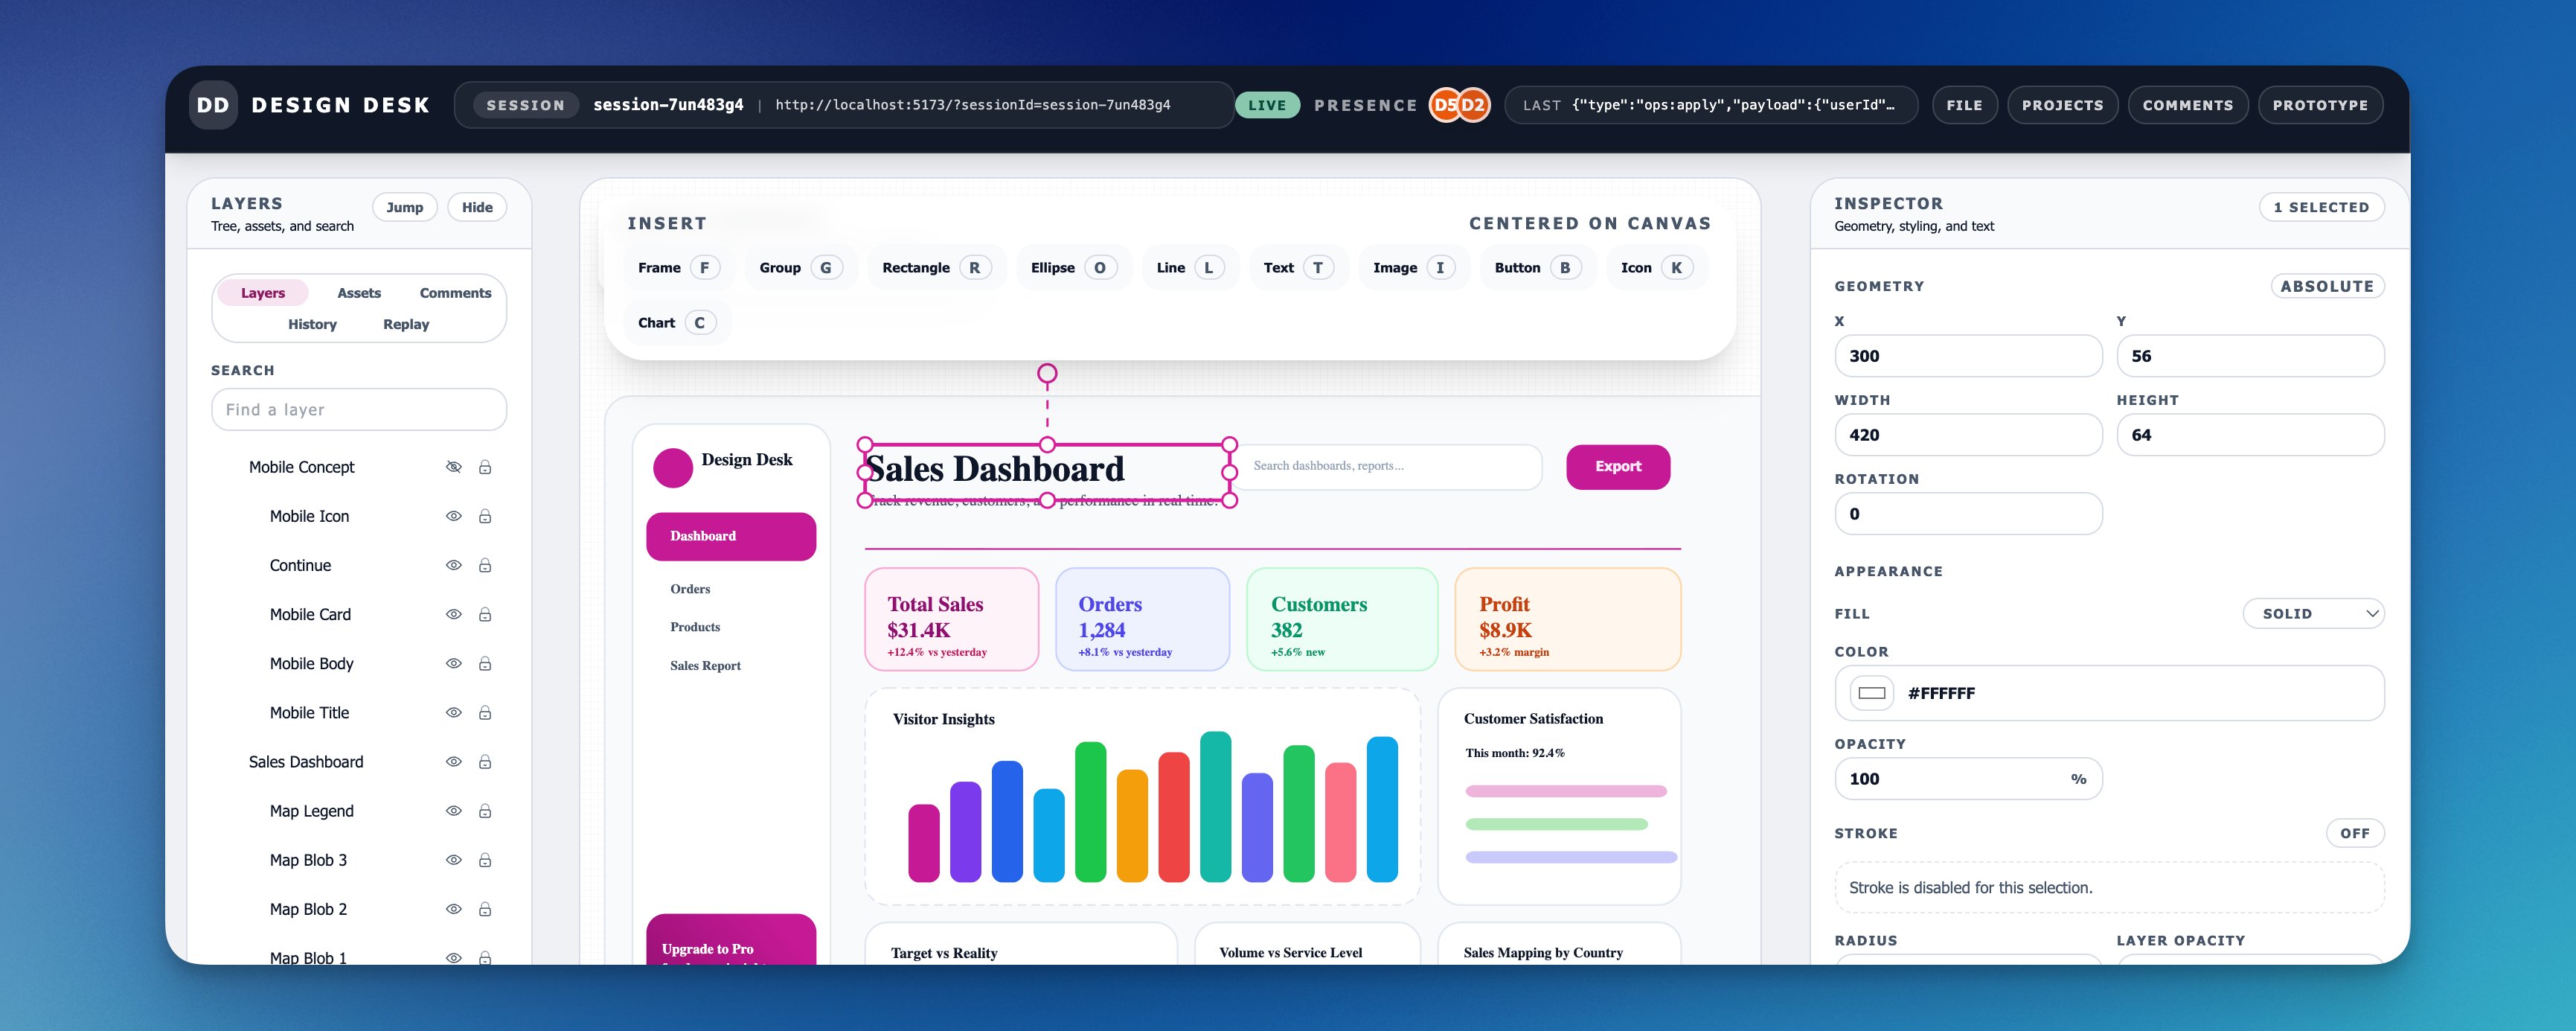
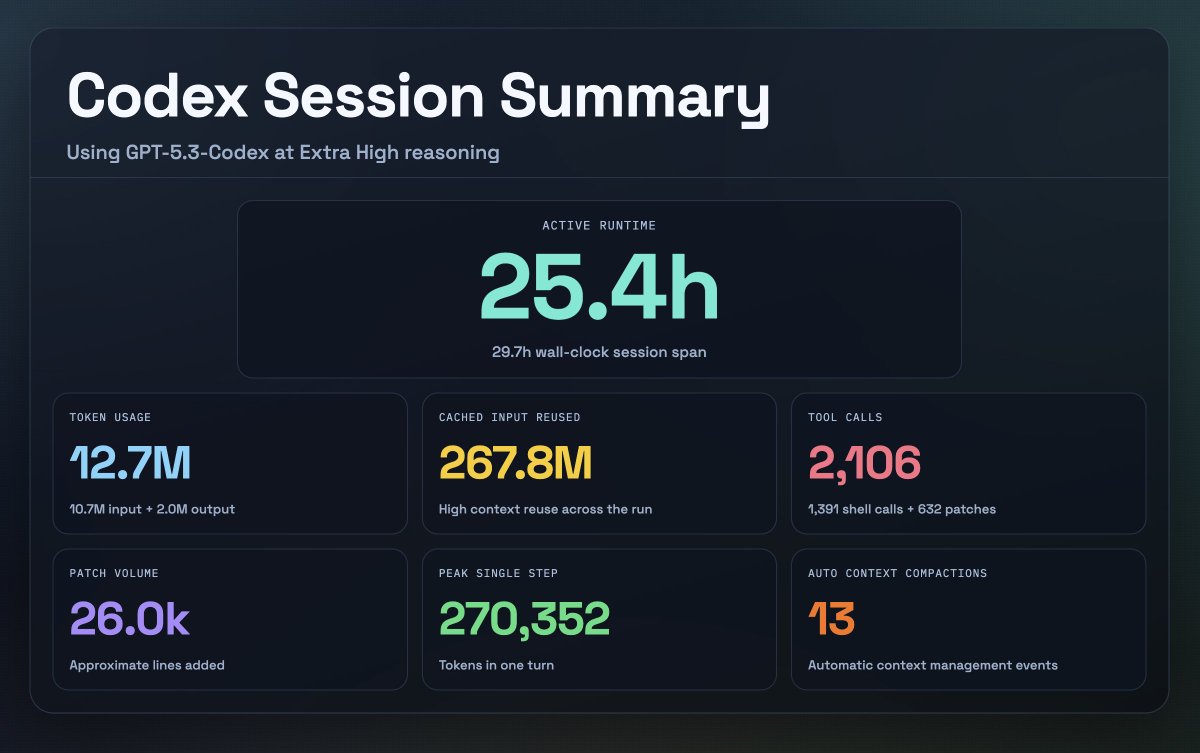
Je voulais mettre cette limite à l’épreuve. J’ai donc donné à Codex un dépôt vide, un accès complet et une seule mission : créer un outil de design à partir de zéro. Puis je l’ai laissé travailler avec GPT-5.3-Codex et le niveau de raisonnement « Très élevé ». Codex a fonctionné pendant environ 25 heures sans interruption, consommé environ 13 millions de tokens et généré environ 30 000 lignes de code.
Il s’agissait d’une expérience, pas d’un déploiement en production. Mais Codex s’est montré performant sur les aspects essentiels des tâches de longue durée : respecter les spécifications, rester concentré sur la tâche, effectuer des vérifications et corriger les erreurs au fur et à mesure.
À quoi ressemble une session Codex de longue durée
J’ai demandé à Codex de générer une page récapitulative des données de la session :
Voici également un aperçu des statistiques de la session CLI et de la consommation de tokens :
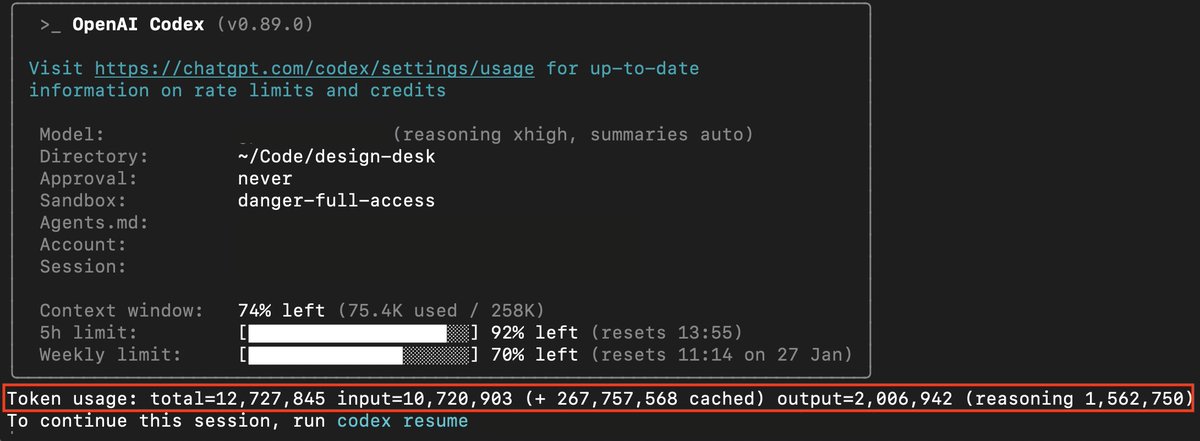
Ces captures d’écran sont utiles, car elles illustrent le changement fondamental en cours : la programmation agentique repose de plus en plus sur l’horizon temporel, et pas seulement sur l’intelligence déployée en une seule étape.
Le véritable changement concerne l’horizon temporel
Il ne s’agit pas simplement de dire que « les modèles sont devenus plus intelligents ». Concrètement, les agents peuvent rester cohérents plus longtemps, mener à bien des tâches plus importantes de bout en bout et se remettre d’erreurs sans perdre le fil.
Les travaux de METR sur les benchmarks d’horizon temporel aident à comprendre cette tendance : la durée des tâches logicielles que les agents de pointe peuvent accomplir avec une fiabilité d’environ 50 % et de 80 % augmente rapidement, avec un doublement tous les 7 mois environ. Consultez Mesurer la capacité de l’IA à accomplir des tâches longues (METR).
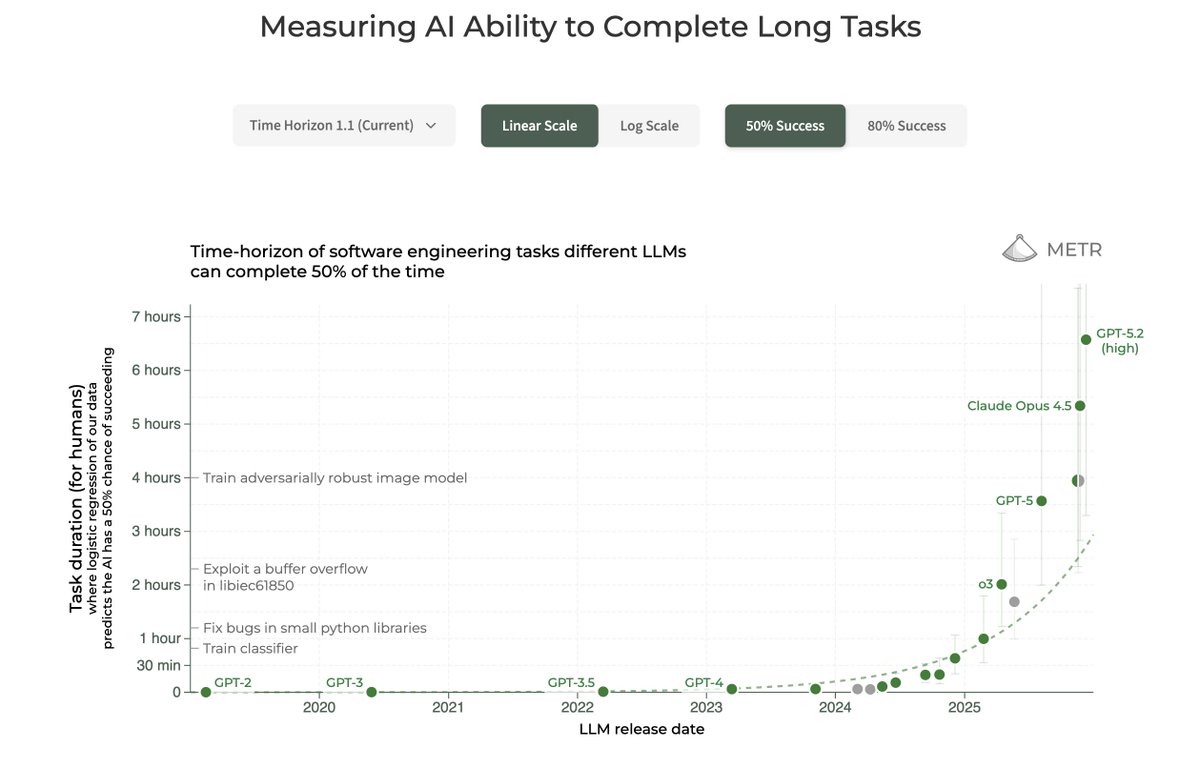
Notre récente annonce du lancement de GPT-5.3-Codex va plus loin dans cette direction pour le travail des agents, avec deux avancées concrètes :
- Il exécute mieux les tâches en plusieurs étapes (planification → implémentation → validation → correction).
- Il est plus facile de le réorienter en cours de route sans tout recommencer (les changements de cap n’effacent pas les progrès réalisés).
Je me suis aussi inspiré des articles de Cursor sur les systèmes de programmation autonomes capables de travailler sur de longues durées, notamment leur expérience de création d’un navigateur : Comment Cursor a créé un navigateur web (Passage à l’échelle des agents).
L’équipe de Cursor a écrit que les modèles OpenAI sont « bien meilleurs pour travailler en autonomie sur de longues durées : suivre les instructions, rester concentrés, éviter de dévier de l’objectif et réaliser des implémentations précises et complètes ».
Pourquoi Codex peut rester cohérent sur des tâches longues
Les tâches de longue durée reposent moins sur un prompt gigantesque que sur la boucle de l’agent dans laquelle le modèle fonctionne.
Dans Codex, cette boucle se déroule à peu près ainsi :
- Planification
- Modification du code
- Exécution des outils (tests/build/lint)
- Observation des résultats
- Correction des erreurs
- Mise à jour de la documentation et de l’état d’avancement
- Répétition du cycle
Cette boucle est essentielle, car elle apporte à l’agent :
- Des retours concrets (erreurs, diffs, journaux)
- Un état conservé à l’extérieur du modèle (dépôt, fichiers, documentation, arbres de travail, sorties)
- La possibilité d’être réorienté au fil du temps (vous pouvez ajuster le cap en fonction des résultats)
C’est aussi pourquoi les modèles Codex semblent plus performants dans les interfaces Codex que dans une fenêtre de discussion générique : le harnais fournit un contexte structuré (métadonnées du dépôt, arborescence des fichiers, diffs, sorties des commandes) et impose une vérification rigoureuse des critères d’achèvement.
Nous avons récemment publié un article qui explique plus en détail la boucle de l’agent Codex.
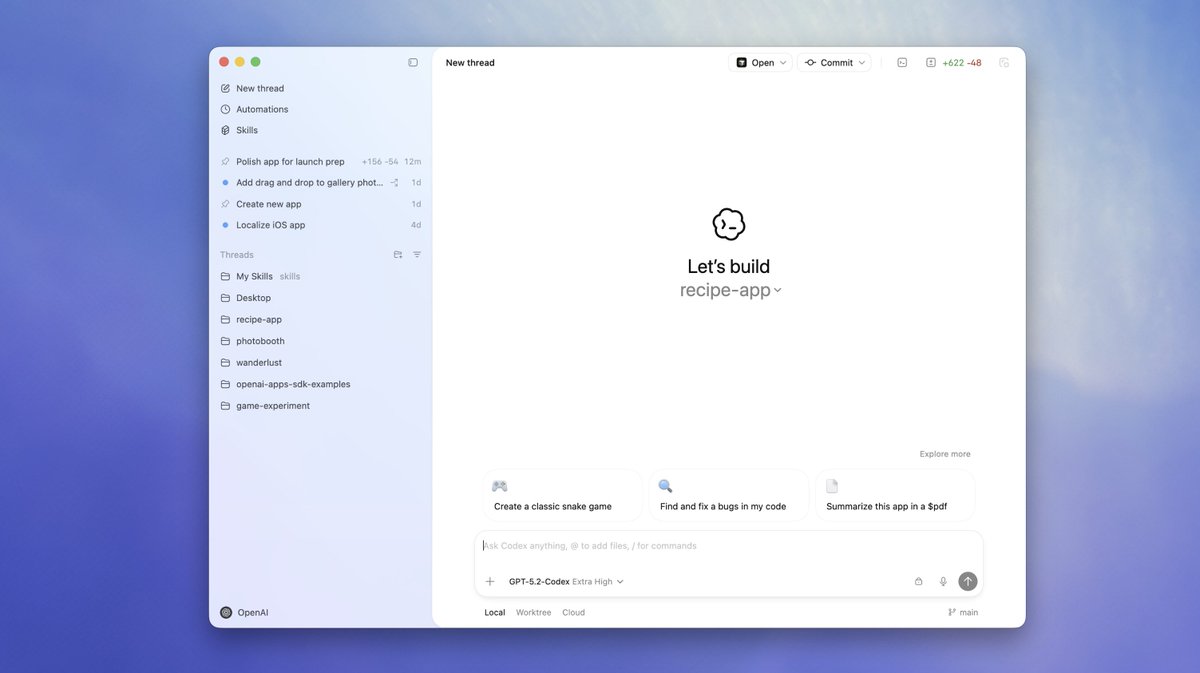
Pour compléter le tout, nous avons aussi lancé Codex App, qui permet d’utiliser cette boucle au quotidien :
- Fils de discussion en parallèle dans plusieurs projets (les tâches longues ne bloquent pas votre travail quotidien)
- Skills (standardisation de la planification, de l’implémentation, des tests et des comptes rendus)
- Automatisations (tâches courantes en arrière-plan)
- Arbres de travail Git (isolation des exécutions, diffs faciles à examiner et réduction des allers-retours inutiles)
Ma configuration pour le test
J’ai choisi un outil de design pour cette « expérience », car c’est un test qui ne pardonne pas : interface utilisateur + modèle de données + opérations d’édition + nombreux cas limites. Impossible de faire illusion. Si l’architecture est mauvaise, tout casse rapidement.
J’ai fourni à GPT-5.3-Codex des spécifications conséquentes et l’ai lancé avec le niveau de raisonnement « Très élevé ». Il a finalement travaillé sans interruption pendant environ 25 heures, tout en restant cohérent et en livrant du code de qualité. Le modèle a également effectué des vérifications (tests, lint, vérification des types) à chaque jalon atteint.
L’idée clé : une mémoire persistante du projet
La technique la plus importante consistait à conserver une mémoire persistante du projet. J’ai consigné les spécifications, le plan, les contraintes et l’état d’avancement dans des fichiers Markdown que Codex pouvait consulter à plusieurs reprises. Cela lui a permis de ne pas dévier de l’objectif et de conserver une définition stable de ce qui était considéré comme « terminé ».
Le lien vers le dépôt figure ci-dessous. Les fichiers étaient organisés comme suit :
Prompt.md (spécifications + livrables)
Objectif : fixer le résultat attendu pour éviter que l’agent ne « construise quelque chose d’impressionnant qui ne répond pas au besoin ».
Principales sections du fichier :
- Objectifs + éléments hors périmètre
- Contraintes impératives (performances, déterminisme, UX, plateforme)
- Livrables (ce qui doit exister à la fin)
- « Terminé lorsque » (vérifications + déroulé de la démonstration)
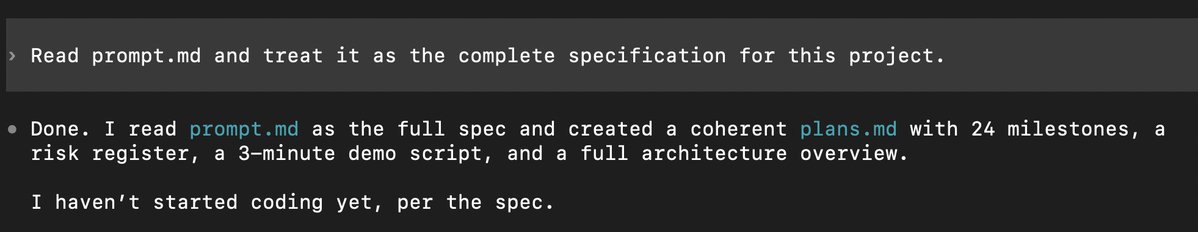
Le prompt initial demandait à Codex de considérer le fichier de prompt et de spécifications comme le cahier des charges complet du projet et de générer un plan structuré en jalons :
Plan.md (jalons + validations)
Objectif : transformer un travail aux contours ouverts en une succession d’étapes que l’agent peut terminer et vérifier.
Principales sections du fichier :
- Jalons suffisamment limités pour être atteints en un seul cycle
- Critères d’acceptation + commandes de validation pour chaque jalon
- Règle d’arrêt et de correction : si la validation échoue, corrigez les erreurs avant de poursuivre
- Notes sur les décisions pour éviter les changements de cap répétés
- Architecture prévue du code source
Nous avons récemment ajouté un mode plan natif à l’application Codex, à la CLI et à l’extension IDE. Il permet de décomposer une tâche importante en une suite d’étapes claires que vous pouvez examiner avant toute modification, afin de vous accorder dès le départ sur l’approche à suivre. Si des précisions sont nécessaires, Codex vous posera des questions complémentaires. Pour l’activer, utilisez la commande slash /plan.
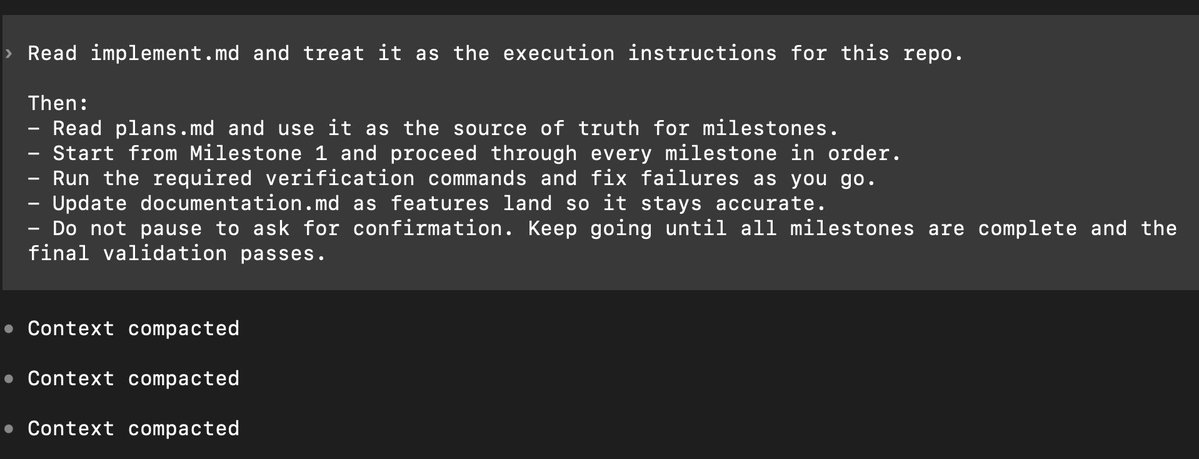
Implement.md (instructions d’exécution faisant référence au plan)
Objectif : servir de guide d’exécution. Ce fichier indique précisément à Codex comment procéder : suivre le plan, limiter les modifications au périmètre prévu, effectuer les validations et mettre à jour la documentation.
Principales sections du fichier :
- Le fichier Markdown du plan fait référence, jalon par jalon
- Effectuez les validations après chaque jalon (corrigez immédiatement les erreurs)
- Limitez les modifications au périmètre prévu (ne l’élargissez pas)
- Mettez à jour le fichier Markdown de documentation au fil du travail
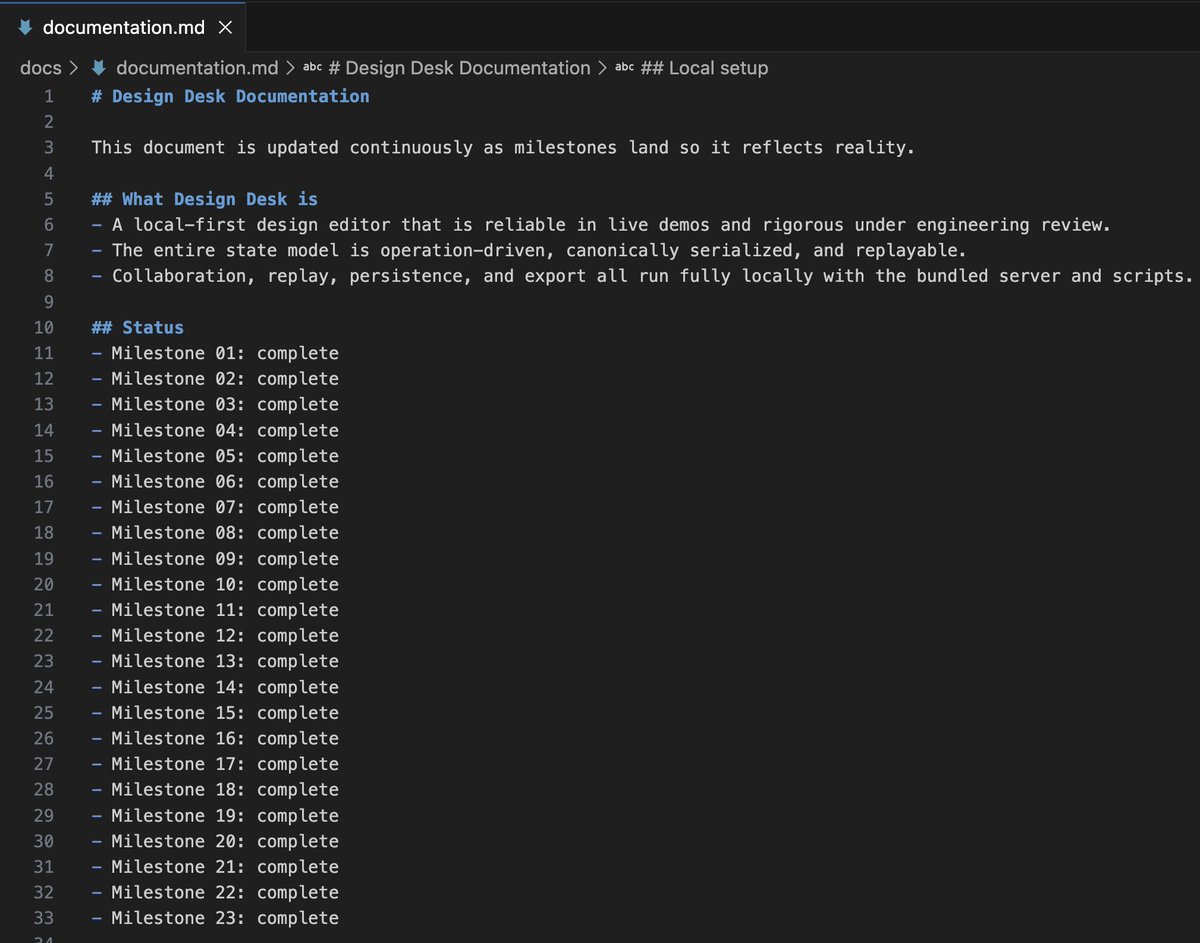
Documentation.md (avancement et décisions au fil des livraisons)
Objectif : servir de mémoire partagée et de journal d’audit. C’est ce qui me permet de m’absenter pendant des heures tout en comprenant ensuite ce qui s’est passé.
Principales sections du fichier :
- État d’avancement des jalons (ce qui est terminé et ce qui vient ensuite)
- Décisions prises (et leurs raisons)
- Instructions de lancement et de démonstration (commandes et tests rapides de bon fonctionnement)
- Problèmes connus et points à suivre
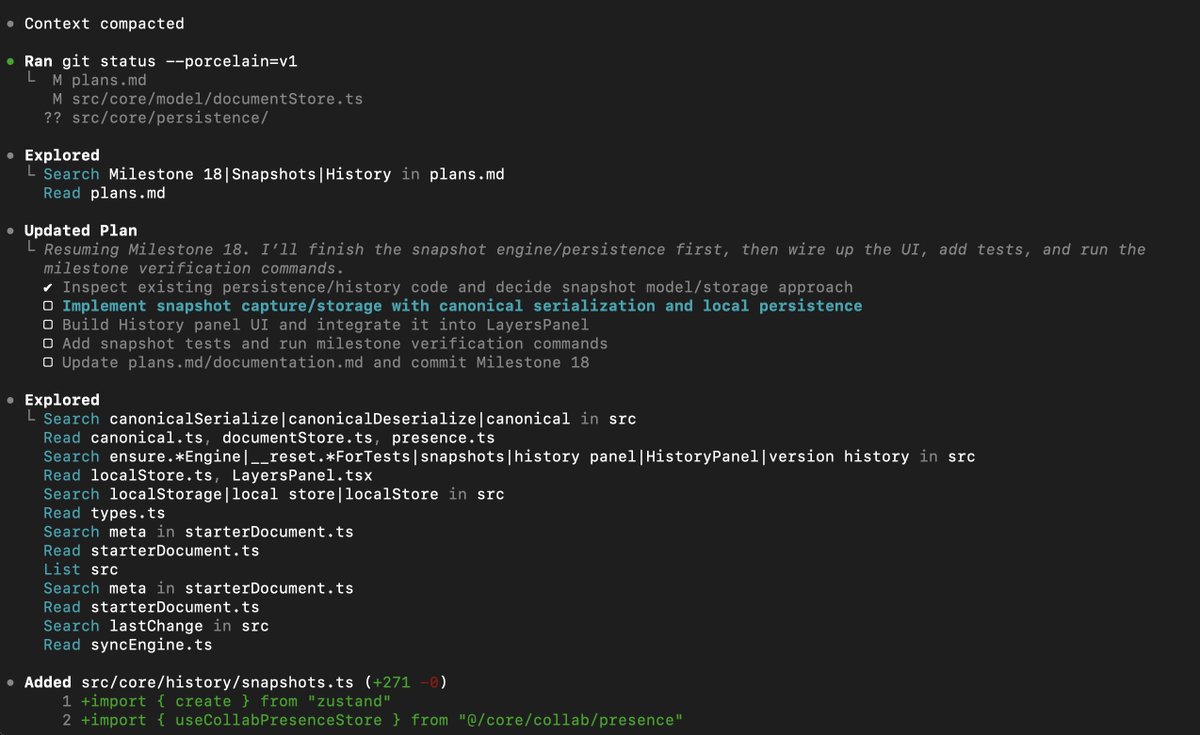
Voici à quoi ressemblait concrètement la vérification des jalons pendant cette session :
Une vérification à chaque jalon
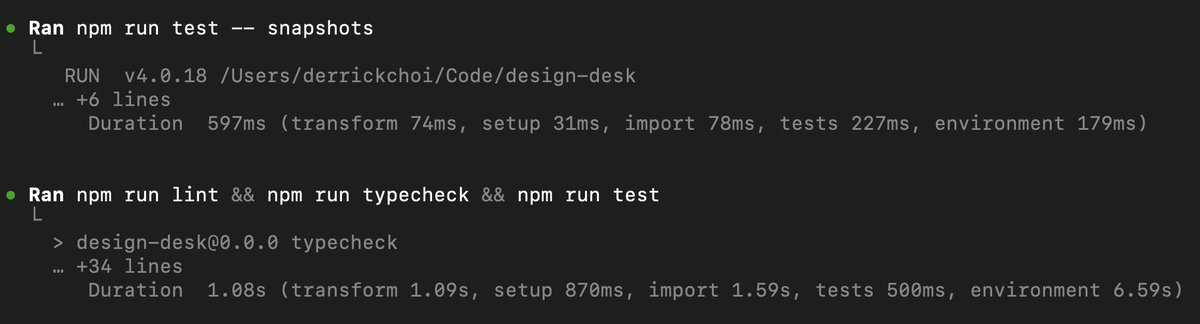
Codex ne s’est pas contenté d’écrire du code en espérant qu’il fonctionne. Après chaque jalon, il a exécuté des commandes de vérification et corrigé les erreurs avant de poursuivre.
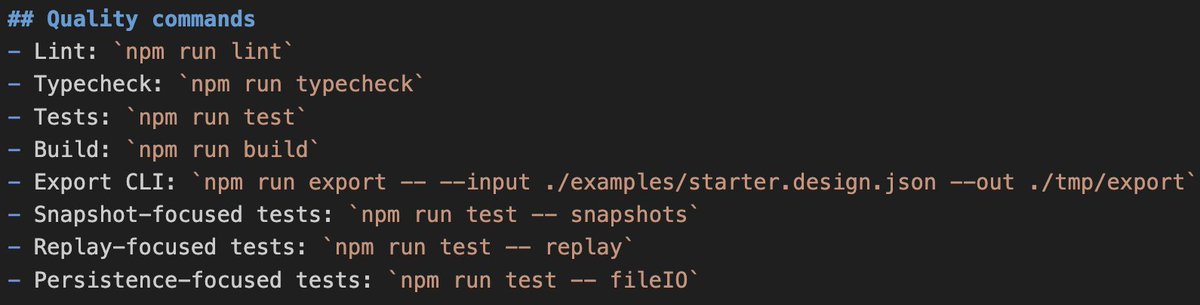
Voici quelques exemples de commandes de contrôle qualité qu’il avait pour consigne d’utiliser :
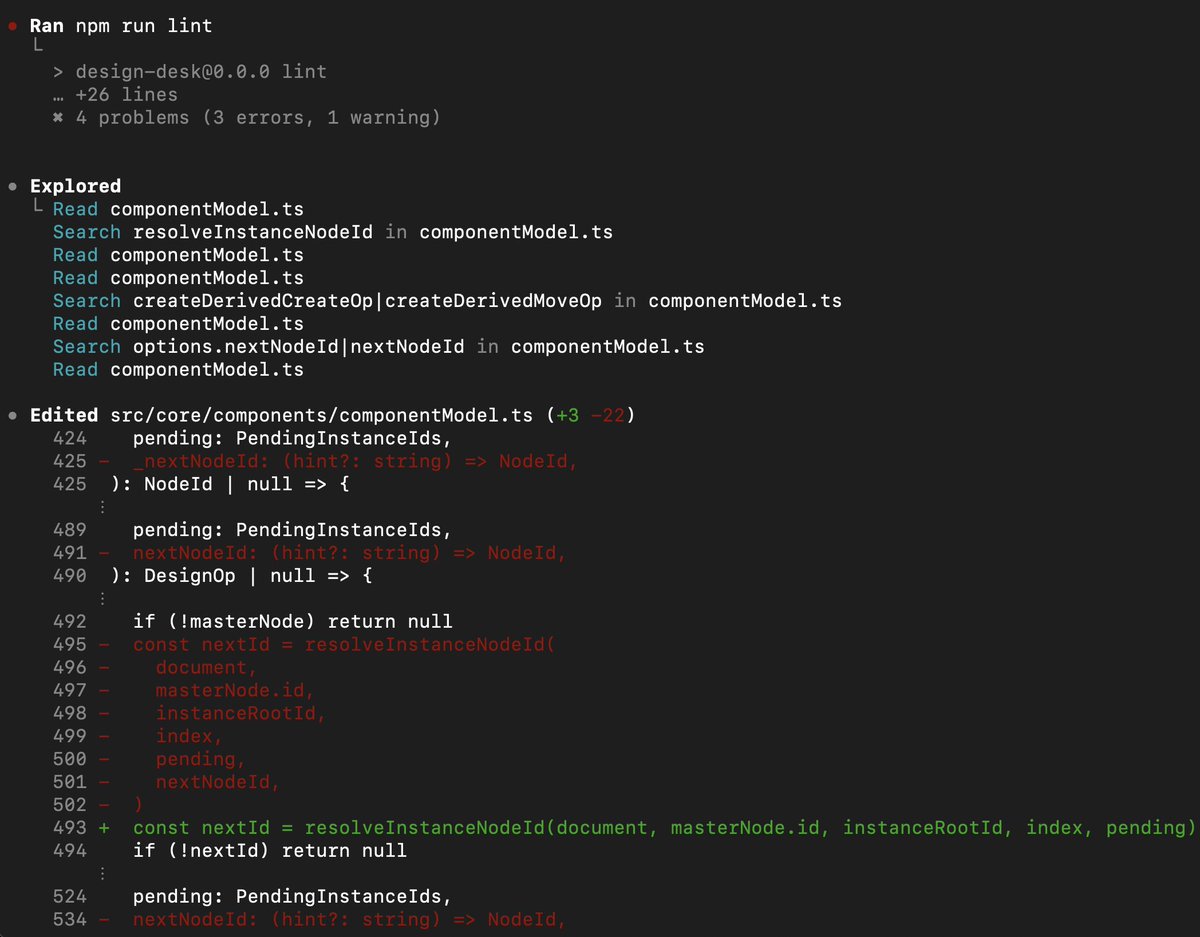
Et voici un exemple de corrections apportées par Codex après un échec du lint :
Ce que l’agent a construit
Le résultat n’était ni parfait ni prêt pour la production, mais il était concret et testable. Pour cette session, le critère n’était pas « ça compile », mais « est-ce que les instructions sont respectées et est-ce que ça fonctionne vraiment ? ».
Principales fonctionnalités implémentées :
- Édition sur le canvas (cadres, groupes, formes, texte, images/icônes, boutons, graphiques)
- Collaboration en temps réel (synchronisation de la présence, des curseurs, des sélections et des modifications entre les onglets)
- Réglages dans l’inspecteur (géométrie, style, texte)
- Gestion des calques (recherche, renommage, verrouillage/masquage, réorganisation)
- Repères/alignement/magnétisme
- Instantanés de l’historique et restauration
- Relecture de la chronologie et création d’une branche à partir d’un point antérieur
- Mode prototype (zones interactives et navigation dans les parcours)
- Commentaires (fils épinglés pouvant être résolus ou rouverts)
- Export (enregistrement/import/export et export via la CLI vers JSON et React + Tailwind)
Les enseignements à tirer pour les tâches de longue durée avec Codex
La réussite de cette session ne tenait pas à un seul prompt bien pensé, mais à la combinaison des éléments suivants :
- Un objectif et des contraintes clairs (fichier de spécifications)
- Des jalons assortis de points de contrôle et de critères d’acceptation (
plans.md) - Un guide d’exécution indiquant comment l’agent doit procéder (
implement.md) - Des vérifications en continu (tests/lint/vérification des types/build)
- Un journal d’avancement et d’audit tenu à jour (
documentation.md) pour pouvoir examiner le déroulement de la session à tout moment
C’est dans cette direction qu’évolue le travail de programmation de longue durée : moins de surveillance constante, davantage de délégation encadrée par des garde-fous.
Essayez Codex sur votre propre tâche de longue durée
Cette session de 25 heures avec Codex donne un aperçu de l’avenir du développement logiciel. Nous dépassons les prompts ponctuels et les échanges soutenus de programmation en binôme pour aller vers des coéquipiers capables de travailler dans la durée et de prendre en charge une véritable partie du travail de bout en bout. Vous les guidez aux jalons clés au lieu de superviser chaque ligne.
Notre objectif avec Codex est simple : en faire un meilleur coéquipier, l’intégrer davantage à votre contexte réel et mettre en place des garde-fous pour que son travail reste fiable, facile à examiner et à livrer. Nous constatons déjà que les développeurs avancent plus vite lorsque l’agent prend en charge les tâches courantes d’implémentation et de vérification. Ils peuvent ainsi se consacrer à l’essentiel : le design, l’architecture, les décisions produit et les problèmes inédits pour lesquels il n’existe pas de solution toute faite.
Et cela ne s’arrêtera pas aux développeurs. À mesure que Codex comprendra mieux les intentions et fournira un cadre plus sûr (plans, validations, aperçus, retours en arrière), davantage de non-développeurs pourront créer et itérer sans passer leur vie dans un IDE. D’autres nouveautés arriveront dans les différentes interfaces et les modèles Codex, mais le cap reste le même : faire de l’agent moins un outil à surveiller en permanence qu’un coéquipier sur lequel vous pouvez compter pour les tâches de longue durée.
Pour essayer vous-même, commencez par ces ressources :