Donnez aux modèles accès à de nouvelles fonctionnalités et données pour leur permettre de suivre les instructions et de répondre aux prompts.
Responses
L’appel de fonction (également appelé appel d’outil) offre aux modèles OpenAI un moyen puissant et flexible d’interagir avec des systèmes externes et d’accéder à des données autres que leurs données d’entraînement. Ce guide vous montre comment connecter un modèle aux données et aux actions fournies par votre application. Nous verrons comment utiliser les outils de type fonction (définis par un schéma JSON) et les outils personnalisés, qui acceptent du texte libre en entrée et en sortie.
Pour les sessions de l’API Agents, utilisez les Fonctions pour enregistrer des fonctions et traiter les demandes d’action de la session. Les exemples de ce guide présentent les intégrations avec l’API Responses et Chat Completions.
Si votre application comporte de nombreuses fonctions ou des schémas volumineux, vous pouvez associer l’appel de fonction à la recherche d’outils pour différer le chargement des outils rarement utilisés et ne les charger que lorsque le modèle en a besoin. Seuls gpt-5.4 et les modèles ultérieurs prennent en charge tool_search.
GPT-6 Astra nécessite l’API Responses pour les appels d’outils. Les exemples Chat Completions
utilisent GPT-5.6 pour des raisons de compatibilité. Consultez le guide de
migration pour mettre à jour une intégration
existante.
Fonctionnement
Commençons par quelques termes clés liés aux appels d’outils. Une fois ce vocabulaire commun établi, nous vous montrerons comment procéder à l’aide d’exemples pratiques.
Une fonction ou un outil est, au sens général, une fonctionnalité que nous déclarons au modèle comme étant à sa disposition. Lorsqu’il génère une réponse à un prompt, le modèle peut déterminer qu’il a besoin des données ou des fonctionnalités d’un outil pour suivre les instructions du prompt.
Vous pourriez donner au modèle accès à des outils capables de :
Récupérer la météo du jour pour un lieu donné
Accéder aux informations du compte correspondant à un identifiant utilisateur donné
Effectuer des remboursements pour une commande perdue
Ou lui permettre d’obtenir toute autre information ou d’effectuer toute autre action souhaitée lorsqu’il répond à un prompt.
Lorsque nous envoyons au modèle une requête API contenant un prompt, nous pouvons y inclure une liste d’outils qu’il pourrait utiliser. Par exemple, pour lui permettre de répondre à des questions sur la météo actuelle dans un endroit du monde, nous pourrions lui donner accès à un outil get_weather qui prend location comme argument.
Un appel de fonction ou un appel d’outil est un type particulier de réponse que le modèle peut produire lorsqu’il analyse un prompt et détermine qu’il doit appeler l’un des outils mis à sa disposition pour en suivre les instructions.
Si le modèle reçoit un prompt comme « Quel temps fait-il à Paris ? » dans une requête API, il pourrait y répondre par un appel à l’outil get_weather, avec Paris comme valeur de l’argument location.
Un résultat d’appel de fonction ou un résultat d’appel d’outil est la réponse qu’un outil génère à partir des données d’entrée de l’appel d’outil du modèle. Ce résultat peut être du JSON structuré ou du texte brut et doit contenir une référence à un appel d’outil précis du modèle (identifié par call_id dans les exemples qui suivent).
Pour compléter notre exemple météo :
Le modèle a accès à un outilget_weather qui prend location comme argument.
En réponse à un prompt comme « Quel temps fait-il à Paris ? », le modèle renvoie un appel d’outil contenant un argument location dont la valeur est Paris
Le résultat de l’appel d’outil peut être un objet JSON (par exemple, {"temperature": "25", "unit": "C"}, indiquant une température actuelle de 25 degrés), le contenu d’une image ou le contenu d’un fichier.
Nous renvoyons ensuite au modèle la définition de l’outil, le prompt d’origine, l’appel d’outil du modèle et le résultat de cet appel pour obtenir enfin une réponse textuelle comme :
The weather in Paris today is 25C.
Une fonction est un type particulier d’outil, défini par un schéma JSON. La définition d’une fonction permet au modèle de transmettre des données à votre application, où votre code peut accéder à des données ou effectuer les actions suggérées par le modèle.
Outre les outils de type fonction, il existe des outils personnalisés (décrits dans ce guide) qui utilisent du texte libre en entrée et en sortie.
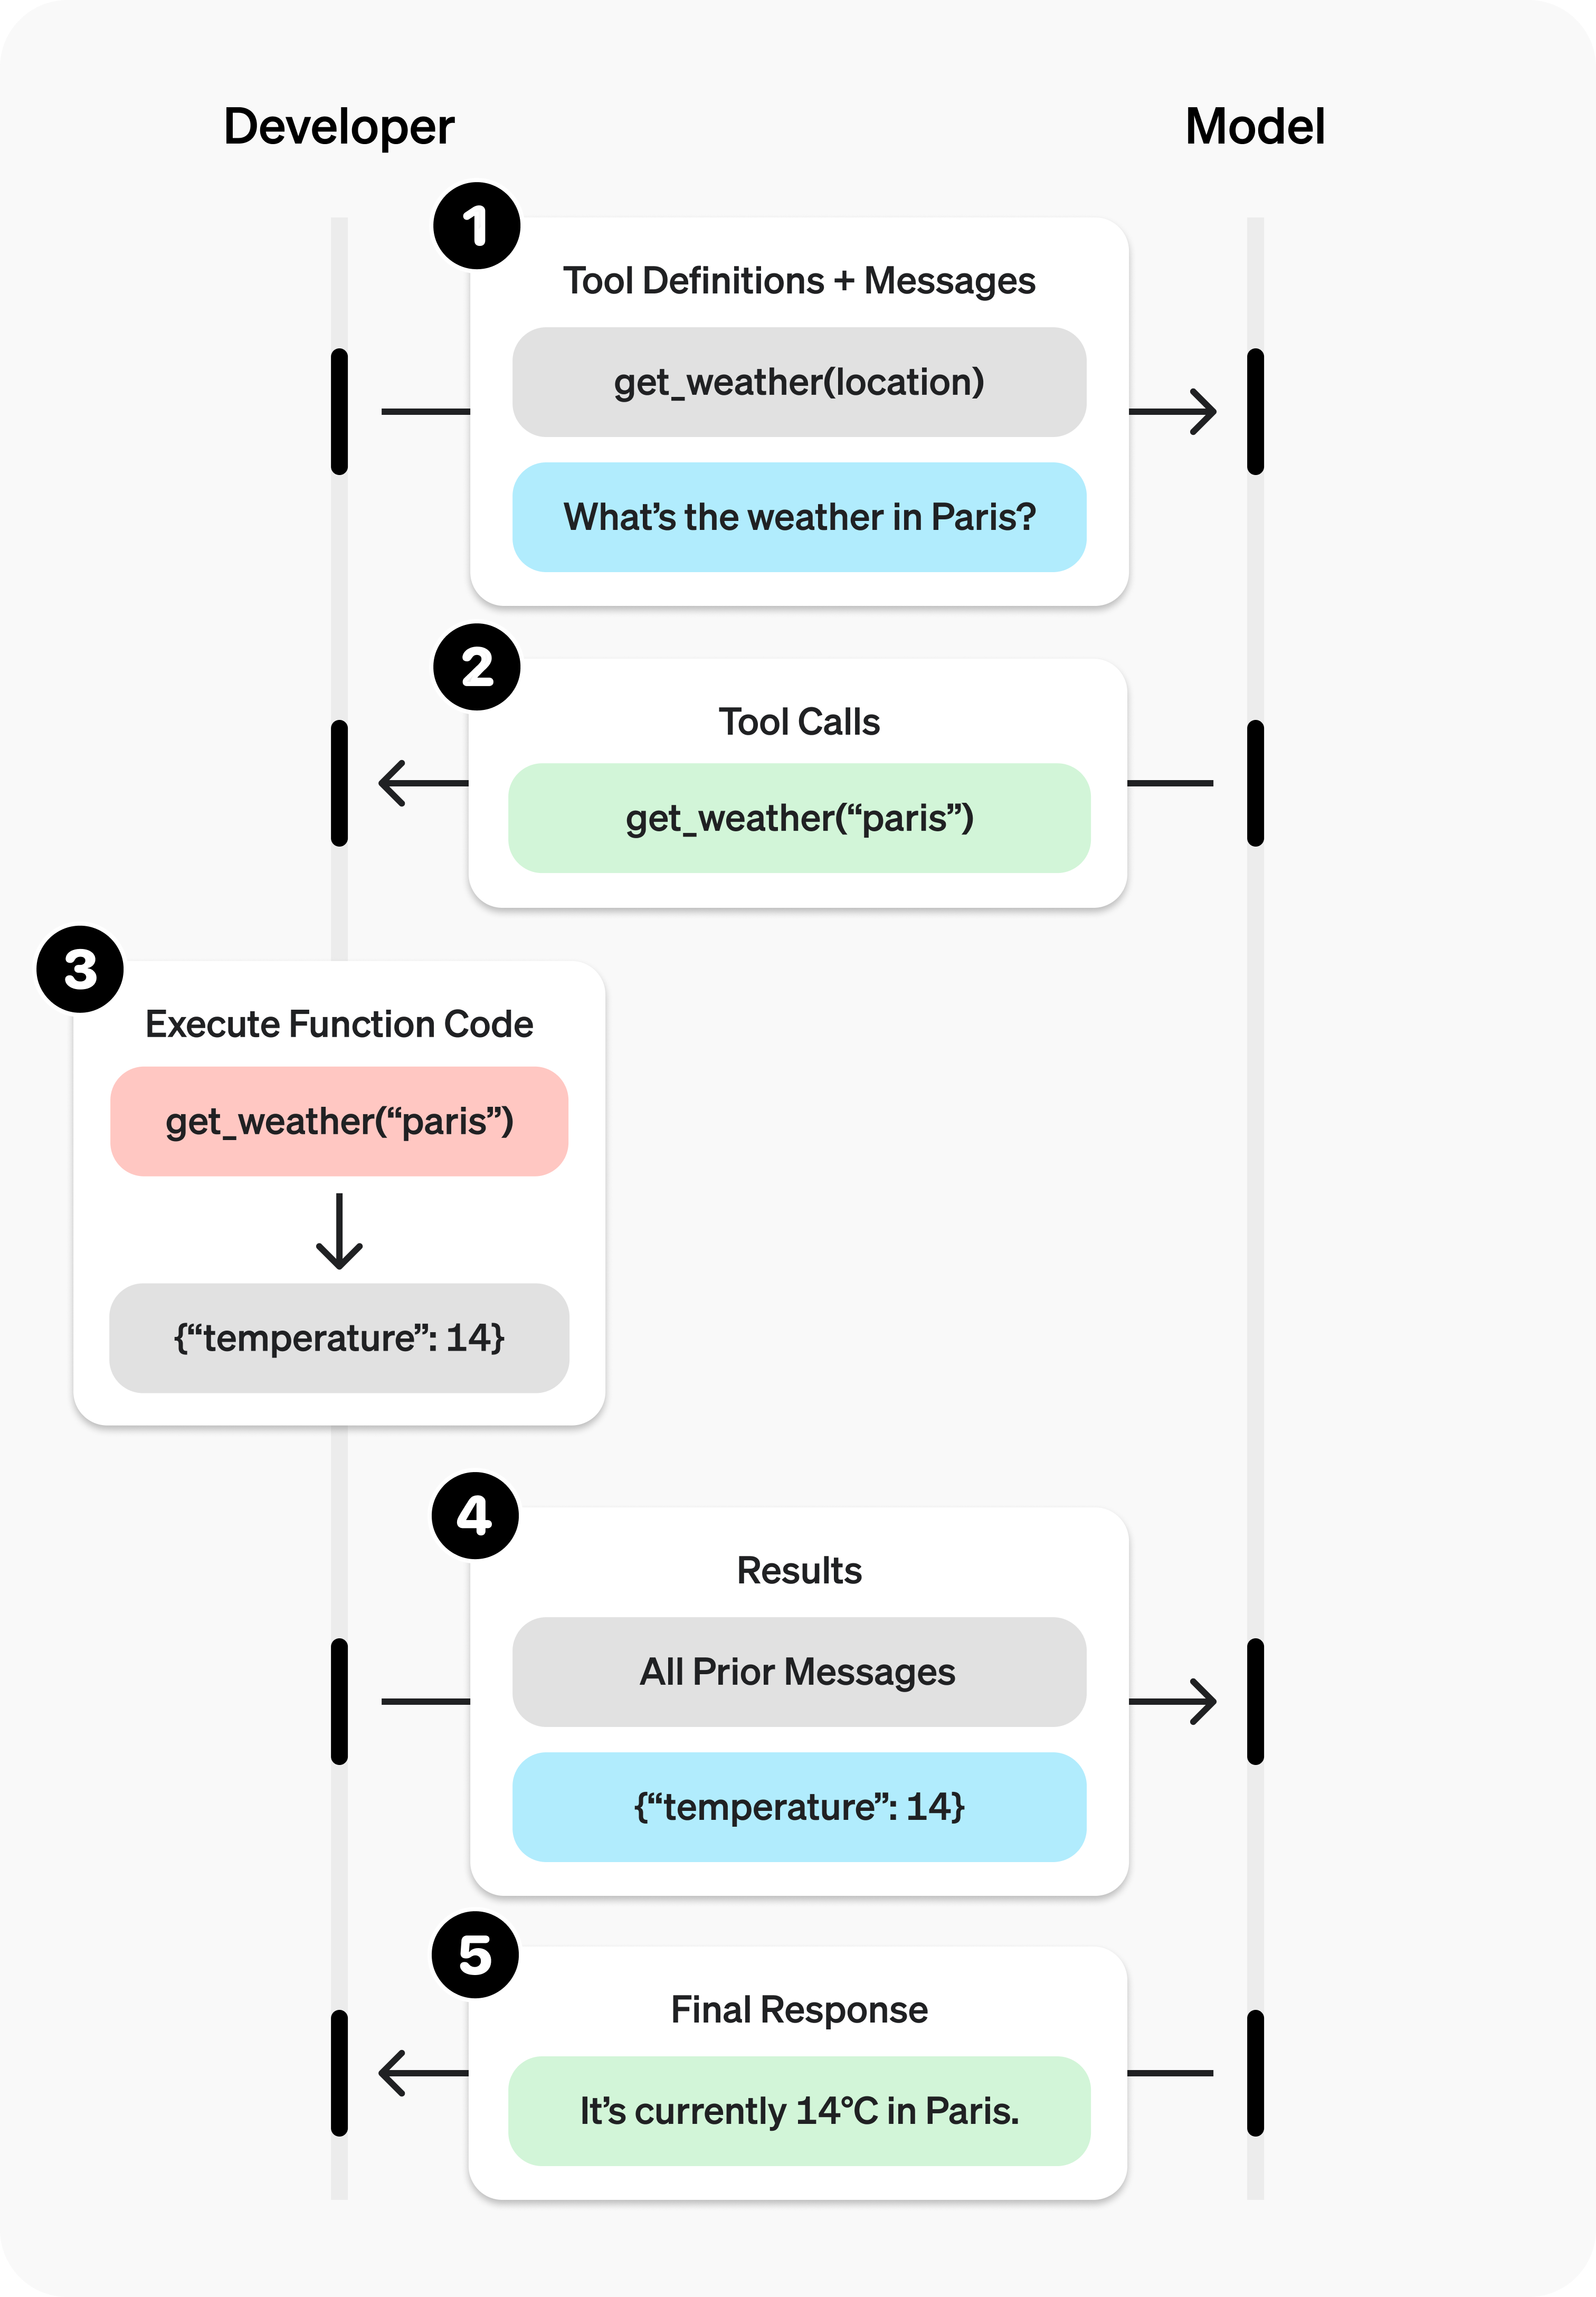
L’appel d’outil est une conversation en plusieurs étapes entre votre application et un modèle via l’API OpenAI. Il se déroule en cinq grandes étapes :
Envoyez une requête au modèle avec les outils qu’il pourrait appeler
Recevez un appel d’outil du modèle
Exécutez du code côté application avec les données d’entrée de l’appel d’outil
Envoyez une deuxième requête au modèle avec le résultat de l’outil
Recevez une réponse finale du modèle (ou d’autres appels d’outils)
Avec Responses, votre application peut poursuivre ce processus aussi longtemps que la tâche nécessite des appels d’outils. Si vous souhaitez un framework qui prend en charge les opérations d’orchestration récurrentes autour de cette boucle, consultez la comparaison entre l’API Responses et l’Agents SDK.
Exemple d’outil de type fonction
Voyons un exemple complet d’appel d’outil avec une fonction get_horoscope qui récupère l’horoscope du jour pour un signe astrologique.
Exemple complet d’appel d’outil
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70import OpenAI from "openai";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", function: { name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, }, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}const messages = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.chat.completions.create({ model: "gpt-5.6", messages, tools,});messages.push(response.choices[0].message);for (const toolCall of response.choices[0].message.tool_calls ?? []) { if (toolCall.type !== "function") continue; if (toolCall.function.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const args = JSON.parse(toolCall.function.arguments); const horoscope = getHoroscope(args.sign); // 4. Provide function call results to the model messages.push({ role: "tool", tool_call_id: toolCall.id, content: JSON.stringify({ horoscope }), }); }}response = await openai.chat.completions.create({ model: "gpt-5.6", messages, tools,});// 5. The model should be able to give a response!console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","function": {"name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, },"strict": True, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."messages = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.chat.completions.create(model="gpt-5.6",messages=messages,tools=tools,)messages.append(response.choices[0].message)for tool_call in response.choices[0].message.tool_calls or []:if tool_call.function.name =="get_horoscope":# 3. Execute the function logic for get_horoscope args = json.loads(tool_call.function.arguments) horoscope = get_horoscope(args["sign"])# 4. Provide function call results to the model messages.append( {"role": "tool","tool_call_id": tool_call.id,"content": json.dumps({"horoscope": horoscope}), } )response = client.chat.completions.create(model="gpt-5.6",messages=messages,tools=tools,)# 5. The model should be able to give a response!print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}// Create a running input list we will add to over timelet input = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.responses.create({ model: "gpt-6-astra", tools, input,});// Preserve model output for the next turninput.push(...toResponseInputItems(response.output));for (const item of response.output) { if (item.type !== "function_call") continue; if (item.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const { sign } = JSON.parse(item.arguments); const horoscope = getHoroscope(sign); // 4. Provide function call results to the model input.push({ type: "function_call_output", call_id: item.call_id, output: horoscope, }); }}console.log("Final input:");console.log(JSON.stringify(input, null, 2));response = await openai.responses.create({ model: "gpt-6-astra", instructions: "Respond only with a horoscope generated by a tool.", tools, input,});// 5. The model should be able to give a response!console.log("Final output:");console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"], }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."# Create a running input list we will add to over timeinput_list = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.responses.create(model="gpt-6-astra",tools=tools,input=input_list,)# Save function call outputs for subsequent requestsinput_list += response.outputfor item in response.output:if item.type =="function_call":if item.name =="get_horoscope":# 3. Execute the function logic for get_horoscope sign = json.loads(item.arguments)["sign"] horoscope = get_horoscope(sign)# 4. Provide function call results to the model input_list.append( {"type": "function_call_output","call_id": item.call_id,"output": horoscope, } )print("Final input:")print(input_list)response = client.responses.create(model="gpt-6-astra",instructions="Respond only with a horoscope generated by a tool.",tools=tools,input=input_list,)# 5. The model should be able to give a response!print("Final output:")print(response.model_dump_json(indent=2))print("\n"+ response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75package mainimport ( "context" "encoding/json" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() tool := horoscopeResponseTool() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("What is my horoscope? I am an Aquarius.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } var functionOutput responses.ResponseInputItemUnionParam for _, output := range response.Output { if output.Type != "function_call" { continue } call := output.AsFunctionCall() if call.Name != "get_horoscope" { continue } var arguments struct { Sign string `json:"sign"` } if err := json.Unmarshal([]byte(call.Arguments), &arguments); err != nil { panic(err) } functionOutput = responses.ResponseInputItemParamOfFunctionCallOutput(getHoroscope(arguments.Sign)) functionOutput.OfFunctionCallOutput.CallID = openai.String(call.CallID) } if functionOutput.OfFunctionCallOutput == nil { panic("the model did not call get_horoscope") } response, err = client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", PreviousResponseID: openai.String(response.ID), Instructions: openai.String("Respond only with a horoscope generated by a tool."), Input: responses.ResponseNewParamsInputUnion{OfInputItemList: responses.ResponseInputParam{functionOutput}}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}func horoscopeResponseTool() responses.ToolUnionParam { parameters := map[string]any{ "type": "object", "properties": map[string]any{ "sign": map[string]any{"type": "string", "description": "An astrological sign like Taurus or Aquarius"}, }, "required": []string{"sign"}, "additionalProperties": false, } tool := responses.ToolParamOfFunction("get_horoscope", parameters, true) tool.OfFunction.Description = openai.String("Get today's horoscope for an astrological sign.") return tool}func getHoroscope(sign string) string { return fmt.Sprintf("%s: Next Tuesday you will befriend a baby otter.", sign)}
Pour les modèles de raisonnement comme GPT-5 ou o4-mini, tous les éléments de raisonnement
renvoyés dans les réponses du modèle contenant des appels d’outils doivent également être retransmis avec les résultats
de ces appels.
Définition des fonctions
Les fonctions sont généralement déclarées dans le paramètre tools de chaque requête API. Avec la recherche d’outils, votre application peut également charger des fonctions de manière différée au cours de l’interaction. Dans les deux cas, chaque fonction appelable utilise la même structure de schéma. La définition d’une fonction comporte les propriétés suivantes :
Champ
Description
type
La valeur doit toujours être function
name
Le nom de la fonction (par exemple, get_weather)
description
Précisions sur les situations dans lesquelles utiliser la fonction et sur la manière de l’utiliser
parameters
Schéma JSON définissant les arguments d’entrée de la fonction
strict
Indique si le mode strict doit être imposé à l’appel de fonction
Voici un exemple de définition pour une fonction get_weather
12345678910111213141516171819202122{ "type": "function", "name": "get_weather", "description": "Retrieves current weather for the given location.", "parameters": { "type": "object", "properties": { "location": { "type": "string", "description": "City and country e.g. Bogotá, Colombia" }, "units": { "type": "string", "enum": ["celsius", "fahrenheit"], "description": "Units the temperature will be returned in." } }, "required": ["location", "units"], "additionalProperties": false }, "strict": true}
Comme parameters est défini par un schéma JSON, vous pouvez utiliser ses nombreuses fonctionnalités, notamment les types de propriétés, les énumérations, les descriptions, les objets imbriqués et les objets récursifs.
Définition des espaces de noms
Utilisez des espaces de noms pour regrouper les outils apparentés par domaine, comme crm, billing ou shipping. Les espaces de noms facilitent l’organisation d’outils similaires et sont particulièrement utiles lorsque le modèle doit choisir entre des outils destinés à des systèmes ou à des usages différents, par exemple un outil de recherche pour votre CRM et un autre pour votre système de gestion des tickets d’assistance.
Si vous devez donner au modèle accès à un vaste écosystème d’outils, vous pouvez différer le chargement de tout ou partie de ces outils avec tool_search. L’outil tool_search permet au modèle de rechercher des outils pertinents, de les ajouter à son contexte, puis de les utiliser. Seuls gpt-5.4 et les modèles ultérieurs le prennent en charge. Consultez le guide de la recherche d’outils pour en savoir plus.
Nous vous encourageons à définir directement les schémas de vos fonctions, mais nos SDK proposent des utilitaires pour convertir les objets pydantic et zod en schémas. Certaines fonctionnalités de pydantic et de zod ne sont pas prises en charge.
Définissez des objets pour représenter le schéma de la fonction
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from "openai";import { z } from "zod";import { zodFunction } from "openai/helpers/zod";const openai = new OpenAI();const GetWeatherParameters = z.object({ location: z.string().describe("City and country e.g. Bogotá, Colombia"),});const tools = [ zodFunction({ name: "getWeather", parameters: GetWeatherParameters }),];const messages = [ { role: "user", content: "What's the weather like in Paris today?" },];const response = await openai.chat.completions.create({ model: "gpt-5.6", messages, tools, store: true,});console.log(response.choices[0].message.tool_calls);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAI, pydantic_function_toolfrom pydantic import BaseModel, Fieldclient = OpenAI()classGetWeather(BaseModel): location: str= Field(..., description="City and country e.g. Bogotá, Colombia")tools = [pydantic_function_tool(GetWeather)]completion = client.chat.completions.create(model="gpt-5.6",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,)print(completion.choices[0].message.tool_calls)
Bonnes pratiques pour définir des fonctions
Choisissez des noms de fonctions clairs et rédigez des descriptions de paramètres et des instructions précises et détaillées.
Décrivez explicitement le rôle de la fonction et de chaque paramètre (ainsi que son format), et précisez ce que représente la sortie.
Utilisez le prompt système pour décrire quand utiliser chaque fonction et quand ne pas l’utiliser. De manière générale, indiquez au modèle exactement ce qu’il doit faire.
Incluez des exemples et des cas limites, notamment pour corriger les échecs récurrents. (Remarque : l’ajout d’exemples peut nuire aux performances des modèles de raisonnement.)
Pour les outils à chargement différé, placez les instructions détaillées dans la description de la fonction et gardez une description concise de l’espace de noms. L’espace de noms aide le modèle à choisir ce qu’il doit charger ; la description de la fonction l’aide à utiliser correctement l’outil chargé.
Utilisez des énumérations et la structure des objets pour empêcher les états invalides. Par exemple, toggle_light(on: bool, off: bool) autorise des appels invalides.
Passez le test du stagiaire. Un stagiaire, ou toute autre personne, peut-il utiliser correctement la fonction avec les seules informations fournies au modèle ? (Si ce n’est pas le cas, quelles questions vous pose-t-il ? Ajoutez les réponses au prompt.)
Allégez la charge du modèle en utilisant du code chaque fois que possible.
Ne demandez pas au modèle de renseigner des arguments dont vous connaissez déjà la valeur. Par exemple, si vous disposez déjà d’un order_id obtenu à partir d’un menu précédent, n’incluez pas de paramètre order_id. Définissez plutôt submit_refund() sans paramètres et transmettez order_id dans votre code.
Regroupez les fonctions qui sont toujours appelées l’une après l’autre. Par exemple, si vous appelez toujours mark_location() après query_location(), intégrez simplement la logique de marquage à la fonction de recherche.
Limitez le nombre de fonctions disponibles dès le départ pour améliorer la précision.
Évaluez les performances avec différents nombres de fonctions.
Visez moins de 20 fonctions disponibles au début de chaque tour , même s’il ne s’agit que d’une recommandation indicative.
Utilisez la recherche d’outils pour différer le chargement des ensembles d’outils volumineux ou rarement utilisés, au lieu de tout exposer dès le départ.
Utilisez les ressources d’OpenAI.
Générez des schémas de fonctions et améliorez-les progressivement dans le Playground.
Envisagez l’affinage pour améliorer la précision des appels de fonction lorsque les fonctions sont nombreuses ou les tâches difficiles. (Cookbook)
Utilisation des tokens
En interne, les fonctions sont injectées dans le message système selon une syntaxe sur laquelle le modèle a été entraîné. Les définitions des fonctions appelables sont donc prises en compte dans la limite de contexte du modèle et facturées comme des tokens d’entrée. Si vous atteignez les limites de tokens, nous vous conseillons de limiter le nombre de fonctions chargées dès le départ, de raccourcir les descriptions lorsque c’est possible ou d’utiliser la recherche d’outils pour ne charger les outils à chargement différé qu’en cas de besoin.
Vous pouvez également recourir à l’affinage pour réduire le nombre de tokens utilisés si votre spécification d’outils définit de nombreuses fonctions.
Gestion des appels de fonction
Lorsque le modèle appelle une fonction, vous devez l’exécuter et renvoyer le résultat. Comme les réponses du modèle peuvent contenir zéro, un ou plusieurs appels, il est recommandé de prévoir le cas où il y en a plusieurs.
La réponse contient un tableau tool_calls dont chaque élément comporte un id (utilisé ensuite pour transmettre le résultat de la fonction) et un objet function contenant un name et des arguments encodés en JSON.
Exemple de réponse contenant plusieurs appels de fonction
Le tableau output de la réponse contient une entrée dont le champ type a pour valeur function_call. Chaque entrée comporte un call_id (utilisé ensuite pour transmettre le résultat de la fonction), un name et des arguments encodés en JSON.
Exemple de réponse contenant plusieurs appels de fonction
Si vous utilisez la recherche d’outils, des éléments tool_search_call et tool_search_output peuvent également apparaître avant un function_call. Une fois la fonction chargée, traitez l’appel de fonction de la manière présentée ici.
Exécutez les appels de fonction et ajoutez les résultats
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def call_function(name, arguments) case name when "get_weather" FunctionCallingExample.get_weather( arguments.fetch("latitude"), arguments.fetch("longitude") ) when "send_email" FunctionCallingExample.send_email( arguments.fetch("to"), arguments.fetch("body") ) else raise ArgumentError, "Unknown function: #{name}" endend
Format des résultats
Le résultat transmis dans le message function_call_output devrait généralement être une chaîne de caractères, dont vous choisissez le format (JSON, codes d’erreur, texte brut, etc.). Le modèle interprétera cette chaîne selon les besoins.
Pour les fonctions qui renvoient des images ou des fichiers, vous pouvez transmettre un tableau d’objets image ou fichier au lieu d’une chaîne de caractères.
Si votre fonction ne renvoie aucune valeur (par exemple, send_email), renvoyez une chaîne de caractères qui indique la réussite ou l’échec, comme "success".
Intégration des résultats à la réponse
Après avoir ajouté les résultats à messages, vous pouvez les renvoyer au modèle pour obtenir une réponse finale.
"It's about 15°C in Paris, 18°C in Bogotá, and I've sent that email to Bob."
Configurations supplémentaires
Choix des outils
Par défaut, le modèle détermine quand utiliser des outils et combien en utiliser. Vous pouvez imposer un comportement précis avec le paramètre tool_choice.
Automatique : (Par défaut) Appelez zéro, une ou plusieurs fonctions. tool_choice: "auto"
Obligatoire : Appelez une ou plusieurs fonctions.
tool_choice: "required"
Fonction imposée : Appelez exactement une fonction précise.
tool_choice: {"type": "function", "name": "get_weather"}
Outils autorisés : Limitez les appels d’outils que le modèle peut effectuer à un sous-ensemble
des outils à sa disposition.
Quand utiliser allowed_tools
Vous pouvez configurer une liste allowed_tools pour ne rendre disponible
qu’un sous-ensemble d’outils au fil des requêtes au modèle, sans modifier la liste d’outils transmise, afin de maximiser les économies réalisées grâce à la mise en cache des prompts.
Vous pouvez également définir tool_choice sur "none" pour obtenir le même comportement que si vous ne transmettiez aucune fonction.
Lorsque vous utilisez la recherche d’outils, tool_choice s’applique toujours aux outils qui peuvent être appelés à ce stade du tour. C’est particulièrement utile après avoir chargé un sous-ensemble d’outils, lorsque vous souhaitez limiter le modèle à ce sous-ensemble.
Appels de fonction en parallèle
Sur les modèles compatibles à partir de GPT-5, les fonctions peuvent être appelées en parallèle
lorsque des outils intégrés sont également disponibles. Les outils intégrés
ne peuvent pas être inclus dans un lot d’appels de fonction en parallèle.
Le modèle peut choisir d’appeler plusieurs fonctions au cours d’un même tour. Vous pouvez l’en empêcher en définissant parallel_tool_calls sur false, ce qui garantit qu’aucun outil ou un seul outil sera appelé.
Remarque : Actuellement, si vous utilisez un modèle affiné et que celui-ci appelle plusieurs fonctions au cours d’un même tour, le mode strict sera désactivé pour ces appels.
Remarque concernant gpt-4.1-nano-2025-04-14 : Cette version de gpt-4.1-nano peut parfois inclure plusieurs appels au même outil si les appels d’outils en parallèle sont activés. Il est recommandé de désactiver cette fonctionnalité lorsque vous utilisez cette version.
Mode strict
Définir strict sur true garantit que les appels de fonction respectent le schéma de la fonction, au lieu de simplement tenter de s’y conformer. Nous recommandons de toujours activer le mode strict.
Le mode strict s’appuie sur notre fonctionnalité de sorties structurées et impose donc quelques exigences :
additionalProperties doit être défini sur false pour chaque objet dans parameters.
Tous les champs de properties doivent être marqués comme required.
Vous pouvez indiquer qu’un champ est facultatif en ajoutant null parmi les options de type (voir l’exemple ci-dessous).
Si vous transmettez strict: true et que votre schéma ne respecte pas les exigences ci-dessus,
la requête sera rejetée avec des précisions sur les contraintes manquantes. Si
vous omettez strict, le comportement par défaut dépend de l’API : les requêtes Responses
tentent de normaliser votre schéma pour le rendre conforme au mode strict lorsque c’est possible, et reviennent
à des appels de fonction non stricts, sans garantie de conformité, si le schéma ne peut pas être rendu
compatible avec le mode strict. Dans ce cas, l’outil présent dans la réponse affichera
strict: false. Les requêtes Chat Completions restent non strictes par défaut. Pour désactiver
le mode strict dans Responses et conserver des appels de fonction non stricts,
sans garantie de conformité, définissez explicitement strict: false.
Mode strict activé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false } }}
Mode strict désactivé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], } }}
Mode strict activé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false }}
Mode strict désactivé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], }}
Le mode strict est activé pour tous les schémas générés dans le
Playground.
Bien que nous recommandions d’activer le mode strict, celui-ci présente quelques limites :
Certaines fonctionnalités de JSON Schema ne sont pas prises en charge. (Consultez les schémas pris en charge.)
Pour les modèles affinés en particulier :
Les schémas font l’objet d’un traitement supplémentaire lors de la première requête, puis sont mis en cache. Si vos schémas varient d’une requête à l’autre, cela peut augmenter la latence.
Le streaming permet de montrer la progression en indiquant quelle fonction est appelée pendant que le modèle renseigne ses arguments, voire en affichant les arguments en temps réel.
Le streaming des appels de fonction ressemble beaucoup à celui des réponses classiques : vous définissez stream sur true et recevez des fragments contenant des objets delta.
Streaming des appels de fonction
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40import { OpenAI } from "openai";const openai = new OpenAI();const tools = [ { type: "function", function: { name: "get_weather", description: "Get current temperature for a given location.", parameters: { type: "object", properties: { location: { type: "string", description: "City and country e.g. Bogotá, Colombia", }, }, required: ["location"], additionalProperties: false, }, strict: true, }, },];const stream = await openai.chat.completions.create({ model: "gpt-5.6", messages: [ { role: "user", content: "What's the weather like in Paris today?" }, ], tools, stream: true, store: true,});for await (const chunk of stream) { const delta = chunk.choices[0].delta; console.log(delta.tool_calls);}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()tools = [ {"type": "function","function": {"name": "get_weather","description": "Get current temperature for a given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia", } },"required": ["location"],"additionalProperties": False, },"strict": True, }, }]stream = client.chat.completions.create(model="gpt-5.6",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,stream=True,)for chunk in stream: delta = chunk.choices[0].deltaprint(delta.tool_calls)
Cependant, au lieu d’assembler les fragments pour former une seule chaîne content, vous les assemblez pour former un objet JSON arguments encodé.
Lorsque le modèle appelle une ou plusieurs fonctions, le champ tool_calls de chaque delta est renseigné. Chaque tool_call contient les champs suivants :
Champ
Description
index
Indique à quel appel de fonction le delta correspond
id
Identifiant de l’appel d’outil.
function
Delta de l’appel de fonction (name et arguments)
type
Type de tool_call (toujours function pour les appels de fonction)
De nombreux champs, comme id, function.name et type, ne sont renseignés que dans le premier delta de chaque appel d’outil.
L’extrait de code ci-dessous montre comment agréger les éléments delta dans un objet tool_calls final.
Le streaming permet de suivre la progression en indiquant quelle fonction est appelée à mesure que le modèle renseigne ses arguments, et même en affichant ces arguments en temps réel.
Le streaming des appels de fonction fonctionne de manière très similaire à celui des réponses classiques : définissez stream sur true pour recevoir différents objets event.
Cependant, au lieu d’agréger les fragments dans une seule chaîne content, vous les agrégez dans un objet arguments encodé en JSON.
Lorsque le modèle appelle une ou plusieurs fonctions, un événement de type response.output_item.added est émis pour chaque appel de fonction. Cet événement contient les champs suivants :
Champ
Description
response_id
L’identifiant de la réponse à laquelle appartient l’appel de fonction
output_index
L’index de l’élément de sortie dans la réponse. Il permet de distinguer les différents appels de fonction de la réponse.
item
L’élément d’appel de fonction en cours, qui comprend les champs name, arguments et id
Vous recevez ensuite une série d’événements de type response.function_call_arguments.delta, qui contiennent le delta du champ arguments. Ces événements contiennent les champs suivants :
Champ
Description
response_id
L’identifiant de la réponse à laquelle appartient l’appel de fonction
item_id
L’identifiant de l’élément d’appel de fonction auquel appartient le delta
output_index
L’index de l’élément de sortie dans la réponse. Il permet de distinguer les différents appels de fonction de la réponse.
delta
Le delta du champ arguments.
L’extrait de code ci-dessous montre comment agréger les éléments delta dans un objet tool_call final.
Lorsque le modèle a terminé les appels de fonction, un événement de type response.function_call_arguments.done est émis. Cet événement contient l’intégralité de l’appel de fonction, avec les champs suivants :
Champ
Description
response_id
L’identifiant de la réponse à laquelle appartient l’appel de fonction
output_index
L’index de l’élément de sortie dans la réponse. Il permet de distinguer les différents appels de fonction de la réponse.
item
L’élément d’appel de fonction, qui comprend les champs name, arguments et id.
Outils personnalisés
Les outils personnalisés fonctionnent de manière très similaire aux outils de type fonction définis par un schéma JSON. Toutefois, au lieu de recevoir des instructions explicites sur les données d’entrée requises par votre outil, le modèle peut lui transmettre une chaîne de caractères quelconque en entrée. Cela permet d’éviter d’encapsuler inutilement une réponse dans du JSON ou d’appliquer une grammaire personnalisée à la réponse (voir ci-dessous).
L’exemple de code suivant montre comment créer un outil personnalisé qui attend en réponse une chaîne de texte contenant du code Python.
Exemple d’appel d’outil personnalisé
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the code_exec tool to print hello world to the console.", tools: [ { type: "custom", name: "code_exec", description: "Executes arbitrary Python code.", }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Use the code_exec tool to print hello world to the console.",tools=[ {"type": "custom","name": "code_exec","description": "Executes arbitrary Python code.", } ],)print(response.output)
Comme précédemment, le tableau output contient un appel d’outil généré par le modèle. Cette fois, toutefois, les données d’entrée de l’appel d’outil sont fournies en texte brut.
Une grammaire non contextuelle (CFG) est un ensemble de règles qui définissent comment produire du texte valide dans un format donné. Pour un outil personnalisé, vous pouvez fournir une CFG qui contraint le texte que le modèle lui transmet en entrée.
Vous pouvez fournir une CFG personnalisée à l’aide du paramètre grammar lors de la configuration d’un outil personnalisé. Nous prenons actuellement en charge deux syntaxes de CFG pour définir les grammaires : lark et regex.
Les grammaires sont définies à l’aide d’une variante de Lark. L’échantillonnage du modèle est contraint à l’aide de LLGuidance. Certaines fonctionnalités de Lark ne sont pas prises en charge :
Assertions avant et arrière dans les expressions régulières de l’analyseur lexical
Quantificateurs non gourmands (*?, +?, ??) dans les expressions régulières de l’analyseur lexical
Priorités des terminaux
Gabarits
Imports (autres que l’import intégré %import common)
Directives %declare
Nous vous recommandons d’utiliser Lark IDE pour expérimenter avec des grammaires personnalisées.
Limitez la complexité de la grammaire
Limitez votre grammaire aux règles et aux motifs dont votre outil a besoin. L’API OpenAI peut renvoyer une erreur si la grammaire est trop complexe. Vérifiez donc que la grammaire souhaitée est compatible avant de l’utiliser dans l’API.
La mise au point des grammaires Lark peut être délicate. Les grammaires les plus simples offrent le fonctionnement le plus fiable. Les grammaires complexes nécessitent souvent des ajustements successifs de leur définition, du prompt et de la description de l’outil pour éviter que le modèle ne se retrouve hors distribution.
Ne faites PAS ceci (répartition entre plusieurs règles ou terminaux). Cette approche tente de laisser les règles répartir le texte libre entre les terminaux. L’analyseur lexical reconnaîtra les portions de texte libre de manière gloutonne et vous perdrez le contrôle :
Les règles en minuscules n’influencent pas le découpage de l’entrée en terminaux : seules les définitions des terminaux le font. Lorsque vous avez besoin de « texte libre entre des ancres », regroupez l’ensemble dans un seul terminal défini par une expression régulière, afin que l’analyseur lexical le reconnaisse en une seule fois, avec la structure voulue.
Terminaux et règles
Lark utilise des terminaux pour les tokens de l’analyseur lexical (par convention, UPPERCASE) et des règles pour les productions de l’analyseur syntaxique (par convention, lowercase). Pour rester dans le sous-ensemble pris en charge et éviter les surprises, le plus pratique est de garder une grammaire explicite, d’éviter toute complexité inutile et de séparer clairement les rôles des terminaux et des règles.
L’analyseur lexical s’exécute avant l’analyseur syntaxique
L’analyseur lexical reconnaît les terminaux de manière gloutonne (la correspondance la plus longue l’emporte) avant l’application de toute logique des règles de la CFG. Si vous essayez de « façonner » un terminal en le répartissant entre plusieurs règles, celles-ci ne pourront pas guider l’analyseur lexical : seules les expressions régulières des terminaux le peuvent.
Privilégiez un seul terminal pour extraire du texte à partir de portions de texte libre
Si vous devez reconnaître un motif au sein d’un texte quelconque (par exemple, du langage naturel avec « n’importe quoi » entre les ancres), exprimez-le dans un seul terminal. N’essayez pas d’alterner des terminaux de texte libre et des règles de l’analyseur syntaxique : l’analyseur lexical glouton ne respectera pas les limites prévues et le modèle risque fortement de se retrouver hors distribution.
Utilisez les règles pour combiner des tokens distincts
Les règles sont idéales pour combiner des terminaux explicitement délimités (nombres, mots-clés, ponctuation) en structures plus grandes. Elles ne conviennent pas pour contraindre « ce qui se trouve entre » deux terminaux.
Définissez des terminaux ciblés, bornés et autonomes
Privilégiez les classes de caractères explicites et les quantificateurs bornés ({0,10}, plutôt que des * non bornés partout). Si vous avez besoin de reconnaître « n’importe quel texte jusqu’à un point », préférez une expression comme /[^.\n]{0,10}*\./ à /.+\./ pour éviter une croissance incontrôlée.
Utilisez les règles pour combiner les tokens, pas pour piloter le fonctionnement interne des expressions régulières
Exemple de bonne utilisation des règles :
start: exprNUMBER: /[0-9]+/PLUS: "+"MINUS: "-"expr: term (("+"|"-") term)*term: NUMBER
Traitez explicitement les caractères d’espacement
Ne vous appuyez pas sur des directives %ignore sans limites. Des directives d’exclusion non bornées peuvent rendre la grammaire trop complexe ou faire sortir le modèle de sa distribution, voire les deux. Insérez plutôt des terminaux explicites partout où les caractères d’espacement sont autorisés.
Dépannage
Si l’API rejette la grammaire parce qu’elle est trop complexe, simplifiez les règles et les terminaux et supprimez les directives %ignore non bornées.
Si les outils personnalisés sont appelés avec des tokens inattendus, vérifiez que les terminaux ne se chevauchent pas et examinez le comportement glouton de l’analyseur lexical.
Lorsque le modèle dérive « hors distribution » (il produit des sorties excessivement longues ou répétitives, syntaxiquement valides mais sémantiquement incorrectes) :
Rendez la grammaire plus restrictive.
Ajustez progressivement le prompt (ajoutez des exemples few-shot) et la description de l’outil (expliquez la grammaire et demandez au modèle de raisonner et de s’y conformer).
Essayez un effort de raisonnement supérieur (par exemple, passez du niveau Médium au niveau Élevé).
CFG à base d’expressions régulières
Exemple de grammaire hors contexte à base d’expressions régulières
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const grammar = "^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\\s+(?P<day>\\d{1,2})(?:st|nd|rd|th)?\\s+(?P<year>\\d{4})\\s+at\\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$";const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.", tools: [ { type: "custom", name: "timestamp", description: "Saves a timestamp in date + time in 24-hr format.", format: { type: "grammar", syntax: "regex", definition: grammar, }, }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23from openai import OpenAIclient = OpenAI()grammar =r"^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$"response = client.responses.create(model="gpt-6-astra",input="Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.",tools=[ {"type": "custom","name": "timestamp","description": "Saves a timestamp in date + time in 24-hr format.","format": {"type": "grammar","syntax": "regex","definition": grammar, }, } ],)print(response.output)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses" "github.com/openai/openai-go/v3/shared")func main() { client := openai.NewClient() grammar := `^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$` tool := responses.ToolParamOfCustom("timestamp") tool.OfCustom.Description = openai.String("Saves a timestamp in date and time format.") tool.OfCustom.Format = shared.CustomToolInputFormatParamOfGrammar(grammar, "regex") response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.Output)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.CustomToolInputFormat;import com.openai.models.responses.CustomTool;import com.openai.models.responses.ResponseCreateParams;String grammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) " + "\\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$";ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input("Use timestamp to save August 7th 2025 at 10AM.") .addTool( CustomTool.builder() .name("timestamp") .description("Saves a timestamp in date and time format.") .format( CustomToolInputFormat.Grammar.builder() .syntax(CustomToolInputFormat.Grammar.Syntax.REGEX) .definition(grammar) .build()) .build()) .build();client.responses().create(params).output().forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newgrammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) \\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$"response = client.responses.create( model: "gpt-6-astra", input: "Use timestamp to save August 7th 2025 at 10AM.", tools: [ { type: :custom, name: "timestamp", description: "Saves a timestamp in date and time format.", format: { type: :grammar, syntax: :regex, definition: grammar } } ])puts(response.output)
La sortie de l’outil devrait alors respecter la CFG à base d’expressions régulières que vous avez définie :
Certaines fonctionnalités des expressions régulières ne sont pas prises en charge :
Assertions avant et arrière
Quantificateurs non gloutons (*?, +?, ??)
Notions clés et bonnes pratiques
Le motif doit tenir sur une seule ligne
Pour reconnaître un saut de ligne dans l’entrée, utilisez la séquence d’échappement \n. N’utilisez pas le mode verbeux ou étendu, qui permet de répartir les motifs sur plusieurs lignes.
Fournissez l’expression régulière sous forme d’une simple chaîne contenant le motif