Apprenez à transformer du texte en nombres pour des cas d’utilisation comme la recherche.
New embedding models
text-embedding-3-small and text-embedding-3-large, our newest and most performant embedding models, are now available. They feature lower costs, higher multilingual performance, and new parameters to control the overall size.
Que sont les plongements vectoriels ?
Les plongements vectoriels de texte d’OpenAI mesurent la proximité entre des chaînes de texte. Ils sont couramment utilisés pour :
Rechercher (les résultats sont classés selon leur pertinence par rapport à une requête textuelle)
Regroupement (les chaînes de texte sont regroupées selon leur similarité)
Recommandations (les éléments associés à des chaînes de texte proches sont recommandés)
Détection d’anomalies (les éléments atypiques présentant peu de similarité avec les autres sont identifiés)
Mesure de la diversité (les distributions de similarité sont analysées)
Classification (les chaînes de texte sont classées selon l’étiquette qui leur est la plus similaire)
Un plongement vectoriel est un vecteur (une liste) de nombres à virgule flottante. La distance entre deux vecteurs mesure leur proximité. Une faible distance indique une forte proximité, tandis qu’une grande distance indique une faible proximité.
Consultez notre page des tarifs pour connaître les tarifs des plongements vectoriels. Les requêtes sont facturées selon le nombre de tokens dans l’entrée.
Comment obtenir des plongements vectoriels
Pour obtenir un plongement vectoriel, envoyez votre chaîne de texte au point de terminaison de l’API de plongements vectoriels en indiquant le nom du modèle de plongement vectoriel (par exemple, text-embedding-3-small) :
La réponse contient le vecteur du plongement (une liste de nombres à virgule flottante) ainsi que des métadonnées supplémentaires. Vous pouvez extraire ce vecteur, l’enregistrer dans une base de données vectorielle et l’utiliser dans de nombreux cas d’utilisation.
Par défaut, le vecteur du plongement comporte 1536 dimensions pour text-embedding-3-small ou 3072 pour text-embedding-3-large. Pour réduire le nombre de dimensions du plongement sans perdre sa capacité à représenter des concepts, fournissez le paramètre dimensions. Pour en savoir plus sur les dimensions des plongements vectoriels, consultez la section consacrée à leurs cas d’utilisation.
Modèles de plongement vectoriel
OpenAI propose deux puissants modèles de plongement vectoriel de troisième génération (identifiés par -3 dans l’identifiant du modèle). Pour en savoir plus, consultez l’article de blog annonçant les modèles de plongement vectoriel v3.
L’utilisation est facturée par token d’entrée. Le tableau ci-dessous illustre ces tarifs en indiquant le nombre de pages de texte traitées par dollar américain (en supposant environ 800 tokens par page) :
Le jeu de données contient au total 568 454 avis sur des produits alimentaires publiés par des utilisateurs d’Amazon jusqu’en octobre 2012. Pour ces exemples, nous utilisons un sous-ensemble des 1 000 avis les plus récents. Les avis sont en anglais et tendent à être positifs ou négatifs. Chaque avis comporte un ProductId, un UserId, un Score, un titre (Summary) et un corps de texte (Text). Par exemple :
Identifiant du produit
Identifiant de l’utilisateur
Note
Résumé
Texte
B001E4KFG0
A3SGXH7AUHU8GW
5
Nourriture pour chiens de bonne qualité
J’ai acheté plusieurs conserves Vitality...
B00813GRG4
A1D87F6ZCVE5NK
1
Non conforme à la description
Le produit est arrivé avec une étiquette indiquant « Cacahuètes salées géantes »...
Ci-dessous, nous réunissons le résumé et le texte de l’avis en un seul texte. Le modèle encode ce texte et produit un unique plongement vectoriel.
L’utilisation de plongements vectoriels de grande taille, par exemple pour les stocker dans une base vectorielle à des fins de récupération, coûte généralement plus cher et consomme davantage de ressources de calcul, de mémoire et de stockage que celle de plongements vectoriels plus petits.
Nos deux nouveaux modèles de plongement vectoriel ont été entraînés avec une technique qui permet aux développeurs de trouver un compromis entre les performances et le coût d’utilisation des plongements vectoriels. Plus précisément, les développeurs peuvent raccourcir les plongements vectoriels (c’est-à-dire supprimer des nombres à la fin de la séquence) sans qu’ils perdent leur capacité à représenter des concepts, en utilisant le paramètre d’API dimensions. Par exemple, sur le benchmark MTEB, un plongement vectoriel text-embedding-3-large peut être raccourci à une taille de 256 tout en restant plus performant qu’un plongement vectoriel text-embedding-ada-002 non raccourci de taille 1536. Pour en savoir plus sur l’effet du nombre de dimensions sur les performances, consultez notre article de blog consacré au lancement des modèles de plongement vectoriel v3.
En général, il est recommandé d’utiliser le paramètre dimensions lors de la création du plongement vectoriel. Dans certains cas, vous devrez peut-être modifier son nombre de dimensions après l’avoir généré. Si vous le modifiez manuellement, veillez à normaliser les dimensions du plongement vectoriel, comme illustré ci-dessous.
La modification dynamique du nombre de dimensions offre une grande souplesse d’utilisation. Par exemple, avec une base de données vectorielle qui ne prend en charge que les plongements vectoriels de 1024 dimensions au maximum, les développeurs peuvent désormais utiliser notre meilleur modèle de plongement vectoriel, text-embedding-3-large, en attribuant la valeur 1024 au paramètre d’API dimensions. Le plongement vectoriel passe alors de 3072 à 1024 dimensions, au prix d’une légère perte de précision en échange d’un vecteur plus petit.
Il arrive souvent que les données d’entraînement du modèle ne contiennent pas les faits et les informations essentiels que vous souhaitez lui fournir pour répondre aux requêtes des utilisateurs. Une solution consiste à ajouter des informations dans la fenêtre de contexte du modèle, comme illustré ci-dessous. Cette approche est efficace dans de nombreux cas d’utilisation, mais augmente le coût en tokens. Dans ce notebook, nous examinons les compromis entre cette approche et la recherche par plongements vectoriels.
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constclient=newOpenAI();constarticle="At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";constquestion=`Use the article below to answer the question. If the answer cannot be found, say "I don't know."Article:${article}Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;constresponse=await client.chat.completions.create({ model: "gpt-4.1-mini", messages: [ { role: "system", content: "You answer questions about the 2022 Winter Olympics.", }, { role: "user", content: question }, ], temperature: 0,});console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."Article:\"\"\"{wikipedia_article_on_curling}\"\"\"Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""response = client.chat.completions.create( messages=[ { "role": "system", "content": "You answer questions about the 2022 Winter Olympics.", }, {"role": "user", "content": query}, ], model=GPT_MODEL, temperature=0,)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";String question = "Use the below article on the 2022 Winter Olympics to answer the subsequent question. " + "If the answer cannot be found, write \"I don't know.\"\n\n" + "Article:\n" + article + "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";ChatCompletionCreateParams params = ChatCompletionCreateParams.builder() .model("gpt-4.1-mini") .addSystemMessage("You answer questions about the 2022 Winter Olympics.") .addUserMessage(question) .temperature(0) .build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"client = OpenAI::Client.newarticle = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."question = <<~QUESTION Use the article below to answer the question. If the answer cannot be found, say "I don't know." Article: #{article} Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?QUESTIONresponse = client.chat.completions.create( model: "gpt-4.1-mini", messages: [ { role: :system, content: "You answer questions about the 2022 Winter Olympics." }, { role: :user, content: question } ], temperature: 0)puts(response.choices.fetch(0).message.content)
Pour récupérer les documents les plus pertinents, nous calculons la similarité cosinus entre le plongement vectoriel de la requête et celui de chaque document, puis renvoyons les documents ayant obtenu les scores les plus élevés.
La recherche de code fonctionne de manière similaire à la recherche de texte par plongements vectoriels. Nous proposons une méthode pour extraire les fonctions Python de tous les fichiers Python d’un dépôt donné. Chaque fonction est ensuite indexée à l’aide du modèle text-embedding-3-small.
Pour effectuer une recherche de code, nous générons le plongement vectoriel de la requête en langage naturel à l’aide du même modèle. Nous calculons ensuite la similarité cosinus entre le plongement vectoriel obtenu et celui de chaque fonction. Les résultats dont la similarité cosinus est la plus élevée sont les plus pertinents.
Comme une distance plus faible entre deux plongements vectoriels indique une plus grande similarité, les plongements vectoriels peuvent être utiles pour formuler des recommandations.
Nous présentons ci-dessous un système de recommandation simple. Il prend en entrée une liste de chaînes de caractères et une chaîne « source », calcule leurs plongements vectoriels, puis renvoie les chaînes classées de la plus similaire à la moins similaire. À titre d’exemple concret, le notebook accessible ci-dessous applique une version de cette fonction au jeu de données AG news (réduit à un échantillon de 2 000 descriptions d’articles de presse) pour renvoyer les 5 articles les plus similaires à un article source donné.
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from"openai";constclient=newOpenAI();conststrings= ["A cheetah is a fast land animal.","A peregrine falcon is a fast bird.","A tortoise moves slowly.",];const { data } =await client.embeddings.create({ model: "text-embedding-3-small", input: strings,});constquery= data[0].embedding;constrecommendations= data .map(({ embedding }, index) => {constdotProduct= embedding.reduce( (total, value, dimension) => total + value * query[dimension],0 );constsimilarity= dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));return { index, text: strings[index], similarity }; }) .sort((left, right) => right.similarity - left.similarity);console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings( strings: list[str], index_of_source_string: int, model="text-embedding-3-small",) -> list[int]: """Return nearest neighbors of a given string.""" # get embeddings for all strings embeddings = [embedding_from_string(string, model=model) for string in strings] # get the embedding of the source string query_embedding = embeddings[index_of_source_string] # get distances between the source embedding and other embeddings (function from embeddings_utils.py) distances = distances_from_embeddings( query_embedding, embeddings, distance_metric="cosine" ) # get indices of nearest neighbors (function from embeddings_utils.py) indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances( distances ) return indices_of_nearest_neighbors
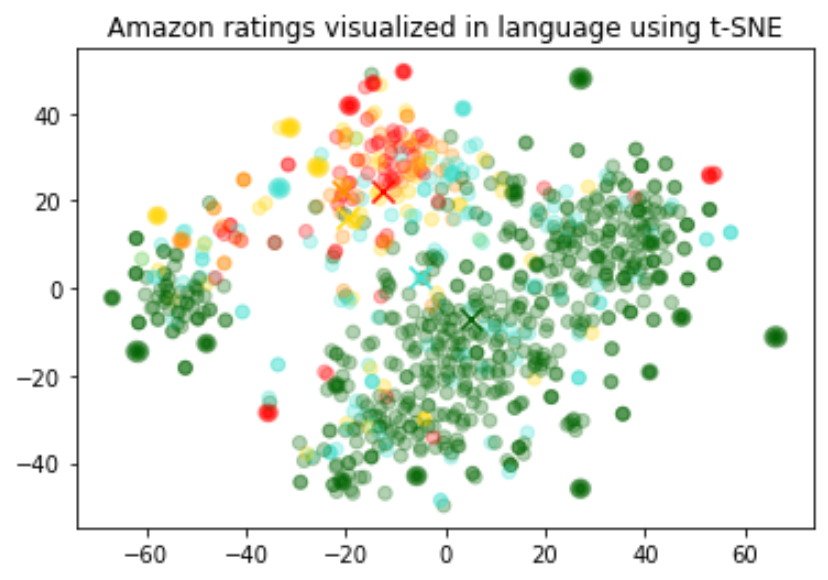
La taille des plongements vectoriels varie selon la complexité du modèle sous-jacent. Pour visualiser ces données de grande dimension, nous utilisons l’algorithme t-SNE afin de les ramener à deux dimensions.
Nous attribuons une couleur à chaque avis selon le nombre d’étoiles donné par son auteur :
1 étoile : rouge
2 étoiles : orange foncé
3 étoiles : doré
4 étoiles : turquoise
5 étoiles : vert foncé
La visualisation semble faire apparaître environ 3 groupes, dont un contient principalement des avis négatifs.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import numpy as npimport pandas as pdfrom sklearn.manifold importTSNEimport matplotlib.pyplot as pltimport matplotlibdf = pd.read_csv("output/embedded_1k_reviews.csv")matrix = np.array(df.ada_embedding.apply(eval).to_list())# Create a t-SNE model and transform the datatsne = TSNE(n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200)vis_dims = tsne.fit_transform(matrix)colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]x = [x for x, y in vis_dims]y = [y for x, y in vis_dims]color_indices = df.Score.values -1colormap = matplotlib.colors.ListedColormap(colors)plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)plt.title("Amazon ratings visualized in language using t-SNE")
Un plongement vectoriel peut servir d’encodeur général de caractéristiques issues de texte libre dans un modèle d’apprentissage automatique. L’intégration de plongements vectoriels améliore les performances de tout modèle d’apprentissage automatique dont certaines entrées pertinentes sont du texte libre. Un plongement vectoriel peut aussi servir à encoder des caractéristiques catégorielles dans un tel modèle. Cette approche est particulièrement utile lorsque les noms des variables catégorielles sont porteurs de sens et nombreux, comme les intitulés de poste. Pour cette tâche, les plongements vectoriels de similarité sont généralement plus performants que les plongements vectoriels de recherche.
Nous avons observé que les représentations par plongements vectoriels sont généralement très riches et denses en informations. Par exemple, réduire le nombre de dimensions des entrées à l’aide de SVD ou de PCA, même de 10 %, dégrade généralement les performances sur les tâches spécifiques effectuées en aval.
Ce code répartit les données entre un jeu d’entraînement et un jeu de test, qui seront utilisés dans les deux cas d’utilisation suivants : la régression et la classification.
Régression à partir des caractéristiques des plongements vectoriels
Les plongements vectoriels offrent une méthode élégante pour prédire une valeur numérique. Dans cet exemple, nous prédisons le nombre d’étoiles attribué par l’auteur d’un avis à partir du texte de celui-ci. Grâce à la richesse des informations sémantiques contenues dans les plongements vectoriels, la prédiction est satisfaisante même avec très peu d’avis.
Nous considérons la note comme une variable continue comprise entre 1 et 5, et autorisons l’algorithme à prédire n’importe quelle valeur à virgule flottante. L’algorithme d’apprentissage automatique minimise l’écart entre la valeur prédite et la note réelle, et atteint une erreur absolue moyenne de 0,39. Autrement dit, la prédiction s’écarte en moyenne de moins d’une demi-étoile de la note réelle.
Cette fois, au lieu de demander à l’algorithme de prédire une valeur quelconque entre 1 et 5, nous allons tenter de déterminer le nombre exact d’étoiles d’un avis en le classant dans l’une des 5 catégories allant de 1 à 5 étoiles.
Après l’entraînement, le modèle prédit beaucoup mieux les avis à 1 et à 5 étoiles que les avis plus nuancés (2 à 4 étoiles), probablement parce que les sentiments y sont exprimés de manière plus tranchée.
Nous pouvons utiliser les plongements vectoriels pour effectuer une classification zero-shot sans aucune donnée d’entraînement étiquetée. Pour chaque classe, nous générons un plongement vectoriel à partir de son nom ou d’une courte description. Pour classer un nouveau texte en zero-shot, nous comparons son plongement vectoriel à ceux de toutes les classes et prédisons la classe présentant la plus grande similarité.
Nous pouvons obtenir le plongement vectoriel d’un utilisateur en calculant la moyenne des plongements vectoriels de tous ses avis. De même, nous pouvons obtenir celui d’un produit en calculant la moyenne des plongements vectoriels de tous les avis sur ce produit. Pour illustrer l’intérêt de cette approche, nous utilisons un sous-ensemble de 50 000 avis afin de disposer de davantage d’avis par utilisateur et par produit.
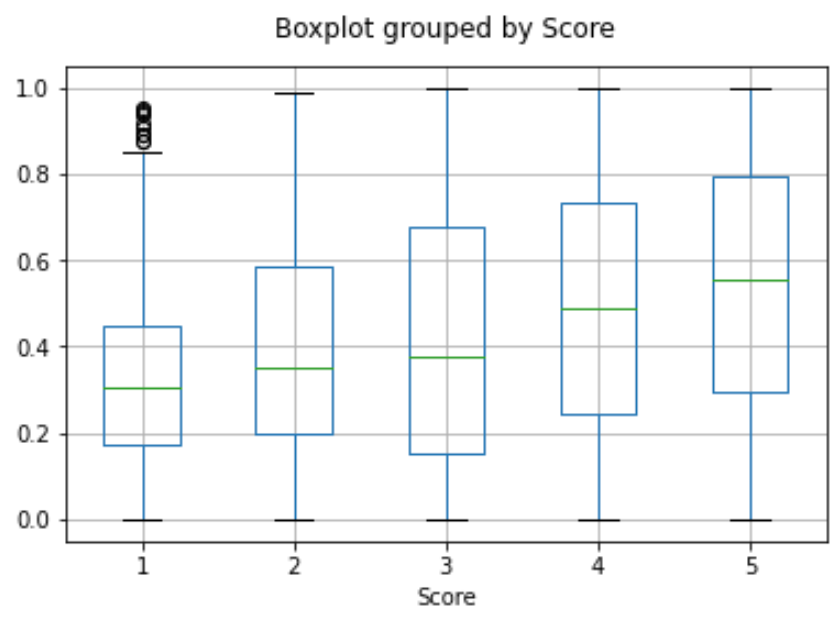
Nous évaluons l’utilité de ces plongements vectoriels sur un jeu de test distinct, en représentant la similarité entre le plongement vectoriel de l’utilisateur et celui du produit en fonction de la note. Fait intéressant, cette approche permet de prédire avec une précision supérieure au hasard si un produit plaira à un utilisateur, avant même qu’il ne le reçoive.
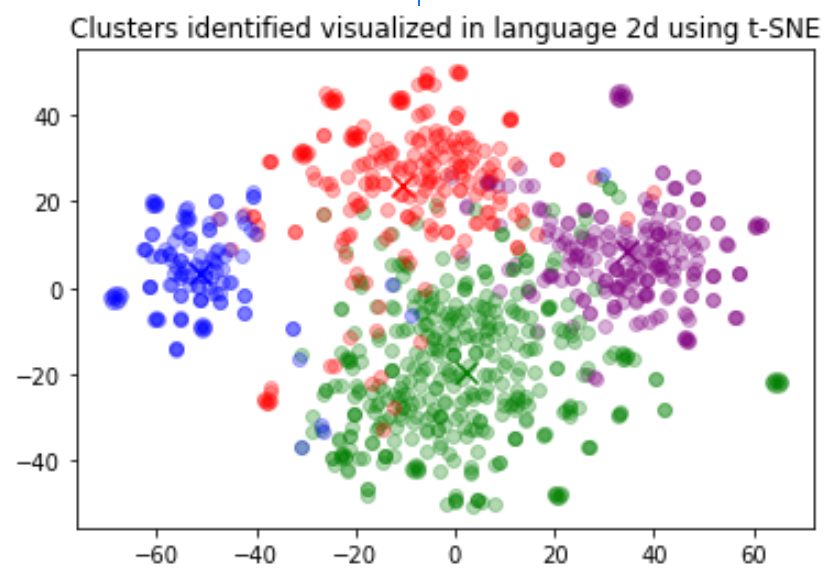
Le regroupement permet de dégager du sens à partir d’un grand volume de données textuelles. Les plongements vectoriels sont utiles pour cette tâche, car ils fournissent des représentations vectorielles qui reflètent le sens de chaque texte. Le regroupement peut ainsi révéler, de manière non supervisée, des groupes sous-jacents dans notre jeu de données.
Dans cet exemple, nous découvrons quatre groupes distincts : un consacré à la nourriture pour chiens, un aux avis négatifs et deux aux avis positifs.
Comment connaître le nombre de tokens d’une chaîne avant de créer son plongement vectoriel ?
En Python, vous pouvez découper une chaîne en tokens avec le tokeniseur tiktoken d’OpenAI.
Exemple de code :
1
2
3
4
5
6
7
8
9
10
11import tiktokendefnum_tokens_from_string(string: str, encoding_name: str) -> int:"""Returns the number of tokens in a text string.""" encoding = tiktoken.get_encoding(encoding_name) num_tokens =len(encoding.encode(string))return num_tokensnum_tokens_from_string("tiktoken is great!", "cl100k_base")
Pour les modèles de plongement vectoriel de troisième génération comme text-embedding-3-small, utilisez l’encodage cl100k_base.
Vous trouverez plus de détails et des exemples de code dans le guide du Cookbook OpenAI consacré au comptage des tokens avec tiktoken.
Comment récupérer rapidement les K vecteurs de plongement les plus proches ?
Pour effectuer des recherches rapides parmi de nombreux vecteurs, nous recommandons d’utiliser une base de données vectorielle. Vous trouverez des exemples d’utilisation de bases de données vectorielles avec l’API OpenAI dans notre Cookbook sur GitHub.
Quelle fonction de distance dois-je utiliser ?
Nous recommandons la similarité cosinus. Le choix de la fonction de distance a généralement peu d’importance.
Les plongements vectoriels d’OpenAI sont normalisés pour avoir une norme de 1, ce qui signifie que :
La similarité cosinus peut être calculée un peu plus rapidement à l’aide d’un simple produit scalaire
La similarité cosinus et la distance euclidienne donnent des classements identiques
Puis-je partager mes plongements vectoriels en ligne ?
Oui, les clients sont propriétaires des données qu’ils fournissent à nos modèles et des sorties qu’ils en obtiennent, y compris les plongements vectoriels. Il vous appartient de veiller à ce que le contenu que vous transmettez à notre API respecte la législation applicable et nos conditions d’utilisation.
Les modèles de plongement vectoriel V3 connaissent-ils les événements récents ?
Non, les modèles text-embedding-3-large et text-embedding-3-small n’ont pas connaissance des événements survenus après septembre 2021. Cette limite est généralement moins contraignante que pour les modèles de génération de texte, mais elle peut réduire les performances dans certains cas particuliers.