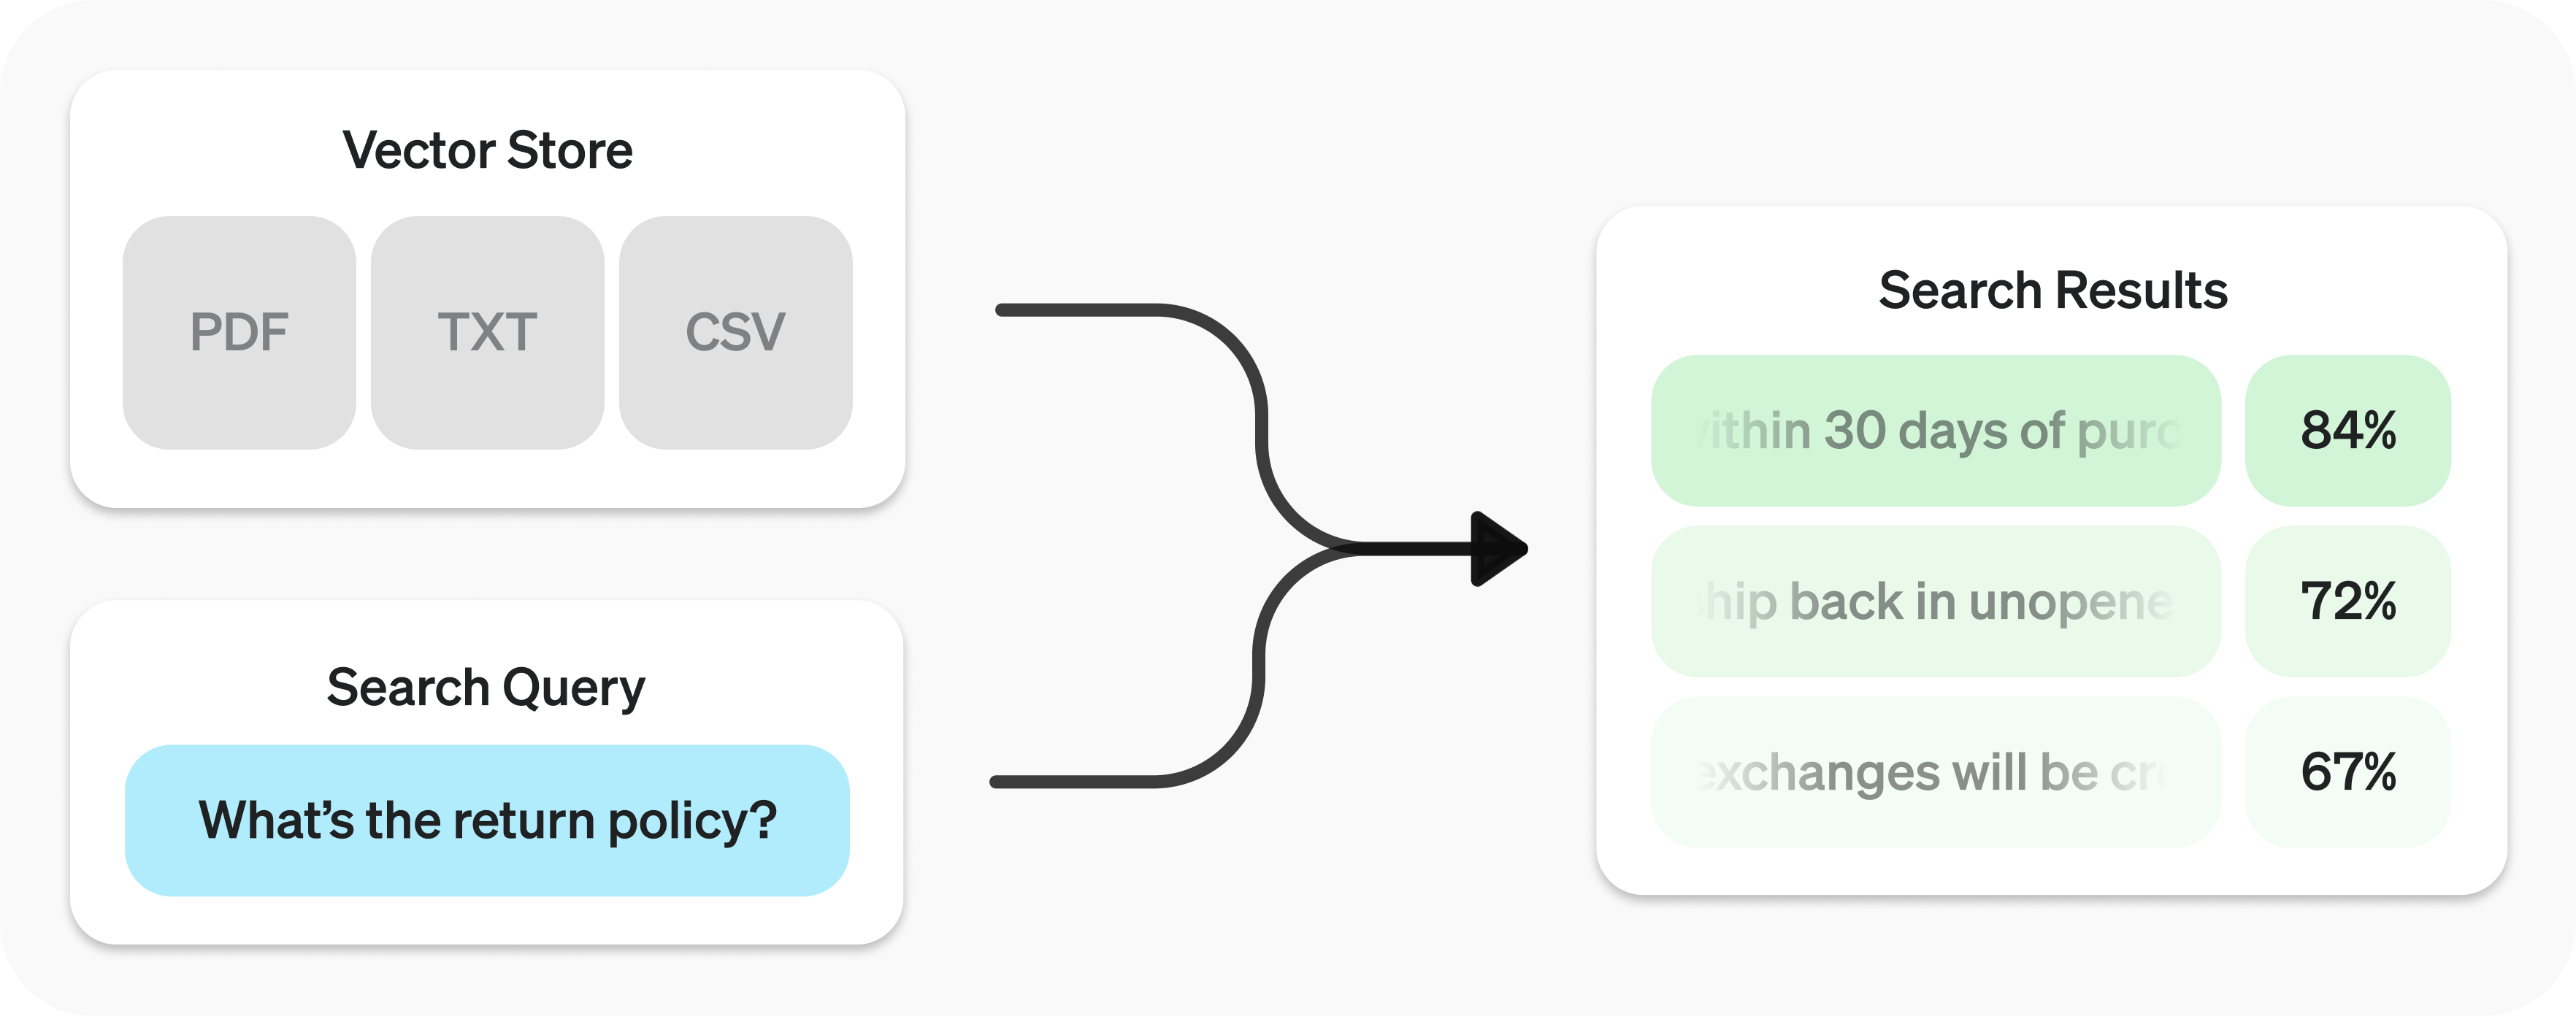
Recherchez dans vos données à l’aide de la similarité sémantique.
L’ API Retrieval vous permet d’effectuer une recherche sémantique dans vos données. Cette technique fait ressortir des résultats dont le sens est proche de votre requête, même s’ils ne partagent que peu ou pas de mots-clés avec elle. La récupération est utile en elle-même, mais devient particulièrement puissante lorsqu’elle est associée à nos modèles pour synthétiser des réponses.
L’API Retrieval s’appuie sur des bases vectorielles, qui servent d’index pour vos données. Ce guide explique comment effectuer une recherche sémantique et présente en détail les bases vectorielles.
Démarrage rapide
Créez une base vectorielle et importez des fichiers.
1
2
3
4
5require "openai"client = OpenAI::Client.newresults = client.vector_stores.search("vs_123", query: "What is the return policy?")puts(results.data&.first&.content)
Pour savoir comment utiliser les résultats avec nos modèles, consultez la section Synthèse des
réponses.
Recherche sémantique
La recherche sémantique est une technique qui utilise des plongements vectoriels pour faire ressortir des résultats pertinents sur le plan du sens. Elle permet notamment de trouver des résultats qui partagent peu ou pas de mots-clés avec la requête et que les techniques de recherche classiques pourraient manquer.
Examinons par exemple les résultats possibles pour "When did we go to the moon?" :
Texte
Similarité des mots-clés
Similarité sémantique
Le premier alunissage a eu lieu en juillet 1969.
0 %
65 %
Le premier homme sur la Lune était Neil Armstrong.
27 %
43 %
Quand j’ai mangé le gâteau de lune, je l’ai trouvé délicieux.
Remarquez que le résultat le plus pertinent ne contient aucun des mots de la requête de recherche. Cette souplesse fait de la recherche sémantique une technique puissante pour interroger des bases de connaissances de toute taille.
La recherche sémantique s’appuie sur des bases vectorielles, que nous présentons en détail plus loin dans ce guide. Cette section se concentre sur le fonctionnement de la recherche sémantique.
Effectuer une recherche sémantique
Vous pouvez interroger une base vectorielle à l’aide de la fonction search, en précisant une requête en langage naturel dans query. Vous obtenez une liste de résultats, chacun comprenant les segments pertinents, les scores de similarité et le fichier d’origine.
Requête de recherche
Python
1
2
3const results = await client.vectorStores.search(vector_store.id, { query: "How many woodchucks are allowed per passenger?",});
1
2
3
4results = client.vector_stores.search(vector_store_id=vector_store.id,query="How many woodchucks are allowed per passenger?",)
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "How many woodchucks are allowed per passenger?")puts(results.data&.first&.content)
Résultats
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42{"object": "vector_store.search_results.page","search_query": "How many woodchucks are allowed per passenger?","data": [ {"file_id": "file-12345","filename": "woodchuck_policy.txt","score": 0.85,"attributes": {"region": "North America","author": "Wildlife Department" },"content": [ {"type": "text","text": "According to the latest regulations, each passenger is allowed to carry up to two woodchucks." }, {"type": "text","text": "Ensure that the woodchucks are properly contained during transport." } ] }, {"file_id": "file-67890","filename": "transport_guidelines.txt","score": 0.75,"attributes": {"region": "North America","author": "Transport Authority" },"content": [ {"type": "text","text": "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks." } ] } ],"has_more": false,"next_page": null}
Par défaut, une réponse contient au maximum 10 résultats, mais vous pouvez porter cette limite à 50 à l’aide du paramètre max_num_results.
Reformulation des requêtes
Certaines formulations de requêtes donnent de meilleurs résultats. Nous proposons donc un paramètre qui reformule automatiquement vos requêtes pour optimiser les performances. Activez cette fonctionnalité en définissant rewrite_query=true lors d’un appel à search.
La requête reformulée sera disponible dans le champ search_query du résultat.
Requête d’origine
Requête reformulée
J’aimerais connaître la hauteur du bâtiment principal des bureaux.
hauteur bâtiment principal bureaux
Quelles sont les règles de sécurité pour le transport de matières dangereuses ?
règles de sécurité matières dangereuses
Comment déposer une réclamation concernant un problème de service ?
procédure de dépôt de réclamation service
Filtrage par attributs
Le filtrage par attributs permet d’affiner les résultats en appliquant des critères, par exemple en limitant les recherches à une plage de dates précise. Vous pouvez définir et combiner des critères dans attribute_filter pour sélectionner les fichiers selon leurs attributs avant d’effectuer la recherche sémantique.
Utilisez des filtres de comparaison pour comparer une clé key précise dans les attributes d’un fichier à une valeur value donnée, et des filtres composés pour combiner plusieurs filtres à l’aide de and et or.
Filtre de comparaison
1
2
3
4
5{"type": "eq"|"ne"|"gt"|"gte"|"lt"|"lte"|"in"|"nin", // comparison operators"key": "attributes_key", // attributes key"value": "target_value"// value to compare against}
Si les résultats de votre recherche de fichiers ne sont pas suffisamment pertinents, vous pouvez ajuster ranking_options pour améliorer la qualité des réponses. Vous pouvez notamment spécifier un ranker, comme auto ou default-2024-08-21, et définir un score_threshold compris entre 0.0 et 1.0. Une valeur plus élevée de score_threshold limite les résultats aux segments les plus pertinents, mais peut en exclure certains qui seraient utiles. Lorsque ranking_options.hybrid_search est fourni, vous pouvez également ajuster hybrid_search.embedding_weight (rrf_embedding_weight) et hybrid_search.text_weight (rrf_text_weight) pour contrôler l’équilibre, lors de la fusion par rangs réciproques, entre les correspondances sémantiques fondées sur les plongements vectoriels et les correspondances par mots-clés fondées sur des représentations creuses. Augmentez le premier poids pour privilégier la similarité sémantique, ou le second pour privilégier les éléments textuels communs, et veillez à ce qu’au moins un des poids soit supérieur à zéro.
Bases vectorielles
Les bases vectorielles sont les conteneurs sur lesquels repose la recherche sémantique de l’API Retrieval et de l’outil de recherche de fichiers. Lorsque vous ajoutez un fichier à une base vectorielle, il est automatiquement découpé en segments, converti en plongements vectoriels et indexé.
Les bases vectorielles contiennent des objets vector_store_file, qui s’appuient chacun sur un objet file.
Type d’objet
Description
file
Représente le contenu importé via l’API Files. Souvent utilisé avec les bases vectorielles, mais aussi pour l’affinage et d’autres cas d’utilisation.
vector_store
Conteneur de fichiers dans lesquels effectuer des recherches.
vector_store.file
Type enveloppe représentant spécifiquement un objet file découpé en segments, converti en plongements vectoriels et associé à un objet vector_store. Contient le dictionnaire attributes utilisé pour le filtrage.
Tarifs
La facturation dépend du stockage total utilisé par l’ensemble de vos bases vectorielles, calculé à partir de la taille des segments analysés et des plongements vectoriels correspondants.
Stockage
Coût
Jusqu’à 1 Go (toutes bases confondues)
Gratuit
Au-delà de 1 Go
0,10 $/Go/jour
Consultez les politiques d’expiration pour connaître les options permettant de réduire les coûts.
Opérations sur les fichiers d’une base vectorielle
Certaines opérations, comme create pour vector_store.file, sont asynchrones et peuvent prendre du temps. Utilisez nos fonctions utilitaires, comme create_and_poll, pour bloquer l’exécution jusqu’à leur achèvement. Vous pouvez aussi vérifier leur état. La suppression de fichiers d’une base vectorielle suit un modèle de cohérence à terme : les résultats de recherche peuvent donc encore inclure du contenu provenant d’un fichier supprimé pendant un court laps de temps.
Lors de la création d’un lot, vous pouvez soit fournir file_ids avec les paramètres facultatifs attributes et/ou chunking_strategy, soit utiliser le tableau files pour transmettre des objets contenant, pour chaque fichier, un file_id ainsi que les paramètres facultatifs attributes et chunking_strategy. Ces deux options sont mutuellement exclusives : vous pouvez ainsi choisir clairement entre des paramètres communs à tous les fichiers et des paramètres propres à chaque fichier.
Pour augmenter le débit d’ingestion dans une même base vectorielle, nous recommandons la création par lots dès que possible. Un lot peut inclure jusqu’à 500 fichiers dans une seule requête, ce qui réduit généralement la contention et la latence de bout en bout par rapport à l’envoi de nombreuses requêtes de création portant chacune sur un seul fichier.
Attributs
Chaque vector_store.file peut être associé à attributes, un dictionnaire de valeurs utilisables lors d’une recherche sémantique avec filtrage par attributs. Ce dictionnaire peut contenir au maximum 16 clés, chacune limitée à 256 caractères.
Créez un fichier avec des attributs dans une base vectorielle
Vous pouvez définir une politique d’expiration pour les objets vector_store à l’aide de expires_after. Lorsqu’une base vectorielle expire, tous les objets vector_store.file associés sont supprimés et ne vous sont plus facturés.
Définissez une politique d’expiration pour une base vectorielle
La taille maximale d’un fichier est de 512 Mo. Chaque fichier ne doit pas contenir plus de 5 000 000 de tokens (ce nombre est calculé automatiquement lorsque vous joignez un fichier).
Découpage en segments
Par défaut, max_chunk_size_tokens est défini sur 800 et chunk_overlap_tokens sur 400. Chaque fichier est donc indexé après avoir été découpé en segments de 800 tokens, avec un chevauchement de 400 tokens entre les segments consécutifs.
Vous pouvez ajuster ce découpage en définissant chunking_strategy lors de l’ajout de fichiers à la base vectorielle. Cette stratégie comporte certaines limites :
max_chunk_size_tokens doit être compris entre 100 et 4096 inclus.
chunk_overlap_tokens doit être supérieur ou égal à zéro et ne devrait pas dépasser max_chunk_size_tokens / 2.
Pour les types MIME text/, l’encodage doit être utf-8, utf-16 ou ascii.
Après avoir effectué une requête, vous souhaiterez peut-être formuler une réponse qui synthétise les résultats. Pour cela, vous pouvez fournir les résultats et la requête initiale à nos modèles afin d’obtenir une réponse ancrée dans ces résultats.
Effectuez une recherche pour obtenir des résultats
Python
1
2
3
4
5
6
7
8
9import OpenAI from "openai";const client = new OpenAI();const userQuery = "What is the return policy?";const results = await client.vectorStores.search(vector_store.id, { query: userQuery,});
1
2
3
4
5
6
7
8require "openai"client = OpenAI::Client.newresults = client.vector_stores.search( "vs_123", query: "What is the return policy?")puts(results.data)
Formulez une réponse à partir des résultats
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22const formattedResults = formatResults(results.data);// Join the text content of all resultsconst textSources = results.data .map((result) => result.content.map((c) => c.text).join("\n")) .join("\n");const completion = await client.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "developer", content: "Produce a concise answer to the query based on the provided sources.", }, { role: "user", content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`, }, ],});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20# Use results and user_query from the preceding search step.formatted_results = format_results(results.data)"\n".join("\n".join(c.text for c in result.content) for result in results.data)completion = client.chat.completions.create(model="gpt-6-astra",messages=[ {"role": "developer","content": "Produce a concise answer to the query based on the provided sources.", }, {"role": "user","content": f"Sources: {formatted_results}\n\nQuery: '{user_query}'", }, ],)print(completion.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46package mainimport ( "context" "fmt" "strings" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() userQuery := "What is the return policy?" results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{ Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)}, }) if err != nil { panic(err) } completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."), openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}func formatResults(results []openai.VectorStoreSearchResponse) string { var sources strings.Builder sources.WriteString("<sources>") for _, result := range results { fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename) for _, content := range result.Content { fmt.Fprintf(&sources, "<content>%s</content>", content.Text) } sources.WriteString("</result>") } sources.WriteString("</sources>") return sources.String()}