Découvrez comment gérer l’état de la conversation lors d’une interaction avec un modèle.
Responses
OpenAI propose plusieurs façons de gérer l’état de la conversation, ce qui permet de conserver les informations au fil des messages ou des échanges.
Si GPT-5.5 traite un message intermédiaire comme
la réponse finale, vérifiez que votre intégration conserve correctement le champ
phase du message de l’assistant. Consultez la section Paramètre
phase pour en savoir plus.
Gestion manuelle de l’état de la conversation
Même si chaque requête de génération de texte est indépendante et sans état, vous pouvez mettre en place des conversations à plusieurs tours en fournissant des messages supplémentaires comme paramètres de votre requête. Prenons l’exemple d’une blague « Toc toc » :
En alternant les messages user et assistant, vous transmettez l’état précédent d’une conversation au modèle en une seule requête.
Pour partager manuellement le contexte entre les réponses générées, reprenez la sortie de la réponse précédente du modèle comme entrée et ajoutez-la à votre requête suivante.
Pour les requêtes sans état adressées aux modèles de raisonnement, conservez chaque élément du tableau output de la réponse. L’API Responses renvoie par défaut des éléments de raisonnement chiffrés. Renvoyer la sortie complète permet de conserver intacts les éléments de raisonnement et les valeurs phase de l’assistant. Les modèles qui prennent en charge la persistance du raisonnement peuvent utiliser reasoning.context: "all_turns" pour intégrer le raisonnement disponible des tours précédents à la génération suivante. Consultez la section Conserver le raisonnement entre les appels.
Dans l’exemple suivant, nous demandons au modèle de raconter une blague, puis une autre. Ajouter ainsi les réponses précédentes aux nouvelles requêtes contribue à rendre les conversations naturelles et à préserver le contexte des interactions précédentes.
Gérez manuellement l’état de la conversation avec l’API Chat Completions.
Nos API facilitent la gestion automatique de l’état de la conversation : vous n’avez plus à transmettre manuellement les entrées à chaque tour.
Nous vous recommandons plutôt d’utiliser l’API Responses. Comme elle conserve l’état, un simple paramètre suffit pour gérer le contexte au fil des conversations.
Si vous utilisez le point de terminaison Chat Completions, vous devrez gérer l’état manuellement, comme indiqué ci-dessus.
Utilisation de l’API Conversations
L’API Conversations fonctionne avec l’API Responses pour conserver l’état de la conversation sous la forme d’un objet persistant doté de son propre identifiant durable. Une fois l’objet conversation créé, vous pouvez continuer à l’utiliser dans différentes sessions, sur différents appareils ou pour différents traitements.
Les conversations stockent des éléments qui peuvent être des messages, des appels d’outils, des sorties d’outils ou d’autres données.
Dans une interaction à plusieurs tours, vous pouvez transmettre conversation aux réponses suivantes pour conserver l’état et partager le contexte entre elles, sans avoir à chaîner plusieurs éléments de réponse.
Gérez l’état de la conversation avec les API Conversations et Responses
Python
1
2
3
4
5
6
7const response = await client.responses.create({ model: "gpt-6-astra", input: [{ role: "user", content: "What are the five Ds of dodgeball?" }], conversation: conversation.id,});console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(model="gpt-6-astra",input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],conversation=conversation.id,)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Conversation: responses.ResponseNewParamsConversationUnion{ OfString: openai.String(conversation.ID), }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("What are the five Ds of dodgeball?"), },})if err != nil { panic(err)}fmt.Println(response.OutputText())
1
2
3
4
5
6
7response = client.responses.create( model: "gpt-6-astra", conversation: conversation.id, input: "What are the five Ds of dodgeball?")puts(response.output_text)
Transmission du contexte de la réponse précédente
Une autre façon de gérer l’état de la conversation consiste à partager le contexte entre les réponses générées à l’aide du paramètre previous_response_id. Ce paramètre permet de chaîner les réponses et de créer un fil de conversation.
Chaînez les réponses d’un tour à l’autre en transmettant l’identifiant de la réponse précédente
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
Dans l’exemple suivant, nous demandons au modèle de raconter une blague. Dans une requête distincte, nous lui demandons d’expliquer pourquoi elle est drôle. Le modèle dispose alors de tout le contexte nécessaire pour fournir une réponse pertinente.
Gérez manuellement l’état de la conversation avec l’API Responses
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
previous_response_id en mode WebSocket
Si vous utilisez le mode WebSocket de l’API Responses, la poursuite de la conversation repose sur la même sémantique de previous_response_id qu’en mode HTTP, mais passe par un socket persistant avec des événements response.create répétés.
Le cache propre à la connexion conserve les réponses précédentes récentes en mémoire pour poursuivre la conversation avec une faible latence. Lorsque vous utilisez stream_id, chaque voie peut conserver sa dernière réponse ; previous_response_id détermine toujours la filiation des réponses. Une nouvelle voie peut donc forker à partir d’une réponse d’une autre voie tant que cette réponse reste disponible. Si un identifiant absent du cache ne peut pas être résolu, envoyez un nouveau tour avec previous_response_id défini sur null et transmettez l’intégralité du contexte d’entrée.
Les objets Response sont conservés pendant 30 jours par défaut. Vous pouvez les consulter sur la page
des journaux du tableau de bord ou les
récupérer via l’API.
Vous pouvez désactiver ce comportement en définissant store sur false
lors de la création d’un objet Response.
Les objets Conversation et les éléments qu’ils contiennent ne sont pas soumis à la durée de vie (TTL) de 30 jours. Les éléments de toute réponse rattachée à une conversation sont conservés sans cette limite de 30 jours.
OpenAI n’utilise pas les données envoyées via l’API pour entraîner ses modèles sans votre consentement explicite. En savoir plus.
Même lorsque vous utilisez previous_response_id, tous les tokens d’entrée précédents des réponses de la chaîne sont facturés comme tokens d’entrée dans l’API.
Gestion de la fenêtre de contexte
Comprendre les fenêtres de contexte vous aidera à créer des fils de conversation et à gérer l’état au fil des interactions avec le modèle.
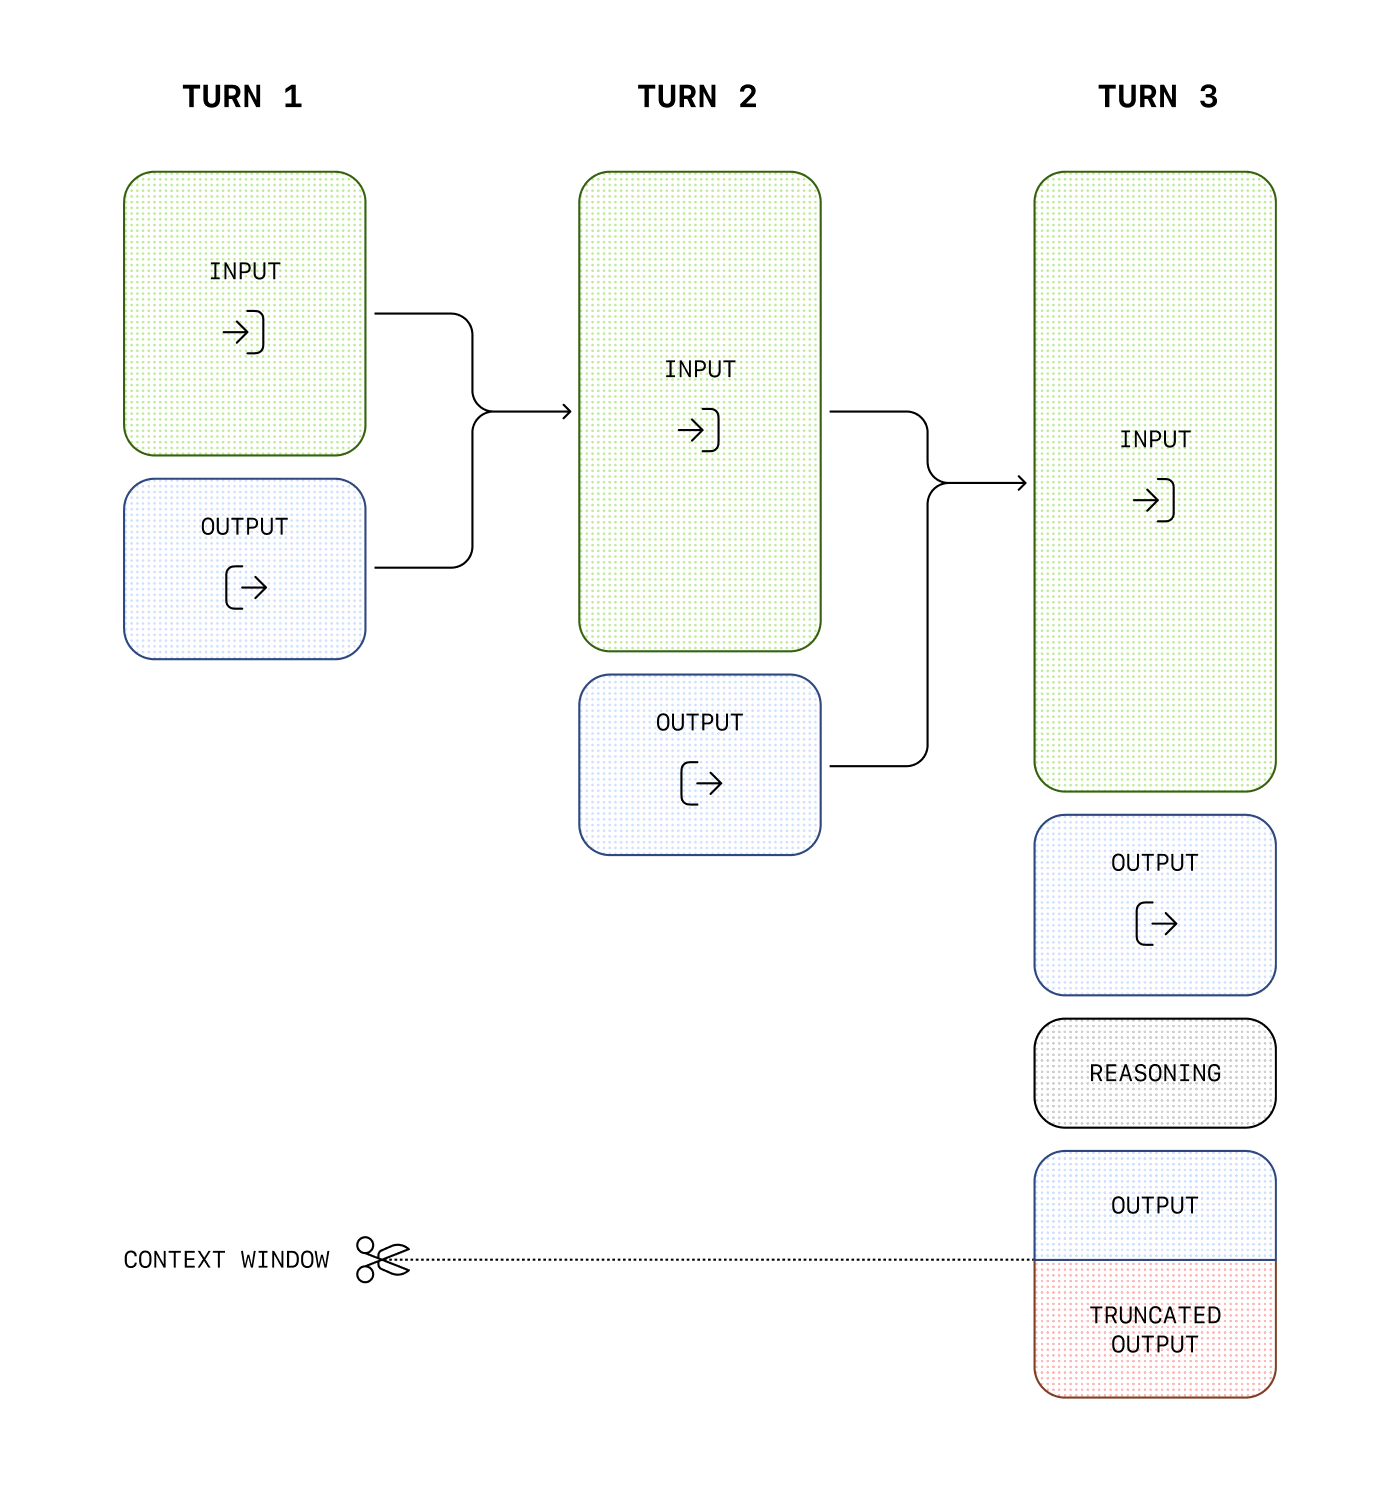
La fenêtre de contexte correspond au nombre maximal de tokens utilisables dans une seule requête. Ce maximum comprend les tokens d’entrée, de sortie et de raisonnement. Pour connaître la fenêtre de contexte de votre modèle, consultez les détails des modèles.
Gestion du contexte pour la génération de texte
À mesure que vos entrées deviennent plus complexes ou que vous ajoutez des tours à une conversation, vous devez tenir compte à la fois des limites de tokens de sortie et de la fenêtre de contexte . Les entrées et les sorties du modèle sont mesurées en tokens. Les entrées sont découpées en tokens pour en analyser le contenu et l’intention, puis des tokens sont assemblés pour produire des sorties cohérentes. Les modèles imposent des limites au nombre de tokens utilisés au cours d’une requête de génération de texte.
Les tokens de sortie sont les tokens générés par un modèle en réponse à un prompt. Chaque modèle a ses propres limites de tokens de sortie. Par exemple, gpt-4o-2024-08-06 peut générer un maximum de 16 384 tokens de sortie.
La fenêtre de contexte correspond au nombre total de tokens utilisables en entrée et en sortie (ainsi que, pour certains modèles, aux tokens de raisonnement). Comparez les limites des fenêtres de contexte de nos modèles. Par exemple, gpt-4o-2024-08-06 dispose d’une fenêtre de contexte totale de 128 000 tokens.
Si vous créez un prompt volumineux, souvent en ajoutant du contexte, des données ou des exemples destinés au modèle, vous risquez de dépasser la fenêtre de contexte allouée au modèle, ce qui peut entraîner des sorties tronquées.
Par exemple, lorsque vous envoyez une requête API à Chat Completions avec le modèle o1, les tokens suivants sont comptabilisés dans le total de la fenêtre de contexte :
Tokens d’entrée (données que vous incluez dans le tableau messages avec Chat Completions)
Tokens de sortie (tokens générés en réponse à votre prompt)
Tokens de raisonnement (utilisés par le modèle pour préparer une réponse)
Par exemple, lorsque vous envoyez une requête à l’API Responses avec un modèle doté de capacités de raisonnement, comme le modèle o1, les tokens suivants sont comptabilisés dans le total de la fenêtre de contexte :
Tokens d’entrée (données que vous incluez dans le tableau input pour l’API Responses)
Tokens de sortie (tokens générés en réponse à votre prompt)
Tokens de raisonnement (utilisés par le modèle pour préparer une réponse)
Les tokens générés au-delà de la limite de la fenêtre de contexte peuvent être tronqués dans les réponses de l’API.
Vous pouvez estimer le nombre de tokens que vos messages utiliseront à l’aide de l’outil de tokenisation.
Compactage
Les instructions détaillées sur le compactage se trouvent désormais dans la page
Compactage.
Pour utiliser /responses avec context_management et compact_threshold, consultez
Compactage côté serveur.
Pour découvrir des exemples et des cas d’utilisation plus précis, consultez l’OpenAI Cookbook, ou découvrez comment utiliser les API pour étendre les capacités des modèles :