
OpenAI propose deux types de modèles : les modèles de raisonnement (o3 et o4-mini, par exemple) et les modèles GPT (comme GPT-4.1). Ces familles de modèles se comportent différemment.
Ce guide aborde les points suivants :
- La différence entre nos modèles de raisonnement et nos modèles GPT sans raisonnement
- Quand utiliser nos modèles de raisonnement
- Comment rédiger des prompts efficaces pour les modèles de raisonnement
Apprenez-en davantage sur les modèles de raisonnement et leur fonctionnement.
Modèles de raisonnement et modèles GPT
Nos modèles de la série o excellent dans des tâches différentes de celles des modèles GPT et nécessitent des prompts différents. Aucune de ces deux familles n’est meilleure que l’autre : elles sont simplement différentes.
Nous avons entraîné nos modèles de la série o (« les planificateurs ») à réfléchir plus longtemps et de manière plus approfondie aux tâches complexes. Ils sont ainsi efficaces pour élaborer des stratégies, planifier la résolution de problèmes complexes et prendre des décisions à partir de grands volumes d’informations ambiguës. Ces modèles peuvent également exécuter des tâches avec une grande exactitude et une grande précision, ce qui les rend idéaux pour les domaines qui nécessiteraient autrement un expert humain, comme les mathématiques, les sciences, l’ingénierie, les services financiers et les services juridiques.
Nos modèles GPT (« les exécutants »), quant à eux, offrent une latence plus faible et un meilleur rapport coût-efficacité. Ils sont conçus pour exécuter des tâches simples. Une application peut utiliser les modèles de la série o pour élaborer une stratégie de résolution d’un problème, puis les modèles GPT pour exécuter des tâches précises, en particulier lorsque la vitesse et le coût comptent davantage qu’une exactitude parfaite.
Comment choisir
Quels critères comptent le plus pour votre cas d’utilisation ?
- Vitesse et coût → Les modèles GPT sont plus rapides et coûtent généralement moins cher
- Exécution de tâches bien définies → Les modèles GPT sont efficaces pour les tâches explicitement définies
- Exactitude et fiabilité → Les modèles de la série o prennent des décisions fiables
- Résolution de problèmes complexes → Les modèles de la série o savent traiter l’ambiguïté et la complexité
Si la vitesse et le coût sont vos principaux critères pour accomplir vos tâches et que votre cas d’utilisation se compose de tâches simples et bien définies, nos modèles GPT sont les plus adaptés. En revanche, si l’exactitude et la fiabilité sont vos principaux critères et que vous devez résoudre un problème très complexe en plusieurs étapes, nos modèles de la série o sont probablement le bon choix.
La plupart des workflows d’IA combineront les deux types de modèles : la série o pour la planification agentique et la prise de décision, et la série GPT pour l’exécution des tâches.
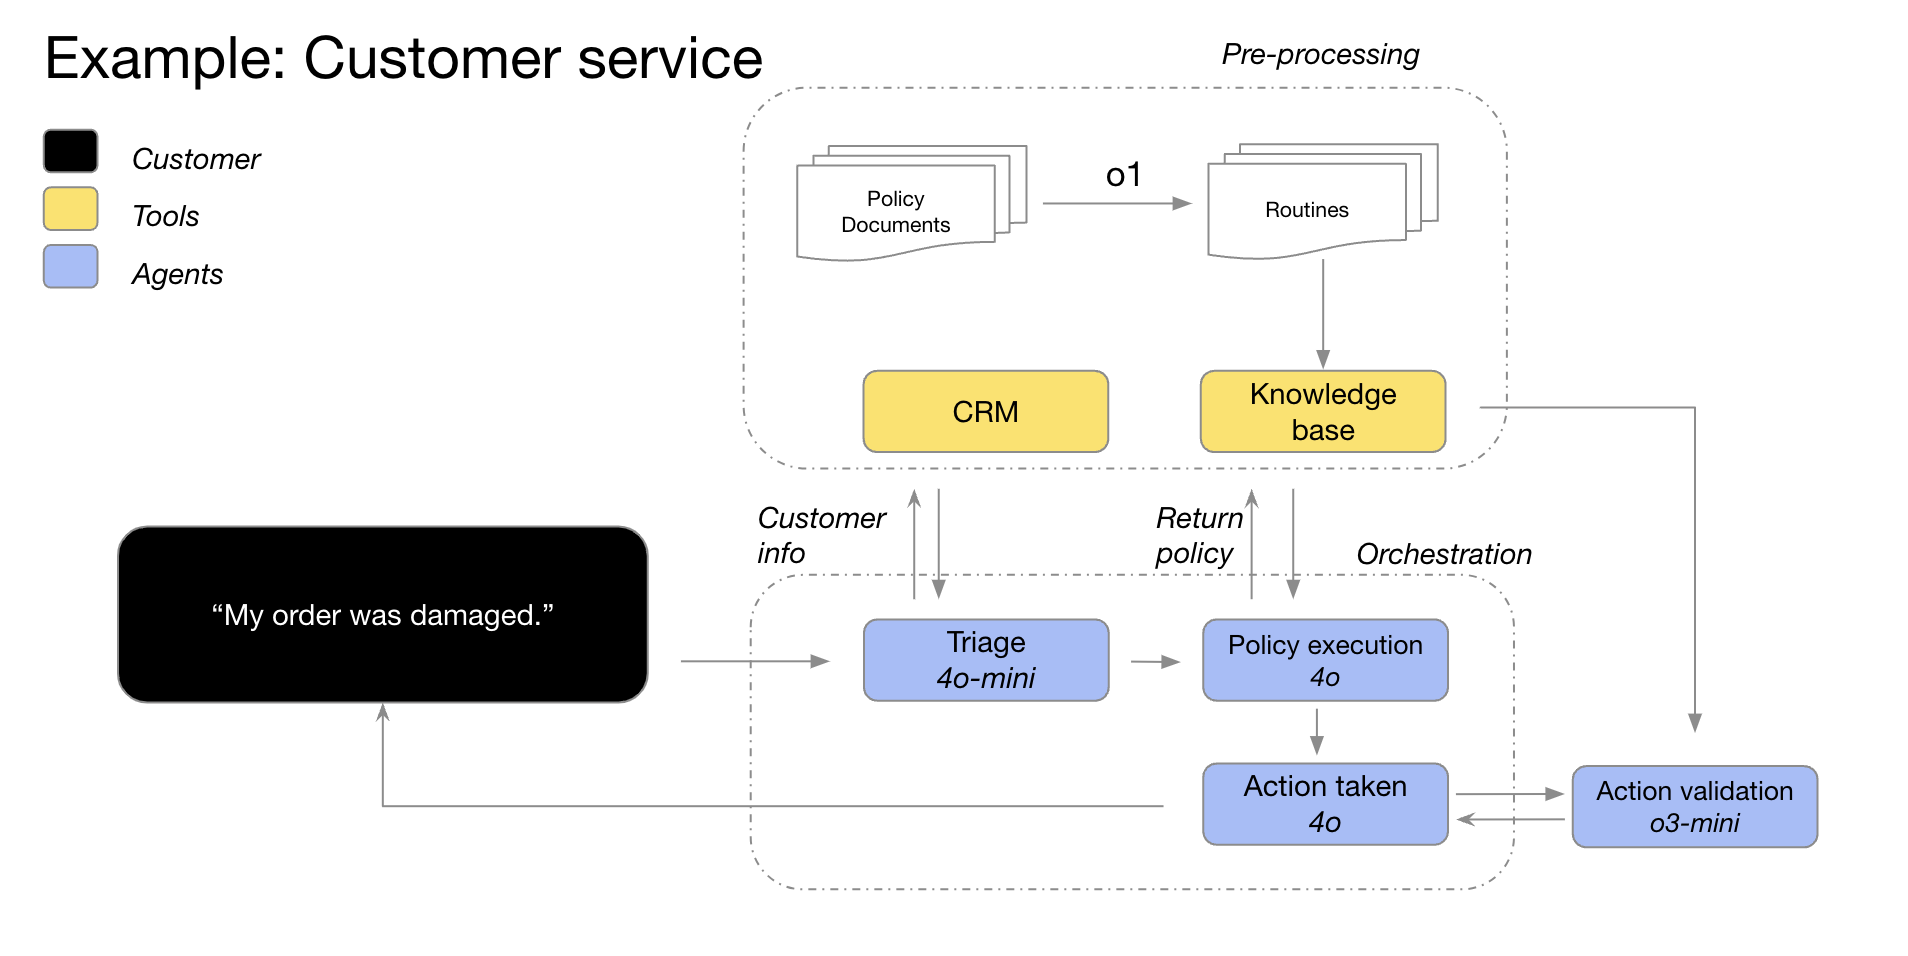
Nos modèles GPT-4o et GPT-4o mini trient les détails de la commande et les informations client, identifient les problèmes liés à la commande et la politique de retour, puis transmettent toutes ces données à o3-mini. Celui-ci décide alors si le retour est possible au regard de cette politique.
Quand utiliser nos modèles de raisonnement
Voici quelques exemples d’utilisations réussies que nous avons observées chez nos clients et en interne chez OpenAI. Il ne s’agit pas d’un panorama exhaustif de tous les cas d’utilisation possibles, mais de conseils pratiques pour tester nos modèles de la série o.
Vous souhaitez utiliser un modèle de raisonnement ? Passez au guide de démarrage rapide →
1. Gérer les tâches ambiguës
À partir d’informations limitées ou disparates et d’un simple prompt, les modèles de raisonnement comprennent particulièrement bien l’intention de l’utilisateur et savent gérer les lacunes dans les instructions. Ils posent d’ailleurs souvent des questions de clarification avant de faire des suppositions sans fondement ou de tenter de combler les informations manquantes.
« Les capacités de raisonnement d’o1 permettent à notre plateforme multi-agent Matrix de produire des réponses exhaustives, bien structurées et détaillées lors du traitement de documents complexes. Par exemple, avec un prompt basique, o1 a permis à Matrix de repérer facilement les enveloppes disponibles pour effectuer des paiements soumis à restrictions dans le cadre d’un contrat de crédit. Aucun modèle antérieur n’est aussi performant. Sur 52 % des prompts complexes portant sur des contrats de crédit denses, o1 a obtenu de meilleurs résultats que les autres modèles. »
—Hebbia, entreprise proposant une plateforme de connaissances fondée sur l’IA pour le droit et la finance
2. Trouver une aiguille dans une botte de foin
Lorsque vous leur transmettez de grandes quantités d’informations non structurées, les modèles de raisonnement excellent à les comprendre et à n’en extraire que les éléments les plus pertinents pour répondre à une question.
« Pour analyser l’acquisition d’une entreprise, o1 a examiné des dizaines de documents, notamment des contrats et des baux, afin de repérer les conditions délicates susceptibles d’affecter l’opération. Chargé de signaler les clauses clés, le modèle a identifié dans les notes de bas de page une disposition cruciale relative au “changement de contrôle” : en cas de vente, l’entreprise devrait rembourser immédiatement un prêt de 75 millions de dollars. L’extrême attention qu’o1 porte aux détails permet à nos agents d’IA d’aider les professionnels de la finance en repérant les informations décisives. »
—Endex, plateforme d’intelligence financière fondée sur l’IA
3. Repérer les liens et les nuances dans un vaste jeu de données
Nous avons constaté que les modèles de raisonnement sont particulièrement efficaces pour raisonner sur des documents complexes contenant des centaines de pages d’informations denses et non structurées, comme des contrats juridiques, des états financiers ou des demandes d’indemnisation. Ils excellent notamment à établir des parallèles entre les documents et à prendre des décisions à partir de faits implicitement présents dans les données.
« La recherche fiscale nécessite de synthétiser plusieurs documents pour produire une réponse finale solide et argumentée. Nous avons remplacé GPT-4o par o1 et constaté qu’o1 raisonnait bien mieux sur les liens entre les documents pour tirer des conclusions logiques qui ne ressortaient d’aucun document pris isolément. En passant à o1, nous avons ainsi multiplié par quatre les performances de bout en bout : incroyable. »
—Blue J, plateforme d’IA pour la recherche fiscale
Les modèles de raisonnement savent également analyser des politiques et des règles nuancées, puis les appliquer à la tâche en cours pour parvenir à une conclusion raisonnable.
« Dans leurs analyses financières, les analystes traitent souvent des scénarios complexes liés aux capitaux propres et doivent en comprendre les subtilités juridiques. Nous avons testé une dizaine de modèles de différents fournisseurs avec une question difficile, mais courante : quel est l’effet d’une levée de fonds sur les actionnaires existants, notamment lorsqu’ils exercent leurs droits antidilution ? Il fallait raisonner sur les valorisations avant et après investissement et traiter des boucles de dilution circulaires, un problème dont la résolution prendrait 20 à 30 minutes à des analystes financiers de premier plan. Nous avons constaté qu’o1 et o3-mini y parvenaient sans la moindre erreur ! Les modèles ont même produit un tableau de calcul clair montrant l’effet sur un actionnaire détenant 100 000 dollars de participation. »
–BlueFlame AI, plateforme d’IA pour la gestion des investissements
4. Planification agentique en plusieurs étapes
Les modèles de raisonnement sont essentiels à la planification agentique et à l’élaboration de stratégies. Nous avons obtenu de bons résultats en utilisant un modèle de raisonnement comme « planificateur » : il élabore une solution détaillée en plusieurs étapes, puis choisit et affecte à chaque étape le modèle GPT approprié (« l’exécutant »), selon que l’intelligence ou la faible latence est prioritaire.
« Nous utilisons o1 comme planificateur dans notre infrastructure d’agents. Il orchestre les autres modèles du workflow pour accomplir une tâche en plusieurs étapes. Nous constatons qu’o1 est particulièrement efficace pour sélectionner les types de données et décomposer les grandes questions en éléments plus petits, ce qui permet aux autres modèles de se concentrer sur l’exécution. »
—Argon AI, plateforme de connaissances fondée sur l’IA pour l’industrie pharmaceutique
« o1 fait fonctionner bon nombre de nos workflows agentiques dans Lindy, notre assistant d’IA pour le travail. Le modèle utilise l’appel de fonction pour récupérer des informations dans votre calendrier ou vos e-mails. Il peut ensuite vous aider automatiquement à planifier des réunions, à envoyer des e-mails et à gérer d’autres aspects de vos tâches quotidiennes. Nous avons confié à o1 toutes les étapes agentiques qui posaient problème et avons vu nos agents devenir pratiquement irréprochables du jour au lendemain ! »
—Lindy.AI, assistant d’IA pour le travail
5. Raisonnement visuel
À ce jour, o1 est le seul modèle de raisonnement à prendre en charge des capacités de vision. Ce qui le distingue de GPT-4o, c’est sa capacité à comprendre même les visuels les plus difficiles, comme des graphiques et des tableaux à la structure ambiguë ou des photos de mauvaise qualité.
« Nous automatisons les contrôles des risques et de la conformité pour des millions de produits en ligne, notamment des imitations de bijoux de luxe, des espèces menacées et des substances réglementées. GPT-4o a atteint 50 % d’exactitude sur nos tâches de classification d’images les plus difficiles. o1 a obtenu un résultat impressionnant de 88 % d’exactitude, sans aucune modification de notre pipeline. »
—SafetyKit, plateforme de gestion des risques et de la conformité fondée sur l’IA
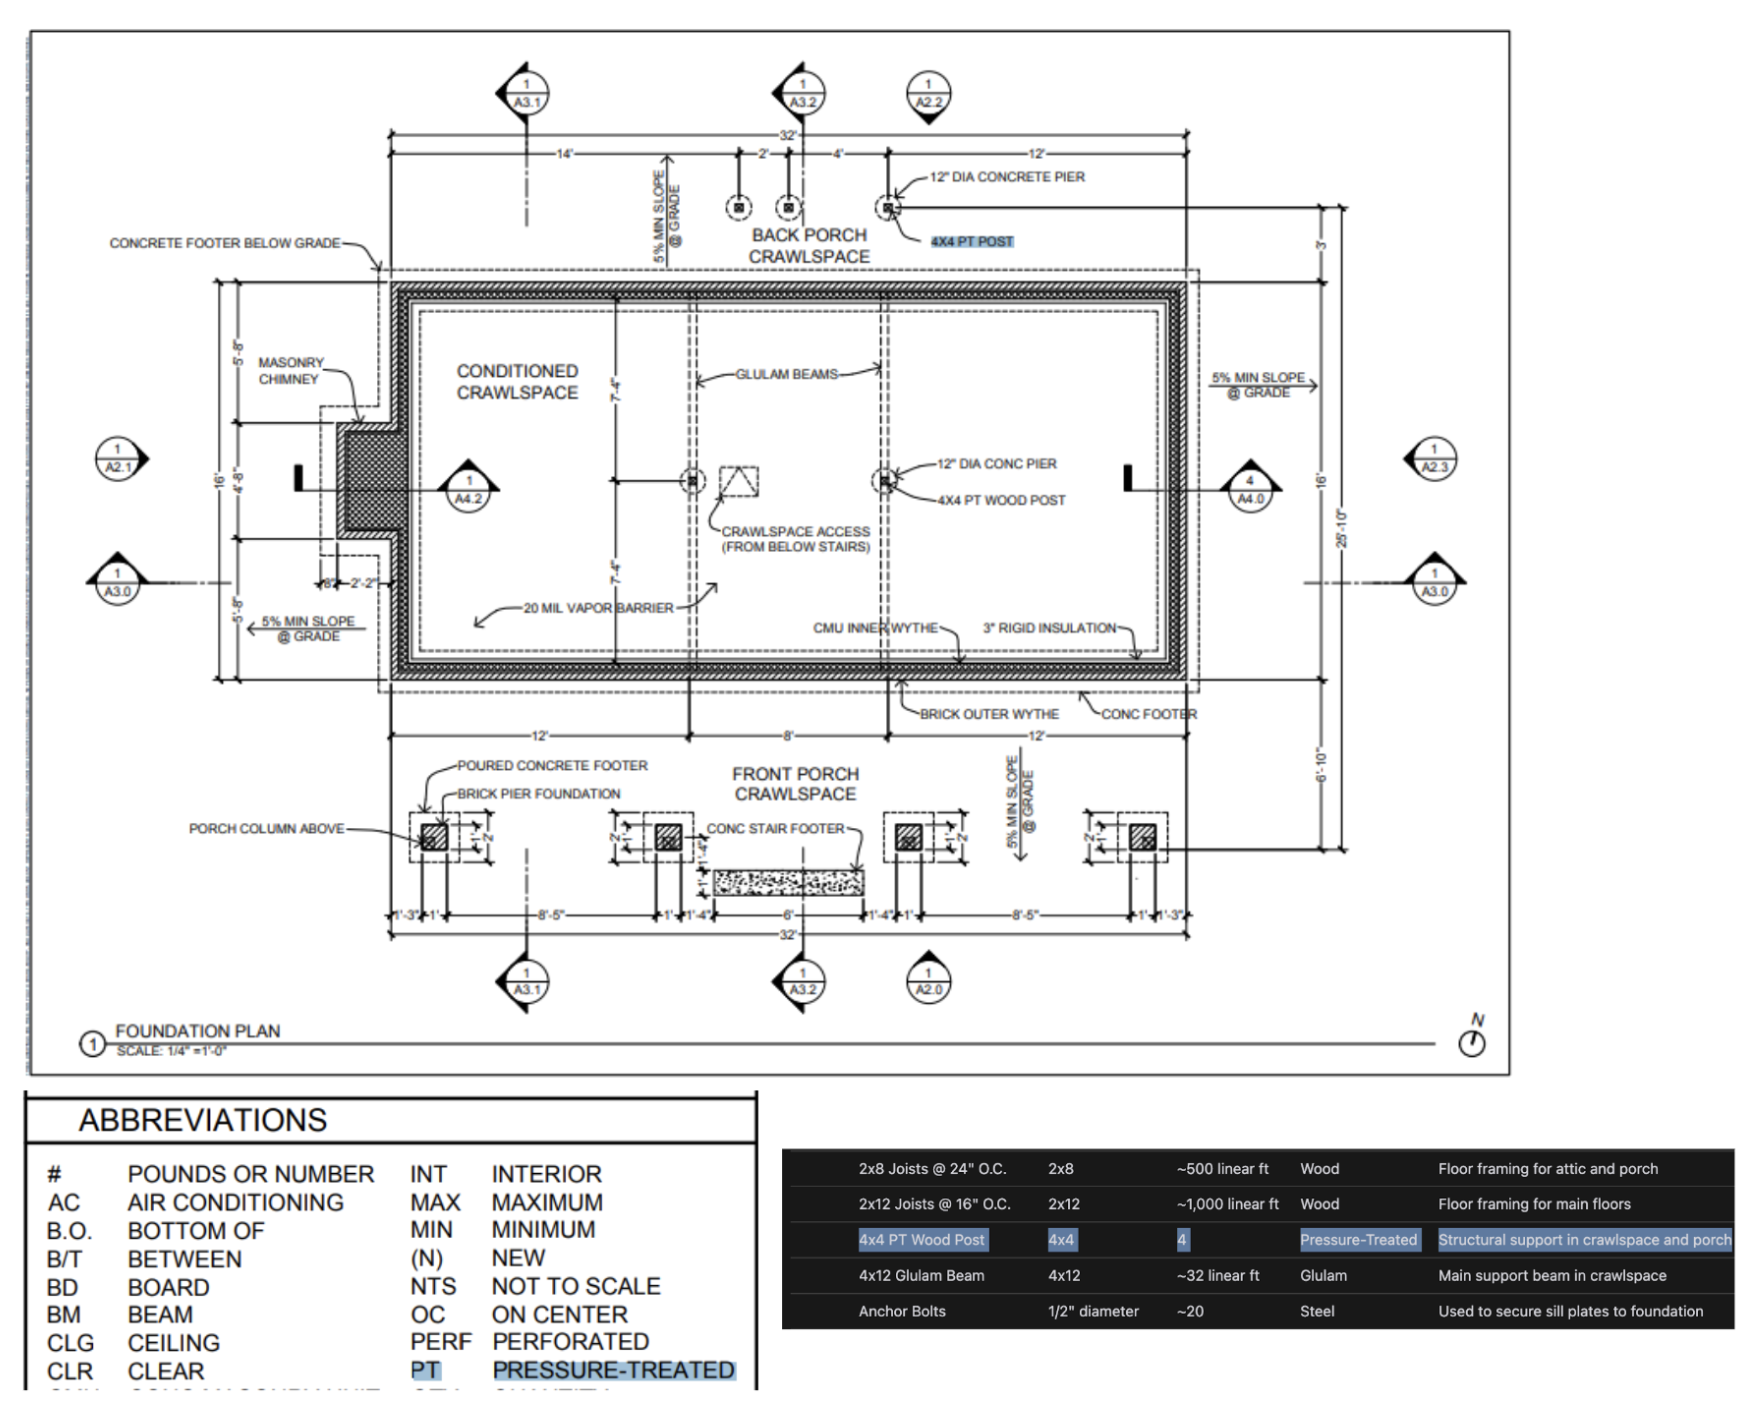
Lors de nos tests internes, nous avons constaté qu’o1 pouvait identifier les équipements fixes et les matériaux sur des plans d’architecture très détaillés afin de générer une nomenclature complète des matériaux. L’un des résultats les plus surprenants était sa capacité à établir des parallèles entre différentes images : il pouvait reprendre la légende d’une page de plans et l’appliquer correctement à une autre page, sans instruction explicite. Vous pouvez voir ci-dessous que, pour les poteaux en bois 4x4 PT, o1 a compris à partir de la légende que « PT » signifiait « pressure treated », c’est-à-dire traité sous pression.
6. Revue, débogage et amélioration de la qualité du code
Les modèles de raisonnement sont particulièrement efficaces pour examiner et améliorer de grandes quantités de code. Compte tenu de leur latence plus élevée, les revues de code s’exécutent souvent en arrière-plan.
« Nous proposons des revues de code automatisées par l’IA sur des plateformes comme GitHub et GitLab. Si le processus de revue de code n’est pas intrinsèquement sensible à la latence, il exige de comprendre les différences de code entre plusieurs fichiers. C’est là qu’o1 se distingue vraiment : il détecte de manière fiable des modifications mineures du code source qui pourraient échapper à un relecteur humain. Le passage aux modèles de la série o nous a permis de tripler les taux de conversion de notre produit. »
—CodeRabbit, startup spécialisée dans la revue de code par l’IA
Même si GPT-4o et GPT-4o mini peuvent être mieux adaptés à l’écriture de code grâce à leur latence plus faible, nous avons également observé d’excellentes performances d’o3-mini en génération de code pour des cas d’utilisation un peu moins sensibles à la latence.
« o3-mini produit régulièrement du code de grande qualité qui répond au problème posé et trouve très souvent la bonne solution lorsque le problème est bien défini, même pour des tâches de programmation très difficiles. Là où d’autres modèles ne sont parfois utiles que pour des itérations rapides et limitées sur le code, o3-mini excelle dans la planification et la réalisation de systèmes logiciels complexes. »
—Windsurf, IDE collaboratif fondé sur l’IA agentique, développé par Codeium
7. Évaluation et comparaison des réponses d’autres modèles
Nous avons également observé de bons résultats lorsque les modèles de raisonnement évaluent et comparent les réponses d’autres modèles. La validation des données est importante pour garantir la qualité et la fiabilité des jeux de données, en particulier dans les domaines sensibles comme la santé. Les méthodes de validation traditionnelles utilisent des règles et des schémas prédéfinis, tandis que des modèles avancés comme o1 et o3-mini peuvent comprendre le contexte et raisonner sur les données pour offrir une approche de la validation plus souple et plus intelligente.
« De nombreux clients utilisent un LLM comme juge dans leur processus d’évaluation sur Braintrust. Par exemple, une entreprise du secteur de la santé peut résumer les questions des patients avec un modèle d’exécution comme gpt-4o, puis évaluer la qualité du résumé avec o1. Chez un client de Braintrust, le score F1 d’un juge est passé de 0,12 avec 4o à 0,74 avec o1 ! Dans ces cas d’utilisation, les clients ont constaté que le raisonnement d’o1 changeait la donne pour repérer les différences subtiles entre les réponses générées, dans les tâches de notation les plus difficiles et les plus complexes. »
—Braintrust, plateforme d’évaluation de l’IA
Comment rédiger des prompts efficaces pour les modèles de raisonnement
Ces modèles donnent les meilleurs résultats avec des prompts simples et directs. Certaines techniques d’ingénierie de prompts, comme demander au modèle de « réfléchir étape par étape », n’améliorent pas nécessairement les performances et peuvent parfois les dégrader. Consultez les bonnes pratiques ci-dessous ou commencez avec des exemples de prompts.
- Les messages développeur remplacent les messages système : à partir de
o1-2024-12-17, les modèles de raisonnement prennent en charge les messages développeur plutôt que les messages système, conformément à la hiérarchie des instructions décrite dans la spécification du modèle. - Rédigez des prompts simples et directs : les modèles excellent dans la compréhension et le suivi d’instructions brèves et claires.
- Évitez les prompts demandant un raisonnement détaillé (« chain-of-thought ») : ces modèles raisonnent en interne ; il est donc inutile de leur demander de « réfléchir étape par étape » ou d’« expliquer leur raisonnement ».
- Utilisez des délimiteurs pour plus de clarté : utilisez des délimiteurs tels que le Markdown, les balises XML et les titres de section pour distinguer clairement les différentes parties de l’entrée et aider le modèle à les interpréter correctement.
- Essayez d’abord le zero-shot, puis le few-shot si nécessaire : les modèles de raisonnement n’ont souvent pas besoin d’exemples few-shot pour produire de bons résultats. Commencez donc par rédiger des prompts sans exemples. Si vos exigences concernant la sortie souhaitée sont plus complexes, il peut être utile d’inclure dans votre prompt quelques exemples d’entrées et de sorties attendues. Veillez simplement à ce que ces exemples correspondent très précisément aux instructions de votre prompt, car des divergences entre les deux peuvent nuire aux résultats.
- Donnez des consignes précises : si vous souhaitez imposer des contraintes à la réponse du modèle, par exemple « proposez une solution avec un budget inférieur à 500 $ », indiquez-les explicitement dans le prompt.
- Définissez très précisément votre objectif final : dans vos instructions, essayez de définir des paramètres très précis pour une réponse satisfaisante et encouragez le modèle à poursuivre son raisonnement et à affiner sa réponse jusqu’à ce qu’elle remplisse vos critères de réussite.
- Mise en forme Markdown : à partir de
o1-2024-12-17, les modèles de raisonnement de l’API évitent de générer des réponses au format Markdown. Pour indiquer au modèle que vous souhaitez une réponse au format Markdown, incluez la chaîneFormatting re-enabledsur la première ligne de votre message développeur.
Comment limiter les coûts tout en maintenant une grande précision
Avec l’arrivée des modèles o3 et o4-mini, le traitement des éléments de raisonnement conservés dans l’API Responses a changé. Auparavant, avec o1, o3-mini, o1-mini et o1-preview, ces éléments étaient toujours ignorés dans les requêtes API suivantes, même lorsqu’ils figuraient parmi les éléments d’entrée des requêtes. Avec o3 et o4-mini, certains éléments de raisonnement adjacents aux appels de fonction sont inclus dans le contexte du modèle afin d’améliorer ses performances tout en utilisant le moins possible de tokens de raisonnement.
Pour tirer le meilleur parti de ce changement, nous recommandons d’utiliser l’API Responses avec le paramètre store défini sur true et de transmettre tous les éléments de raisonnement des requêtes précédentes, soit en utilisant previous_response_id, soit en reprenant tous les éléments de sortie d’une ancienne requête pour les transmettre comme éléments d’entrée d’une nouvelle requête. OpenAI inclura automatiquement les éléments de raisonnement pertinents dans le contexte du modèle et ignorera les autres. Pour les cas d’usage plus avancés où vous souhaitez gérer plus précisément le contenu du contexte du modèle, nous recommandons d’inclure au minimum tous les éléments de raisonnement situés entre le dernier appel de fonction et le message utilisateur précédent. Ainsi, le modèle n’aura pas à reprendre son raisonnement depuis le début lorsque vous répondrez à un appel de fonction, ce qui améliore les performances des appels de fonction et réduit la consommation globale de tokens.
Si vous utilisez l’API Chat Completions, les éléments de raisonnement ne sont jamais inclus dans le contexte du modèle, car Chat Completions est une API sans état. Dans les cas d’usage agentiques complexes impliquant de nombreux appels de fonction, cela entraîne une légère baisse des performances du modèle et une consommation accrue de tokens de raisonnement. En l’absence d’enchaînements complexes de plusieurs appels de fonction, les performances ne devraient pas se dégrader, quelle que soit l’API utilisée.
Autres ressources
Pour trouver d’autres idées, consultez l’OpenAI Cookbook, qui contient des exemples de code et des liens vers des ressources tierces, ou découvrez-en davantage sur nos modèles et leurs capacités de raisonnement :