
Maintenant que GPT-5 est disponible, nous souhaitions vous en dire plus sur la meilleure façon de l’intégrer, l’API Responses, et expliquer pourquoi Responses est conçue sur mesure pour les modèles de raisonnement et l’avenir agentique.
Chaque génération d’API OpenAI a été conçue autour de la même question : quel est le moyen le plus simple et le plus puissant pour les développeurs de communiquer avec les modèles ?
La conception de nos API a toujours été guidée par le fonctionnement des modèles eux-mêmes. Le tout premier point de terminaison /v1/completions était simple, mais contraignant : vous donniez un prompt au modèle, qui se contentait de poursuivre votre texte. Grâce à des techniques comme les prompts few-shot, les développeurs pouvaient tenter de guider le modèle pour produire du JSON ou répondre à des questions, mais les capacités de ces modèles étaient bien inférieures à celles auxquelles nous sommes habitués aujourd’hui.
Puis sont arrivés le RLHF, ChatGPT et l’ère du post-entraînement. Soudain, les modèles ne se contentaient plus de compléter vos textes inachevés : ils vous répondaient comme un interlocuteur. Pour accompagner cette évolution, nous avons créé /v1/chat/completions (en un seul week-end, comme le raconte cette anecdote bien connue). En introduisant des rôles comme system, user et assistant, nous avons fourni une base pour créer rapidement des interfaces de discussion avec des instructions personnalisées et du contexte.
Nos modèles ont continué à s’améliorer. Ils ont bientôt commencé à voir, à entendre et à parler. L’appel de fonction, introduit fin 2023, s’est révélé être l’une de nos fonctionnalités les plus appréciées. À peu près au même moment, nous avons lancé l’API Assistants en bêta : notre première tentative d’interface entièrement agentique, avec des outils hébergés comme l’interpréteur de code et la recherche de fichiers. Certains développeurs l’ont appréciée, mais elle n’a jamais été adoptée à grande échelle, car sa conception imposait des limites et rendait sa prise en main difficile par rapport à Chat Completions.
Fin 2024, la nécessité d’unifier ces approches était devenue évidente : il nous fallait une API aussi accessible que Chat Completions, aussi puissante qu’Assistants, mais aussi spécialement conçue pour les modèles multimodaux et de raisonnement. C’est ainsi qu’est née /v1/responses.
/v1/responses est une boucle agentique
Chat Completions proposait une interface de discussion simple, fondée sur des échanges successifs. Responses offre une boucle structurée pour raisonner et agir. Imaginez que vous travaillez avec un détective : vous lui fournissez des éléments de preuve, il enquête, consulte éventuellement des experts (les outils), puis vous présente ses conclusions. Le détective conserve ses notes privées (l’état du raisonnement) entre les étapes, mais ne les remet jamais au client.
C’est là que les modèles de raisonnement donnent toute leur mesure : Responses préserve l’ état du raisonnement du modèle au fil des échanges. Dans Chat Completions, le raisonnement est perdu entre les appels, comme si le détective oubliait les indices chaque fois qu’il quittait la pièce. Responses garde le carnet ouvert : le raisonnement mené étape par étape est conservé pour l’échange suivant. Cela se traduit dans les benchmarks (TAUBench +5 %), ainsi que par une utilisation plus efficace du cache et une latence réduite.
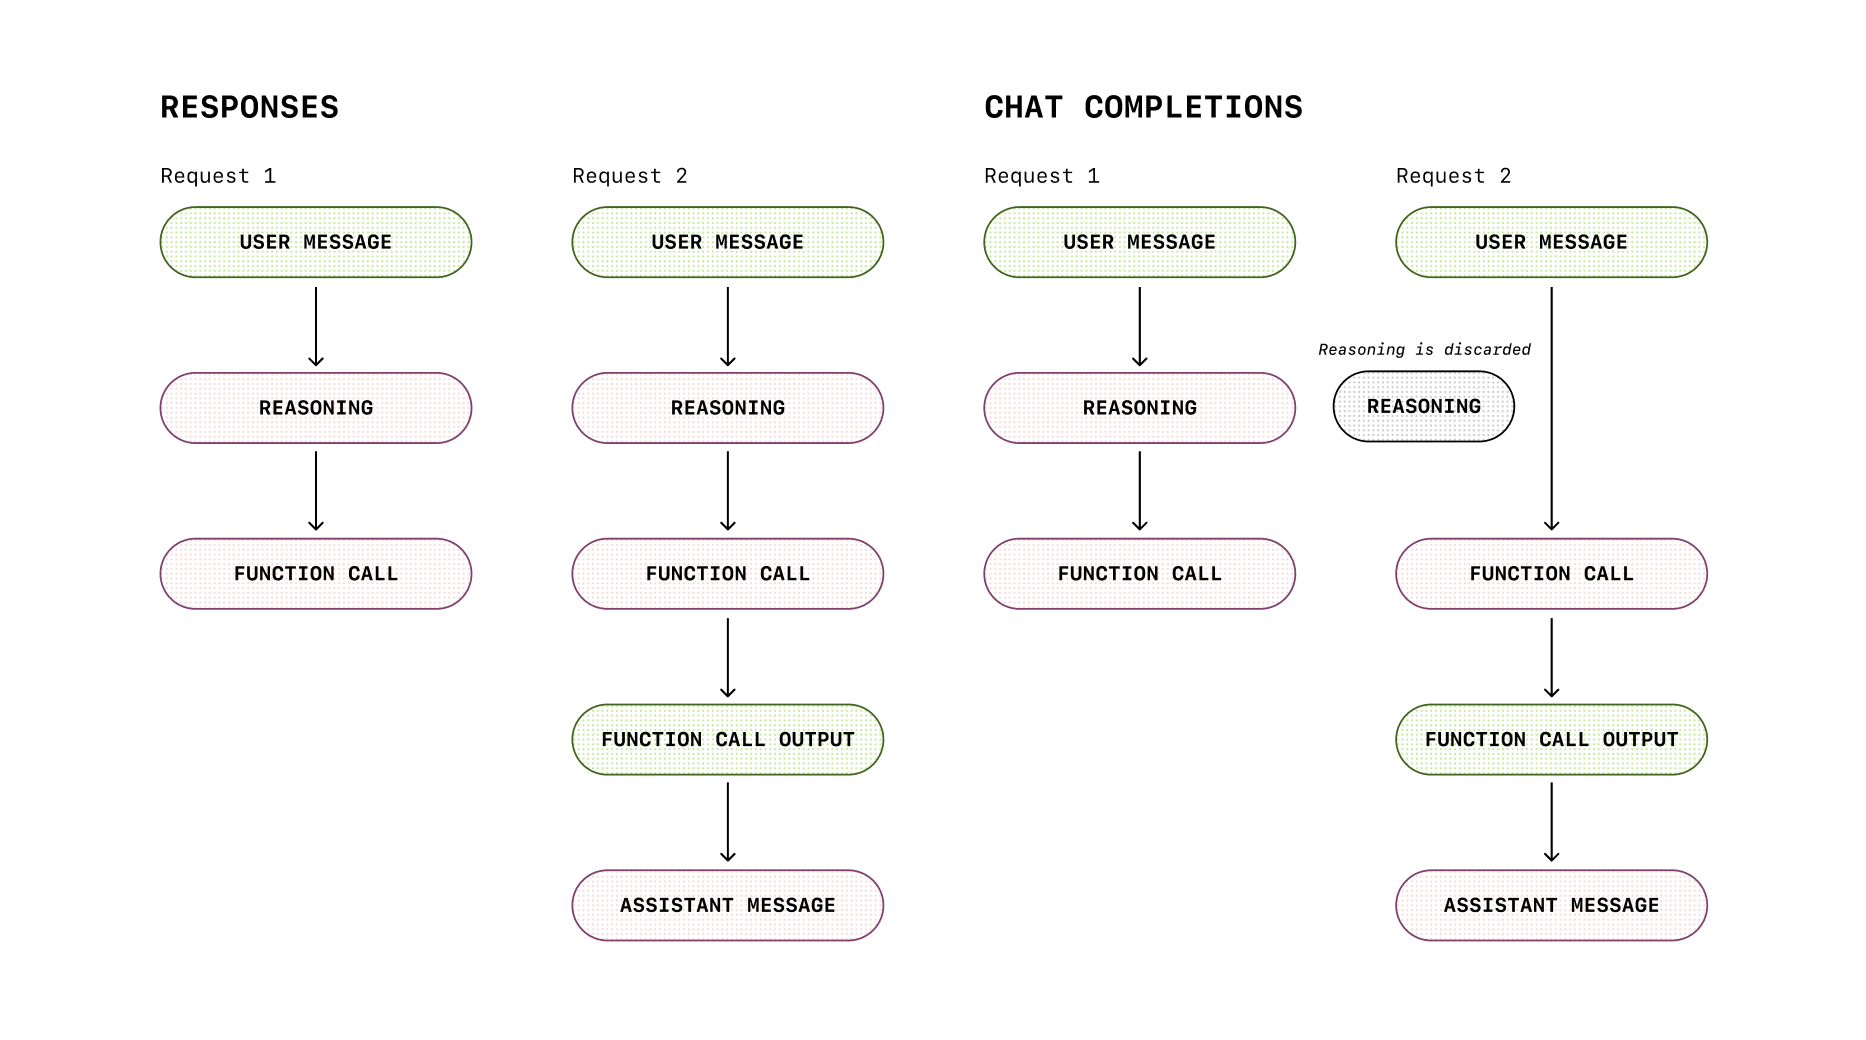
Responses peut aussi renvoyer plusieurs éléments en sortie : non seulement ce que le modèle a dit, mais aussi ce qu’il a fait. Vous obtenez des traces de son travail : appels d’outils, sorties structurées, étapes intermédiaires. C’est comme recevoir à la fois la copie finale et les calculs au brouillon. Utile pour déboguer, auditer et créer des interfaces plus riches.
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},Monter en abstraction grâce aux outils hébergés
Aux débuts de l’appel de fonction, nous avons remarqué un usage récurrent : les développeurs utilisaient le modèle à la fois pour appeler des API et pour effectuer des recherches dans des bases documentaires afin d’y puiser des données externes, une approche désormais connue sous le nom de RAG. Mais lorsqu’on débute, créer un pipeline de récupération de données à partir de zéro est une entreprise complexe et coûteuse. Avec Assistants, nous avons introduit nos premiers outils hébergés : file_search et code_interpreter, qui permettaient au modèle d’utiliser le RAG et d’écrire du code pour résoudre les problèmes que vous lui soumettiez. Dans Responses, nous sommes allés encore plus loin en ajoutant la recherche web, la génération d’images et MCP. Et puisque les outils s’exécutent côté serveur, par l’intermédiaire d’outils hébergés comme l’interpréteur de code ou MCP, chaque appel n’a plus besoin de repasser par votre propre backend, ce qui réduit la latence et le coût des allers-retours.
Préserver le raisonnement en toute sécurité
Pourquoi donc se donner tant de mal pour masquer le raisonnement détaillé (« chain-of-thought », ou CoT) brut du modèle ? Ne serait-il pas plus simple d’exposer le CoT et de laisser les clients le traiter comme les autres sorties du modèle ? En bref, exposer le CoT brut présente plusieurs risques : des hallucinations, du contenu préjudiciable qui ne serait pas généré dans une réponse finale et, pour OpenAI, des risques concurrentiels.
Lors du lancement d’o1-preview à la fin de l’année dernière, notre directeur scientifique Jakub Pachocki écrivait ceci sur notre blog :
Nous pensons qu’un raisonnement détaillé (« chain-of-thought ») masqué offre une occasion unique de surveiller les modèles. À condition d’être fidèle et lisible, ce raisonnement masqué nous permet de « lire dans les pensées » du modèle et de comprendre son cheminement. Par exemple, nous pourrions à l’avenir vouloir surveiller ce raisonnement pour y déceler des signes de manipulation de l’utilisateur. Pour que cela fonctionne, le modèle doit toutefois pouvoir exprimer ses pensées sans les altérer. Nous ne pouvons donc pas entraîner son raisonnement détaillé à respecter des règles ou des préférences utilisateur. Nous ne souhaitons pas non plus rendre un raisonnement détaillé non aligné directement visible aux utilisateurs.
Responses répond à ces enjeux :
- En conservant le raisonnement en interne, chiffré et masqué au client.
- En permettant de poursuivre le raisonnement en toute sécurité via
previous_response_idou des éléments de raisonnement, sans exposer le CoT brut.
Pourquoi /v1/responses est le meilleur choix pour développer
Nous avons conçu Responses pour conserver l’état, prendre en charge plusieurs modalités et fonctionner efficacement.
- Utilisation agentique des outils : l’API Responses permet d’enrichir facilement les workflows agentiques avec des outils comme la recherche de fichiers, la génération d’images, l’interpréteur de code et MCP.
- Conservation de l’état par défaut. Les conversations et l’état des outils sont suivis automatiquement. Cela simplifie considérablement le raisonnement et les workflows sur plusieurs échanges. Intégré via Responses, GPT-5 obtient un score supérieur de 5 % sur TAUBench par rapport à Chat Completions, uniquement grâce à la conservation du raisonnement.
- Une conception multimodale dès le départ. Texte, images, audio, appels de fonction : tous sont pris en charge à part entière. Nous n’avons pas greffé des modalités sur une API textuelle ; nous avons conçu la maison avec suffisamment de chambres dès le premier jour.
- Des coûts réduits, de meilleures performances. Les benchmarks internes montrent une utilisation du cache améliorée de 40 à 80 % par rapport à Chat Completions. Cela se traduit par une latence et des coûts réduits.
- Une meilleure conception : nous avons beaucoup appris des API Chat Completions et Assistants, et avons apporté à l’API Responses et au SDK plusieurs petites améliorations qui facilitent le quotidien, notamment :
- Des événements de streaming sémantiques.
- Un polymorphisme avec discriminant interne.
- Des utilitaires
output_textdans le SDK (plus besoin dechoices.[0].message.content). - Une meilleure organisation des paramètres multimodaux et de raisonnement.
Et Chat Completions ?
Chat Completions ne va pas disparaître. Si cette API vous convient, continuez à l’utiliser. Mais si vous souhaitez un raisonnement qui persiste, des interactions multimodales naturelles et une boucle agentique qui ne nécessite aucun bricolage, Responses est la voie à suivre.
Et pour la suite
Tout comme Chat Completions a remplacé Completions, nous nous attendons à ce que Responses devienne le choix par défaut des développeurs pour créer avec les modèles OpenAI. Elle est simple quand vous en avez besoin, puissante quand vous le souhaitez, et suffisamment flexible pour s’adapter à tout ce que le prochain paradigme nous réserve.
C’est sur cette API que nous allons nous appuyer pour développer dans les années à venir.